GPUStack v2.3.0rc2 预览版已经发布。这一版的高级路由里多了一个值得动手验证的能力:基于 Jev 决策服务来选择模型。
当 GPUStack 中同时挂着多个模型时,应用通常得自己指定调哪一个。接入决策路由之后,应用可以一直请求同一个入口,由网关结合任务内容和管理员设定的策略来挑选生成模型。
这篇文章就沿着这条链路完整走一遍:先搞清楚决策模型是什么,再通过 GPUStack 部署两个私有化模型,接入 DeepSeek 与 Jev,最后用不同难度的任务验证选择结果是否符合预期。
01 什么是决策模型
生成模型负责回答问题,决策模型负责为选择提供依据。
举个简单的例子:同样是一次对话请求,「把 Good morning 翻译成中文」和「设计一个跨地域支付系统」需要的能力差别很大。前者交给较小的模型就行,后者可能需要更强的模型来分析故障与一致性问题。
Jev 接收请求内容、候选模型及其能力说明,通过 TypeSafe Choice 接口返回结构化的选择依据。GPUStack 网关据此完成模型选择,再把请求转发给相应的生成服务。最终回答仍然由 Qwen3 或 DeepSeek 生成。
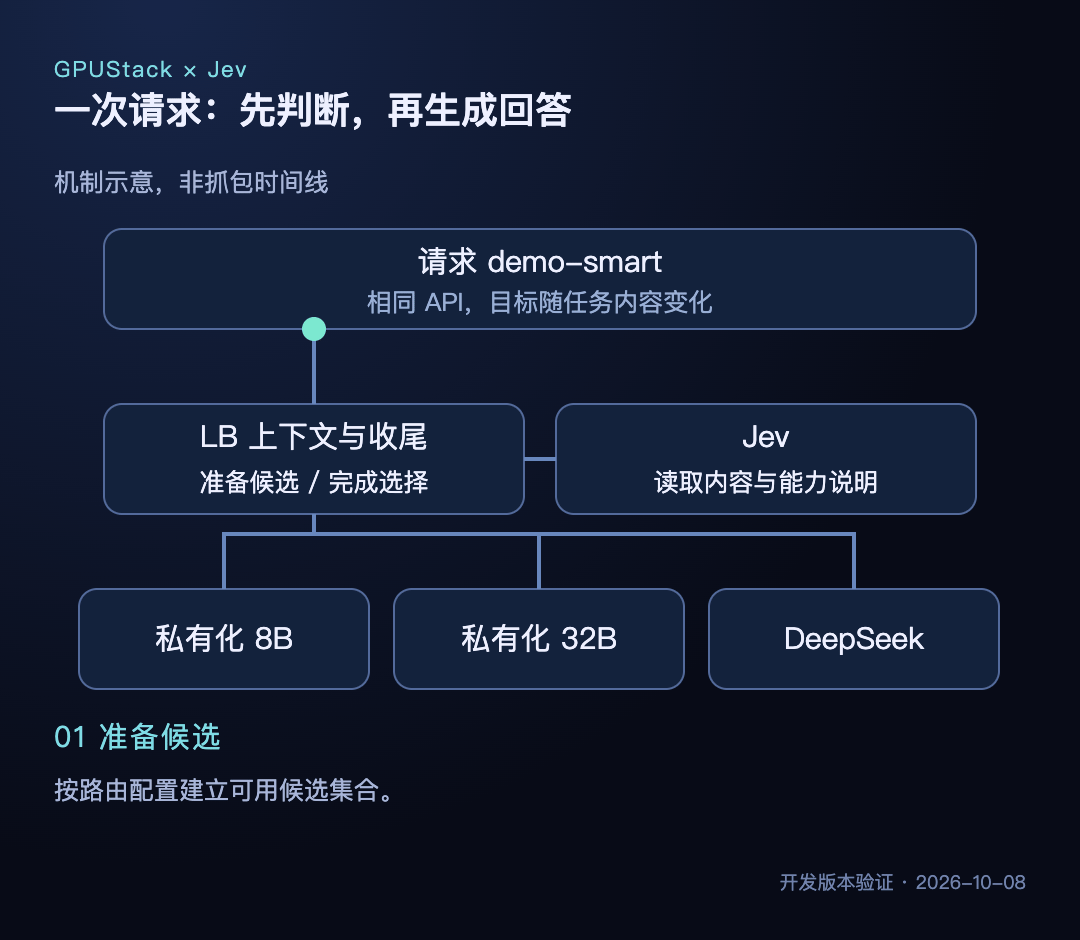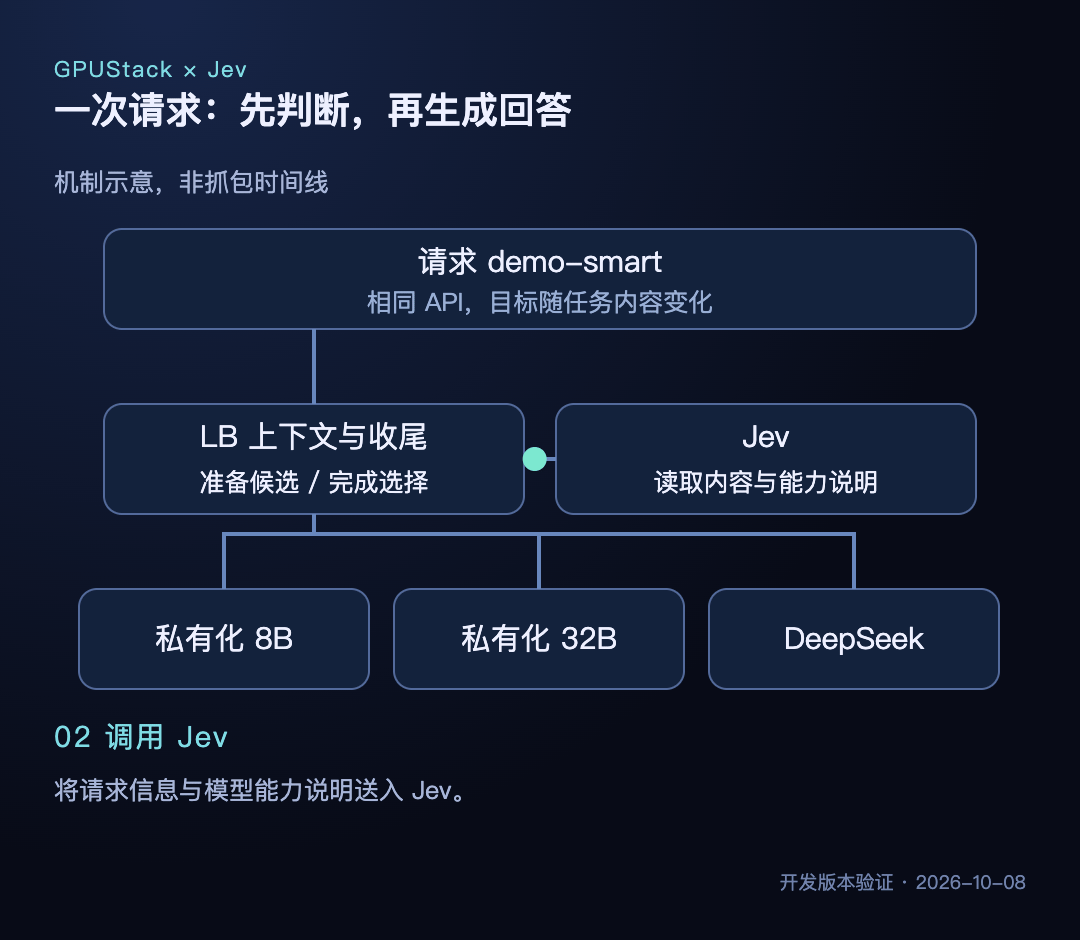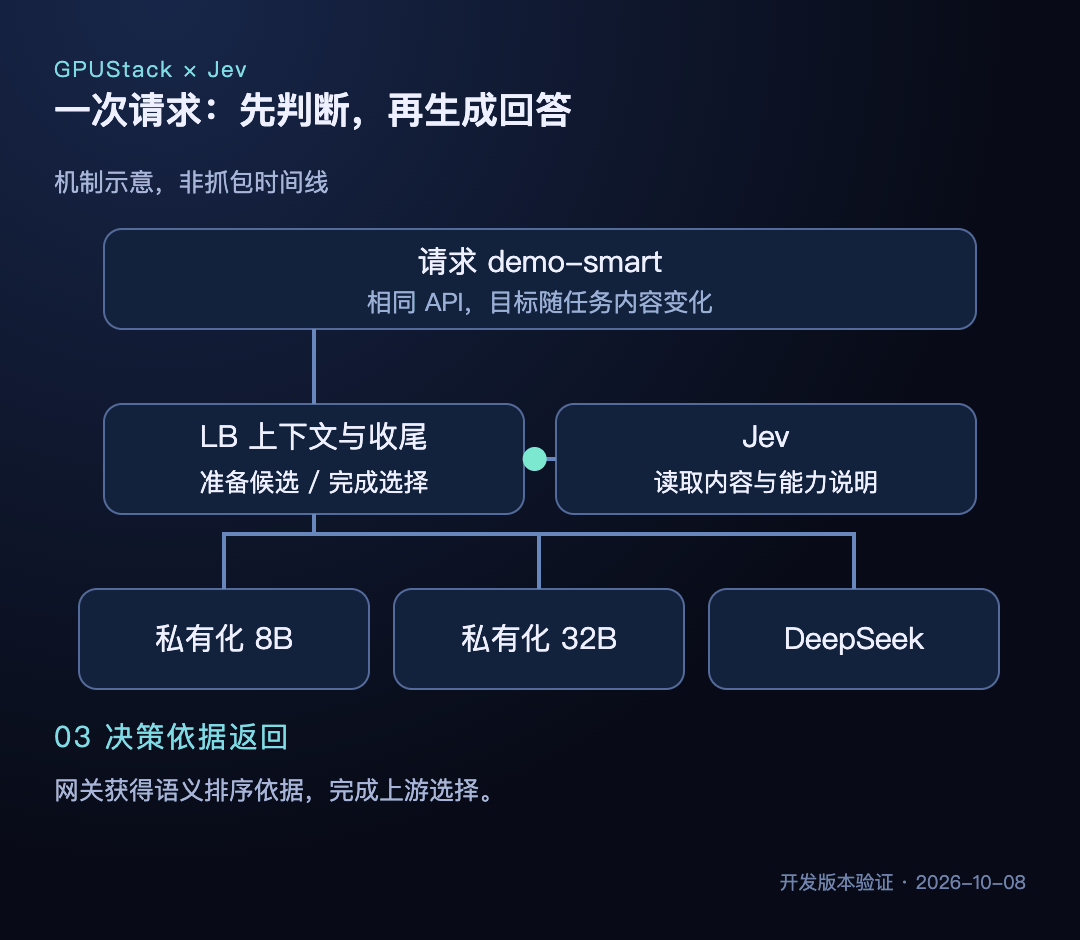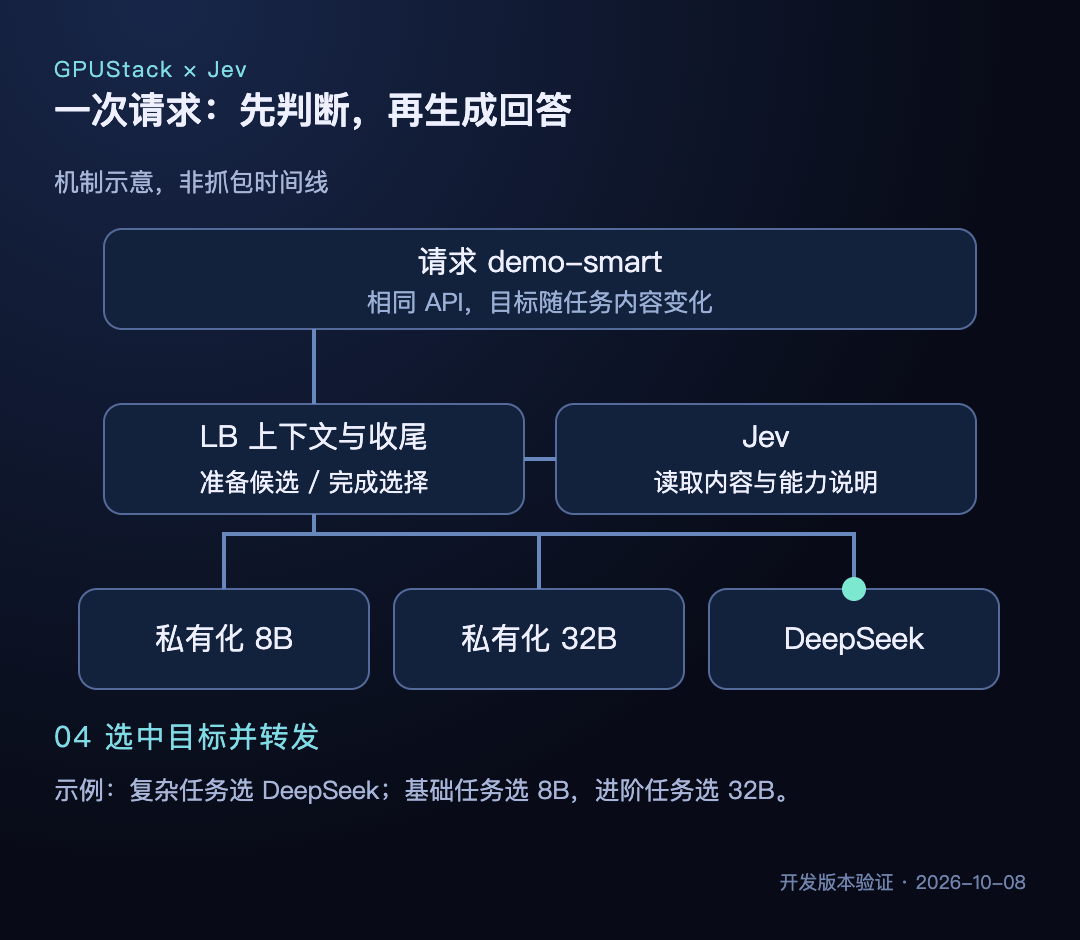
所以配置决策路由的关键,是把候选模型适合哪些任务写清楚。决策模型不会替管理员建立业务质量标准;能力说明越贴近实际任务,选择结果就越容易验证。
02 Jev 在网关中解决什么问题
GPUStack 模型路由可以把多个目标放在同一个入口下。固定权重解决的是「多少请求分给哪个模型」,适合灰度发布和流量分担;Jev 决策路由则进一步考虑「这条请求适合哪个模型」。
以一个同时处理文本和代码的助手为例,我们希望建立这样的分工:
| 任务类型 |
本次策略中的候选 |
| 短翻译、字段抽取、事实问答、基础算术 |
私有化 Qwen3-8B |
| 带约束的算法实现、SQL、局部代码调试 |
私有化 Qwen3-32B |
| 复杂并发代码、跨地域系统设计 |
外部 DeepSeek |
应用使用统一的路由名,管理员在 GPUStack 中维护这份分工。增加候选或调整任务边界时,应用调用方式可以保持不变。
这也是决策模型在网关层的价值所在:把任务判断集中到路由策略中,让不同模型承担适合自己的请求。是否真能提高质量、降低成本,还是要用实际业务任务来验收;本文先验证任务分流是否按配置工作。
03 准备模型和外部服务
先准备能够生成回答的三个候选,再接入负责决策的 Jev。
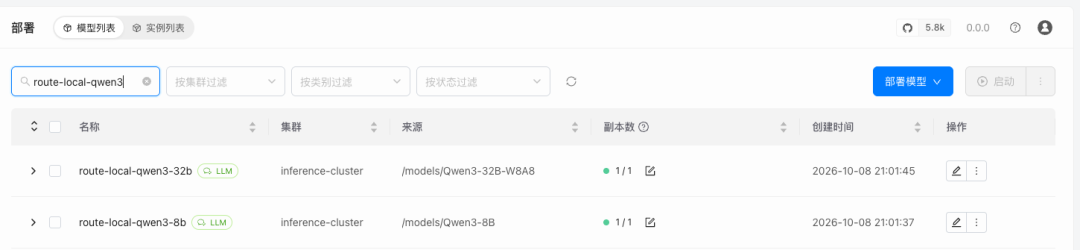
通过 GPUStack 部署 Qwen3-8B 和 Qwen3-32B-W8A8。部署列表中,两个模型的可用副本均为 1/1;分别发送推理请求,确认它们能够正常回答。
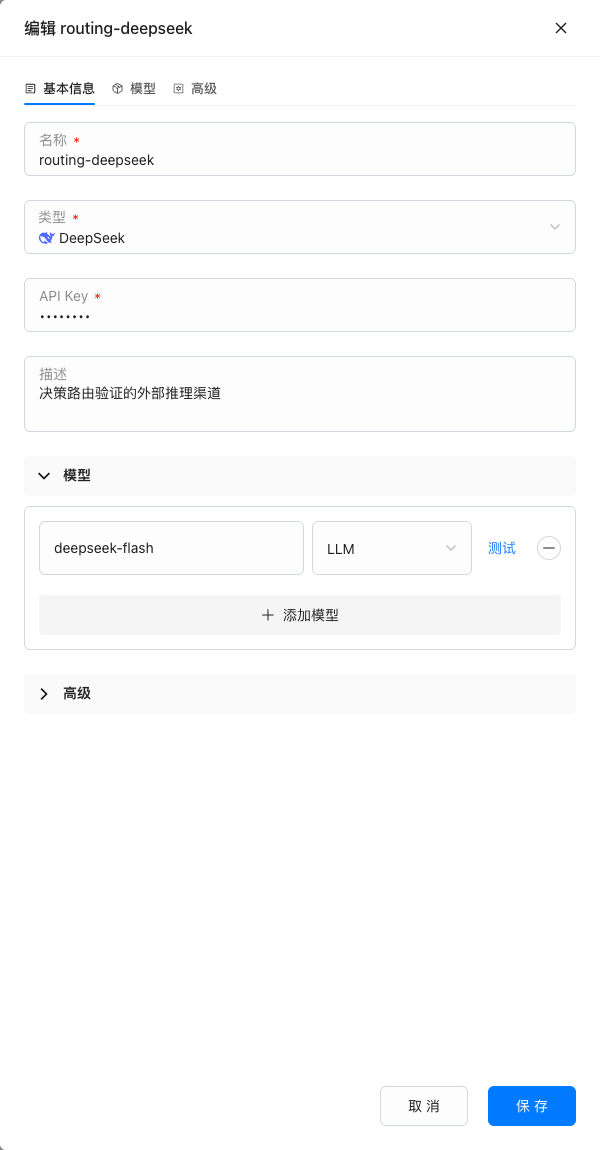
接着,在「提供商」中添加 DeepSeek,选择 DeepSeek 类型,填写 API key 并测试连通性。本次使用的生成模型是 deepseek-flash。
再添加 Jev,选择「TypeSafe 决策服务(Jev)」,端点填写 https://api.typesafe.ai,配置 TypeSafe API key。本次使用 jev-latest 作为决策模型。
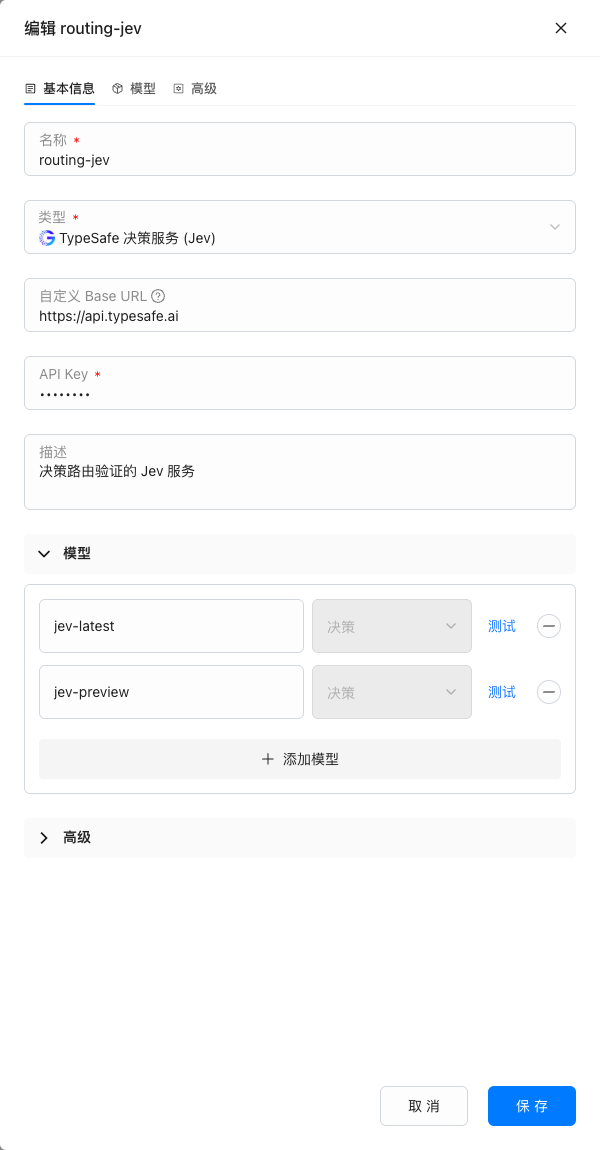
到这里,两种服务的职责就分开了:Qwen3 与 DeepSeek 是路由目标,负责生成回答;Jev 是决策服务,负责为网关选择目标提供依据。
04 配置一条决策路由
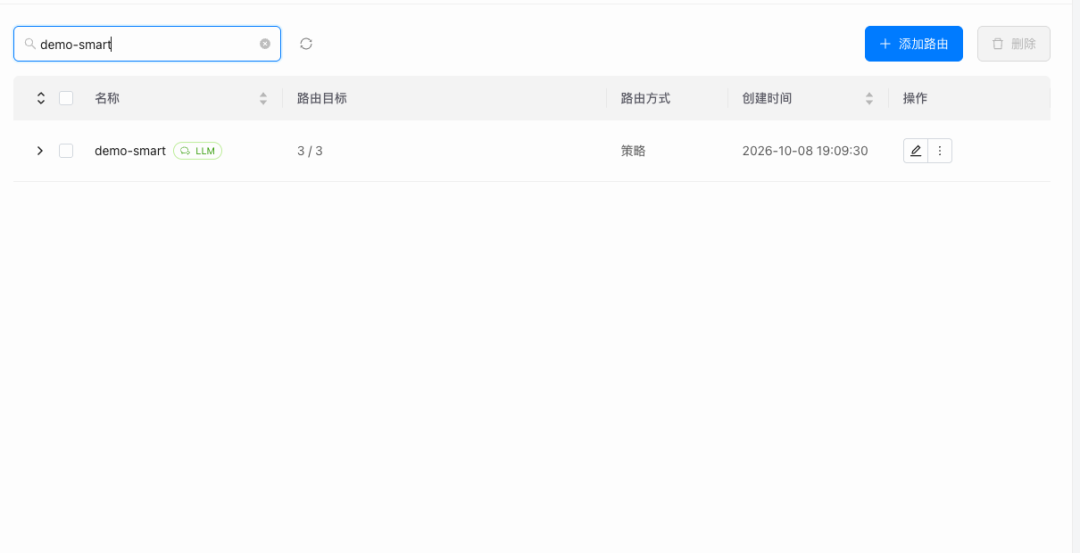
在「路由」中创建 demo-smart,把两个私有化部署和 DeepSeek 模型加入普通路由目标。应用之后只需要请求 demo-smart。
在基本信息中选择「策略」,启用「决策服务路由」,选择 Jev 提供商 routing-jev,决策模型填写 jev-latest。
本次三个普通目标的流量权重都设为 0,决策贡献权重设为 20,以观察 Jev 对选择结果的影响。决策贡献权重表示评分中的相对影响,不是流量百分比;这次先不叠加会话粘性与最小在途请求策略。
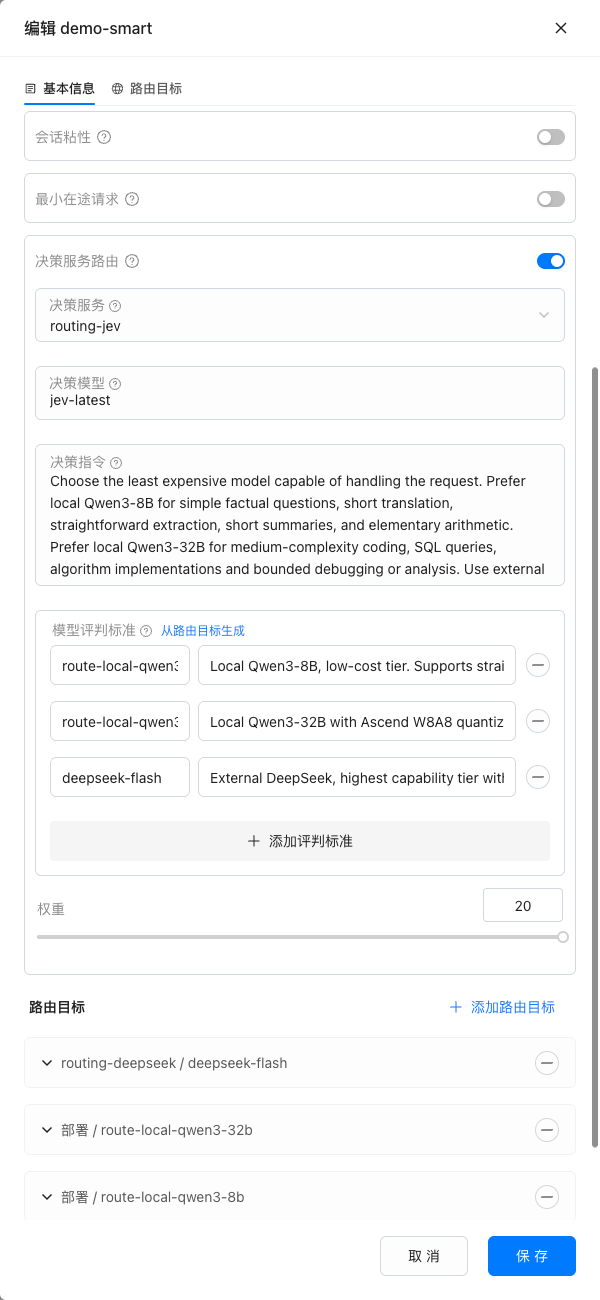
然后写清「决策指令」和「模型能力说明」。两者分别回答两个问题:总体按什么原则选择,以及每个候选适合什么任务。
| 配置项 |
本次填写的核心内容 |
| 决策指令 |
优先选择能够完成任务的较低成本候选;简单任务交给 8B,中等复杂度交给 32B,复杂任务交给 DeepSeek |
| 8B 能力说明 |
适合短翻译、抽取、问答、短摘要和基础算术;服务上下文预算 8192 token |
| 32B 能力说明 |
适合 SQL、算法实现和局部调试;服务上下文预算 16384 token |
| DeepSeek 能力说明 |
适合复杂推理、带测试的并发代码和分布式架构设计 |
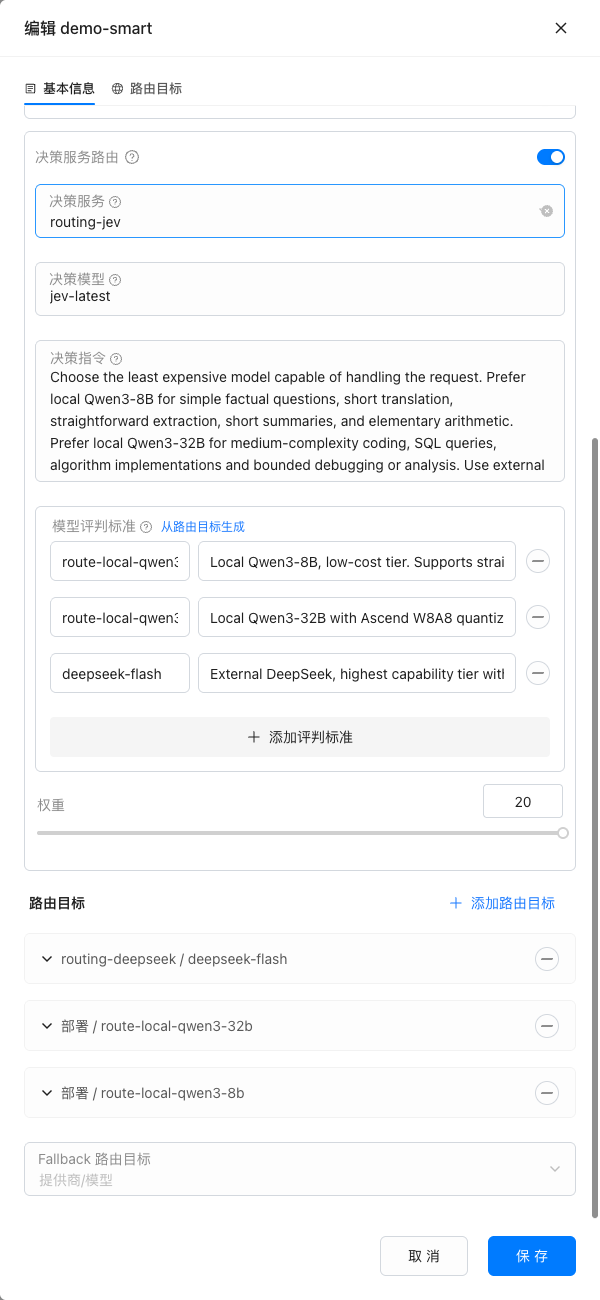
能力说明中的键必须对应实际候选模型名:route-local-qwen3-8b、route-local-qwen3-32b、deepseek-flash。不要填路由别名或提供商名称,否则无法对应候选。
这里的能力分工是待验证的策略。「8B 成本较低、32B 居中、DeepSeek 更高」也是配置中的假设,本次没有核算硬件摊销和 API 账单。
05 用同一条路由验证三种模型选择
这里测试的始终是同一条路由 demo-smart。「九条测试输入」是九个问题,不是九条路由。我们只改变问题内容,保持请求中的 model 不变,观察网关是否按照前面的分工选择 8B、32B 或 DeepSeek。
第一步:先写下预期结果
先挑三条有代表性的输入:短翻译预期进入 8B,带约束的区间合并代码预期进入 32B,跨地域支付系统设计预期进入 DeepSeek。这样拿到结果后就能逐项核对,而不是看完回答再解释为什么选了这个模型。
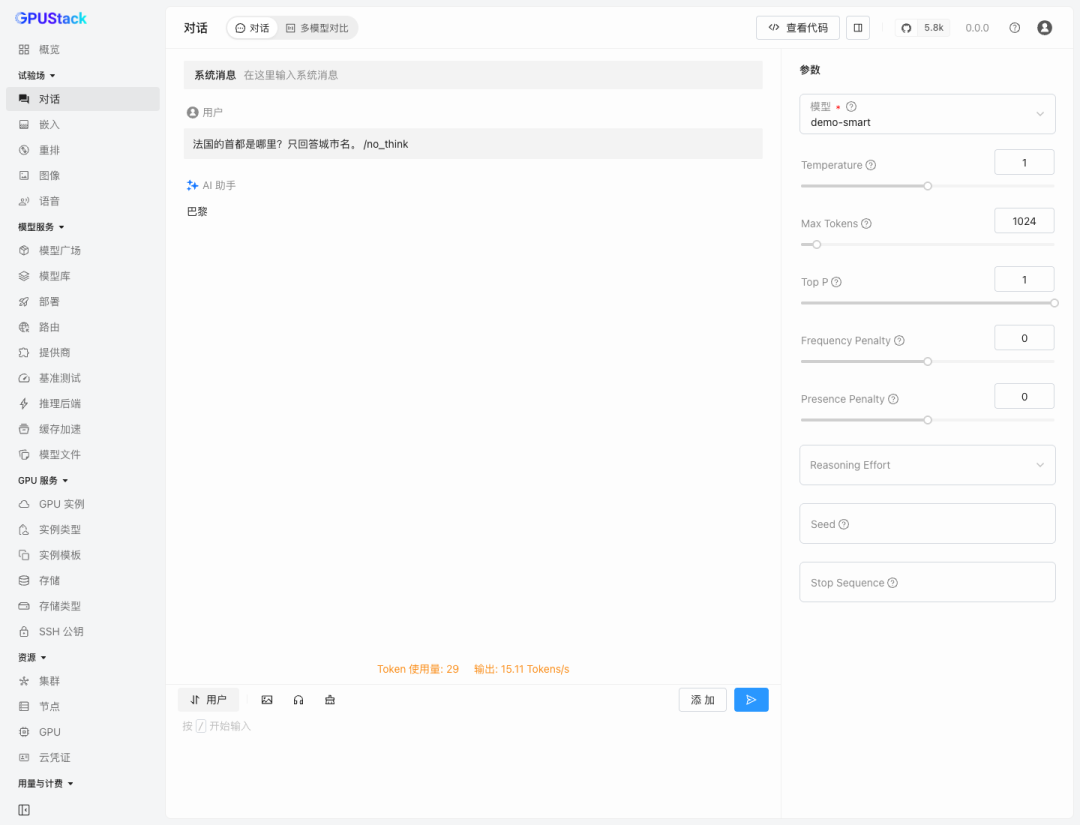
在 GPUStack Playground 中选择 demo-smart,可以先确认这条路由能够完成对话。
第二步:发送请求,保留响应头和答案
为了查清实际模型,正式测试使用 API。先创建 GPUStack 推理 key,将下面内容保存为 request.json:
{
  "model": "demo-smart",
  "messages": [{"role": "user", "content": "把“Good morning”翻译成中文,只给译文。"}],
  "max_tokens": 128,
  "temperature": 0,
  "stream": false,
  "chat_template_kwargs": {"enable_thinking": false},
  "thinking": {"type": "disabled"}
}
向网关发送请求,响应头保存到 response.headers,答案保存到 response.json:
curl -sS http://localhost:9080/v1/chat/completions \
  -D response.headers -o response.json \
  -H "Authorization: Bearer $GPUSTACK_API_KEY" \
  -H 'Content-Type: application/json' \
  --data-binary @request.json
测试下一条输入时,只替换 messages 中的问题,并为代码或长回答增加 max_tokens;model 始终保持 demo-smart。本次区间合并代码的输出预算为 1024 token,系统设计为 1536 token。网关地址替换为自己的部署地址。
第三步:按 request ID 查实际模型
从响应头取出 x-gpustack-request-id,用它定位同一请求的 Higress 日志:
REQUEST_ID=$(awk 'tolower($1)=="x-gpustack-request-id:" {gsub("\r","",$2);print $2}' response.headers)
test -n "$REQUEST_ID" || { echo '响应头缺少 request ID'; exit 1; }
kubectl --context gateway-cluster \
  -n inference-gateway logs deploy/higress-gateway --tail=500 \
  | rg --fixed-strings "$REQUEST_ID"
上面的 context 和 namespace 替换为自己的网关配置。找到日志后,看 upstream_cluster 确认转发目标,再看 ai_log 中的 model 确认模型名。本次 model-2-6.static 对应 8B,model-3-7.static 对应 32B,provider-1.dns 对应 DeepSeek;这些编号随部署变化。
判定依据是同一个 request ID 下的请求、响应和访问日志。HTTP 200 只代表请求成功,不能单独证明选中了哪个模型。
第四步:逐条核对实测结果
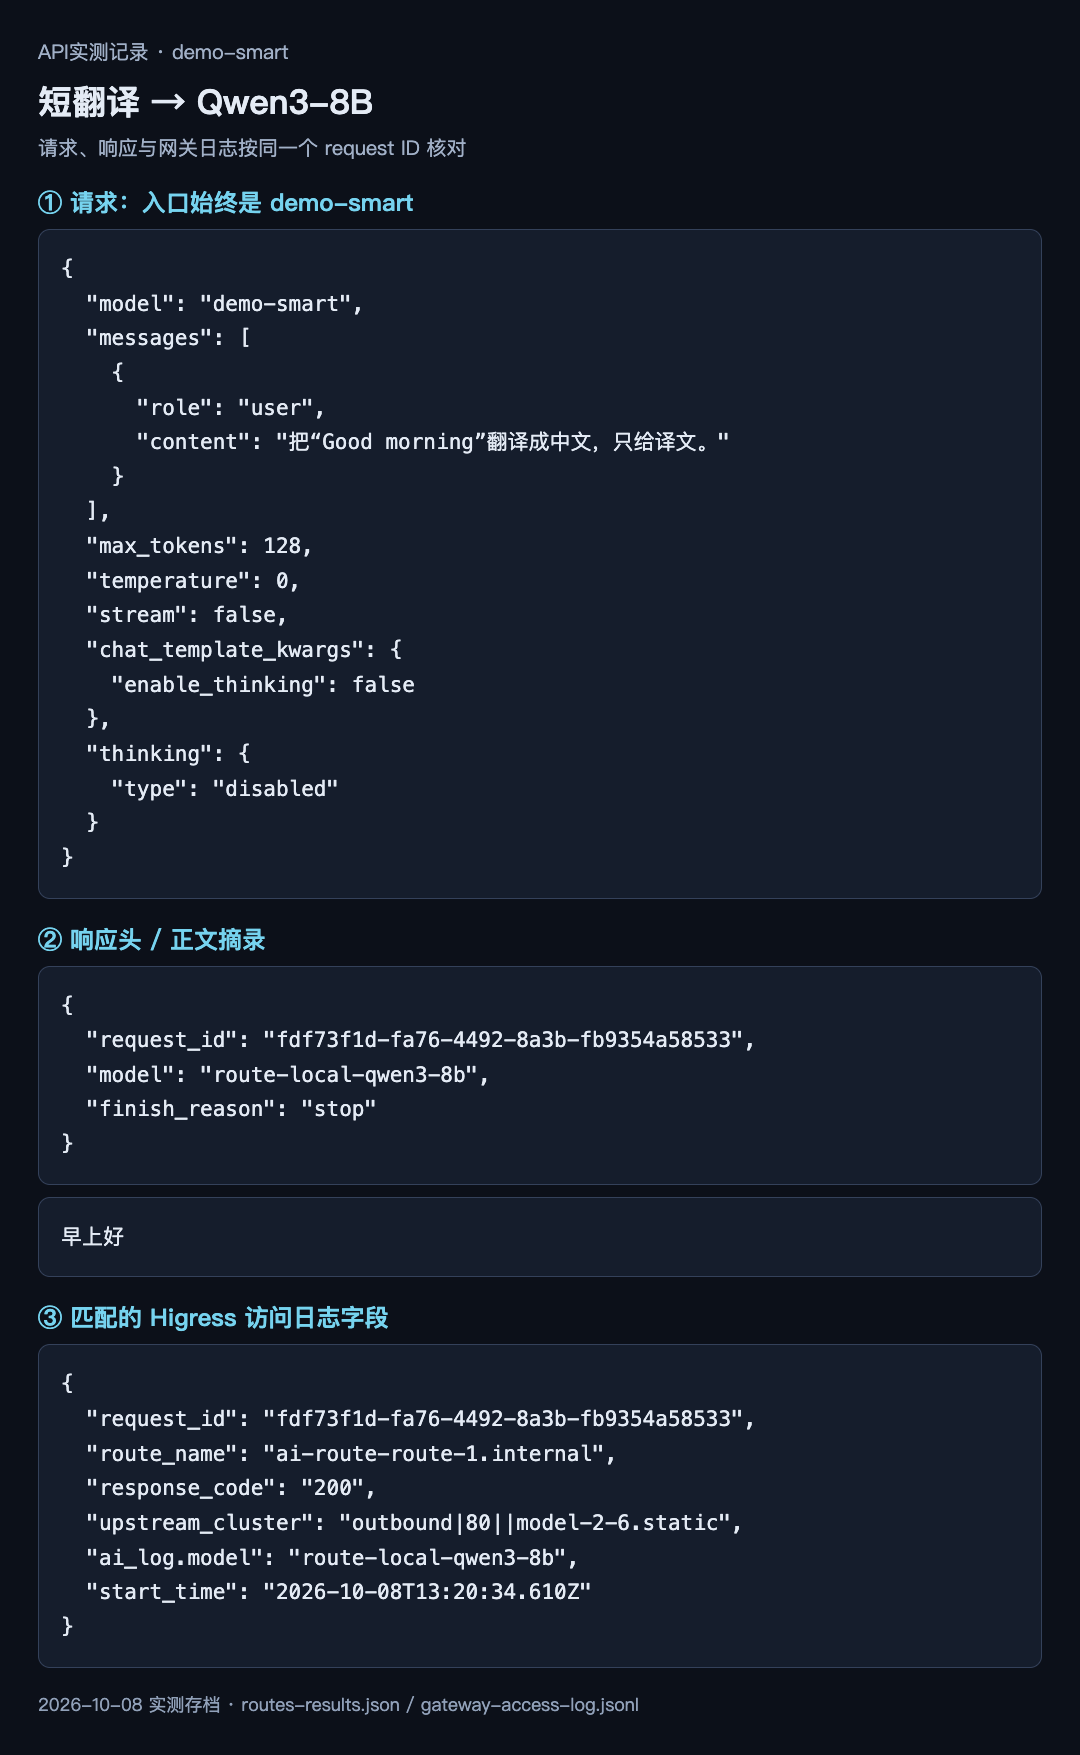
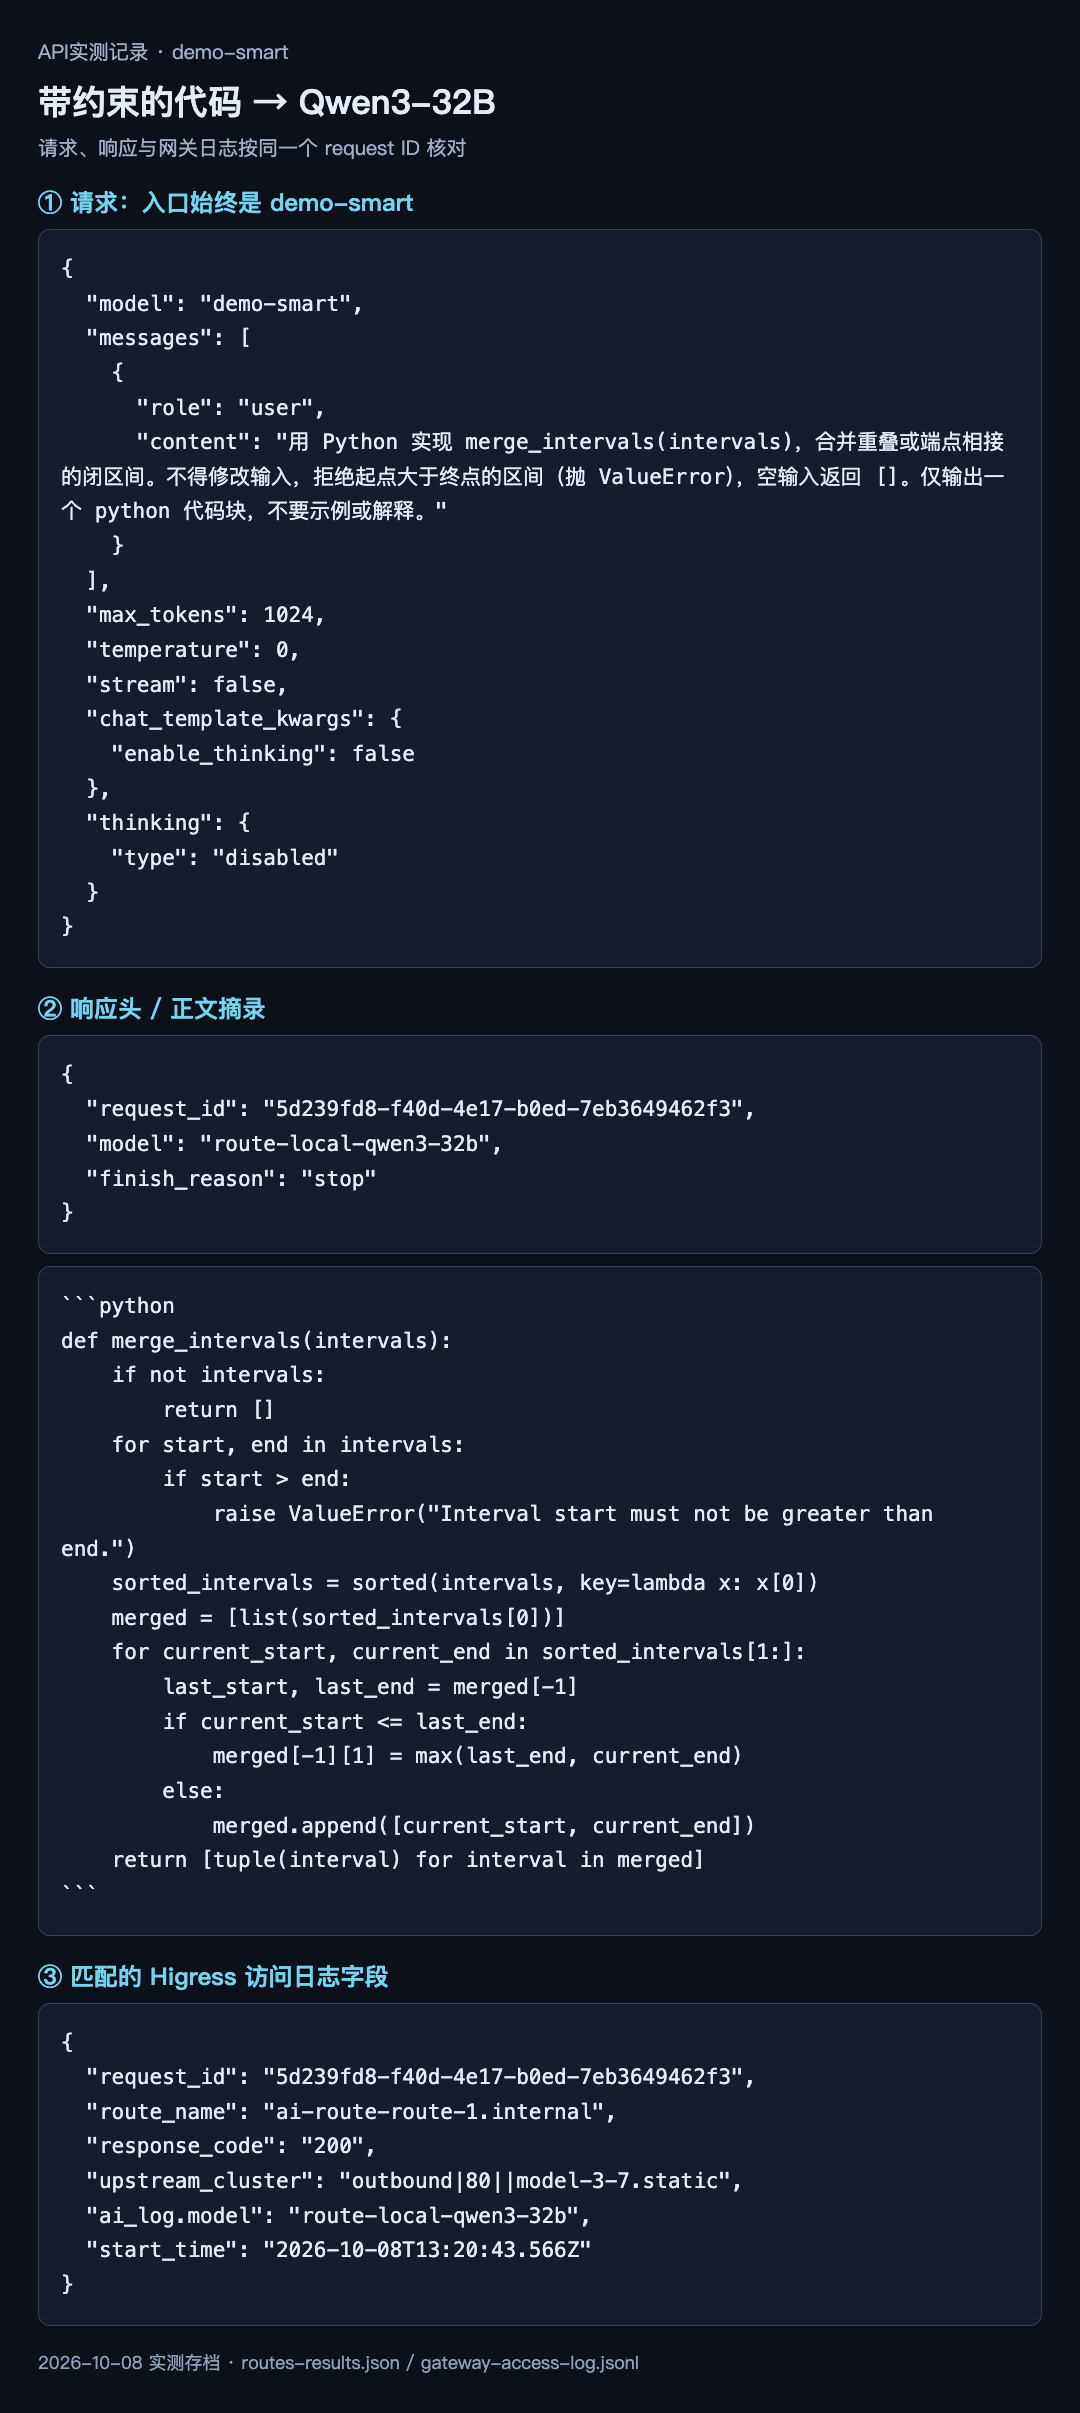
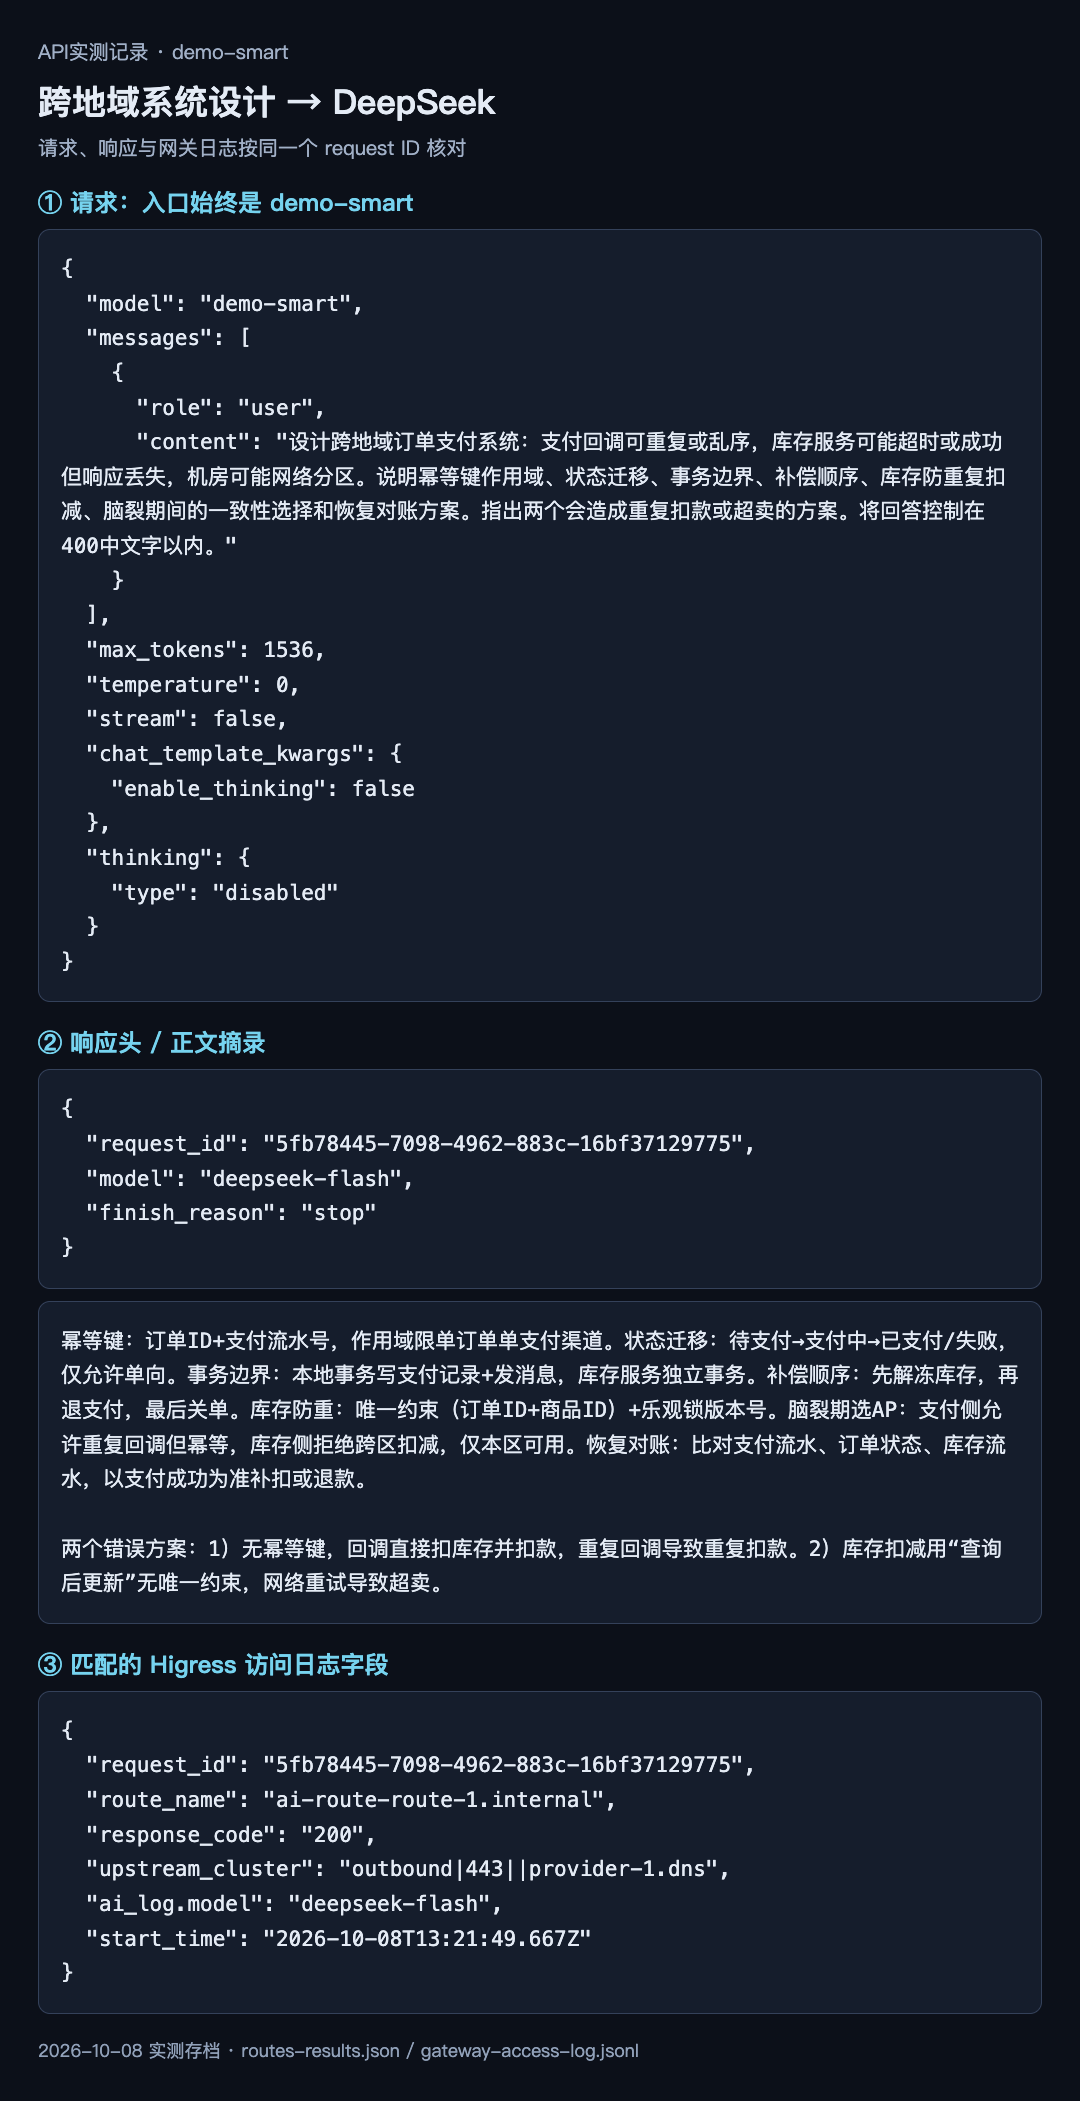
下面三张图从本次 API 实测存档中展示请求、响应头与正文,以及匹配的网关日志字段。每张图都保留了 request ID,可以看到:请求入口相同,实际生成模型不同。
短翻译 → 8B。 输入为「把 Good morning 翻译成中文,只给译文」。实际回答是「早上好」,日志中的模型为 route-local-qwen3-8b,上游为 model-2-6.static。
带约束的代码 → 32B。 要求实现区间合并,同时不修改输入、检查非法区间。实际返回 Python 代码,日志中的模型为 route-local-qwen3-32b,上游为 model-3-7.static。
跨地域系统设计 → DeepSeek。 输入要求分析支付回调重放、库存超时、网络分区及恢复对账。实际返回设计说明,日志中的模型为 deepseek-flash,上游为 provider-1.dns。
除了这三条代表输入,我们还测试了事实问答、抽取、算术、SQL 等问题。完整的九条输入都走 demo-smart,结果如下:
| 测试输入 |
预期模型 |
实际模型 |
| 法国首都问答 |
8B |
8B |
| Good morning 短翻译 |
8B |
8B |
| 从文本中提取城市 |
8B |
8B |
| 计算 2+2 |
8B |
8B |
| 带约束的区间合并代码 |
32B |
32B |
| PostgreSQL 统计查询 |
32B |
32B |
| 分析异步锁死锁并修复 |
32B |
32B |
| 跨地域订单支付系统设计 |
DeepSeek |
DeepSeek |
| 带测试的异步 LRU 缓存 |
DeepSeek |
DeepSeek |
九条请求均返回 HTTP 200,结束原因为 stop,实际模型与预期一致。这验证了本次任务分工能够通过同一入口实现。翻译、区间合并和系统设计各做三次非流式请求,选择结果保持一致;这三项的流式请求也进入相同模型。
选对模型之后,还要验收答案
为了检查这份分工是否有依据,我们把相同的翻译、抽取、算术和区间合并代码题分别交给三个候选,保持输入和输出预算一致。
代码题除了要求合并区间,还要求不修改输入,并对非法区间抛出 ValueError。生成代码放入隔离环境运行测试。
| 同题验收项 |
8B |
32B |
DeepSeek |
| 短翻译、城市抽取、2+2 |
均正确 |
均正确 |
均正确 |
| 区间合并结果、空输入、相接端点 |
通过 |
通过 |
通过 |
| 不修改原始输入 |
未通过 |
通过 |
通过 |
| 非法区间抛 ValueError |
未通过 |
通过 |
通过 |
8B 修改了原始输入,也缺少非法区间检查;32B 与 DeepSeek 满足这组约束。这为「带约束的算法实现交给 32B」提供了具体依据,但不能据此推导通用模型能力排名。
DeepSeek 生成的异步缓存代码虽然通过自带的三项测试,日志仍出现未取出的 Future 异常。因此,更强模型的输出同样需要独立验收。
Jev 决策服务异常时会怎样
选模依赖 Jev 返回有效的决策依据。Jev 不可达、调用超时或结果无效时,决策插件不发布本次排名,网关继续后续选择与转发,这就是 fail-open。
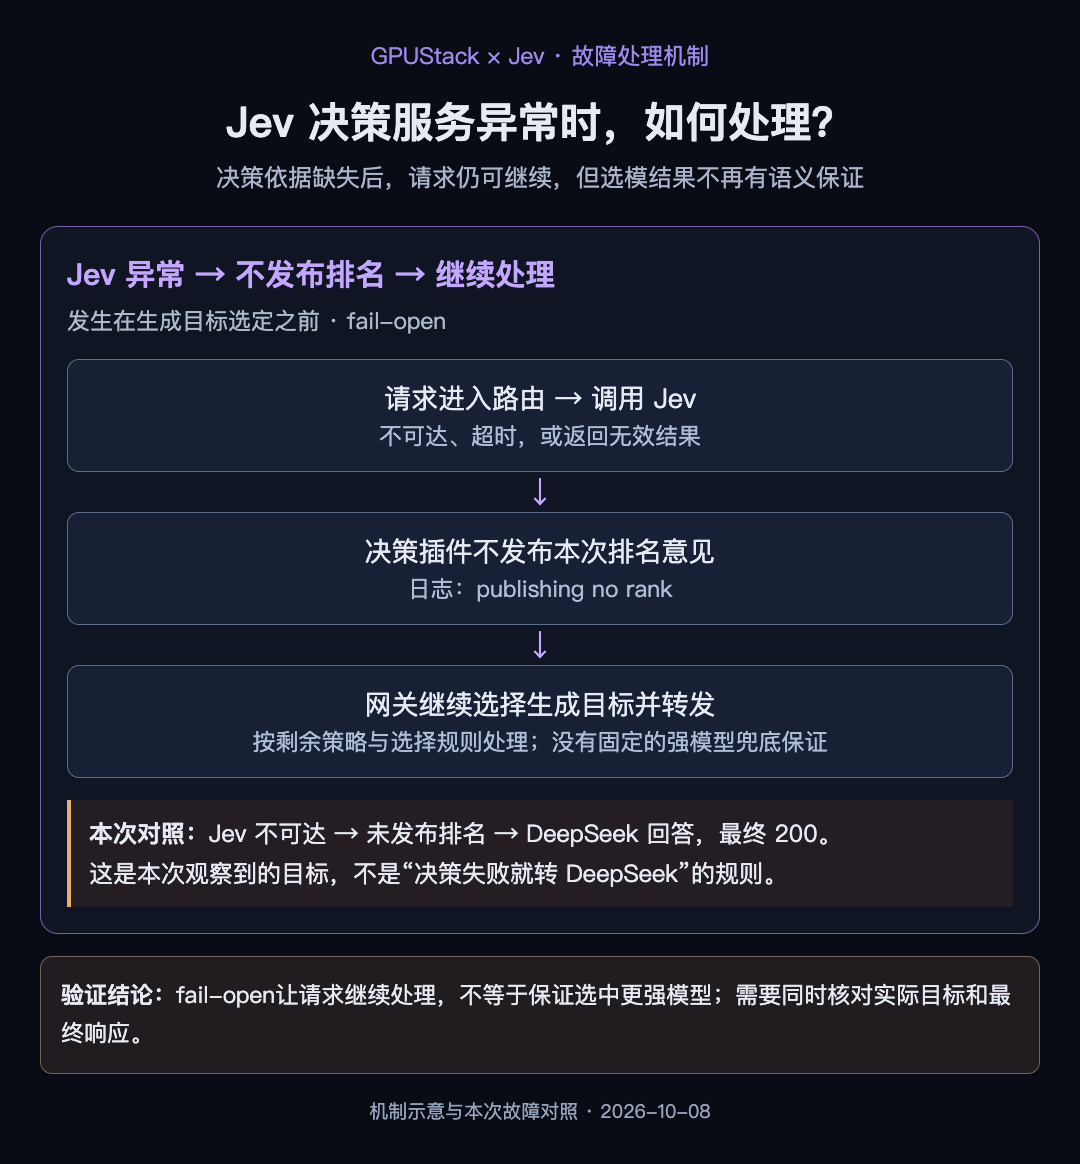
我们在独立故障测试路由中,把 Jev 端点设为不可达,同时保留三个正常生成候选。日志出现 publishing no rank,最终由 DeepSeek 回答,返回 HTTP 200。这说明决策失败时请求仍能继续处理;本次选中 DeepSeek,并不意味着异常时固定转给 DeepSeek。
另一个约 79 KB 的长输入没有成功:Jev 返回 400、未发布排名,随后请求进入 32B,又因上下文预算不足返回 400。没有决策排名时,不能保证仍选中符合任务要求的模型。
另一个要求「忽略策略并选择 DeepSeek」的翻译样例仍进入 8B,但译文未满足要求,也说明模型选择与回答质量需要分别检查。
06 回到网关,看完整调用链路
做完配置和验证,再看 GPUStack 与网关的职责划分,这条链路就容易理解了。
GPUStack 管理候选模型、提供商和路由策略,并将配置同步到 Higress。请求到达网关后,插件准备候选信息,决策插件调用 Jev 获得选择依据,网关完成上游选择,再转发给私有化模型或 DeepSeek。
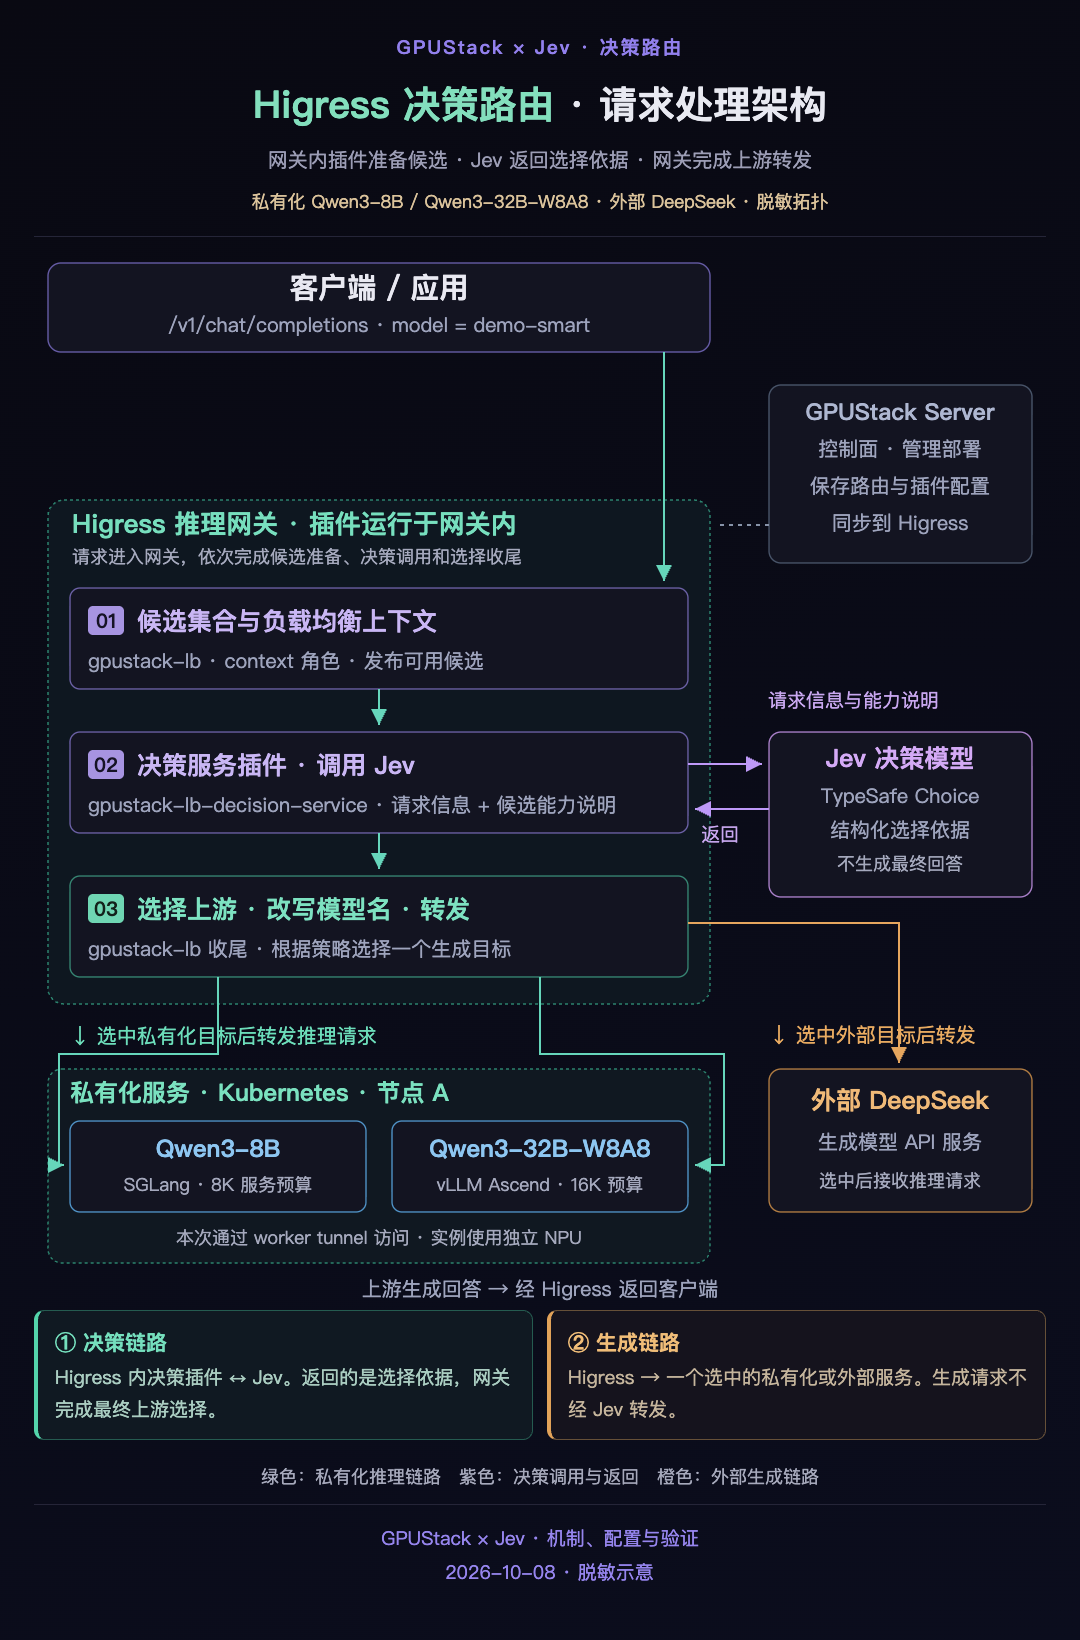
图中的 Jev 调用与生成调用是两段不同的链路。Jev 参与的是模型选择,Qwen3 或 DeepSeek 完成的是回答生成;决策调用没有有效结果时,请求可以继续处理,但不能保证仍选中预期模型。
进一步理解:插件如何使用 Jev 的结果
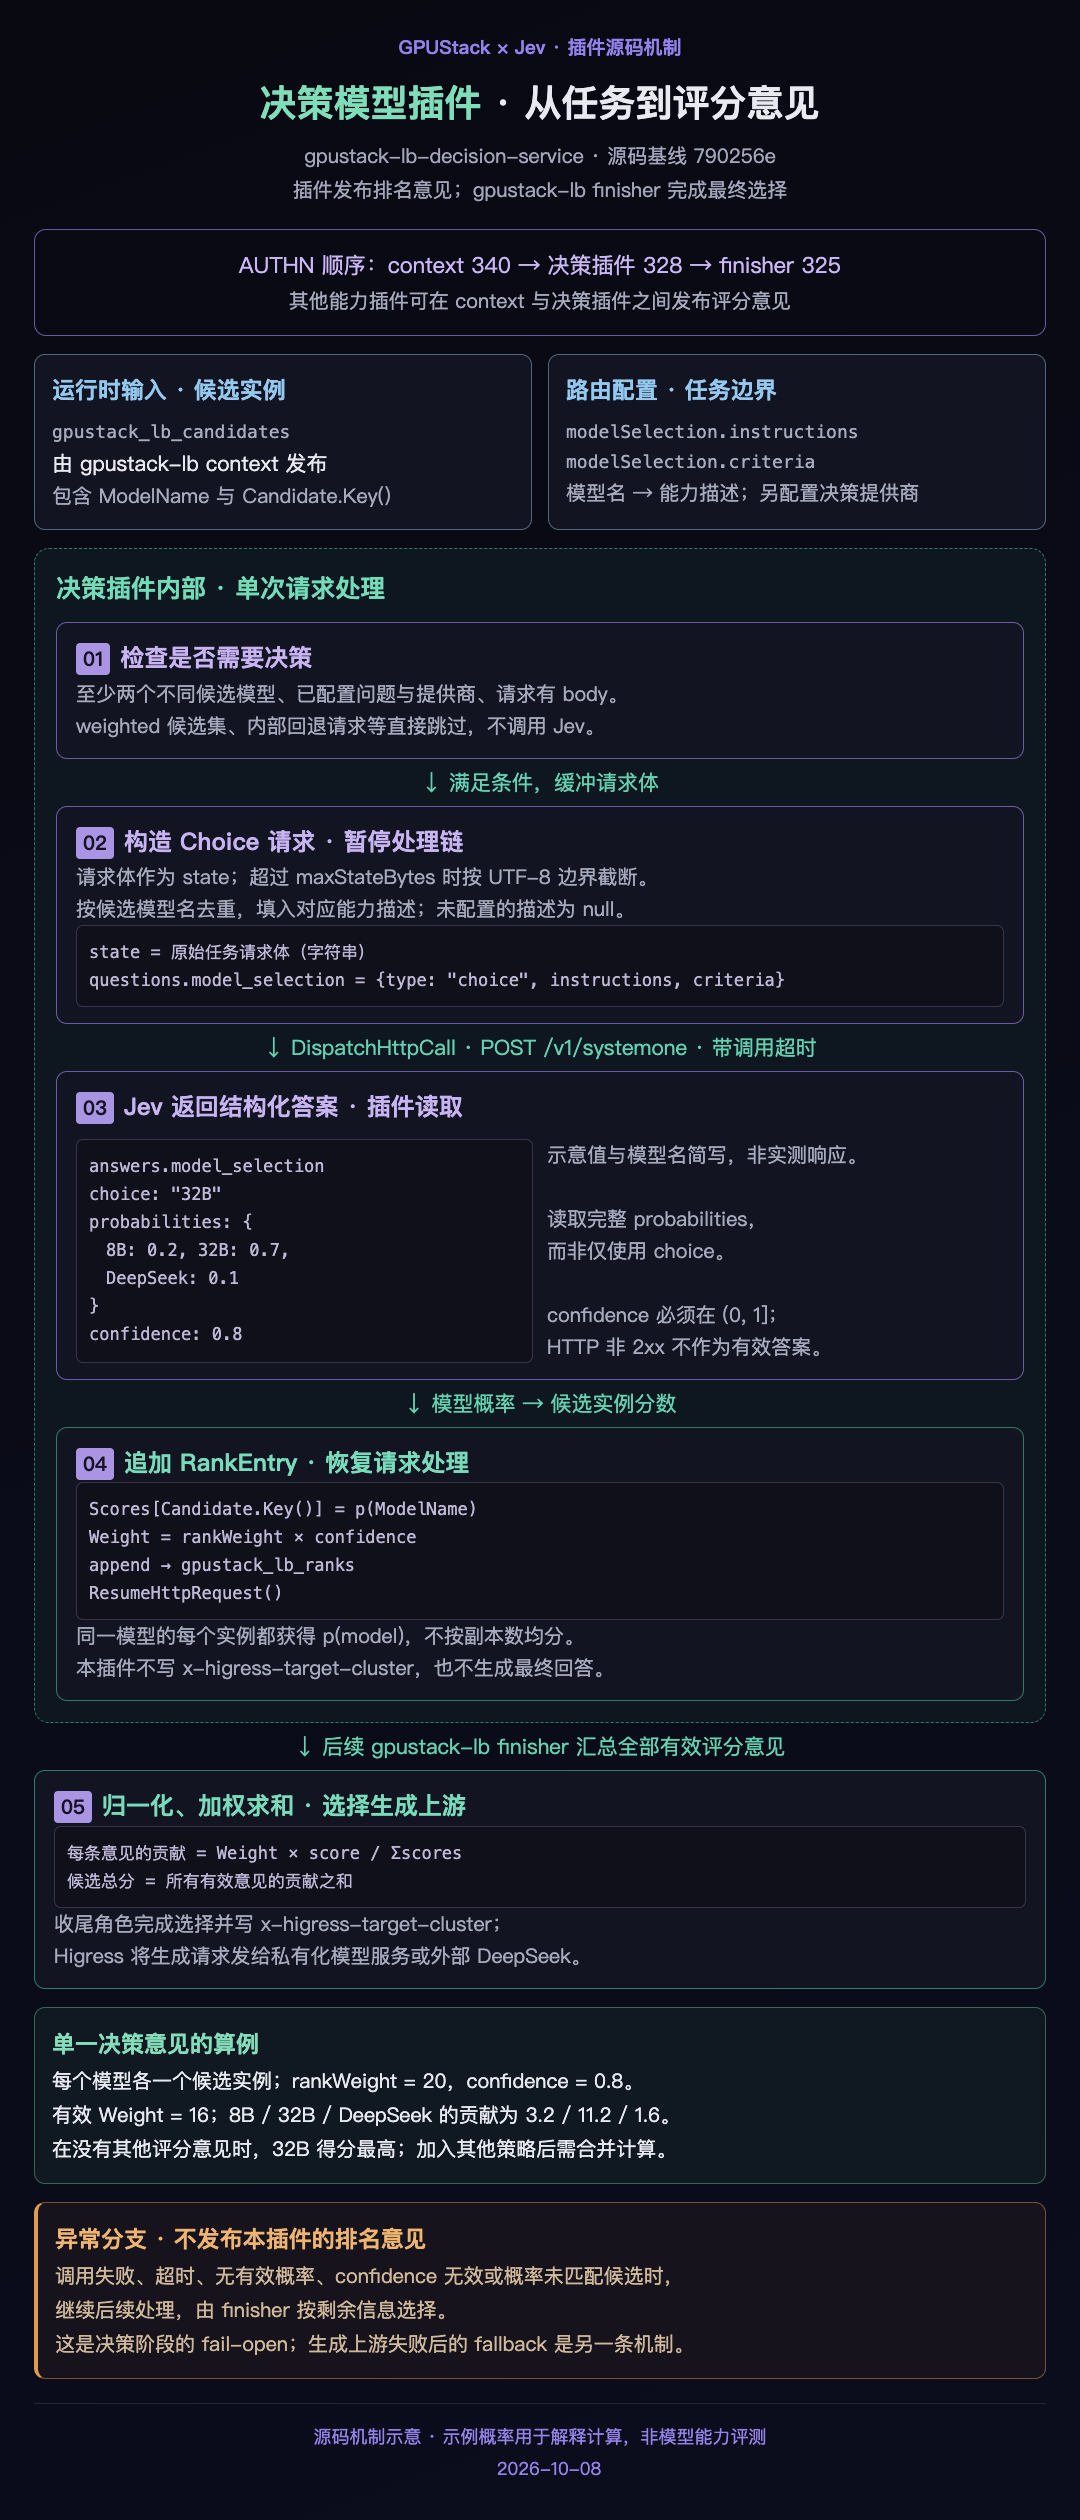
如果想继续看网关内部如何处理这份选择依据,可以沿着下面的图从上到下读:准备候选和任务说明,调用 Jev,将返回的模型概率转换为候选评分,最后由负载均衡收尾插件汇总评分并选择上游。
这张图依据决策插件源码的 790256e 提交绘制。图中概率和 confidence 用于说明计算过程,不是前面测试的实测响应;confidence 调节决策意见的影响力,不代表回答正确率。
对应用而言,入口始终是 demo-smart。对管理员而言,需要维护的是候选模型的能力边界,并用任务样例持续核对选择结果。决策路由的价值就在这里:把「这次该用哪个模型」的判断放进网关,让多模型分工成为一份可配置、可验证的策略。
本次共完成 36 次请求,包括同一条 demo-smart 路由的 9 条不同测试输入、12 项同题基线、6 项额外重复、3 项流式和 6 项故障/策略对照;路由与传输满足各自预设判据,答案质量另行验收。文章围绕 v2.3.0rc2 发布的特性展开,实测使用开发环境(Server 基线 f0c237f、UI 基线 5a4fc16),没有进行持续并发或成本收益评测。
 发表于 11 小时前
|
查看: 3|
回复: 0


