在 A100 上生成一段 5 秒视频,用 vLLM-Omni 跑 50 步的记录是 251.9 秒;改用 SGLang,运行 6 步并开启加速 LoRA、SageAttention2 和 Cache-DiT 之后,三条记录的中位数是 24.35 秒。
生成端缩短等待,高清端再交给 SeedVR2。《墨境》六职业游戏选角 CG,就是这条流程的实际制作案例:人物、动作、运镜由 MiniMax-H3 生成,通过验收的镜头再超分到 1080P。
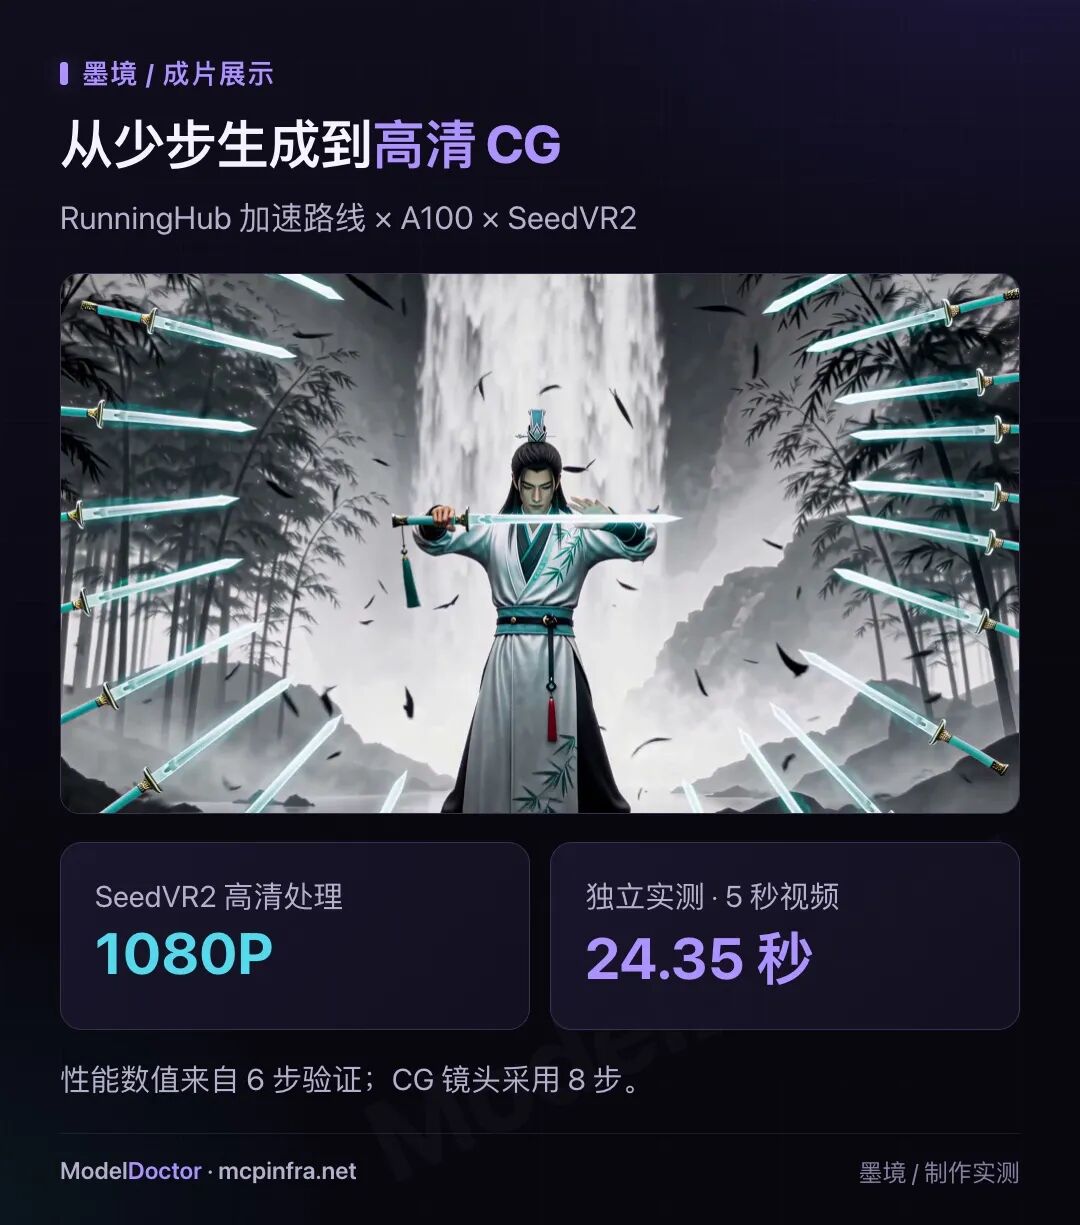
1. A100:5 秒视频,从 251.9 秒到 24.35 秒
加速验证采用 4×A100-SXM4 80GB、SGLang 0.5.19,启用公开 Turbo LoRA、SageAttention2 与 Cache-DiT,关闭 torch.compile。请求 5 秒、1344×768、24fps,实际输出 124 帧;6 步生成的三条提示词耗时分别为 25.29、24.35、24.31 秒,产物均通过格式检查。
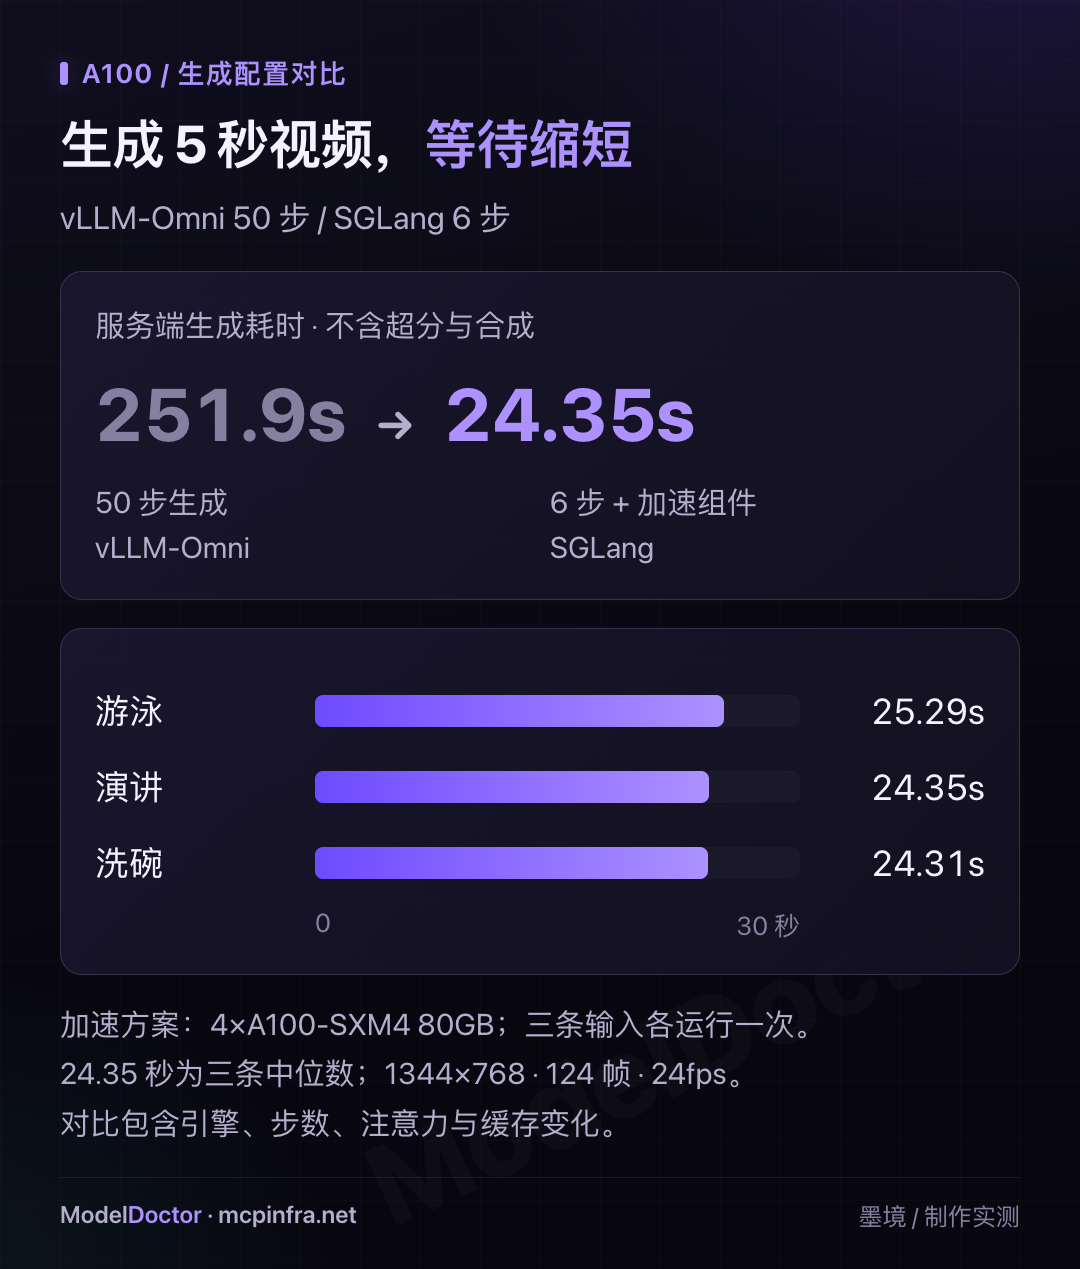
24.35 秒是三条不同输入各运行一次的中位数,不是同一输入反复测试得出的稳定性结论。统计口径是服务端生成时间,不包含 SeedVR2、后期合成、排队或下载。
两组记录同时改变了推理引擎、采样步数和执行优化,展示的是整套生成配置的耗时差异,不能把全部收益都归因于 LoRA。
这档性能对制作的意义,是缩短一次镜头试错的等待。人物动作不合要求时,仍要修改提示词、筛选与重新生成;生成变快,才更容易在有限时间里多试几版。
2. RunningHub 的加速方法,我们用了哪些
RunningHub H3 Lightning 将加速拆成少步生成、执行优化和多卡协作三部分。官方 8×RTX 6000D 的 5 秒视频对照,从 50 步 348.8 秒降到完整优化后的 4 步 28.7 秒;不过这组结果使用 RH 自训权重,不能直接套到我们的 A100 和社区 LoRA 上。RunningHub 官方说明
我们沿用它的技术路线,采用公开 larryvrh/MiniMax-H3-Turbo-Lora;参考图任务另用 LightX2V 的 Ref2VA 加速 LoRA,没有自行训练这些权重。
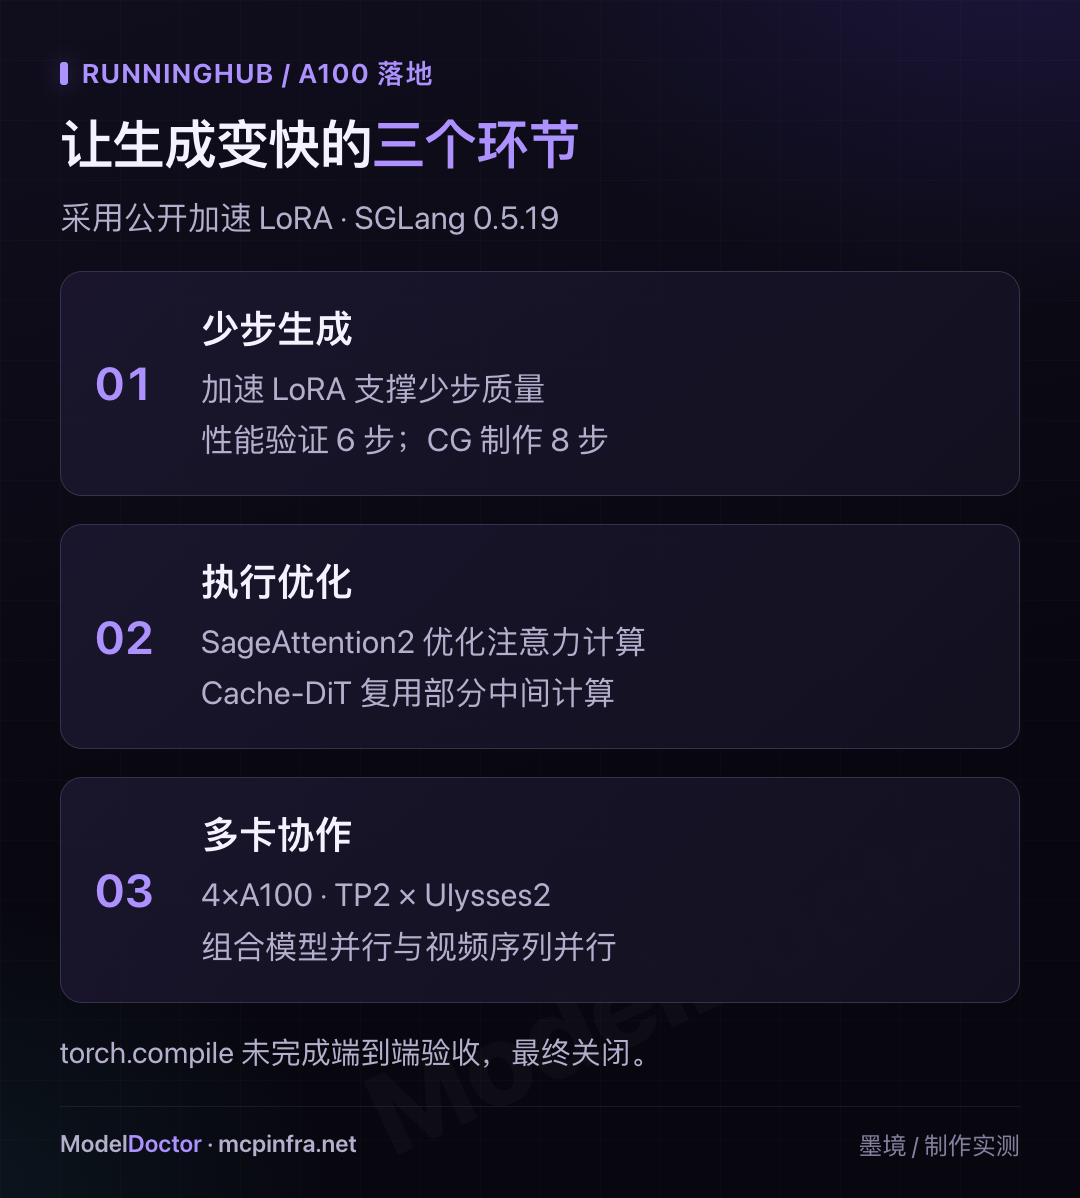
普通风格 LoRA 主要改变画面内容,加速 LoRA 的目标则是让模型用更少的去噪步骤生成可用画面。减少步骤省下计算,少步训练支撑画质,两者需要一起看。
执行层中,SageAttention2 优化注意力计算,Cache-DiT 复用部分中间结果。多卡采用 TP2×Ulysses2,分别拆分模型计算和视频序列。torch.compile 在这次部署中未完成端到端出片验收,最终关闭。
为了分清“减少步数”和“加载 LoRA”的作用,我们在另一种硬件 PPU 上补了对照。固定引擎、输入规格和 seed,改变步数与 LoRA:50 步无 LoRA 的中位数为 443.31 秒,4、6、8 步 LoRA 分别为 31.94、49.81、67.69 秒,每档十条不同提示词各运行一次。
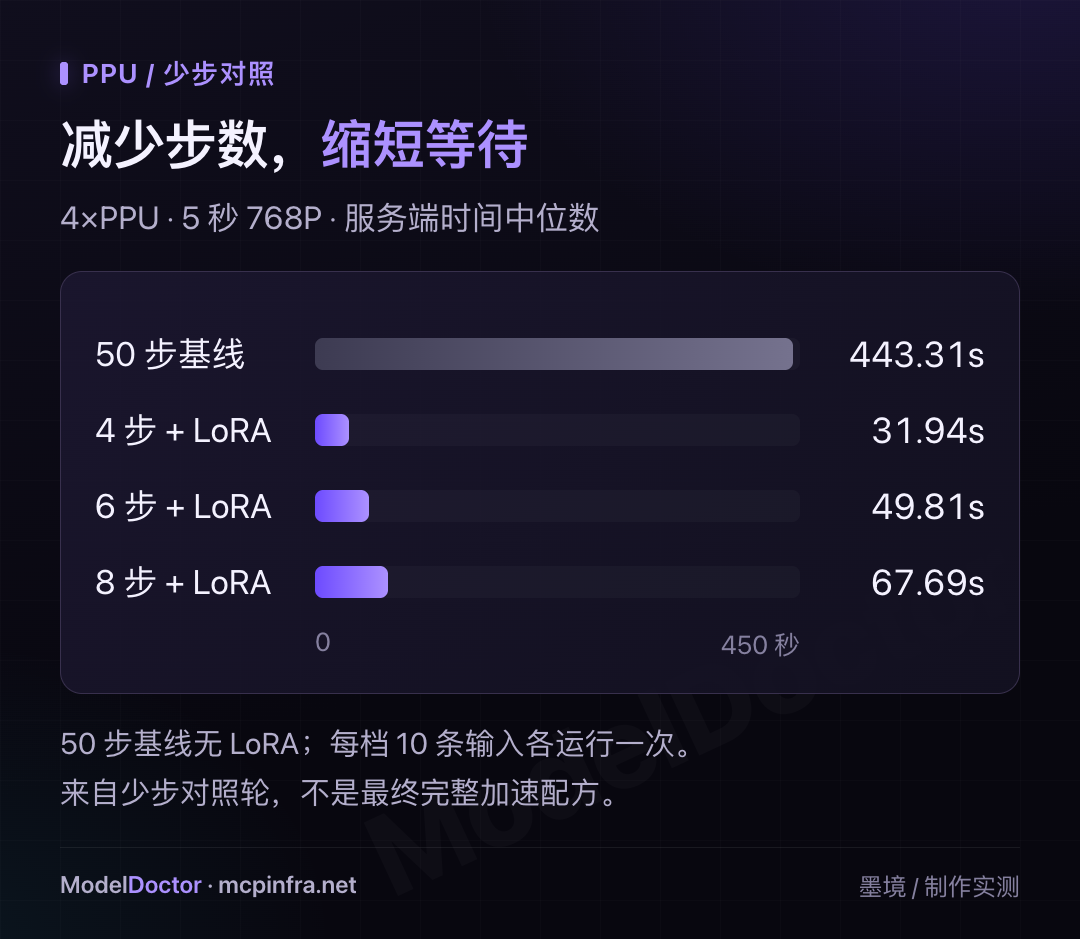
这些性能数值来自少步对照轮的归档日志,不是最终整套加速配方。随后补跑的质量对照更能说明 LoRA 的作用:同样是 4 步,游泳场景不带 LoRA 时主体模糊,加载后人物出现。
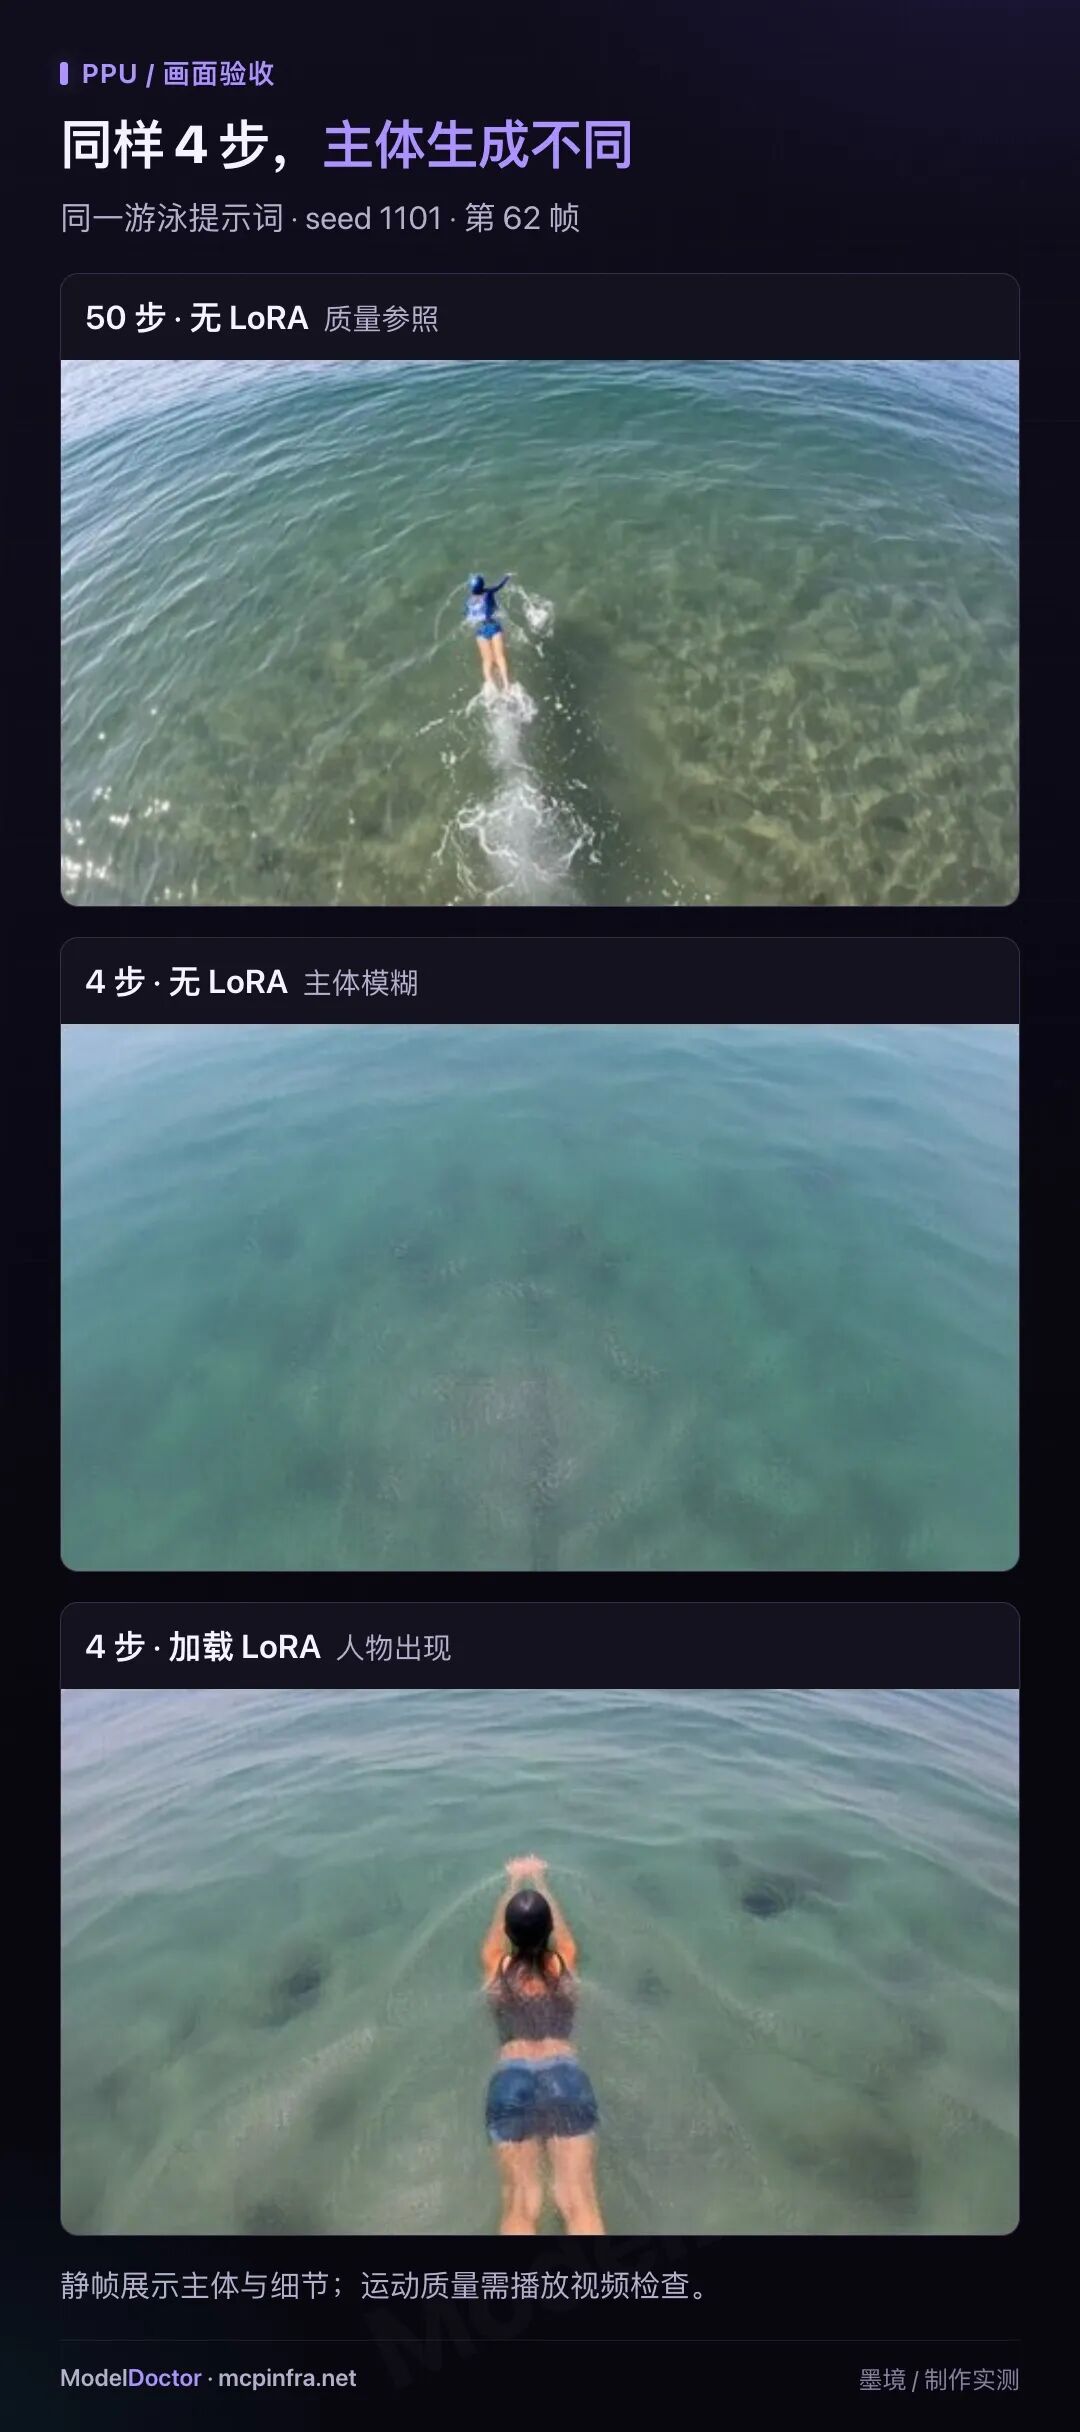
同一提示词、seed 1101、第 62 帧,能观察主体与细节的差别。它支持少步质量改善,但静帧不能证明动作连贯,也没有证明所有题材都能无损提速。
《墨境》的制作镜头采用 8 步,包含角色演出和较大幅度运镜;24.35 秒则属于 5 秒、6 步的性能验证。实际制作要按动作复杂度选档位,不能把这一个速度数字贴到所有 CG 镜头上。
3. SeedVR2:先筛片,再处理成高清素材
生成阶段先用 768P 完成人物、构图和动作验证,合格片段再进入超分。如果动作已经错了,清晰度再高也无法交付,先筛片能避免把第二轮计算花在废片上。
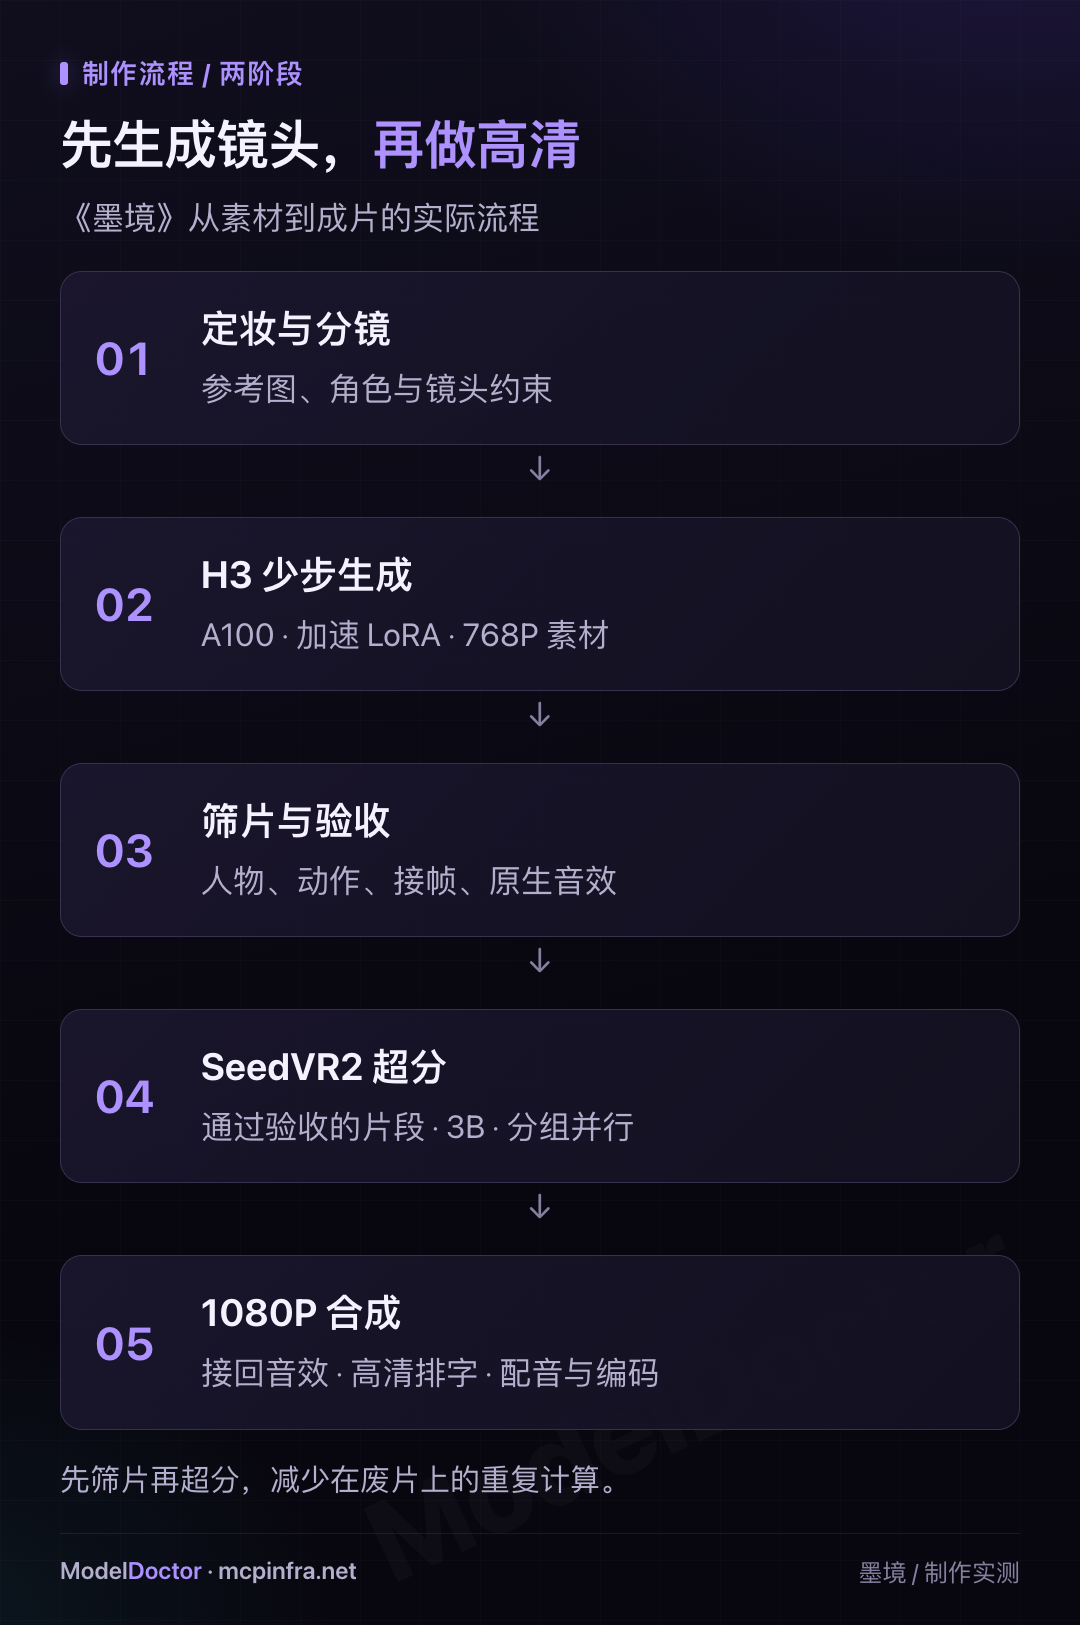
我们采用字节跳动开源的 SeedVR2-3B,对通过验收的镜头做高清处理。它使用一步式视频修复,但整个任务仍包含编码、模型计算和解码;“一步”不等于只需很短时间。SeedVR2 官方仓库
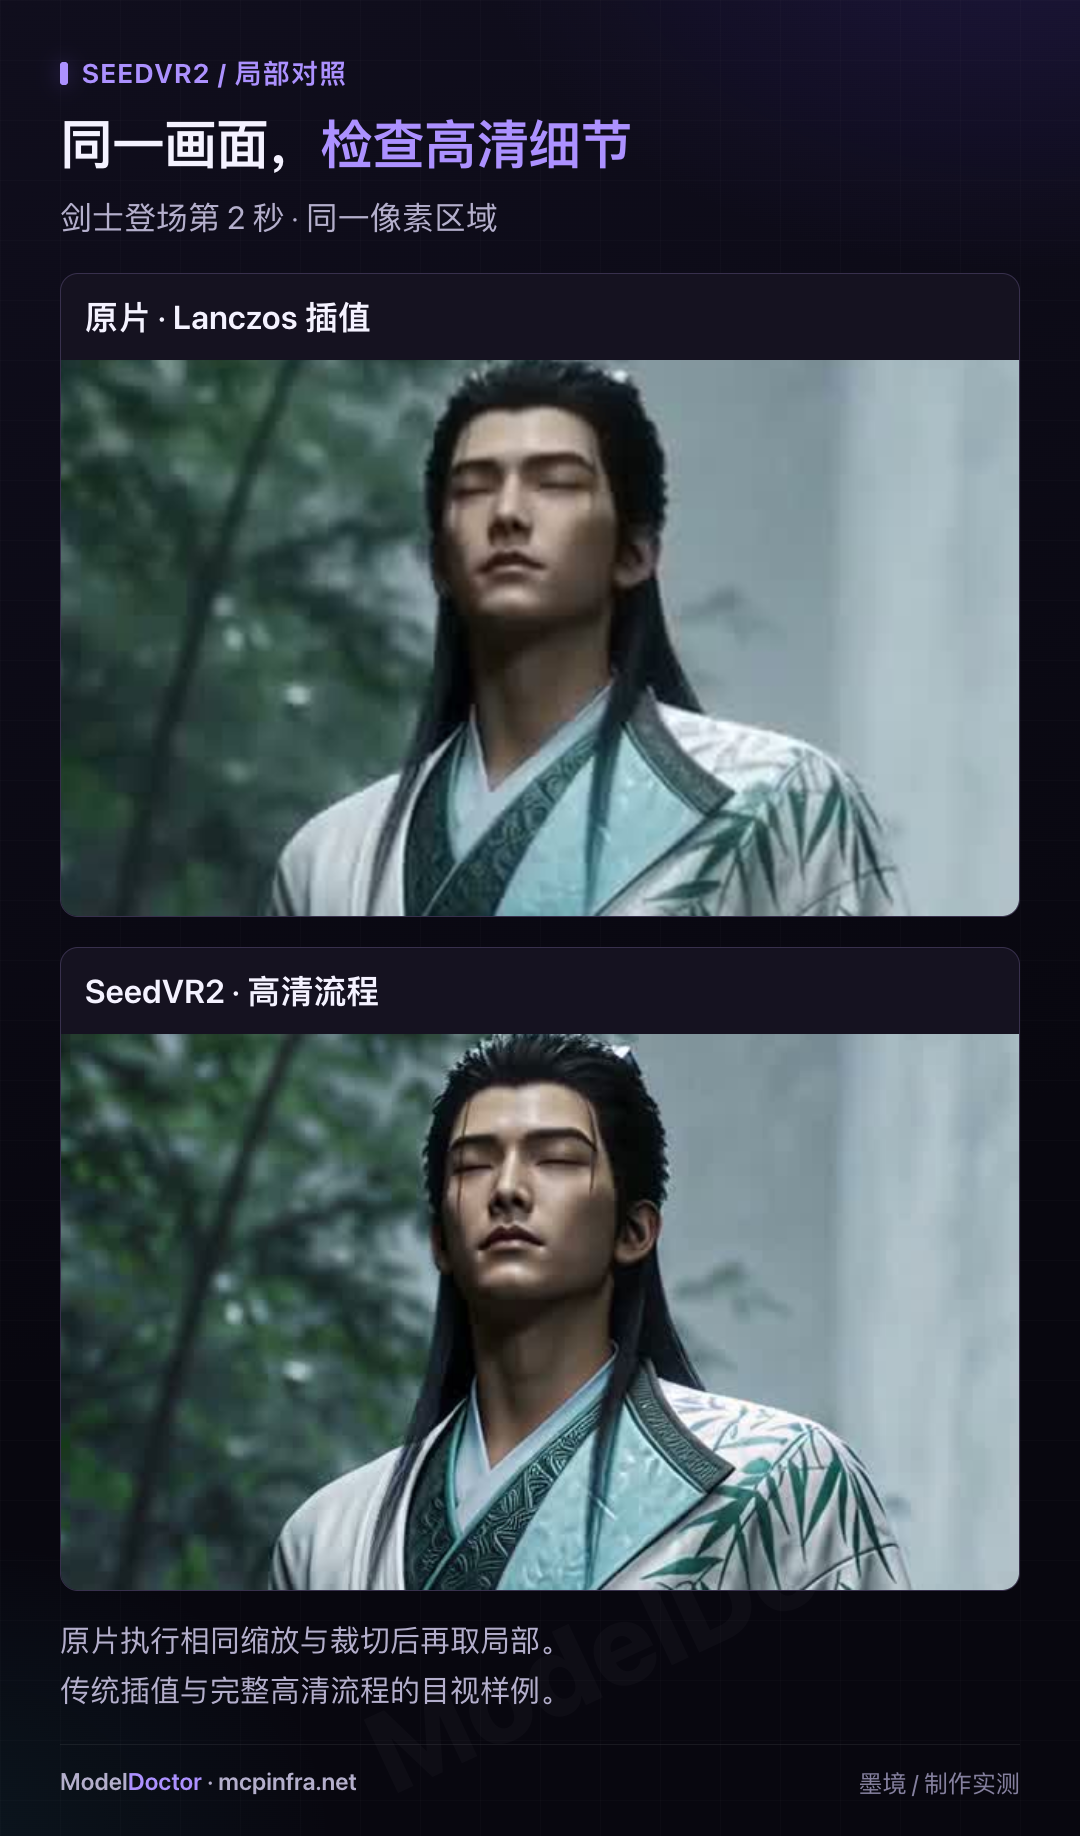
剑士登场片段第 2 秒,原片先按相同规则做 Lanczos 缩放与裁切,再与高清结果取同一区域。这是传统插值与完整超分流程的目视对照,重点看发丝、衣料、轮廓;更清楚之外,还要检查角色有没有变、连续播放是否闪烁。
超分利用模型先验补充纹理,不会找回原片本来不存在的真实细节。对轻度退化的 AIGC 素材,也可能产生过锐或过度细节,因此仍需按题材验收。
生成缩短到几十秒后,高清处理成为制作排程中的另一项成本。《墨境》将 30 个角色片段和 1 个首页循环分给 A100、PPU 两台机器,四组并行,约 74 分钟完成,0 失败。这是整批耗时,不是单段处理速度。
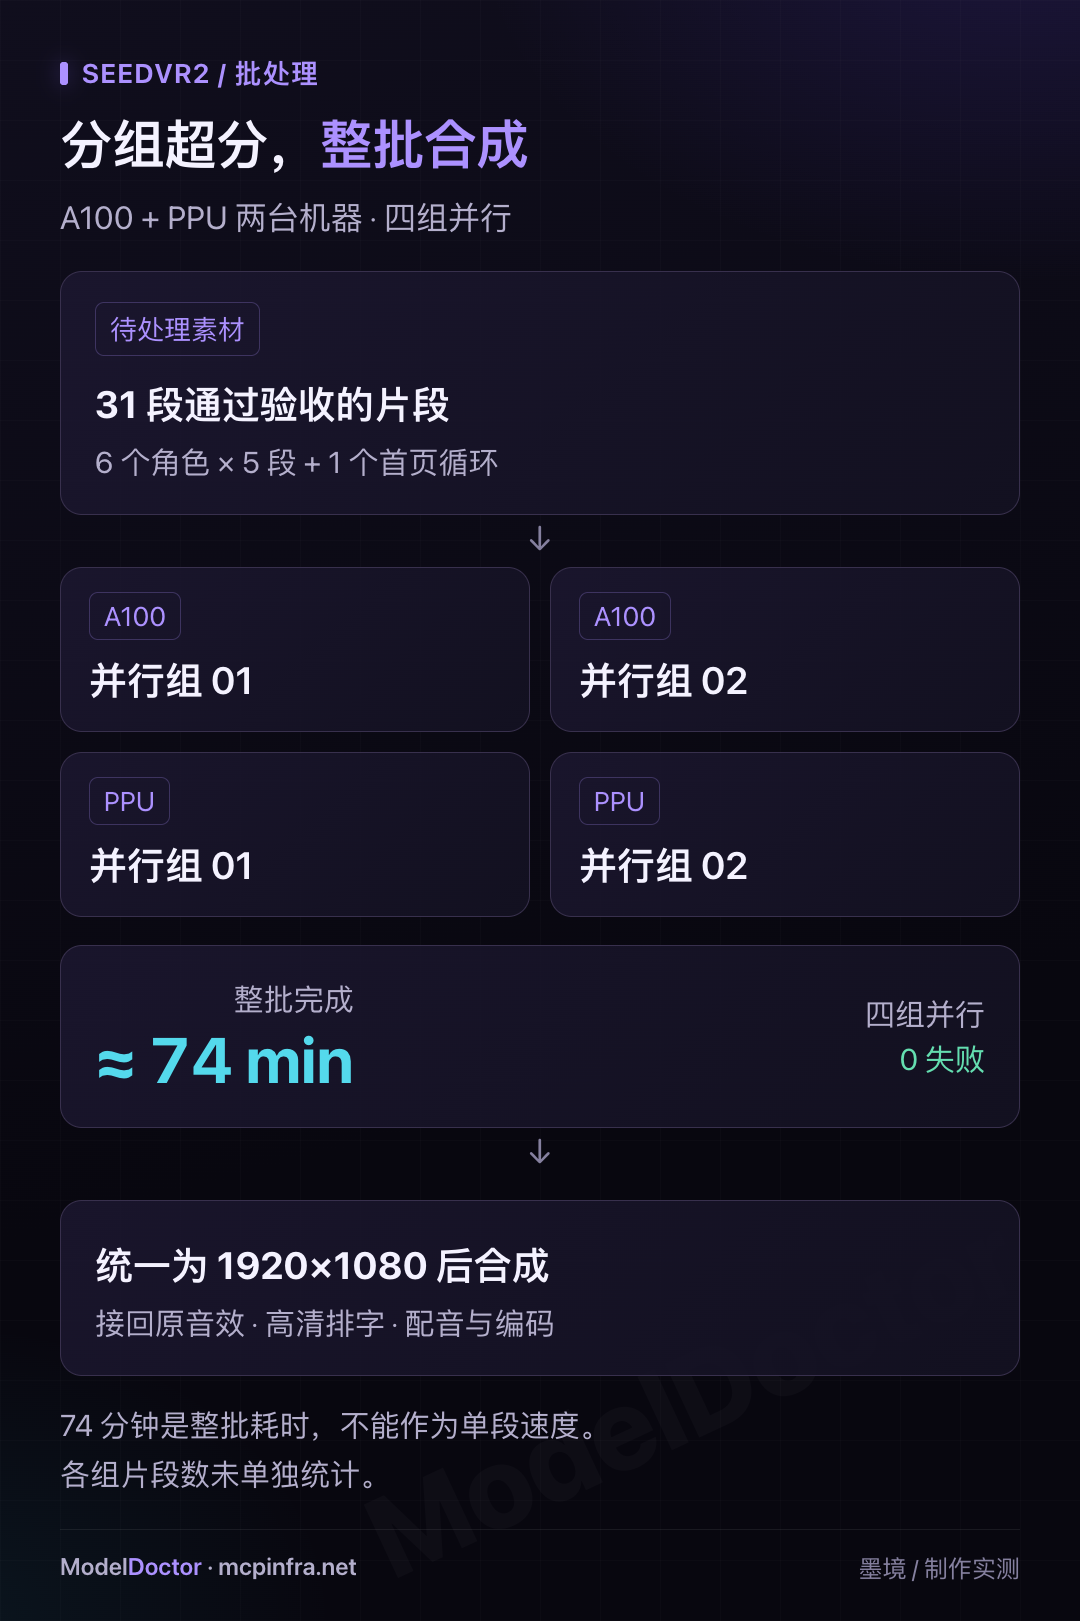
超分先于文字叠加:界面名牌、能力图和大招标题在 1080P 画布上重新绘制,避免让生成式修复改变排好的字。原生音效从 H3 原片接回,随后加入配音并统一编码,最终文件为 1920×1080。
因此,“5 秒视频约 24 秒生成”和“高清成片交付”要分开理解。前者衡量生成端,后者还需要筛片、超分、配音与合成,不能当作全流程只花了 24 秒。
4. 用六职业 CG 检查实际效果
《墨境》从六个职业的定妆图和分镜开始。首页是角色同框的选角场景,选中后进入登场、动作与大招演出,最后回到首页;这些镜头需要人物一致、接帧自然,而不只是单张画面漂亮。
性能验证使用一个四卡实例;实际制作同时运行两组四卡 A100 服务,分别处理参考图生成与首尾帧任务,高清阶段再分组并行。生成与后处理分开排程,才能批量推进镜头。
六宫格展示的是各角色真实高清大招片段,按原速同步播放,方便观察动作、画风和细节。完整 CG 则展示选角、角色演出与镜头衔接的最终效果。
这次实践把 RunningHub 的生成加速路线接到了实际 CG 制作中:公开 LoRA 支撑少步生成,A100 缩短等待,SeedVR2 处理合格素材,最后在高清画布上完成合成。性能记录与可播放的作品,分别回答“快了多少”和“能做成什么”。
部署参数速查
A100 使用 4 卡、SGLang 0.5.19,文生视频权重为 larryvrh/MiniMax-H3-Turbo-Lora 的 minimax_h3_turbo_v4_step600_ema.safetensors。原始启动脚本、权重版本与校验记录保留在复现资料中。
下面是当时的启动参数片段,接在已配置的 SGLang 服务命令中;模型路径、镜像、端口和 GPU 可见范围需另行配置。
--num-gpus 4 \
--tp-size 2 \
--ulysses-degree 2 \
--attention-backend torch_sdpa \
--component-attention-backends=transformer=sage_attn \
--enable-torch-compile false \
--lora-nickname turbo \
--lora-scale 1.0 \
--lora-merge-mode auto
Cache-DiT 由启动环境变量 SGLANG_CACHE_DIT_ENABLED=true 启用;生成请求中将 num_inference_steps 设为 6,固定 seed 1101、请求 5 秒,target 指定短边 768、宽高比 16:9。启动后核对日志中的 LoRA 加载、DiT 的 sage_attn 与分布式缓存状态,再预热、生成并检查产物。
SeedVR2-3B 在已准备好依赖与权重的环境中,使用归档的四卡调用:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
torchrun --nproc-per-node=4 --master_port=29500 \
  projects/inference_seedvr2_3b.py \
  --video_path /work/in \
  --output_dir /work/out \
  --seed 666 \
  --res_h 1080 --res_w 1920 \
  --sp_size 4
/work/in、/work/out 分别为输入与输出目录。此次超分中间产物为 1904×1088,合成前统一为 1920×1080;最终规格以文件检查为准。
以上结果来自特定硬件、软件构建与制作素材;更换版本、题材或参数后,需要重新验证速度与画质。后续如有新的部署实测,也会同步整理到 云栈社区 供大家参考。
 发表于 1 小时前
|
查看: 7|
回复: 0


