视频生成模型不断向更高分辨率、更长时长推进,随之而来的一个直接问题是:视频 token 序列越来越长,DiT 中 Attention 的计算成本迅速上升。
Sparse Attention、Few-Step Distillation 和低精度量化,分别从单步 Attention、采样步数和数值精度三个方向压缩推理成本。
但在实际训练中,当 Attention Sparsity 从常见的 90% 继续推到 95% 甚至 97% 时,却出现了一个反常现象:
训练损失仍在继续下降,生成视频却开始出现结构破碎、背景漂移和时序不稳定。
更关键的是,继续延长训练、扩大数据规模,甚至增大 compensation branch 的容量,都无法真正修复这一问题。团队将这种失效模式称为 High-Sparsity Trap(高稀疏陷阱)。
围绕这一问题,北京大学、清华大学、阿里巴巴等机构提出并开源了 SparkDiffusion:先建立可用的高稀疏生成先验,再利用 Terminal-Aligned Supervision 修正完整生成轨迹,最终结合 RoLA、CrossDistill 与 FP8/Fused Kernel,形成从训练到 GPU 部署的统一加速链路。
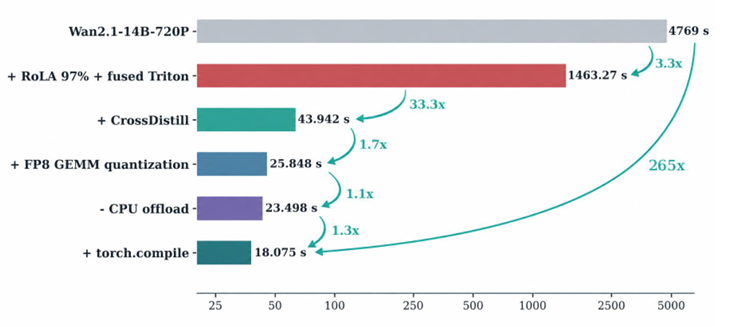
最终,在 Wan2.1-T2V-14B-720P 上,一段 81 帧、约 5 秒的视频,在单张 RTX 5090 上的扩散生成时间从 4769 秒降低到 18 秒,实现 265× 加速;在 H100 上从 1757 秒降低到 8 秒,实现 220× 加速。Wan2.1-T2V-1.3B-480P 则可以进一步做到 RTX 5090 上 1.3 秒、H100 上 0.6 秒。
High-Sparsity Trap:为什么90%可以,97%却开始失效?
从 90% sparsity 提高到 97%,看起来只增加了 7 个百分点,但实际保留的 Attention block 已从 10% 降到 3%,Sparse Branch 的计算量只剩前者的约 30%。
这意味着很大的额外加速空间,同时也意味着稀疏化带来的信息损失会迅速放大。
在 Wan2.1-T2V-14B-480P 上,80% 和 90% sparsity 的生成结果仍然接近 Dense Model;但当稀疏率达到 95% 和 97% 后,人物、道路和背景结构开始明显退化。
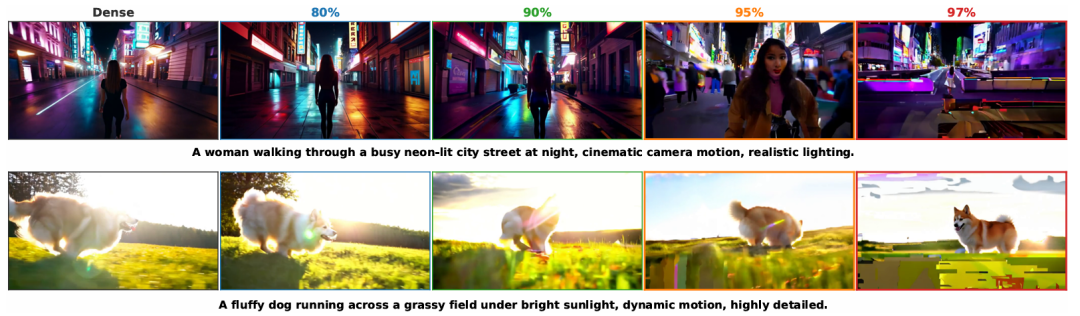
95%—97% sparsity 下开始出现明显的生成质量退化
更关键的是,这并不是简单的"模型没有训练够"。
团队将训练延长到 10000 steps,并把数据规模扩大到约 30000 个视频,step-local validation loss 仍然持续下降,但最终视频质量并没有恢复;增大 compensation branch 的容量同样作用有限。
问题到底出在哪里?
团队进一步进行了 Oracle Intervention:只在一小段 sampling interval 中,将 Sparse Student 的 prediction 替换成 Dense Teacher。
实验发现,在 97% sparsity 下:
- 只修正最高噪声阶段的 5 个 step,就能移除大部分 terminal error;
- 使用相同预算修正最低噪声阶段的 5 个 step,效果却非常有限。
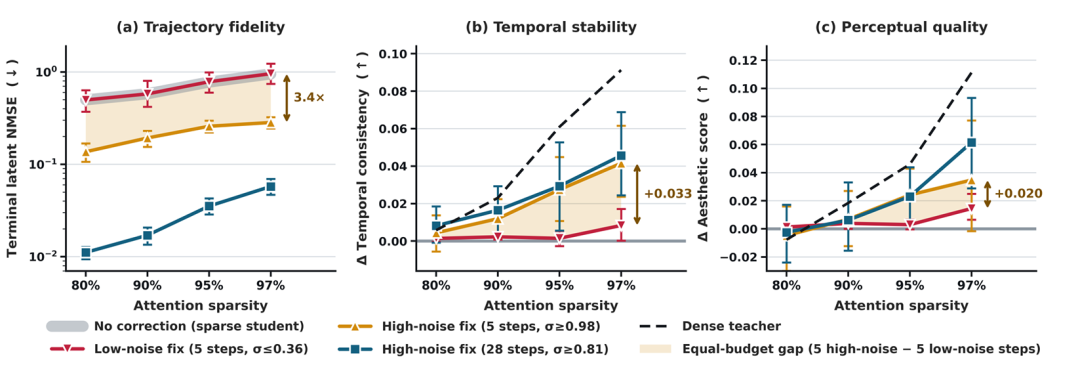
相同 correction budget 下,高噪声阶段对最终 trajectory fidelity、temporal stability 和 perceptual quality 的影响更大
这说明,高稀疏模型最主要的问题来自 high-noise structure-generation stage。
高噪声阶段形成的结构偏差会沿后续 denoising trajectory 被不断传播和放大。
因此,极高 sparsity 下的问题已经不能只看"当前这一步预测准不准",而需要进一步考虑:
这一步的误差,经过后面的完整 trajectory 后,最终会把生成结果带到哪里。
Terminal-Aligned Supervision:从逐步监督到终端对齐
Flow Matching 等常规训练方式属于 step-local supervision:模型在某个 noise level 上预测 velocity,Loss 直接衡量的是这一时刻的 prediction 是否准确。
但最终的视频由整条 sampling trajectory 共同决定。
因此,在极高 sparsity 下,即使每一步的平均 prediction error 都在下降,只要这些误差具有系统性的方向,它们仍然可能沿 trajectory 累积成明显的 terminal drift。
SparkDiffusion 因此引入 Terminal-Aligned Supervision(终端对齐监督) 的视角。
它不再只关心:"当前这一步预测得准不准?"
而是进一步约束:"当前这一步经过后续生成轨迹后,最终会把 sample 带到哪里?"
它的 supervision target 可以来自当前时刻之后的 trajectory state、teacher-composed trajectory,或者最终输出本身。
论文在六种二维 sequence distribution 上做了受控实验。即使高稀疏模型的 validation loss 已经收敛,Multi-step Sparse Model 在 trajectory 接近终点时仍会明显偏离数据分布;加入 terminal-aligned distillation 后,Few-Step Student 的 terminal distance 重新接近 Dense Teacher。
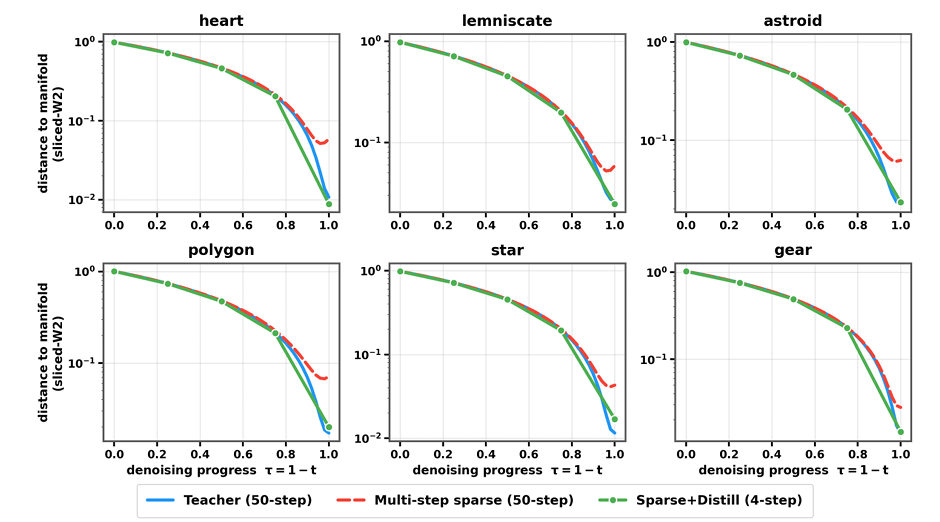
Step-local training 已经收敛,但 Multi-step Sparse Model 在 trajectory 末端仍发生偏移;加入 Terminal-Aligned Distillation 后终点误差明显下降
由此得到 SparkDiffusion 最核心的 staging principle:
先通过短暂的 Sparse Warm-up,让高稀疏模型形成可用的 coarse prior;再通过 Terminal-Aligned Distillation 修正最终生成分布。
SparkDiffusion:RoLA + CrossDistill + FP8
基于前面的诊断,SparkDiffusion 将团队此前的 RoLA 和 CrossDistill 连接进同一套三阶段加速框架:
Sparse Warm-up → Trajectory-Mixed Distillation → FP8 + Fused Kernel Deployment。
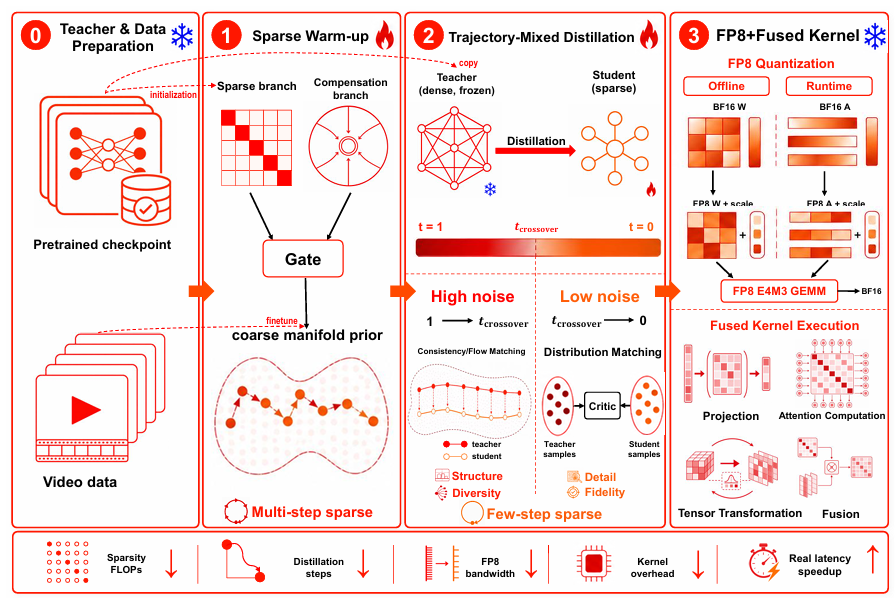
SparkDiffusion 整体框架:Sparse Warm-up、Trajectory-Mixed Distillation 与 FP8 + Fused Kernel Deployment
RoLA:让极高稀疏仍然保留全局信息
SparkDiffusion 默认采用团队提出的 RoLA(Rotary-Positioned Low-Rank Linear Attention) 作为 Sparse Attention Module。
RoLA 一边通过 block-sparse branch 保留高能量 query-key interaction,一边利用带有旋转位置信息的 low-rank linear branch,补回被 sparsification 舍弃的 global context。
SparkDiffusion 首先进行一个短暂的 Sparse Warm-up,让 Dense Pretrained Model 适应 97% sparsity,形成后续 distillation 所需要的 coarse generative prior。
但 RoLA 主要解决的是 高稀疏结构下如何尽可能保留信息,单纯依赖 step-local training 仍然无法解决 High-Sparsity Trap。
因此还需要 CrossDistill。
CrossDistill:用3步修正完整生成轨迹
Stage 2 使用团队提出的 CrossDistill(Balancing Quality and Diversity via Trajectory-Level Hybrid Few-Step Distillation)。
CrossDistill 沿 noise trajectory 设置 crossover point:
- High-noise:1 个 PCM consistency step,跟随 Teacher 的 coarse structure 与 motion trajectory,并保留不同 seed 带来的 diversity;
- Low-noise:2 个 DMD distribution-matching step,进一步修正 terminal-visible error,提高细节和 fidelity。
最终得到一个 3-step、CFG-free Student。
这与前面对 High-Sparsity Trap 的诊断正好对应:High-noise stage 负责稳定最容易产生结构误差的 early trajectory,Low-noise stage 再进一步对齐最终生成分布。
在 97% sparsity 下,Pure PCM 的 VBench / VBench-2.0 为 81.94 / 56.41,Pure DMD 为 82.56 / 57.38,CrossDistill 最终达到 83.15 / 58.05。
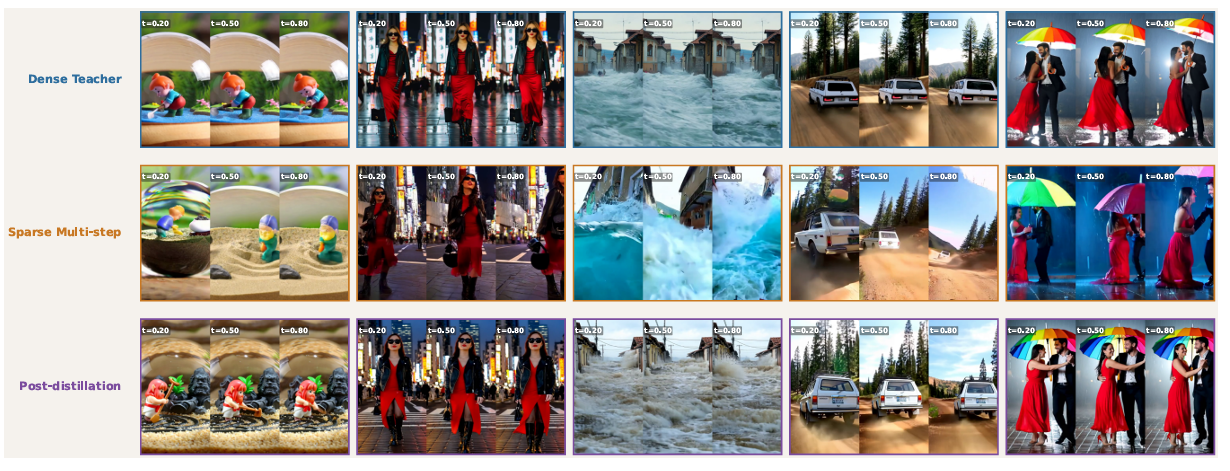
Multi-step Sparse Model 已经出现结构漂移;接入 CrossDistill 后,3-step Student 的结果重新接近 Dense Teacher
最后,SparkDiffusion 将 Attention 和 FFN 中的 Linear Projection 进一步量化到 W8A8 FP8 E4M3,并融合 activation scaling、type casting 等操作,减少 memory access 和 Kernel launch overhead。
因此,最终的加速来自三部分:
RoLA 高稀疏 Attention 降低单步计算量;CrossDistill 将 NFE 从 100 降到 3;FP8 与 Fused Kernel 再将理论计算收益转化为真实 GPU latency。
实验结果与总结
SparkDiffusion 在 Wan2.1/Wan2.2、T2V/I2V、480P/720P,以及 RTX 5090/H100 等多种设置下进行了验证。
所有主要实验均生成 81 帧视频,480P 对应 480×832,720P 对应 720×1280。
主要结果包括:
- Wan2.1-T2V-14B-720P,RTX 5090:4769 s → 18 s,265×;
- Wan2.1-T2V-14B-720P,H100:1757 s → 8 s,220×;
- Wan2.1-T2V-1.3B-480P,RTX 5090:182 s → 1.3 s,140×;
- Wan2.2-T2V-A14B-720P,RTX 5090:4545 s → 25.1 s,181×。
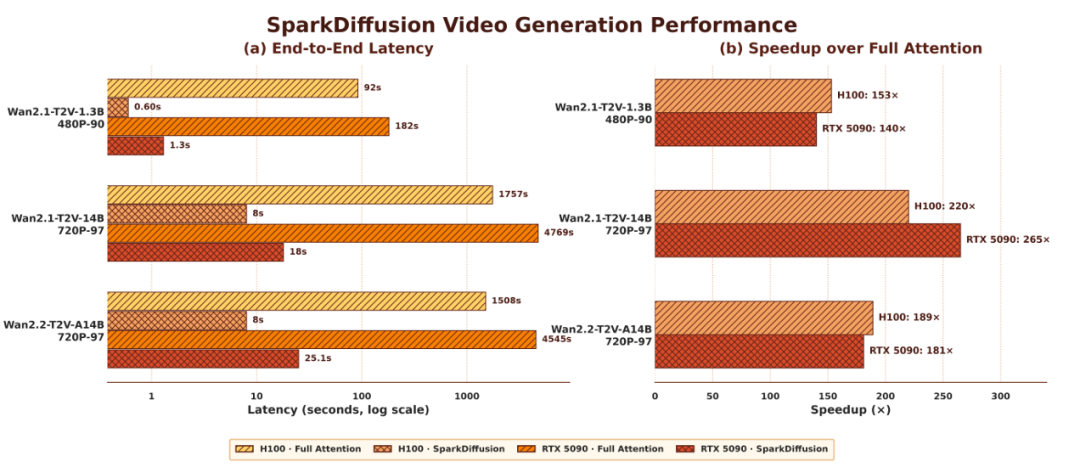
SparkDiffusion 在不同 Wan 模型和硬件上的 diffusion generation latency 与 speedup
相比最终的 265×,SparkDiffusion 更重要的一个结论或许是:当 Sparse Attention 被推到极高稀疏率后,step-local loss 已经不再是 terminal generation quality 的可靠代理。
High-Sparsity Trap 揭示了这一失效模式,而 Terminal-Aligned Supervision 给出了一条更直接的修复路径:
先让高稀疏模型形成可用的生成先验,再去修正完整 trajectory 的最终分布。
在此基础上,SparkDiffusion 进一步用 RoLA + CrossDistill + FP8 将高稀疏 Attention、Few-Step Generation 与 Low-Precision Deployment 串成一条完整加速链路。
最终,一段 81 帧、约 5 秒的 720P 视频,可以在单张 RTX 5090 上用 18 秒完成扩散生成。
随着生成分辨率、视频长度和时空 token 数量进一步提高,Sparse Attention 相比 Dense Attention 的计算优势也会继续增加。
团队下一步将继续把这套方法扩展到 高分辨率全模态生成模型 与 AR 自回归视频 / World Model。在这些更长序列的生成场景中,高噪声结构误差与跨 chunk 误差传播也会更加突出,Terminal Alignment 可能具有进一步的应用空间。
 发表于 1 小时前
|
查看: 8|
回复: 0


