大模型 Attention 路线变迁:从分流到重组。
作者丨李娜
编辑丨岑峰
一张大模型架构图里,同时出现了 Kimi 和 DeepSeek 的影子。
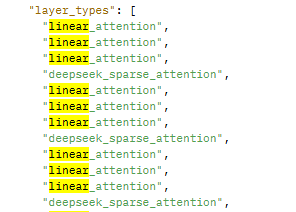
GLM-5.3-Flash 项目配置文件:45 层架构中,34 层采用 Kimi 路线的 KDA 线性注意力,另外 11 层采用 DeepSeek 路线的 KPool-DSA 稀疏注意力。
今年以来,大模型架构里出现了一条越来越清晰的变化:一些混合注意力架构中原本由全局 Attention 承担的角色,开始被 Sparse Attention(稀疏注意力)接替。
要理解这个变化,得先回到 Attention 本身。
Attention 解决的是一个基础问题:模型处理当前 token 时,能不能在越来越长的历史里,找到真正有用的信息。
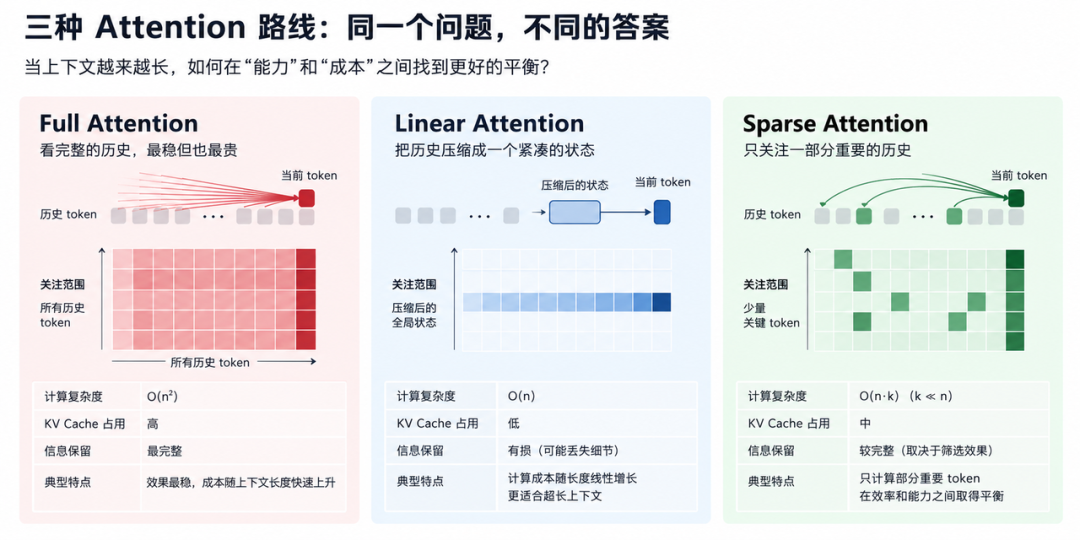
大致来看,目前常见的 Attention 机制可以理解成三类:
- 全局注意力(Full / Global Attention):直接读取完整的 token 历史,信息保留最充分,但计算和缓存成本也最高。
- 线性注意力(Linear Attention):把历史压缩进更紧凑的状态,以降低长序列的计算成本。
- 稀疏注意力(Sparse Attention):保留更完整的历史,只选择其中一部分重要信息参与计算。
过去几年出现的很多高效注意力(Efficient Attention),主要就在后两种方向上继续演化。
最开始,经典 Transformer 主要使用 Full Attention。Full Attention 让模型可以直接访问完整的 token 级历史,代价是计算和 KV Cache 随上下文迅速增长,连带着训练和推理成本也随之大幅增加。
过去几年,大家对 Attention 的改造,本质上都是在能力和成本之间找平衡。于是,作为折中方案的混合注意力架构逐渐流行起来:不同机制被放进同一套模型里分工,高效 Attention 负责降低成本,少量全局 Attention 保留直接访问完整历史的机会。
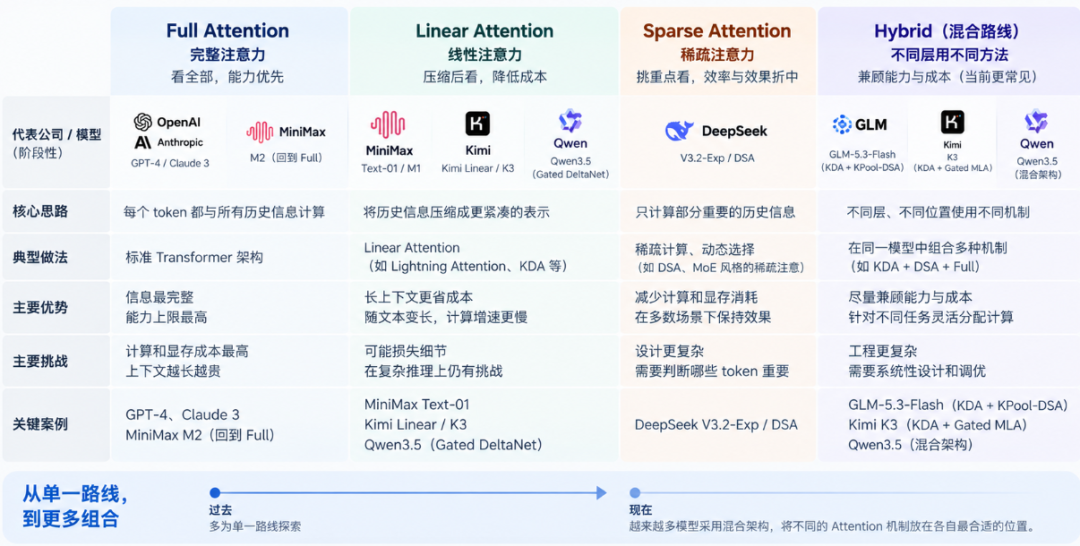
从不同 Attention 路线,看大模型公司的选择
到了今年,很多混合注意力架构里由全局 Attention 承担的角色,开始出现被 Sparse Attention 接替的迹象。
8 月发布的 Qwen3.8-Flash-Next 就是一个很清楚的例子。它延续此前三层 Gated DeltaNet 配一层 Attention 的结构,但那一层原本负责全局精确读取的 Attention,被进一步改造成了 Qwen Sparse Attention 这样的高效注意力机制。此前,我们也对 GLM-5.3-Flash 和 Qwen3.8-Flash-Next 做过详细实测,可参见 https://mp.weixin.qq.com/s/HxJhiH0O1etsHoH_X1J5VQ。
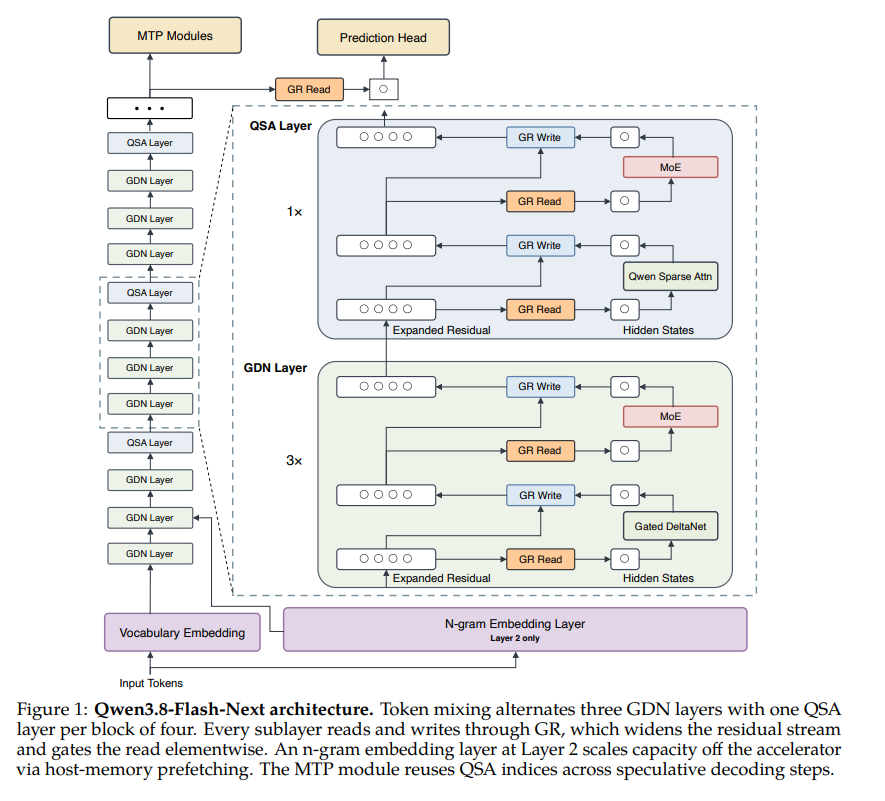
Qwen3.8-Flash-Next 架构图:每四层里,三层是 GDN,一层是 QSA。
为什么那层一直被认为无法替代的全局 Attention,也开始有人尝试用另一种高效机制接替?如果具体的 Attention 技术正在变成可以流动和重组的零件,我们今天所谓一家模型公司的“技术路线”,到底还指什么?
01 MiniMax 最后还是留下了 Full Attention
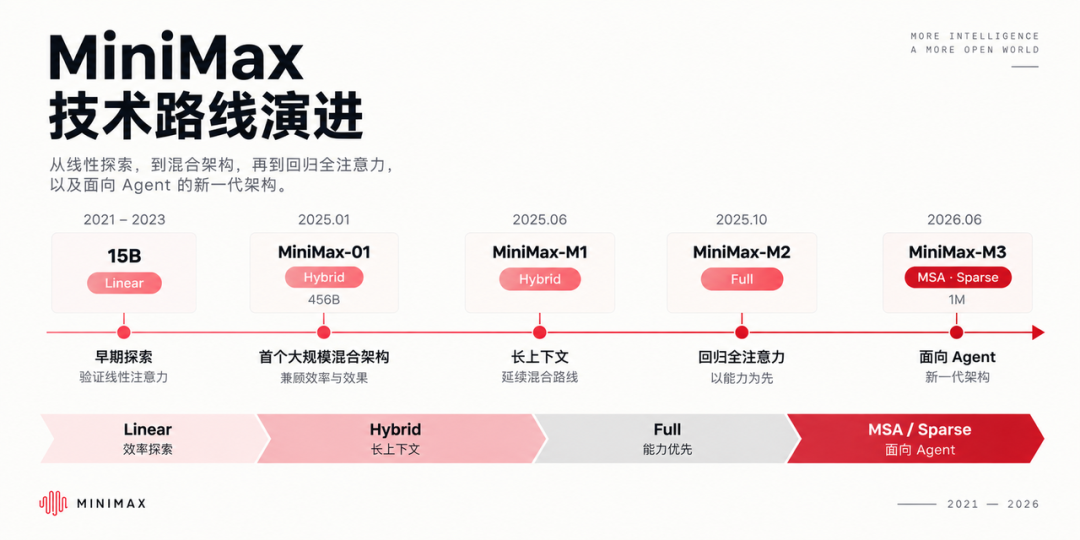
要回答这个问题,可以看看 MiniMax 过去几年的架构变化,几乎完整经历了这一轮反复:从押注线性注意力,到保留少量全局注意力做混合注意力,再回到全局注意力,后来又转向稀疏注意力。每一次变化背后,都对应着模型 Scale 以后新暴露出来的问题。
2023 年底,后来主导过 MiniMax-01 网络架构设计的钟怡然正在给 Linear Attention 找一家愿意真正把它 Scale Up 的公司。
他从 2021 年开始研究这条路线,此前最大的实验模型已经做到 15B。在他看来,Linear Attention 在建模效果和运行效率上的几个主要问题已经基本解决,真正剩下的问题只有一个:它被放大到几百 B 参数以后,还能不能成立?
这个问题已经不是研究团队自己可以回答的了。
预训练一个几百 B 参数的大模型,架构一旦确定,数据、算法、训练系统和工程资源都会跟着转向。钟怡然此前也接触过其他公司,最终在 2023 年底和闫俊杰的一次交流后,MiniMax 决定把这条还没有经过大规模验证的路线接下来。
双方对这件事的把握其实并不一样。
钟怡然后来回忆,作为长期研究 Linear Attention 的人,他当时觉得成功概率接近 99%;但站在闫俊杰的位置上,他估计这个数字只有大约一半。一旦把 Linear 作为下一代主模型的架构,MiniMax 超过 80% 的研发资源都会被卷进来。一家大模型公司要用绝大多数研发资源,去验证一件只有五成把握的事。
MiniMax 创始人闫俊杰,图源网络。
早期实验一度让这场下注显得没有那么危险。团队曾经训练过一版 15B 左右的纯 Linear 模型,效果已经可以接近 Transformer,似乎说明这条路线可以继续往上 Scale。但模型进一步放大后,问题开始暴露出来。Linear Attention 为了降低长上下文的计算成本,会把历史信息压缩进更紧凑的状态里,而在检索这类需要从很长文本中准确找回某个细节的任务上,这种压缩会出现问题。
Linear Attention 省下计算的关键,在于它不会一直保存并重新读取每个历史 token,而是把过去的信息不断压缩进有限的状态里。这样做很像把一本书边读边做笔记:记住主题和大意很高效,但如果几百页以后突然问“第 37 页某句话具体写了什么”,压缩过的笔记未必还能完整还原。
MiniMax 原本希望把 Linear 做得更彻底,最后还是把 Full Attention 加了回来。
后来 MiniMax-01 采用的 7:1 混合注意力架构由此出现:每 7 层 Lightning Attention 之后,加入 1 层传统 SoftMax Attention。大部分计算交给更便宜的 Linear Attention,但模型隔一段仍然获得一次直接读取完整上下文的机会。
这个比例是在不同层数和组合之间反复实验后找到的折中。钟怡然后来把混合注意力形容成一种“保底方案”。
可是,15B 模型给出的信号仍不足以支撑一轮 4560 亿参数的正式训练。在真正开跑 MiniMax-01 之前,团队做了大约 3700 次预训练实验,不断改变模型大小、架构和参数组合,再从这些相对便宜的小实验中判断 Scaling Law 是否还能继续成立。
2024 年中,MiniMax 最终开始训练 4560 亿参数的 MiniMax-01。到 2025 年 1 月模型发布时,7 层 Lightning Attention 加 1 层 Full Attention 的架构被正式保留下来,上下文长度也被推到了 400 万 token。
MiniMax 花了数千次实验和一轮大规模预训练,最后仍然没有把那层 Full Attention 拿掉。它恰恰解释了为什么在后来很长一段时间里,混合注意力虽然越来越常见,却往往仍要保留少量全局 Attention。
而 MiniMax 很快还会第二次碰到这个问题。
02 Scale 之后,混合注意力又暴露了新问题
模型继续 Scale 以后,第二轮问题出现了。
这一次是更复杂的多跳推理问题。当模型需要经过多个中间步骤,把前面的条件、推导和结论重新串起来时,混合注意力开始出现比 Full Attention 更明显的能力损失。
问题暴露以后,团队重新设计测试和训练方法,小规模实验里,混合注意力又可以追上 Full Attention。真正让 MiniMax 犹豫的也因此不再是这个具体缺陷,而是另一件事:这次的问题可以找到、可以修,下一次还没有被发现的问题在哪里?
Text-01 时期使用的 Benchmark,并没有提前暴露后来的多跳推理差距。即使团队为这个问题补上新的测试,也无法证明在更大的模型和更复杂的任务上,不会继续出现新的能力缺口。
这意味着,混合注意力真正的风险是未知能力损失无法被提前穷尽。
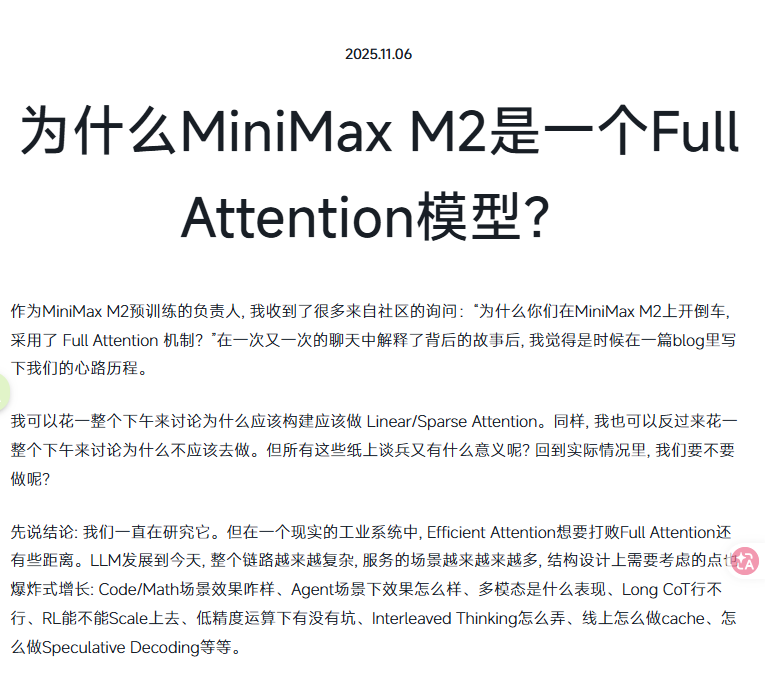
MiniMax 官网技术博客截图。
所以到了 M2,MiniMax 重新采用了 Full Attention。相比继续押注一个可能在更大 Scale 上暴露新问题的架构,Full Attention 虽然更贵,但它的能力边界和工程行为更可预期。
这也是 Full Attention 长期很难从混合注意力架构里彻底消失的原因:它留下来的价值,很大一部分来自对未知能力风险的兜底。
但到了下一阶段,Agent 又重新改变了这笔账。
03 Agent 重新放大了 Full Attention 的成本
M2 回到 Full Attention 之后,MiniMax 并没有在那里停太久。
2026 年 6 月发布的 M3 重新离开 Full,转向自研的 MiniMax Sparse Attention(MSA)。这一次,变化来自于模型要处理的任务。
Text-01 时期,长上下文更多意味着一次性读进更多材料:一本书、一份报告,或者几十万 token 的文档。到了 Agent 阶段,上下文开始变成一段不断增长的工作历史。搜索结果、网页、代码、工具返回、报错和中间结果,会随着任务一轮轮执行不断累积。一个 Agent 可能工作几十轮甚至更久,前面发生过的事情又不能轻易丢掉。
这让 Full Attention 的另一面越来越难忽视。
M2 时期,MiniMax 最担心的是高效 Attention 可能带来的未知能力损失,因此宁愿接受 Full Attention 更高的成本。但到了 M3,长程 Agent 开始把这笔成本不断放大:历史越长,每一轮需要处理的信息越多,计算和 KV Cache 都会继续增长。
MiniMax 在 M3 发布时把 Context Scaling 直接列为解决复杂 Agent 任务的核心问题,并重新从 Attention 架构动手。最终采用的 MSA 不再让每一步都处理完整历史,而是先从长上下文中筛出真正需要参与 Attention 计算的部分。官方数据显示,在 100 万 token 上下文下,M3 单 token 计算量约为上一代模型的 1/20。
于是,MiniMax 几年的路线看起来像是绕了一圈:Text-01 用 Linear 降低长上下文成本,同时留下 Full Attention 兜底;M2 因为 Scale 后暴露出的能力风险,重新回到 Full;到了 M3,Agent 又把长上下文成本推到前台,于是团队再次寻找 Full Attention 之外的方案,只是这一次选择了 Sparse。
M2 时,MiniMax 愿意用更高的计算成本换能力上的确定性;到了 M3,Agent 让这份“确定性保险”的价格变得越来越高。
04 Linear 和 Sparse 被放进同一个模型
MiniMax 重新走向 Sparse 时,类似的变化已经开始在其他模型里出现。
过去很多混合注意力架构虽然引入了更高效的 Attention,最后仍会保留少量全局 Attention。到了 2026 年,这个结构开始松动。2 月发布的 MiniCPM-SALA 直接把 Lightning Attention 和 Sparse Attention 放到了一起;到了 8 月,Qwen3.8-Flash-Next 延续此前三层 Gated DeltaNet 配一层 Attention 的结构,却把负责精确检索的那部分进一步改成了 Qwen Sparse Attention。
这个变化在 Qwen 身上尤其清楚。三比一的结构没有变,变的是那一层“兜底”的方式。过去由全局 Attention 直接读取完整历史,现在开始交给 Sparse Attention,从长上下文中筛出真正需要的信息。
到了 GLM-5.3-Flash,类似的组合再次出现:45 层模型中,34 层采用 KDA,另外 11 层采用 KPool-DSA。过去分别由 Kimi 和 DeepSeek 推进的 Linear 与 Sparse 路线,被放进了同一套模型。
Linear 和 Sparse 之所以能够放在一起,恰好因为两者解决的是不同的问题。Linear 擅长用较低成本维持一段很长的历史,却不擅长随时恢复其中某个具体细节;Sparse 保留 token 级历史,但每次只读取其中一小部分。前者更像负责“记住整体状态”,后者负责“需要时回去查具体内容”。这也是为什么两种过去看起来彼此竞争的方案,后来开始出现在同一套架构里。
三个模型的实现并不相同,但它们指向了一个共同变化:Attention 架构正在从寻找一种更好的机制,走向让不同机制承担不同的工作。 Linear 或 Recurrent Attention 负责以更低成本维持长历史,Sparse Attention 负责在需要时从中找回更具体的信息。
过去被当作不同路线讨论的 Linear、Sparse 和 Full,正在变成同一个架构设计空间里的不同选项。
05 技术开始越过公司的边界
这种组合越来越容易发生,也和过去几年技术扩散的方式有关。
2024 年,长期研究线性注意力的杨松琳开始维护线性注意力开源社区 FLA。她后来回忆,FLA 从一开始就不只是为了发布论文,而是希望把 Linear Attention 变成真正可以复用的基础设施:算法之外,接口、kernel 和具体实现也一起开放。后来 Kimi 推进 KDA 时,也从这个社区吸收了核心贡献者。
技术因此不再只跟着论文流动。代码、社区和研究人员,把一项架构创新带出了最初提出它的团队。
到 2025 年底,杨松琳在讨论 Linear Attention 下一步时,已经提出过一个当时还很激进的方向:既然 Linear 在精确检索上仍有缺口,是否可以直接和 Sparse 结合,让两种机制各自处理不同的问题。她当时举出的例子,就是 Kimi 的 KDA 和 DeepSeek 的 DSA。
不到一年,这种设想已经出现在真实模型里。
这也让“技术路线”越来越难简单地和某一种 Attention 机制绑定。过去人们习惯说 MiniMax 做 Linear、DeepSeek 做 Sparse、Kimi 做 KDA;但当代码可以开源、人员可以流动、已经被验证过的技术可以迅速进入另一家公司的模型,这些标签的有效期会越来越短。
真正拉开差距的,也越来越不是“有没有某项技术”,而是什么时候采用它、怎样和其他技术组合,以及愿意在能力、成本和工程风险之间做什么取舍。
06 尾声:路线没有消失
再回到开头那张架构图,Kimi 和 DeepSeek 的名字同时出现在 GLM-5.3-Flash 里,已经没有那么反常了。
过去几年,人们习惯用 Linear、Sparse、Full Attention 来区分不同公司的技术路线。但 MiniMax 几次看似反复的选择,其实已经说明,这种划分越来越难解释真实的大模型研发。
做 Text-01 时,MiniMax 最先看到的是长上下文带来的成本,于是押注 Linear;模型继续 Scale 以后,未知的能力损失变得更危险,M2 因此重新回到 Full;到了 Agent 阶段,不断增长的工作历史又把计算成本推到前台,M3 再次转向 Sparse。
技术没有突然变好或变坏,变化的是每个阶段最先撞到的约束。
这也解释了为什么今天很难再用一种 Attention 机制定义一家公司的路线。真正决定选择的,是模型下一步要处理什么任务,什么成本已经不能继续接受,以及团队愿意为能力上的确定性付出多少代价。
GLM-5.3-Flash 里 KDA 和 DSA 同时出现,记录下来的也不是哪一条路线最终赢了。它更像一个结果:当具体技术越来越容易被验证、吸收和重新组合,所谓“路线”正在从对某一种架构的长期押注,变成一家公司对约束变化的持续判断。
技术会扩散,也会被重新组合。真正没有那么容易被复制的,是一家团队判断下一堵墙会出现在哪里。
参考资料:
- 晚点聊 LateTalk 104:《我给线性注意力找“金主”,字节 say No,MiniMax say Yes》
- MiniMax:《MiniMax-01 is Now Open-Source: Scaling Lightning Attention for the AI Agent Era》
 发表于 前天 01:48
|
查看: 5|
回复: 0


