这轮大模型更新,开发者最关心的问题很直接:能力上去了,同样一笔预算,到底能多做多少事?
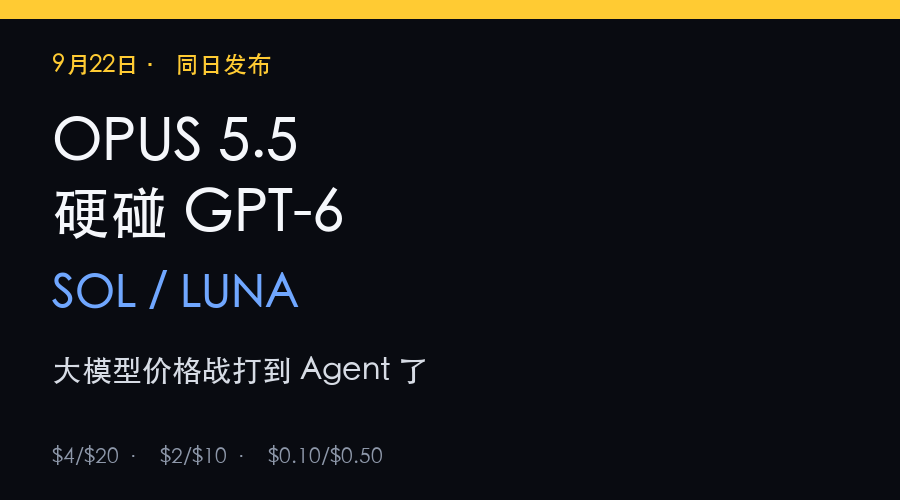
Anthropic 发布 Claude Opus 5.5,OpenAI 带来 GPT-6 Sol 和 GPT-6 Luna。一个继续强化复杂任务,另一个把不同成本的模型放进同一家族,Agent 的选型开始越来越像给团队分工——谁负责难题,谁负责跑量。
更值得算的是实际接入价格。RouteFast 模型广场已经列出这三款模型,其中 Luna 的常规档缓存输入价为每百万 Token 0.05 美元。
这个价格放在一次聊天里,差别不明显;放到每天成千上万次分类、提取和自动化调用里,就值得认真算一遍。
先把三个模型的定位说清楚
Claude Opus 5.5 的 API 型号为:
claude-opus-5-5
它重点面向复杂编码、长时间 Agent 任务和专业知识工作。Anthropic 公布的标准输入、输出价格为每百万 Token 4 美元、20 美元,比 Opus 5 分别下降 20%。
除了单价降低,Anthropic 表示它完成任务使用的 Token 也更少:在其默认设置测试中,典型任务成本下降约 40%,输出速度提升超过 30%。这些是厂商测试结果,实际项目还要看任务和配置。
OpenAI 这边,Sol 的定位是复杂编码与 Agent 工作流,Luna 则面向高频、明确、成本敏感的任务;更高档还有 GPT-6 Astra。
Sol 和 Luna 的官方模型页都列出 105 万 Token 上下文、12.8 万 Token 最大输出。工具能力还与所用接口有关,例如内置工具通过 Responses API 使用,接入平台支持范围也需要分别确认。
| 模型 |
官方标准输入/输出价 |
优先考虑的任务 |
| Claude Opus 5.5 |
$4 /$20 |
跨文件重构、长任务、复杂报告 |
| GPT-6 Sol |
$2 /$10 |
复杂编码、多步骤工具工作流 |
| GPT-6 Luna |
$0.10 /$0.50 |
分类、提取、批量自动化 |
单位均为美元/百万 Token。Sol、Luna 此处采用 ≤272K 输入档,长上下文、缓存和其他处理模式单独计价。
如果通过 RouteFast 接入,再看这张实际报价表
RouteFast 模型广场的公开分组目前显示:
| 模型 |
输入价格 |
输出价格 |
| Claude Opus 5.5 |
$2.00 |
$10.00 |
| GPT-6 Sol |
$1.00 |
$5.00 |
| GPT-6 Luna |
$0.05 |
$0.25 |
单位同样是美元/百万 Token,取自页面“实付价格(折后)”栏;Sol、Luna 为页面 ≤272K 档。这三款在上述普通输入和输出项目上,是官方标准单价的一半。
价格入口: https://routefast.ai/model-plaza
有两点值得一起看:Sol、Luna 超过 272K 后,广场分别显示 $2/$7.50、$0.10/$0.375;缓存读写另列价格,不能把所有计费项都直接乘以 0.5。页面也提示登录后可能显示专属分组与倍率,自己的账户以实际分组和账单为准。
这张表的作用,是帮你估算试用预算。它不替代对接口兼容性、限额和实际任务效果的验证。
一万次调用,差别有多大?
假设你做工单分类或字段提取,共调用 1 万次,每次计费输入 1,000 Token、计费输出 200 Token,每次请求均未进入长上下文档。
总量就是 1,000 万输入、200 万输出。按上面的单价估算:
| 模型 |
官方标准价估算 |
RouteFast 公开价估算 |
| Claude Opus 5.5 |
$80 |
$40 |
| GPT-6 Sol |
$40 |
$20 |
| GPT-6 Luna |
$2 |
$1 |
这是假设计费量下的算例,未计缓存、工具费与重试;若推理 Token 计入输出,也必须纳入上述计费输出量。它不是三个模型处理同一任务的实测账单。
Luna 值得关注的地方,就在这些量大、边界清楚、结果容易校验的任务里。
给工单分类,从资料里提取字段,为内容打标签,先筛选一批候选信息——如果小模型已经能稳定完成,把每条请求都交给最高档模型,就未必划算。
Opus 5.5 更贵,为什么仍然值得放进工具箱
因为有些任务,返工比 Token 贵。
跨仓库修改、长时间故障调查、带着多项约束生成报告,真正占用人的时间,往往是检查、纠错和重新解释需求。
Anthropic 披露的早期案例涉及大规模代码迁移、代码库审计和长任务执行。它还报告了遵守任务边界与抵抗提示词注入方面的改进。
这些信息让 Opus 5.5 值得进入复杂任务的测试名单,但最终要看的仍是你自己的样本:它能否少返工、能否通过检查、节省了多少人工时间。
一次有效结果的成本
= API 费用 + 重试费用
+ 人工检查与修正成本
+ 错误带来的预期损失
每百万 Token 便宜,并不自动等于每件事情都便宜;反过来,贵模型也不该因为名字响亮就接走全部请求。
三档模型,怎样放进一个应用
可以先按任务分工:
- Luna:分类、提取、批处理,优先交给可自动检查的任务。
- Sol:日常复杂编码、代码审查、多步骤工具调用。
- Opus 5.5:长任务、复杂约束、返工代价高的问题。
业务代码里,把模型名放进配置:
MODEL_ROUTES = {
    "batch": "gpt-6-luna",
    "daily_agent": "gpt-6-sol",
    "complex_task": "claude-opus-5-5",
}

model = MODEL_ROUTES[task.profile]
这段仅表示路由关系,各家接口与鉴权仍需接入层分别适配。上线时再加入超时、预算、结果检查和失败回退。
一个 20 行的故障描述,可能比 10 万字摘要更难;模型升级条件最好来自任务复杂度和实际失败记录,而不是只看输入长度。
想把 API 调用、工具编排和 Agent 工作流补成系统能力,可以到 Agent 板块按目录选学: https://yunpan.plus/f/93 。带着一个具体应用去学,再拿同一组任务比较模型,收益会更明确。
这轮竞争,最后会落到你的账单上
模型能力提高,让更多任务可以自动完成;接入价格下降,让原本嫌贵的工作流有了重新尝试的理由。
接下来值得做的,是把自己最常见的任务分成两组:哪些量大、重复、容易检查,哪些复杂、耗时、返工昂贵。
前一组先试 Luna,后一组比较 Sol、Opus 5.5 或更高档模型。最后按完成率、总耗时和账单决定,而不是只按排行榜换名字。
同样一笔预算,你会优先让更多小任务自动完成,还是把最难的一件事交给强模型?
相关入口
- 模型价格与 API 接入:
https://routefast.ai/model-plaza
- 云栈 Agent 课程与资料:
https://yunpan.plus/f/93
- 官方模型资料:
anthropic.com/claude-opus-5-5
- 官方模型资料:
developers.openai.com/api/docs/models
价格依据本次查阅的官方模型页及 RouteFast 模型广场,按页面最新信息更新。厂商效果数据归原发布方。
 发表于 前天 01:43
|
查看: 4|
回复: 0


