本文聚焦于大模型后训练的五个核心概念:SFT、RLHF、DPO、RLAIF 和 RLVR。预训练让模型学会语言和世界中的大量模式,后训练则不断调整它面对具体指令时更愿意生成什么。读完这篇文章,你会知道五种方法分别使用什么训练信号、怎样更新模型,又为什么经常出现在同一套训练流程里。
给一个预训练模型输入:
请帮我写一封礼貌但明确的项目延期说明,控制在 200 字以内。
它可能直接写出一封可用邮件,也可能复述问题、继续补全相似网页文本,或者写成一篇“如何撰写延期说明”的教程。
这并不奇怪。预训练阶段的核心任务通常是预测下一个 token。模型从海量文本中学到了语言结构、事实关联和一部分推理模式,却没有被稳定地训练成“看到用户指令就按要求回答”的助手。
后训练会给模型更明确的信号:SFT 提供一份合格答案,偏好数据告诉它两个回答哪个更好,可验证任务则让程序直接检查结果。
这些方法的差别,主要落在三个问题上:训练数据是什么、反馈由谁提供、模型又怎样根据反馈完成更新。 图 1 展示了基础模型经过不同后训练阶段,逐步成为助手模型的过程。
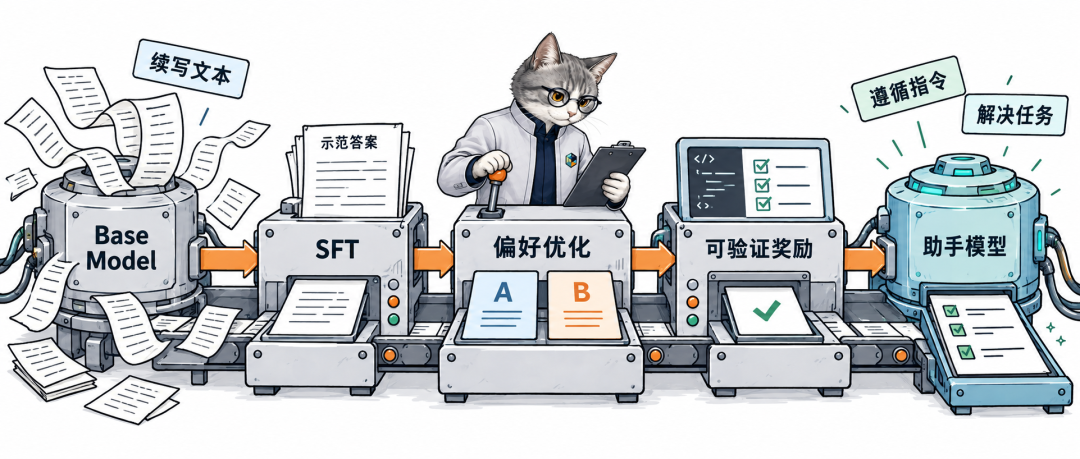
图 1:预训练让模型获得语言与知识基础,SFT、偏好优化和可验证奖励训练进一步改善指令遵循、回答偏好与任务求解能力。
五种方法,解决的是不同问题
SFT、RLHF、DPO、RLAIF、RLVR 经常被并列介绍,但它们关注的并不是同一件事。
| 方法 |
主要训练信号 |
反馈来源 |
常见优化方式 |
| SFT |
标准答案、示范 token |
人工、专家或合成数据 |
交叉熵、教师强制 |
| RLHF |
回答偏好或评分 |
人类标注者 |
奖励模型 + PPO 等 RL |
| DPO |
chosen / rejected 偏好对 |
人类或 AI 均可 |
直接偏好损失 |
| RLAIF |
偏好、评分、批评与修订 |
AI 评审模型、规则或“宪法” |
奖励模型 + RL,也可配合 DPO |
| RLVR |
答案正确性、测试结果、规则约束 |
程序化 verifier 或环境 |
在线采样 + PPO、GRPO 等 |
SFT 主要学习示范答案;RLHF 把人的偏好转成奖励;DPO 改变偏好数据的使用方式;RLAIF 把一部分反馈工作交给 AI;RLVR 则用程序或环境直接判断结果。
因此,它们并不是前一种被后一种依次替代的关系。同一套后训练方案里,几种方法往往会组合使用。图 2 从反馈来源、反馈形态和优化方式三个维度标出了它们的位置。
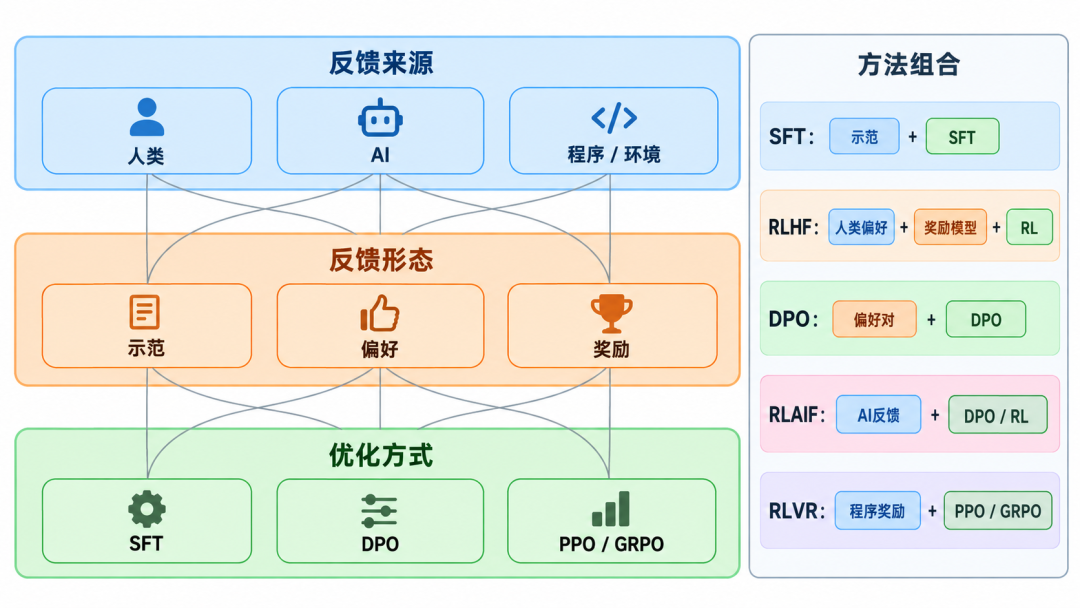
图 2:SFT、DPO、RLHF、RLAIF 与 RLVR 的区别,可以从反馈由谁提供、以什么形态表达,以及模型怎样更新三个维度理解。
1. SFT:先让模型知道“应该怎样回答”
通俗理解:SFT 给模型看成对的“问题—好答案”,让它学会在相似上下文中复现这种回答方式。
SFT 是 Supervised Fine-Tuning,中文通常译为监督微调。在大模型后训练中,它通常是基础模型走向 Instruct Model 或 Chat Model 的第一步。
一条典型训练数据大致长这样:
System:你是一名项目经理。
User:请写一封礼貌但明确的项目延期说明,控制在 200 字以内。
Assistant:由于核心接口联调时间超出预期,原定于……
训练时,模型看到 system、user 和前面已经出现的回答 token,然后预测示范答案中的下一个 token。简化后的损失可以写成:
L_SFT = -Σ log πθ(y_t | x, y_<t)
其中 x 是指令和上下文,y_t 是示范回答的第 t 个 token。训练会提高这些示范 token 在相应上下文中出现的概率。
工程实现里,通常只对 assistant 的回答部分计算 loss。system 和 user 消息负责提供条件;如果把它们也当成预测目标,模型还会额外学习复述提示格式。具体的数据组织与损失计算方式见图 3。
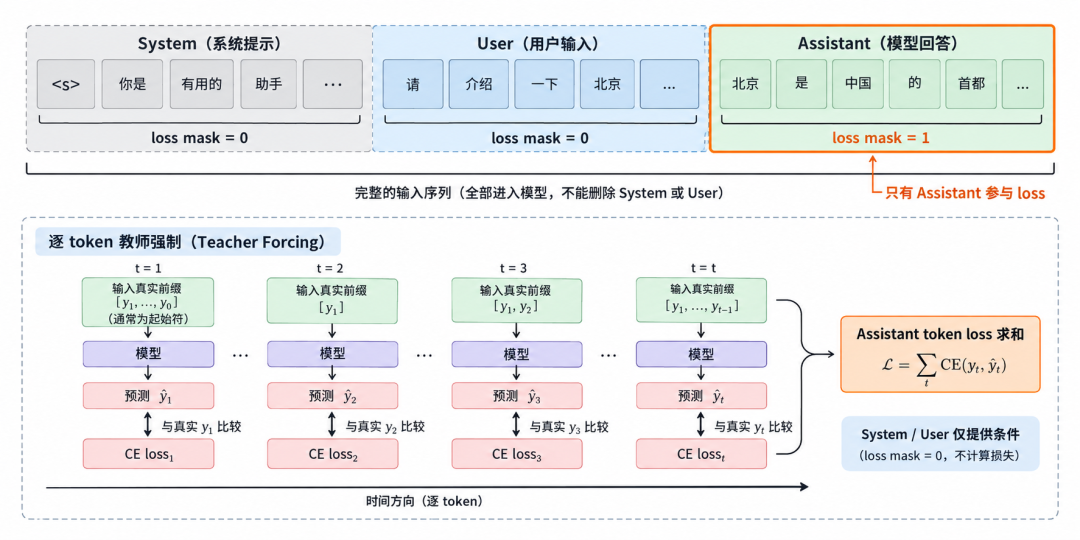
图 3:system、user 和 assistant 消息都会进入模型,但通常只有 assistant token 参与损失计算,并通过 teacher forcing 逐 token 学习示范回答。
SFT 能教会模型什么
SFT 最直接的作用,是把基础模型已有的能力组织成稳定的任务响应方式,例如:
- 遵循自然语言指令;
- 按特定格式、语气和长度回答;
- 输出 JSON、函数参数或工具调用模板;
- 使用行业术语完成领域任务;
- 学习示范中呈现的解题步骤和拒答方式。
FLAN 是指令微调早期的重要工作。它把多个 NLP 任务改写成自然语言指令,并在一批任务上微调模型。论文实验表明,这种做法能够改善模型在部分未见任务类型上的零样本表现。
InstructGPT 把人工示范 SFT 放在整条对齐流水线的起点:标注者先给出期望回答,模型从示范中学会基本的指令响应,再进入偏好学习阶段。
SFT 的能力边界
SFT 擅长模仿,却很难完整表达“哪个答案更好”。
同一个延期说明,可以有很多合格版本。有人更看重简洁,有人希望解释充分,有人关注风险承担。如果每个 prompt 只配一个标准答案,模型看到的是“这样写可以”,却不知道另一个回答为什么略差。
数据质量也直接决定了模型学到什么。示范中如果充满冗长套话,模型就会学会冗长;工具调用样本格式不一致,部署时就容易出现参数错误。数据混合比例和训练强度控制不当,还可能让模型在获得目标风格的同时丢失一部分通用能力。
SFT 的难点通常在数据:既要覆盖目标任务,也要保证质量稳定、格式一致。
2. RLHF:把人的比较转成奖励
通俗理解:RLHF 不要求标注者每次都写出完美答案,而是让他们比较多个回答,再把这种偏好转成模型可以优化的奖励。
有些要求很难写成唯一标准答案。
一封邮件是否“足够礼貌但又不含糊”,一段回答是否“既有帮助又不过度承诺”,很难逐 token 标注。让标注者在两个完整回答之间选择更好的那个,通常更自然。
经典 RLHF 流程可以分成三步。
第一步:先得到 SFT 模型
强化学习需要一个能正常生成回答的起点。SFT 模型已经掌握基本对话格式和指令响应,后续优化才不至于在巨大输出空间中从头探索。
第二步:训练奖励模型
针对同一个 prompt,让模型生成多个候选回答,再由人类标注者排序:
Prompt:写一封延期说明

回答 A:说明原因、给出新日期、提出补救方案
回答 B:只说“项目将延期,敬请谅解”

人类偏好:A > B
奖励模型接收 prompt 和完整回答,输出一个标量分数。训练目标希望 chosen 回答的分数高于 rejected 回答。
可以借用 Bradley–Terry 模型理解这种偏好概率:
P(A > B) = σ(r(x, A) - r(x, B))
如果 A 的奖励比 B 高很多,模型就会预测人更可能选择 A。
第三步:用强化学习更新策略模型
正在被训练的语言模型称为策略模型(policy)。它实际生成一批回答,也就是 rollout;奖励模型为回答打分,PPO 等算法再提高高奖励回答的生成概率。
训练目标不会只追求奖励,还会加入与参考模型之间的 KL 约束:
目标 ≈ 奖励模型得分 - β × KL(当前策略 || 参考模型)
这个约束很重要。若策略为了追求奖励偏离原模型太远,可能学会利用奖励模型的漏洞,写出得分很高、真实质量却下降的回答。图 4 把经典 RLHF 的三阶段训练流程串联起来。
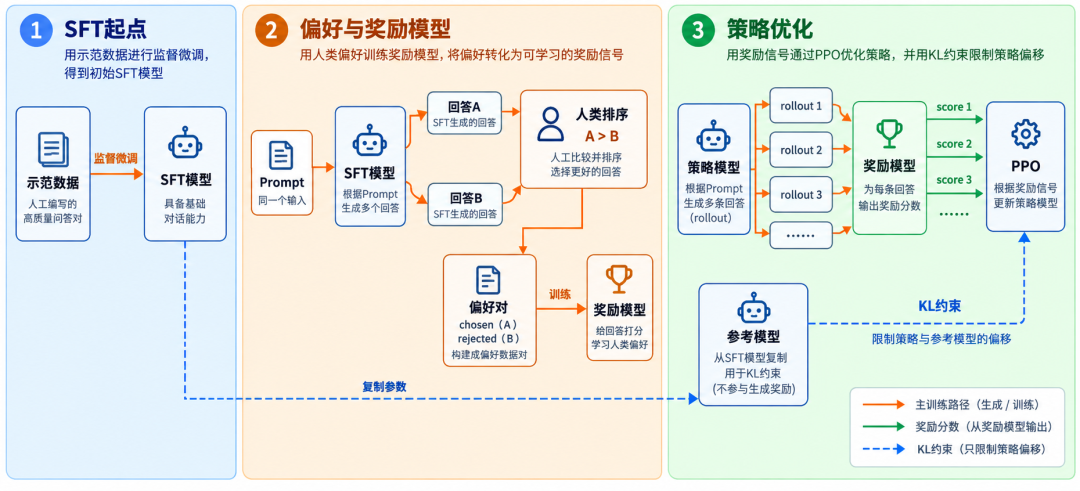
图 4:RLHF 先进行监督微调,再用人类偏好训练奖励模型,最后通过 PPO 更新策略,并用参考模型提供 KL 约束。
Learning to Summarize from Human Feedback 展示了从人类比较中训练奖励模型、再优化摘要策略的路线;InstructGPT 则将 SFT、奖励模型和 PPO 组合成一条完整的指令对齐流程。
RLHF 的代价在哪里
RLHF 把难以写成规则的偏好引入训练,但这份偏好始终是代理信号。
标注者可能偏爱更长、更自信、格式更工整的答案。奖励模型会从有限比较数据中寻找统计规律,有时也会把这些表面特征当成质量。如果策略持续优化同一个奖励模型,就可能出现奖励过优化:训练 reward 继续上涨,人工评价却停止改善,甚至开始下降。
此外,经典 RLHF 还要同时运行策略生成、奖励模型推理、参考模型约束和 PPO 更新,计算与工程链路都比普通监督微调复杂。
3. DPO:绕过显式奖励模型,直接学习偏好对
通俗理解:DPO 直接拉高 chosen 回答相对 rejected 回答的概率优势,同时用参考模型限制更新幅度。
RLHF 的偏好数据本来是这样的:
prompt + chosen answer + rejected answer
经典流程先用这些数据训练奖励模型,再让策略模型在线采样并通过强化学习追逐奖励。DPO 则直接从偏好对构造策略更新目标。
Direct Preference Optimization(DPO) 从带 KL 约束的 RLHF 目标出发,对奖励函数进行重参数化,把原本“奖励模型 + 在线 RL”的问题改写成一个直接作用于语言模型的分类式损失。
它关注的是这个相对概率差:
chosen 优势
= [log πθ(chosen) - log πref(chosen)]
- [log πθ(rejected) - log πref(rejected)]
πθ 是正在训练的模型,πref 是参考模型。DPO 希望 chosen 相对于参考模型变得更可能,同时让 rejected 相对变得不那么可能。超参数 β 控制偏好强化力度与贴近参考模型之间的平衡。两条路线的训练链路可以直接对照图 5。
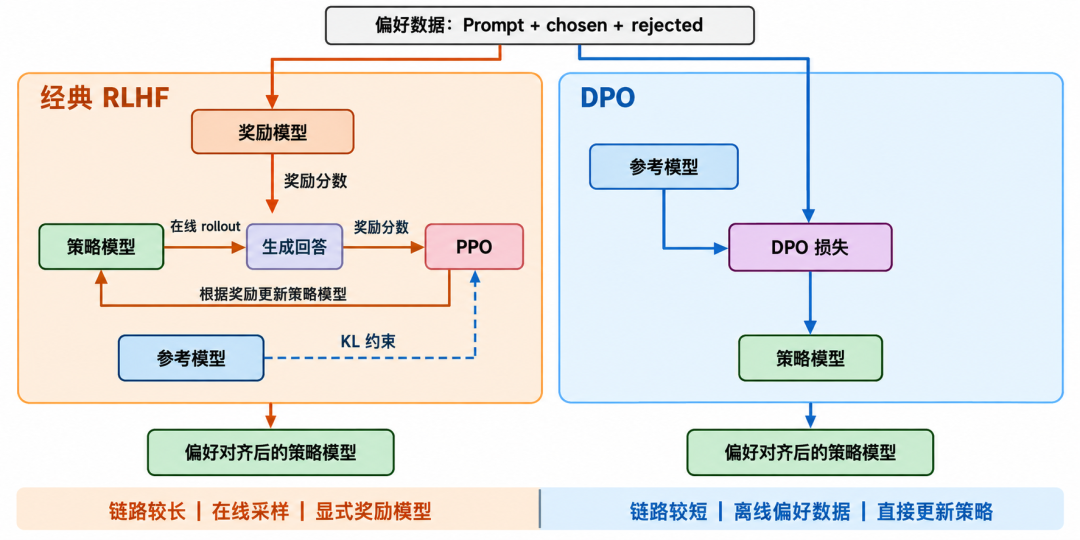
图 5:经典 RLHF 需要显式奖励模型与在线采样;DPO 直接利用离线偏好对更新策略,但仍需要参考模型提供约束。
DPO 简化了哪些环节
标准 DPO 训练有几个明显的工程优势:
- 不需要单独维护奖励模型;
- 训练期间不需要边生成新回答边执行 actor–critic 更新;
- 可以在已有的离线偏好数据上训练;
- 整体流程更接近常规语言模型微调。
因此,DPO 很快进入了开源后训练工具链。Hugging Face TRL 也把 SFTTrainer、DPOTrainer、RewardTrainer 和在线 RL Trainer 分成不同入口。
DPO 仍然依赖偏好数据
chosen/rejected 如果主要由长度、措辞或评审模型偏差决定,策略会把这些偏差学进去。
它还面对离线数据的分布问题:偏好对通常来自某个旧策略或其他模型,而当前策略训练一段时间后,已经会生成不同类型的回答。离线数据未必持续覆盖它的新行为。
显式奖励模型被省掉后,过优化仍可能发生。关于直接对齐算法过优化的研究 观察到,DPO 等方法在更大的 KL 预算或更强训练下,同样可能出现代理目标改善、真实质量退化的现象。
DPO 更准确的定位,是把经典偏好优化链路大幅缩短。它没有取消偏好学习,也不会自动修正偏好数据本身的问题。
4. RLAIF:让 AI 参与生产反馈
通俗理解:RLAIF 让另一个模型依据任务标准或一组原则,对候选回答做比较、评分、批评与修订。
RLHF 最难规模化的环节之一,是持续获得高质量的人类反馈。
开放式对话涉及大量长尾问题。每次都让人阅读多个回答、理解任务背景、按一致标准排序,速度慢、成本高,也很难保证不同标注者始终使用同一套尺度。
RLAIF,即 Reinforcement Learning from AI Feedback,把一部分反馈工作交给 AI 模型。它描述的是反馈来自 AI,并不限定只能使用某一种优化算法。
AI 反馈可以有多种形式:
- 在两个回答中选择更好的一个;
- 分别评价帮助性、安全性、事实性和表达质量;
- 依据一组原则指出回答中的问题;
- 生成修订后的更好答案;
- 在在线 RL 中直接输出奖励分数。
Constitutional AI:原则怎样进入训练
Constitutional AI 给出了一条有代表性的路线。
在监督阶段,模型先生成原始回答,再根据一条“宪法”原则批评这个回答并生成修订版本。修订数据被用于微调模型。
原始回答
    ↓ 根据原则自我批评
修订回答
    ↓ 监督微调
初始策略模型
在强化学习阶段,AI 评审模型依据原则比较候选回答,用这些 AI 偏好训练偏好模型,之后再把它作为奖励信号优化策略。
候选回答 A / B
    ↓ AI 按原则比较
AI 偏好数据
    ↓
偏好模型 / 奖励
    ↓
策略优化
图 6 进一步展示了两类反馈来源如何形成不同训练数据,并接入多种优化方式。
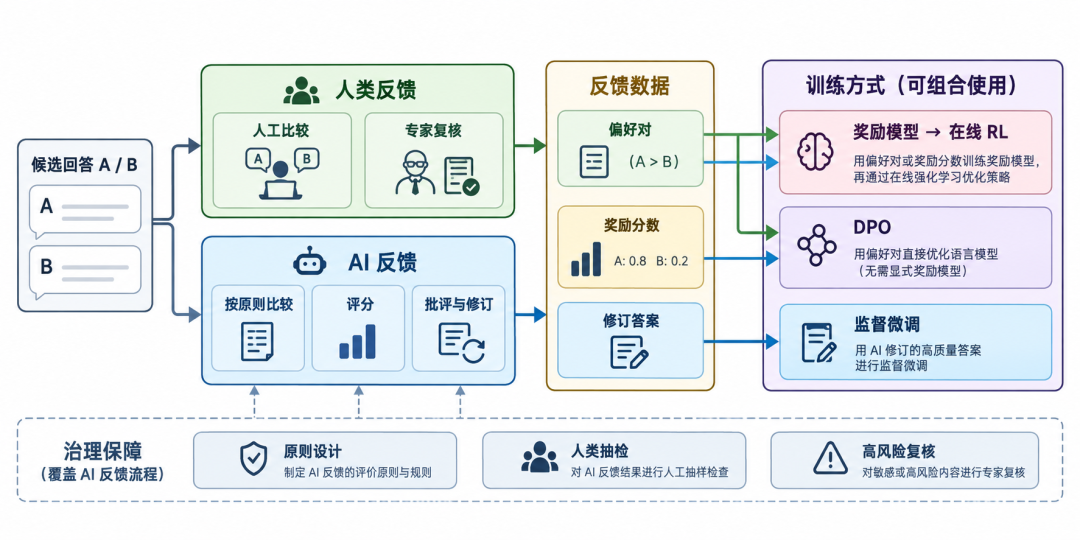
图 6:人类与 AI 都可以提供偏好对和奖励分数,AI 还可以生成修订答案;这些反馈能够分别接入奖励模型、DPO、在线 RL 或监督微调。
另一项 RLAIF 与 RLHF 对比研究 在总结、帮助性对话和无害性对话等特定实验中比较了 AI 与人类偏好。论文还讨论了两种做法:把 AI 偏好蒸馏进奖励模型,或者在 RL 过程中直接调用 AI 模型给出奖励。
这些结果说明 AI 反馈可以成为可扩展的训练信号,但不能直接推导出“AI 标注全面等同于人工标注”。实验任务、评审模型能力、提示与最终人类评价都会影响结论。
人仍然负责什么
RLAIF 降低的是逐条反馈的人工需求。人仍然要决定:
- 用哪些原则评价回答;
- AI 评审模型是否适合这个领域;
- 哪些高风险任务必须由专家复核;
- 如何抽检偏好标签和识别位置偏差;
- 最终产品是否符合真实用户需求。
如果回答生成、偏好标注和最终评测都来自相近的模型,某些共同盲区还可能被反复放大。
AI 生成的 chosen/rejected 数据可以直接用于 DPO,也可以先训练奖励模型,再走 RLHF 式的在线强化学习。RLAIF 规定的是反馈来源,并不绑定某个唯一的优化器。
5. RLVR:让程序来检查结果是否正确
通俗理解:RLVR 用程序检查答案、代码或行为是否满足明确条件,再把检查结果作为强化学习奖励。
偏好模型适合判断语气、帮助性和安全性,却未必是判断数学答案或代码正确性的最佳工具。
如果一个问题存在可自动检查的结果,就可以把 verifier 直接接入强化学习:
- 数学题的最终答案是否匹配;
- 代码能否编译、是否通过单元测试;
- JSON 是否符合 schema;
- 回答是否满足长度、关键词和格式要求;
- Agent 在环境中是否完成目标任务。
这类路线常被称为 Reinforcement Learning with Verifiable Rewards(RLVR)。
RLVR 的训练循环
一轮典型训练大致包含四步:
Prompt
  ↓
当前策略采样多条回答 / 轨迹
  ↓
Verifier 检查结果并返回奖励
  ↓
PPO、GRPO 等算法更新策略
SFT 主要提高示范轨迹的概率;RLVR 允许模型实际采样多条路径,再根据结果选择哪些行为值得加强。只要 verifier 足够便宜,训练就能反复产生大量反馈,不需要人工逐条阅读。完整训练循环如图 7 所示。
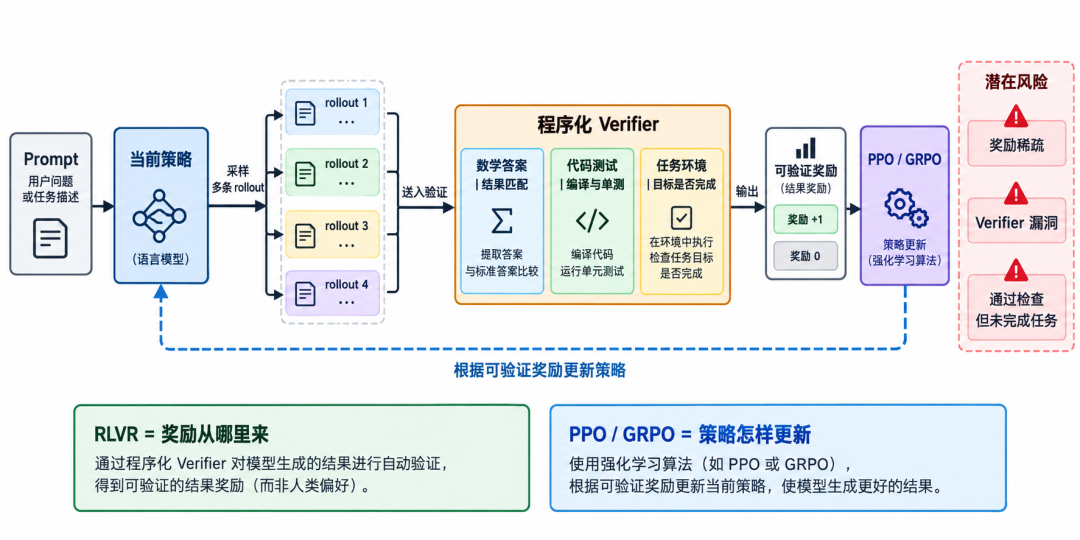
图 7:当前策略先采样多条 rollout,再由数学答案、代码测试或任务环境提供可验证奖励,最后通过 PPO 或 GRPO 更新策略。
RLVR 与 GRPO 分别解决什么
这两个词经常一起出现。RLVR 说的是奖励从哪里来:结果可以由程序或环境验证。GRPO 说的是策略怎样更新:它利用同一问题的一组采样结果构造相对优势。
DeepSeekMath 提出了 GRPO,用组内相对奖励替代 PPO 中单独的价值模型,以降低相关训练开销。一个 RLVR 任务可以使用 GRPO,也可以使用 PPO 或其他强化学习算法。
为什么 RLVR 与推理模型联系紧密
数学和代码提供了规模化、相对明确的结果反馈。模型可以尝试不同解法,正确答案获得奖励,错误答案得不到奖励。在线采样让它有机会探索示范数据中没有直接展示的求解路径。
Tülu 3 把 SFT、DPO 和 RLVR 组织成一套公开后训练流程,并把 RLVR 用于数学和可验证指令遵循等任务。
DeepSeek-R1 展示了大规模强化学习对推理行为的影响。其中 R1-Zero 在不先进行 SFT 冷启动的研究设置下直接对基础模型实施 RL,出现了自我反思、延长推理等行为,同时也出现可读性差和语言混杂。实际的 DeepSeek-R1 使用了冷启动数据和多阶段训练来改善这些问题。
可验证结果,不等于可靠过程
如果数学题最终答案正确,不能仅凭这一点确认中间推导每一步都严谨。代码通过有限测试,也不等于没有隐藏错误。
Verifier 能检查什么,模型就会围绕什么优化。检查器存在漏洞时,模型可能找到一条“通过检查但没有真正完成任务”的捷径。奖励过于稀疏时,绝大多数采样都是零分,训练也会变得困难。
开放式写作、价值判断和复杂事实解释更难定义唯一正确答案。这类任务仍需要示范、偏好、专家审核与多维评测。
6. 现代后训练,很少只用一种方法
SFT 先让模型稳定回答,偏好优化调整多个可行答案之间的选择,RLVR 再在可自动验证的任务上鼓励策略探索。三个阶段各自解决不同问题,后面的阶段无法代替前面的基础工作。
Tülu 3:SFT、DPO 与 RLVR 组成完整训练流程
Tülu 3 的公开路线可以概括为:
提示与数据构建
    ↓
SFT:建立通用指令能力
    ↓
DPO:学习偏好数据
    ↓
RLVR:增强可验证任务能力
    ↓
开发集、未见任务与去污染评测
SFT 数据说明“好答案长什么样”,DPO 偏好对进一步区分回答质量,RLVR 则在数学、规则遵循等任务上提供可检查的结果信号。
DeepSeek-R1:研究对照与完整训练路线要分开看
R1-Zero 用来观察基础模型直接接受大规模 RL 时会出现什么推理行为,也暴露了可读性和语言一致性问题。
DeepSeek-R1 的实际路线更完整:先用少量高质量冷启动数据建立可读的推理格式,再进行面向推理的强化学习;之后收集推理与非推理数据做监督微调,并进行后续强化学习,以兼顾推理能力、帮助性和安全性。
这两个案例说明,现代后训练通常由多个阶段组成。阶段顺序、数据比例与评测体系,往往和算法名称一样重要。图 8 对照了 Tülu 3 与 DeepSeek-R1 的阶段安排。
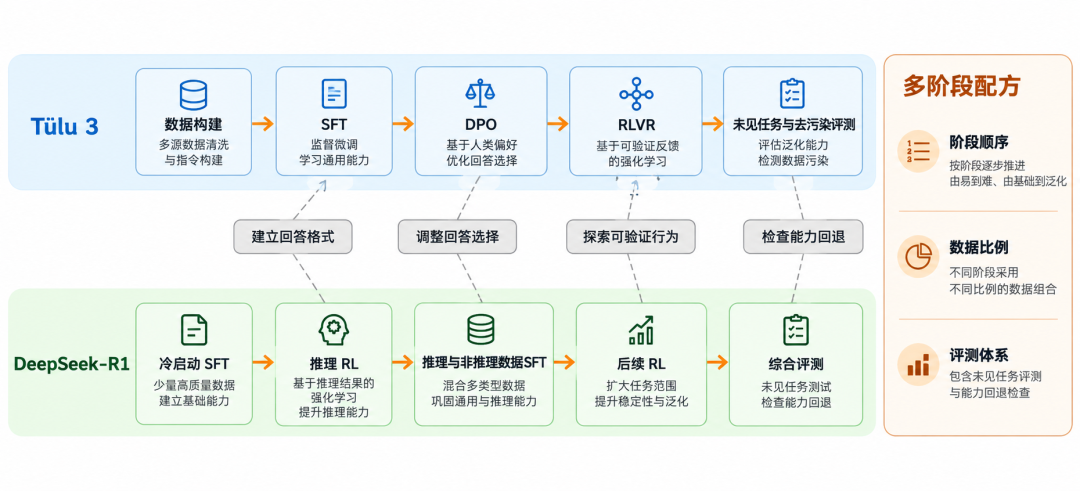
图 8:两条路线都采用多阶段训练,但 Tülu 3 依次组织 SFT、DPO 与 RLVR,DeepSeek-R1 则围绕冷启动、推理强化学习、数据回收和后续强化学习展开。
7. 选方法,先看能提供什么训练信号
讨论后训练时,人们容易先问:“DPO 和 PPO 该选哪个?”更实用的起点是:想改变什么行为,又能稳定提供哪种反馈?
| 目标 |
更需要的数据或反馈 |
可优先考虑 |
主要检查项 |
| 教会固定格式、领域表达、工具协议 |
高质量示范答案 |
SFT |
loss mask、数据混合、能力遗忘 |
| 调整帮助性、简洁度、安全边界 |
chosen/rejected 偏好对 |
DPO 或 RLHF |
标注一致性、长度偏差、KL |
| 扩大偏好数据规模、执行原则约束 |
AI 评审与规则 |
RLAIF + DPO/RL |
评审偏差、人类抽检 |
| 提高数学、代码、结构约束正确率 |
自动 verifier、测试环境 |
RLVR + PPO/GRPO |
奖励稀疏、规则漏洞、泛化 |
| 同时做通用助手与推理增强 |
多阶段混合数据 |
SFT + 偏好优化 + RLVR |
阶段回退、多任务评测 |
实际决策通常从四步开始:
- 定义希望改变的可观察行为,例如 JSON 合法率、代码测试通过率或人工帮助性评分。
- 判断能否写出高质量示范,能否稳定比较两个回答,或能否自动检查结果。
- 根据反馈形态选择训练目标,再决定使用 DPO、PPO、GRPO 等算法。
- 预留独立评测集,同时检查目标能力、通用能力、安全性和输出风格是否回退。
算法不能替代反馈设计。如果团队说不清“什么样的回答算更好”,换一种优化器通常也解决不了问题。
8. 后训练最难的,是把目标写对
这几种方法使用不同训练信号,但在实际训练中都会遇到下面这些问题。
偏好不等于事实
人类和 AI 评审都可能偏爱更长、更自信、格式更完整的回答。偏好数据适合调整交互质量,却不能单独保证事实正确。
训练奖励不等于真实质量
奖励模型可能把长度当成质量,代码 verifier 可能漏掉边界测试,格式检查器可能只看 JSON 能否解析。RLHF 会利用奖励模型漏洞,DPO 会过拟合偏好分布,RLAIF 会放大 AI 评审盲区,RLVR 也会寻找 verifier 没覆盖的捷径。
单项能力提高,其他能力可能回退
大量数学 RL 可能改变回答长度与语言风格,过强的安全偏好会增加不必要拒答,窄领域 SFT 也可能损伤通用能力。
因此,SFT loss、reward、DPO accuracy 或 episode reward 都只反映训练的一部分。真实任务成功率、人工盲评、格式与工具调用正确率、拒答边界、输出成本和通用能力回退,都应进入评测。
训练集、开发集和最终测试集也要真正分开。Tülu 3 在公开训练流程中强调开发评测、未见任务评测和数据去污染。只有留下足够独立的任务,才能判断模型学到的是可迁移能力,还是对训练指标的适应。图 9 展示了代理指标与真实质量逐渐偏离的典型情况。
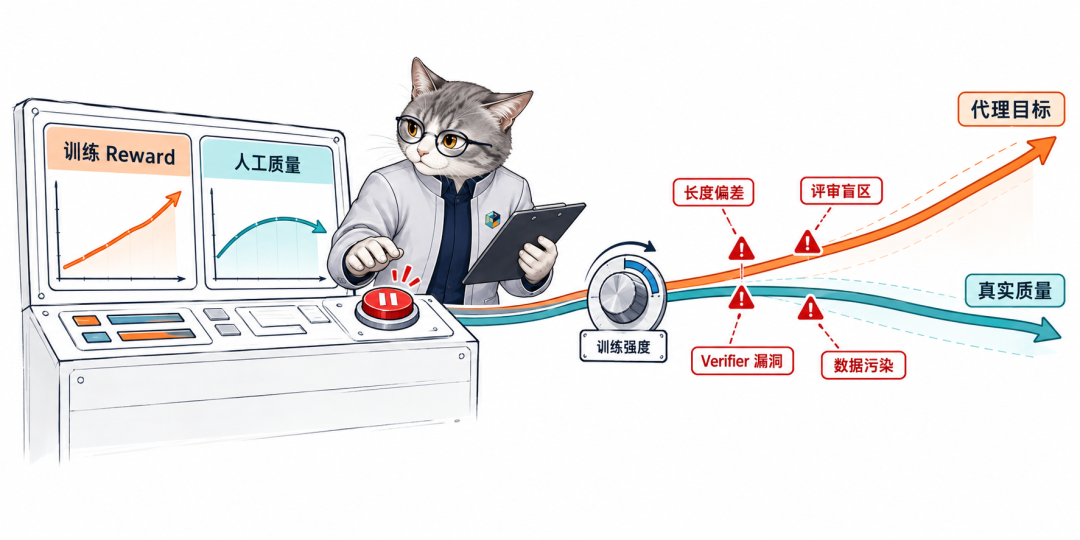
图 9:训练 reward 持续上升,并不代表人工评价同步提高;长度偏差、评审盲区、Verifier 漏洞和数据污染都可能造成指标失真。
最后:后训练是在决定模型更愿意怎样回答
回到开头那封延期说明。
SFT 让模型学习邮件格式、语气和基本内容;RLHF 从人的比较中学习哪种解释更清楚、哪种表达更得体;DPO 更直接地把这种偏好写进策略;RLAIF 依据原则批量生成评价与修订;其中可以量化的长度、格式和任务结果,还能交给 verifier 检查。
它们调整的是同一个对象:给定上下文后,模型为各种可能回答分配的概率。
SFT:照着好答案学
RLHF:从人的比较中学
DPO:直接学习偏好对
RLAIF:让 AI 扩展反馈
RLVR:让检查结果提供奖励
预训练大体决定模型知道什么、能够生成什么。后训练继续决定,当用户真正提出要求时,模型更可能选择哪一种回答方式。
训练方案不该从哪个缩写最热门开始。先明确希望模型形成什么行为,再确认示范、偏好或 verifier 是否可靠,最后选择与反馈形式匹配的优化算法。算法只有和目标、数据、评测对应起来,训练指标的提升才可能转化为真实任务中的改善。
参考链接
- From-Zero-to-AGI:https://ai-mzq.github.io/From-Zero-to-AGI/
- FLAN:https://arxiv.org/abs/2109.01652
- InstructGPT:https://arxiv.org/abs/2203.02155
- Learning to Summarize from Human Feedback:https://arxiv.org/abs/2009.01325
- Direct Preference Optimization(DPO):https://arxiv.org/abs/2305.18290
- TRL:https://huggingface.co/docs/trl/index
- 关于直接对齐算法过优化的研究:https://arxiv.org/abs/2406.02900
- Constitutional AI:https://arxiv.org/abs/2212.08073
- RLAIF 与 RLHF 对比研究:https://arxiv.org/abs/2309.00267
- DeepSeekMath:https://arxiv.org/abs/2402.03300
- Tülu 3:https://arxiv.org/abs/2411.15124
- DeepSeek-R1:https://arxiv.org/abs/2501.12948
- Tülu 3:https://allenai.org/tulu
 发表于 前天 02:11
|
查看: 5|
回复: 0


