北京时间 2026 年 9 月 23 日 02:12,OpenAI 正式发布生成式预训练第六代模型(GPT-6)的两个新成员 Sol 和 Luna,应用编程接口(API)价格均比上一代模型(GPT-5.6)对应型号的促销价降低 50%。
最值得关注的,不是模型家族又多了两个名字,而是 OpenAI 开始把同一代前沿智能拆成不同成本层:Astra 守住能力上限,Sol 承接复杂工作,Luna 负责高频和规模化调用。下一轮竞争绝不只是谁的榜单分数更高,还要看同样一美元到底能买到多少可靠的工作产出。
一、这次发布,真正变的是"智能怎么卖"
GPT-6 Astra 在 9 月初发布时,OpenAI 强调的是能力上限。Sol 和 Luna 则把重点转向成本与吞吐:Sol 每百万输入 token 为 2 美元、输出为 10 美元;Luna 分别为 0.10 美元和 0.50 美元。两者都比 GPT-5.6 同档型号的促销价低 50%。
OpenAI 还把缓存输入读取折扣提高到 90%,并允许开发者在大模型应用里不破坏此前缓存的情况下调整推理强度和工具开关。对长对话和智能体来说,这不只是账面单价下降:上下文能够重复利用,连续任务的边际成本才可能真正降下来。
模型竞争正在从"单次回答最聪明"转向"持续工作最划算"。企业购买的不是一次考试分数,而是数千次工具调用、长上下文复用和失败重试之后的总成本。
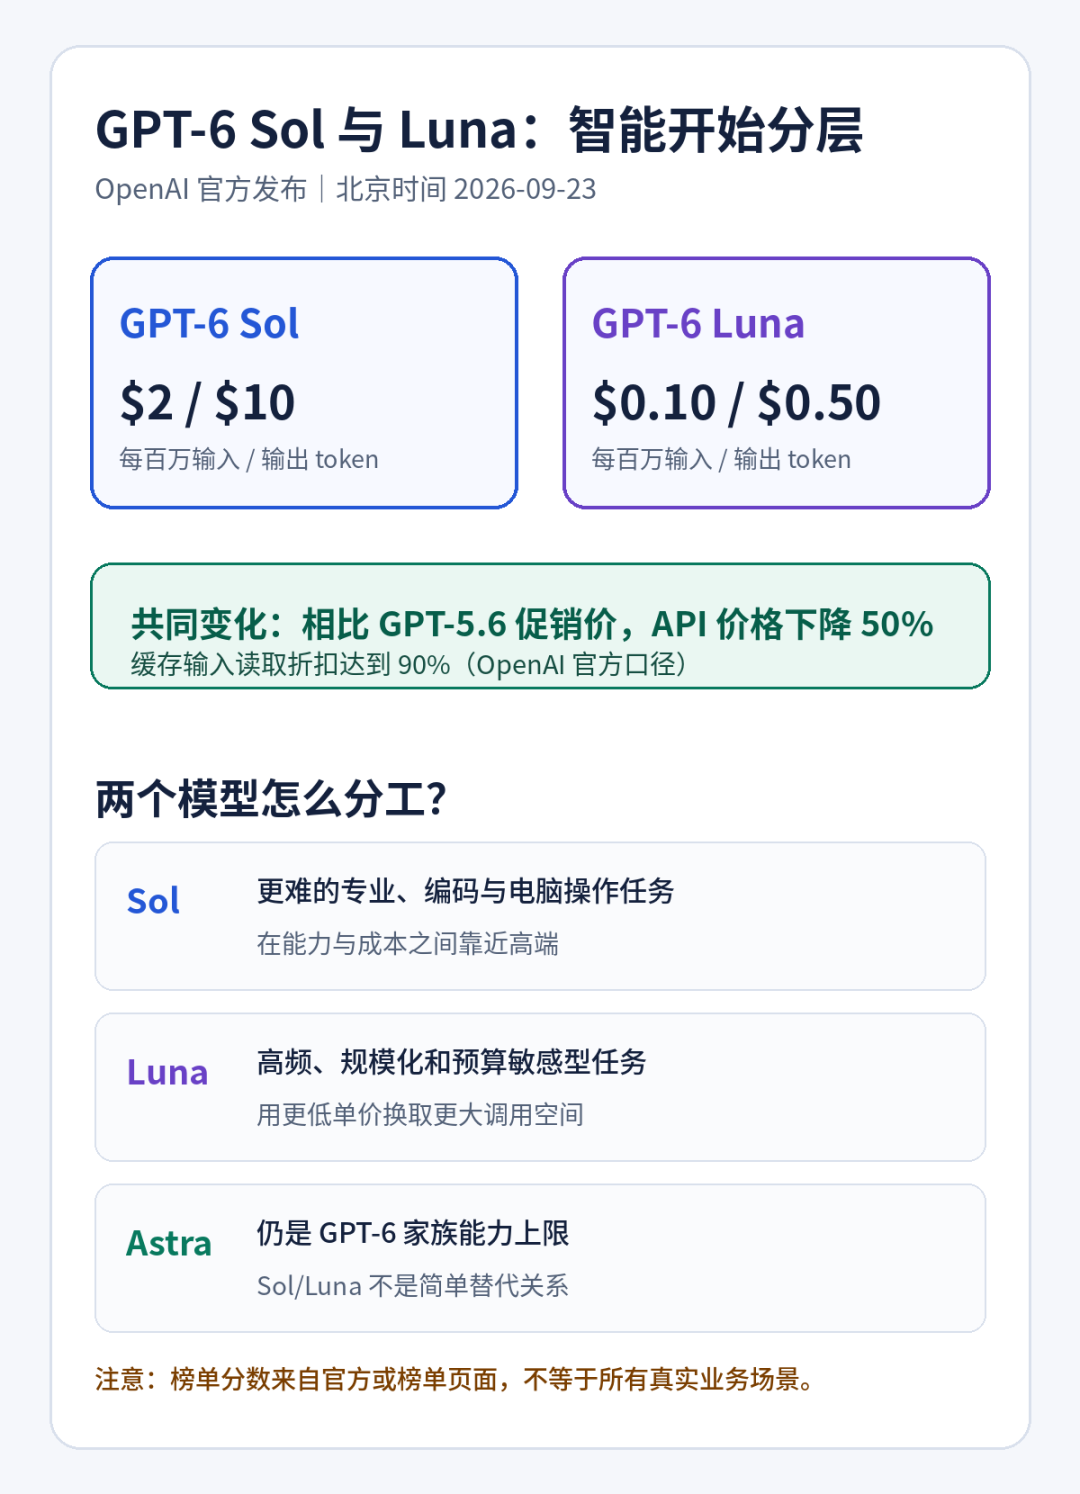
图:根据 OpenAI 公开价格、模型定位和上线说明整理。
二、Sol 和 Luna 不是一强一弱,而是两种工作预算
Sol 面向更难的专业工作、编码和电脑操作任务。OpenAI 希望它在明显低于 Astra 的成本下,保留足够多的高端能力。Luna 则把价格压得更低,适合高频分类、批量处理、轻量智能体步骤,以及预算对每次调用都敏感的产品。
这有点像团队用人:不是所有任务都需要首席专家亲自上场。困难决策交给 Astra 或 Sol,大量可标准化步骤交给 Luna,再通过路由器动态升级。真正的工程难题会变成:怎样判断任务难度,什么时候升级模型,失败一次后是否值得再花十倍成本重试。
价格更低,不等于总账单一定更低
如果模型更便宜后,团队把调用量扩大十倍、把智能体循环拉得更长,最终支出仍可能上升。需要一起观察的还有成功率、重试次数、工具调用量、延迟和人工复核成本。
三、官方榜单很亮眼,但要逐项看测试在测什么
在企业自动化评测系统(AutomationBench)1.0.6 上,OpenAI 称 Sol 以最高推理强度取得 33.2%,高于 Claude Opus 5 最高档的 26.9%,单任务成本约为后者的 9%。这个基准覆盖销售、营销、运营、支持、财务和人力资源等 47 种工具工作流。数字说明 Sol 在这组任务上有较好的成本效率,但不等于它在所有企业流程里都能以相同比例胜出。
在 Agents' Last Exam 中,OpenAI 报告 Sol 最高档得到 56.4%,并称单任务成本比 Claude Opus 5 的最高分配置低 60%。该项目关注可验证的长流程专业工作;当前公开介绍显示它覆盖 55 个细分行业,并计划收集 5000 项任务。这里的意义是"能否完成一整段工作",而不是单道问答准确率。
编码方面,OpenAI 报告 Sol 在深度软件工程评测系统(DeepSWE)1.1 达到 68.8%,距离 Claude Fable 5 最高档 69.9% 相差 1.1 个百分点,但成本约低 80%;Luna 最高档为 66.6%。DeepSWE 官方页面说明,这套测试使用 91 个代码仓库、覆盖 5 种语言,任务从零编写以降低训练数据污染。
需要强调的是,以上模型分数主要来自 OpenAI 发布页。前沿代码评测系统(FrontierCode)的独立榜单页面已经出现 GPT-6 Sol 和 Luna 条目,但其余页面目前主要能独立核验基准定义,不能视为全面复现了 OpenAI 所有结论。
四、编码智能体为什么最可能先感受到变化
编码智能体会读大量文件、反复调用终端、修改代码、运行测试,再根据失败继续迭代。一次任务可能消耗远多于普通聊天的 token。OpenAI 披露,按 API 价格估算,其内部研究人员每日编码智能体用量的中位数已超过 600 美元,90 分位超过 7000 美元。这个数字只描述 OpenAI 内部使用强度,却很好地解释了为什么成本曲线会成为发布主角。
当模型能连续工作数小时,团队不再只比较"哪一个回答更漂亮",而会比较完成一次可合并代码修改要花多少钱。Sol 试图占据复杂编码与成本之间的甜点位;Luna 则可能承担代码搜索、格式修复、测试归因和重复性较强的子步骤。
但漂亮基准不等于仓库里一定好用。真实项目还会受到权限、依赖、私有代码、测试质量和需求模糊程度影响。团队应从小规模真实任务开始,记录每个模型的成功率、人工返工时间和总调用成本,而不是直接按排行榜替换全部流程。
五、谁能用,现阶段又有哪些限制
OpenAI 表示,Sol 和 Luna 已面向 Plus、Pro、Business、Enterprise 和 Edu 用户在 ChatGPT Work 与 Codex 中开放,并在发布当日逐步放量。Free 和 Go 用户可以在桌面应用中使用 Luna。两款模型同时通过 API 提供,型号分别为 gpt-6-sol 和 gpt-6-luna。
发布页还写明,两款模型尚未进入普通 Chat 界面。由于采用逐步上线,不同账户看到模型的时间可能不同。OpenAI 的评测环境、API 和最终产品还可能使用不同系统提示、工具和配置,因此榜单输出与用户实际体验不会完全一致。
安全方面,OpenAI 称 Sol 和 Luna 继承 Astra 的对齐训练,并在误导性编码声明等测试上优于 GPT-5.6 对应型号。不过发布页链接的是 GPT-6 Astra 系统卡,而不是独立的 Sol/Luna 系统卡。现阶段更稳妥的理解是:官方宣布它们沿用了同一代安全路线,具体风险差异仍需要更完整材料。
六、判断:大模型进入"配置组合"竞争
第一,最强模型不会消失,但不会负责每一步。真正成熟的产品会像云计算分配通用处理器和图形处理器一样,根据任务难度、风险和预算动态选择模型。
第二,缓存和路由可能比单次降价更重要。如果一套智能体能够复用长上下文、避免重复读取仓库,再把简单步骤交给 Luna,系统级节省会比模型单价变化更明显。
第三,评测单位将从"每道题"变成"每项工作"。以后更值得看的指标,是完成一次可验收任务的总费用、总时间、人工复核量和失败恢复能力。
Sol 和 Luna 是否真的重画了性价比曲线,还要等更多独立使用与复现。但 OpenAI 这次已经把竞争问题改写了:前沿智能不再只是一个昂贵的最大型号,而是一组可以被产品按需编排的计算资源。这也是云栈社区上众多开发者正在持续追踪的话题。
主要参考资料
文中模型能力与价格以发布时公开信息为准。未被独立复现的比较结果均按 OpenAI 官方口径表述。
 发表于 前天 01:33
|
查看: 5|
回复: 0


