凌晨两点,第 20 轮迭代启动。没有人在值班。提方向、写代码、训练、评估、上线——整条链路里,人类最后一次出现,是两周前批准这个循环开始的那一刻。2026 年 7 月,阿里 Lazada 广告召回系统,真实生产环境。
如果你写算法,这篇文章写的是你的日常:那个「下一步该改哪儿」的夜晚。如果你不写算法,这篇文章写的是一种工作正在被重新定义——就像当年翻译和司机没有被机器取代、但工作内容彻底改变一样。
驱动那个凌晨循环的,是一个 8B 的专用模型,叫 Astar(阿里与浙大,arXiv:2608.27287)。它只会一件事:提出 AI 系统的下一步演化方向。
而这件事,在此之前完全是资深工程师的地盘。
先给一个坐标。Astar 做的这件事,在研究社区有一个名字:递归自我改进,Recursive Self-Improvement,RSI——系统为自己(或同类系统)提出改进,而每一轮改进的结果,又成为下一轮改进的燃料。这四个字母此前主要活在思想实验和安全论文里:人们争论「AI 修改 AI」会不会失控、评估器该不该上锁。2026 年,它以一张吞吐表的形式走进了生产环境。
读下去之前,先给你三句话兜底。通用大模型在这个任务上的表现和人类专家几乎同分,而且都不及格——瓶颈不是聪明,是经验放在哪里。Astar 的解法不是提示词,是把系统自己的失败记录训练进权重。以及,它顺手造了一个秒级的「裁判」,这个裁判既是全文最强的组件,也是我最想替你盯紧的组件——因为按照 RSI 的惯例,裁判恰恰是最不该被系统自己碰的东西。
01|最后一双人的手
工业 AI 系统的迭代,拆开看是四步:有人提出「下一步改哪儿」,有人(或 agent)把它写成代码,集群训练几个小时到几天,评估决定去留。然后循环。
后三步这两年飞速自动化了。第一步没有。
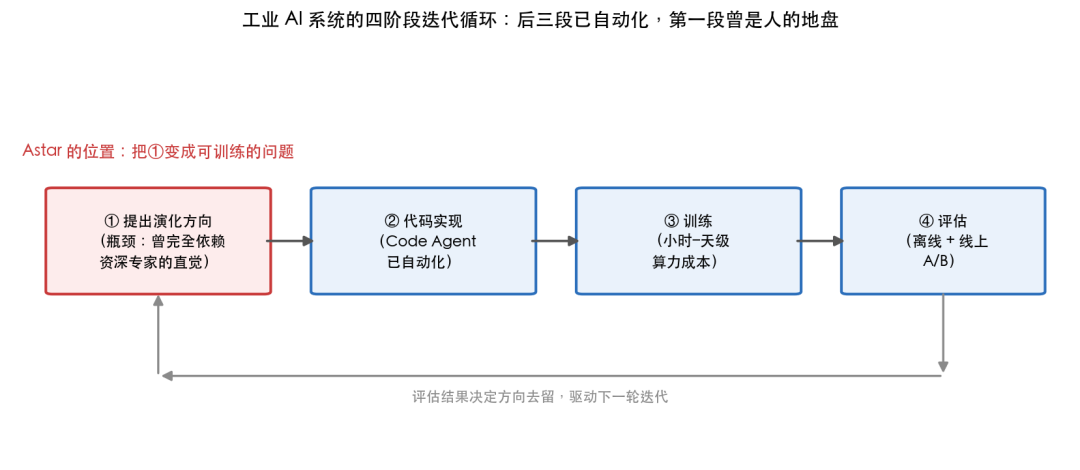
四阶段迭代循环
为什么第一步这么难?论文给了两个理由,都朴素得让人点头。
一是它太吃综合判断。提出一个好方向,要同时懂业务、懂数据分布、懂模型架构、懂训练动态,还要在心里推演「这个模型还能怎么变好」。没有公式,没有检查清单。
二是验证太贵。验证一个方向等于跑一次完整训练加评估,工业系统里以天计。选错方向的代价不是几分钟,是几天算力和一个团队的等待。所以这一步交给了最贵的人:资深专家。
那直接问通用大模型不行吗?行,而且论文真的测了。结果是全文最被低估的一组数字:
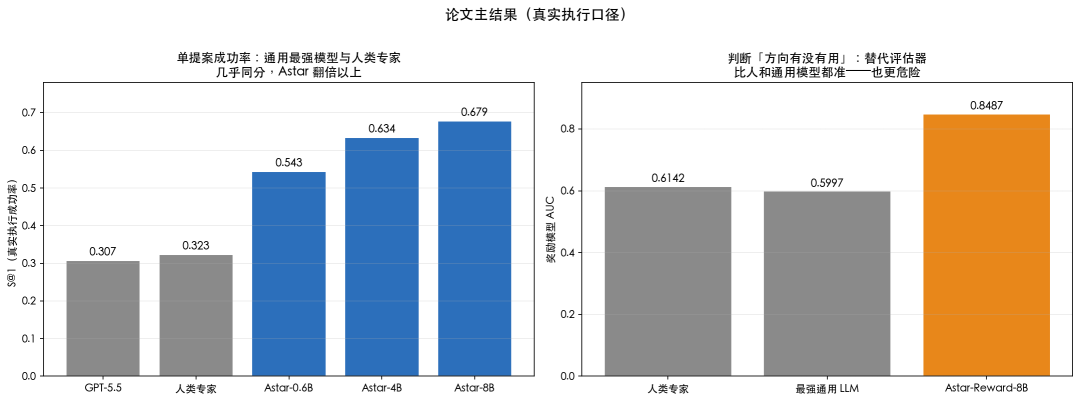
GPT-5.5 的单提案真实执行成功率,0.3071。人类专家,0.3229。
请记住这组数字的形状:当今最强的通用模型和资深专家打平,且都在及格线以下。 通用模型读过所有公开论文,却没读过这个系统的失败记录。它的建议听起来头头是道,落下去指标纹丝不动。
把领域知识写进提示词呢?论文的判断很清醒:这类知识很难被语言化。它活在几百次 commit 的成败里,活在「上次这么改没用」的记忆里。Prompt 注入得了文档,注入不了经验。
所以 Astar 换了一条路:不注入,训练。
02|让系统自己教模型
经验没写成文档,但经验留下了痕迹:git 的提交历史,和每次实验的日志。
每一次 commit 就是一页实验记录:从哪个版本出发、改了什么、指标变成什么样。哪些方向试过、哪些真的有效,全在里面。idea 由此而来:让这个系统自己的历史,教模型怎么改它自己。
听起来浪漫,落地是四个坑。
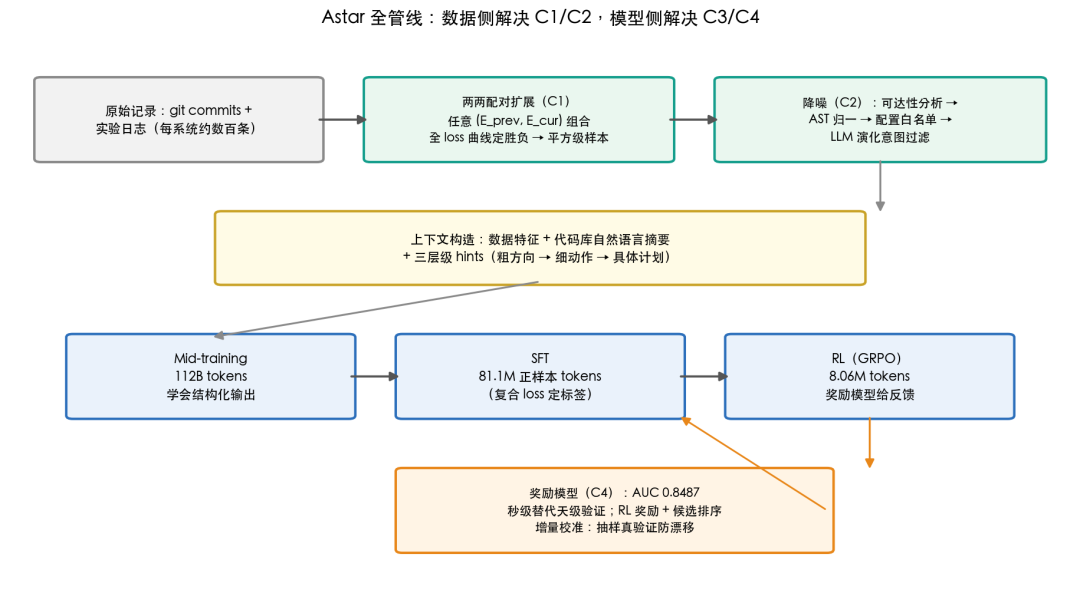
坑一,记录太少。一个系统的实验历史通常只有几百条,只取相邻两次实验之间的「方向」,样本更稀,还常常只是残缺的微调。
坑二,噪声太多。大量 commit 跟性能毫无关系:改日志、改配置、重构代码。直接喂给模型,它会学到一堆虚假模式。
坑三,方向空间太大。架构、损失、优化器、数据,每个维度下还有无数细粒度动作。没有引导的搜索,等于蒙眼摸象。
坑四,验证太慢。天级的验证周期,喂不起强化学习的探索,也喂不起大规模候选筛选。
Astar 的全部设计,就是对着这四个坑一一填土。接下来两节有点硬,不写代码的读者可以抓住每段开头的那个类比,细节跳过不影响理解。
03|数据工程:把几百条记录变成几万条
先解决「太少」:不只是比较相邻两次考试,而是把一学期的任意两份答卷 cross-compare。
论文的做法叫 pairwise 扩展:任意取两个版本配对,几百条记录立刻变成几万个样本。那谁好谁坏怎么定?不看单个指标点,比较两条完整的 loss 曲线——谁收敛得更好更稳,谁就是更优版本。方向标签则是两个版本之间修订差异的摘要。
副作用是好的:模型既见得到短期微调,也见得到跨越多轮的长期跃迁。
再解决「太脏」:先在改动记录里,只圈出「真的改了算法」的那些。
三段规则,层层过滤。第一段叫可达性分析:给两个版本的代码建调用图,删掉死代码和不可达分支——没被执行的改动不算演化。第二段叫 AST 归一:解析语法树,删掉 print、assert、注释,抹平格式和 import 顺序——语法噪音不算演化。第三段叫配置白名单:diff 里的改动分两类,output_dir、gpu_count 这类工程变量丢掉,learning_rate、optimizer 这类算法变量留下。
规则滤完还有语义滤:让 LLM 判断这次改动有没有明确的演化意图,说不清的丢掉。同时让它产出两样东西——一个三层级的「hints」(先粗方向、再细动作、再具体计划,像医生先定科室、再定检查、再定剂量),和一段简洁的改动说明。
做过数据管线的人会发现,这套动作的本质很熟悉:先定义什么算信号,再谈模型。 和我们清洗另类数据时对待 vendor 文件的方式,是同一门手艺。
最后给每个样本配上「当时的系统状态」:数据的结构化统计,加代码库的自然语言摘要。状态到方向,样本才完整。
04|三阶段训练:先学看片子,再学优秀病例,再放手探索
Astar 全管线
把训练想成培养一个住院医。
第一阶段 mid-training(112B tokens) 是让他大量看片子,学会用规范的格式写病历:在完整演化历史上做 next-token 预测,目标是学会输出带三层级 hints 的结构化方向。论文特意否掉了「把历史塞进上下文窗口」的偷懒路线——那只会让模型背病例,不会看病。
第二阶段 SFT(81.1M 正样本 tokens) 是只跟优秀病例学习。历史里成败混杂,SFT 只学成功的。成功怎么定义?一个复合指标:末步 loss、末若干步均值、末若干步波动,三者加权——分别看收敛结果、滤掉瞬时噪声、惩罚振荡。两个版本比这个指标,降者为正样本。
第三阶段 RL(GRPO,8.06M tokens) 是放手让他探索新疗法。但真验证太贵,于是有了下一节那个关键角色。
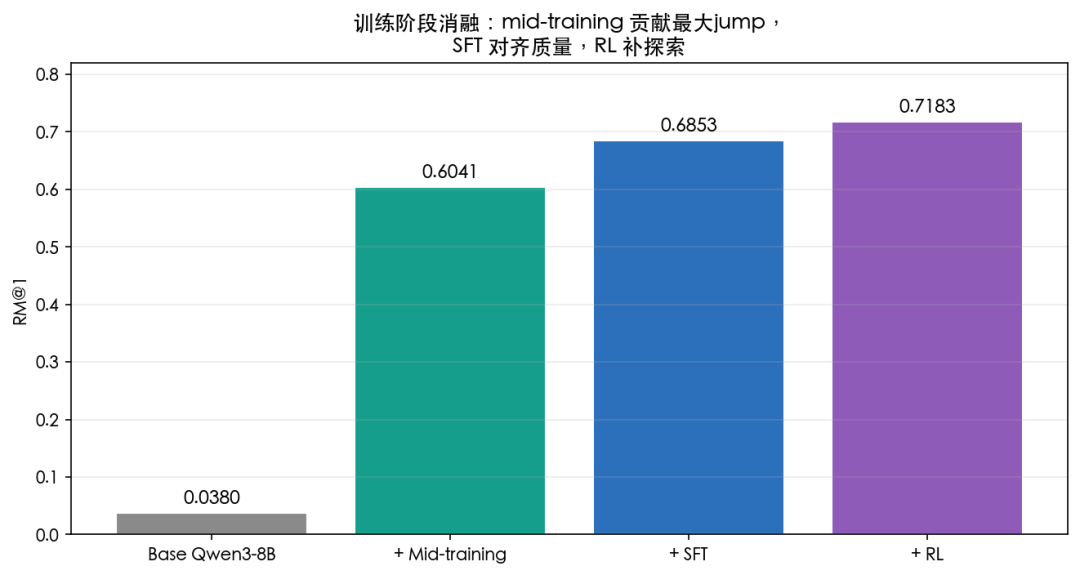
消融实验把三阶段的贡献摆得很清楚:base 模型 RM@1 只有 0.0380(跟通用模型一个水平),mid-training 一步跳到 0.6041,加 SFT 到 0.6853,加 RL 到 0.7183。最大的那一级台阶,是领域经验一次性注入的地方。
训练阶段消融
05|一个不会下场打球、但眼光极准的教练
验证一个方向要几天,但 RL 探索需要即时反馈。矛盾的解法是训练一个奖励模型:用前面筛出的正负样本,学一个「这个方向会不会降 loss」的二分类器。天级验证变成秒级预测。
这个教练身兼三职:RL 的奖励函数、候选方向的排序器、离线指标的裁判。
眼光也确实准。判断「方向有没有用」的 AUC:奖励模型 0.8487,人类专家 0.6142,最强通用模型 0.5997。十次排序对八次半,比人和通用模型都强。
论文主结果
左图是单提案的真实执行成功率:Astar-8B 0.6786,最小的 0.6B 版本 0.5435 也已经超过所有通用模型和人类专家。右图就是那位教练的视力表。
但请把 0.8487 翻过来看:大约 15% 的排序是错的。
而这 15% 的错误同时流进三个地方:RL 的策略梯度、候选排序、以及论文自己的离线指标。论文知道教练会看走眼,给了增量校准——周期性抽最近策略的一部分输出做真实验证,预测和真实持续对不上,就用这批已验证样本更新教练,再恢复训练。
方向是对的。但「一部分」是多少、校准间隔多长、间隔里策略已经跑偏多远,论文没给数字。
而这位教练自己,也在被这个循环改变。 论文第 3.4 节把回环闭合:Astar 提出方向 → Code Agent 实现 → 训练评估 → 部署 → 结果被采样、降噪、结构化成新样本 → 回流继续训练 Astar 自己。没有这条回流,Astar 是一个静态模型:目标系统一旦演化出训练时没见过的新状态,它的提案就会过时,够不着新的优化前沿。有了这条回流,Astar 与目标系统共同演化——20 轮部署里它一直在变强。
把这一段翻译成 RSI 的语言,就是全文最重要的一句结构描述:改进的产物,反过来改进了改进者本身。 目标系统被 Astar 改变;目标系统的新历史改变 Astar;Astar 再提出下一个方向。递归,两层,闭环。论文标题里的 self-evolving,指的就是这个。
也请注意递归经过的那个零件:奖励模型。Astar 在增量更新自己的评估器——按照 RSI 安全讨论的惯例,这恰恰是最敏感的一层。论文的刹车是部署前的真实 A/B:递归可以在内圈转,但出圈必须过真实裁判。这个设计是否足够,是第 09 节八个问题里的第一个。
这不是挑刺。第 08 节我们会用一个合成实验,把「对着看走眼的教练做最大化」会发生什么,演给你看。
06|结果:数字,和一张改变经济学的表
部署在 Lazada 广告召回模型上:两周、20 轮连续迭代,离线 Hitrate@200 累计提升 23.6%;随后 5 天线上 A/B,GMV +4.86%、广告收入 +1.82%、点击 +0.84%、订单 +1.79%,p < 0.05。
但全文对我冲击最大的,是另一张表。
人工工作流:每周验证 Θ(1) 到 Θ(10) 个方向,每个方向耗 Θ(1) 到 Θ(10) 小时人力。Astar 工作流:每周 Θ(100) 个方向,每个方向 Θ(1) 到 Θ(10) 分钟。
一到两个数量级。
所谓「造物飞轮」,真正含义不是 AI 比人聪明,而是试错的边际成本被压到了可以连续转起来的水平。飞轮转起来之后,聪明才开始复利。
07|两个案例:它到底提出了什么
第一个案例发生在生成式召回系统里(RQ-VAE 码本结构)。Astar 发现 decoder 里共享的 FFN 被迫用同一组参数,同时拟合粗粒度和细粒度两层码本的分布,层级之间互相打架。它的提案:换成 MoE,每层码本一个专家,按层级索引确定性路由。妙在成本——每个 token 仍然只激活一个专家,FLOPs 中性。结构改了,账单没变,干扰没了。
第二个案例有数学美感,值得为不写代码的读者多花三十秒。
Muon 是一个优化器,核心动作是把梯度矩阵的所有奇异值「拉平到 1」,让各个方向权重均衡。干净数据上这招极好。但推荐场景的梯度谱长这样:一小撮真实信号,沉在一大片噪声里。
随机矩阵理论给了一条确定性的分界线,叫 Marchenko-Pastur 边界:边界之内基本是噪声,之外才是信号。Muon 的「一刀切」问题就在于,它把噪声也一并拉平到 1——本来被压着的噪声,被系统性放大。
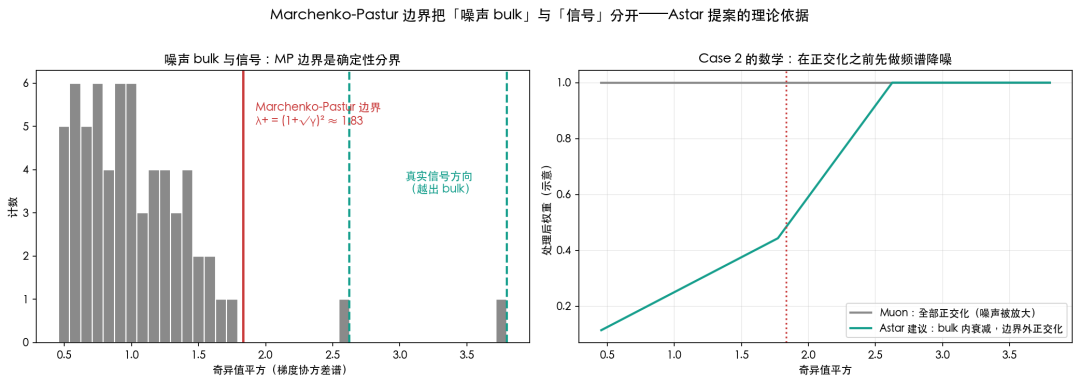
Marchenko-Pastur 边界
左图里,灰色的一片是噪声 bulk,红线是 MP 边界,越界的两条虚线是真实信号。Astar 的提案是:在拉平之前先做一步频谱降噪——边界之上正常处理,边界之内衰减。无学习参数,无额外训练负担。
一个模型,从自己系统的训练动态里,提出了一个有随机矩阵理论背书的优化器改造。这是「内化经验」四个字最硬的注脚。
08|我们自己的两个小实验
按惯例,我们用合成数据复现机制(只读方向,不读大小)。
实验 A:三种提案者。 40 个候选方向、20 轮迭代、60 个种子。随机提案的真实成功率 0.442;带一个「听起来合理但与真实效果几乎无关」先验的提案者 0.465;从历史成败里学习的提案者 0.920。
「像通用 LLM 那样合理」约等于随机。这就是第 01 节那组同分数字的合成版本:合理不等于有效,有效来自这个系统的失败记录。
实验 B:赢家诅咒。 给一个视力与论文教练相当(AUC≈0.85)的替代评估器,让策略每轮生成 N 个候选、按它的分数选最优。N 从 4 涨到 256 的过程中:评估器的自我宣称值从 0.196 涨到 0.567;被选中方向的真实价值只从 0.116 涨到 0.346 就平台了;两者之间的差距从 0.081 单调涨到 0.221。
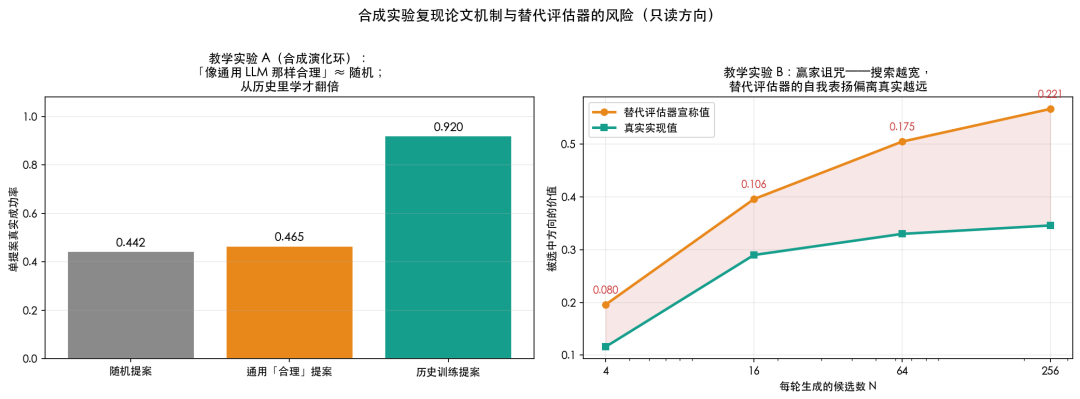
教学实验
右图那条红色阴影,就是教练的表扬与真实水平之间的裂缝。搜索越宽,裂缝越深——因为对着有噪的分数做最大化,选中的越来越是「分数的误差」而不是「真实的价值」。拍卖会上出价最高的人,常常是评委高估的那一个;这不是恶意,是数学。
Astar 的 RL 正是对着这样一个教练做最大化。它的防线是增量校准和最终的真实 A/B。但在校准间隔之内、在 A/B 之前,这条裂缝是裸露的。
演化环动图
09|替它接住八个问题
掌声之后,是提问时间。
第一,评估有循环。 离线指标用他们自己的奖励模型当裁判,而奖励模型同时是 RL 的奖励和排序器。论文用「离线指标与真实执行一致性高」自证,但一致性本身是在教练参与下测的。
第二,缺三个基线。 通用 LLM 加完整提交史 in-context(论文说训练优于注入,却没测注入);奖励模型加简单搜索(不需要训练提案者);AlphaEvolve 式演化搜索加同一个奖励模型。没有这三条,「训练是必要的」只证明了一半。
第三,pairwise 扩展的归因是模糊的。 跨多轮的版本对,差异里混着多次改动;「方向」标签是差异摘要,不是因果归因。模型学到的可能是「那段时期的组合拳」。
第四,loss 不等于业务。 所有标签来自 loss 曲线;业务价值只在最后一次 A/B 露面。召回阶段的 23.6% 与端到端的 4.86% 之间隔着排序和出价,换算关系论文没给。
第五,单系统、单窗口。 一个召回模型、20 轮、5 天 A/B;p 值给了,置信区间没给。「self-evolving」目前是 per-system 的,跨系统迁移在 future work 里。
第六,112B tokens 与「每系统数百条记录」之间的张力。 语料必然横跨大量仓库;那么能力里多少来自目标系统自己的历史、多少来自跨系统先验?这个消融缺失,而它决定「换系统要不要重训」。
第七,预定义分类法是探索的天花板。 三层级 hints 是预定义的;RL 的探索被约束在分类法之内。案例二那种跨学科提案是个案还是常态,论文没有系统证据。
第八,可复现性。 内部数据、内部模型、阈值 0.5。外部团队能复现管线,复现不了结果。
10|它站在哪条线上
最后把 Astar 放进更大的地图,给专业读者。
与 AlphaEvolve、FunSearch 一族相比:那一族是「搜索代码 + 确定性评估器」(数学正确性、benchmark 分数)。Astar 的评估器是学出来的概率模型——更强(能评开放方向),也更脆(有 15% 的错)。确定评估器与学习评估器,是两条路线的分水岭。
与 MLE-bench、SWE-agent 一族相比:那一族自动化的是「执行」,方向由人给;Astar 自动化的是「方向」,执行交给 Code Agent。互补,不竞争。
与 RSI 文献相比,Astar 的位置可以用 2026 年那篇递归自我改进综述的四层框架来读:系统改进的对象分为部署行为、训练策略、评估器、研究过程四层。Astar 一只脚踩在研究过程层(替目标系统决定下一步试什么),另一只脚踩进了评估器层(奖励模型增量更新)——后者正是安全讨论最想上锁的那层。对照本系列拆过的 AQuA:它把评估器密封在 agent 够不到的地方,宁可牺牲灵活性也要堵泄漏;Astar 相反,把评估器放进回环里,用部署前的真实 A/B 做外圈刹车。两种答案对应两种世界:一个泄漏即作废的世界,和一个存在最终真实裁判的世界。 RSI 从思想实验变成工程问题之后,争论的焦点也从「要不要递归」变成了「递归的内圈里允许放什么」。
与奖励黑客文献相比:agent 对可见指标作弊是恶意版本;Astar 的策略对着评估器的误差面做最大化,是温和版本——不是恶意,是数学(见实验 B)。
结尾:换工位,不是失业
回到那张效率表。每周上百个被验证的方向、每方向分钟级人力——「提出方向」这项职能,正在从手艺变成基础设施。
论文的展望也指向同一处:多轮反思、多 agent 共判(创新者、批评者、验证者)、跨场景扩展。下一代 Astar 会把一部分验证成本,从真实执行搬回测试时推理。
实验 B 提醒我们:搬得越多,赢家诅咒越裸露。真实裁判永远要保留席位——哪怕它很贵、很慢、一周只开一次庭。
机器之心那篇的结尾说,未来的分工是「人类设计 Meta-AI 来指导 AI」。
我想补半句:人类还要设计那台不允许被讨好的裁判。
RSI 的第一个工业样本,最终不是以接管叙事到来的,而是以一张吞吐表到来的:每周 Θ(100) 个被验证的方向,每方向分钟级人力,GMV +4.86%。它被 GMV 考核,也被 GMV 约束——这大概是递归自我改进能拥有的最朴素、也最结实的刹车。
以及,给此刻正在读这篇的工程师:你的经验没有贬值,它刚刚变成了训练数据。问题只是——由谁来定义它的标签。
动手区:最小可跑骨架
import numpy as np

def pairwise_expand(experiments, loss_metric):
    """任意两版本配对,全 loss 曲线定胜负(C1 的可跑版)。
    experiments: [(version_id, loss_curve_array)],按时间排序。"""
    samples = []
    for i in range(len(experiments)):
        for j in range(len(experiments)):
            if i == j:
                continue
            vid_p, lp = experiments[i]
            vid_c, lc = experiments[j]
            z = 1 if loss_metric(lc) < loss_metric(lp) else 0
            samples.append((vid_p, vid_c, z))
    return samples

def combined_loss(curve, alpha=0.5, gamma=0.2, k=10):
    """论文式 (1):末步 + 末 k 步均值 + 稳定性惩罚。"""
    tail = curve[-k:]
    return (1 - alpha) * curve[-1] + alpha * tail.mean() + gamma * tail.std()

def winner_curse_demo(proxy, true_delta, n_candidates):
    """实验 B 的一行版:对 proxy 做 argmax,
    返回 (评估器宣称, 真实价值);gap 随 n_candidates 增大。"""
    sel = int(np.argmax(proxy[:n_candidates]))
    return proxy[sel], true_delta[sel]

# 循环骨架:propose → code agent → train/eval → 记录 (state, direction, outcome)
# → 回流训练;教练增量校准:每 K 轮抽样真验证,偏差持续则更新。
 发表于 前天 02:08
|
查看: 3|
回复: 0


