离线评估通过了,上线之后效果却对不上。
遇到这种情况,大多数团队的第一反应是换模型、调参数、补数据。每一步看起来都像是在解决问题,成本也实实在在往上走。可问题真的出在模型本身吗?
Uber 在 9 月 22 日发布的工程文章里,举了一个小得让人意外的例子:训练时语言字段是 en-US,真正预测时传进来的却是 en。 另一类差异更隐蔽——编码字符串里的下划线和连字符对不齐。对人来说,en-US 和 en 表达的意思很接近;但对按固定词表学习的模型来说,它们可能是完全不同的类别,甚至直接落进"未知值"。
服务没报错,请求正常返回,效果却在悄悄变差。
最贵的误会:以为线上和训练吃的是同一份数据
Uber Eats 的 推荐模型 使用用户会话、餐厅信息和历史点击、订单等特征。线上推理有自己的取数路径;离线训练则从应用日志、特征表、点击日志等来源重新拼训练集。两边独立计算,字段名称相同,也不保证取值一致。
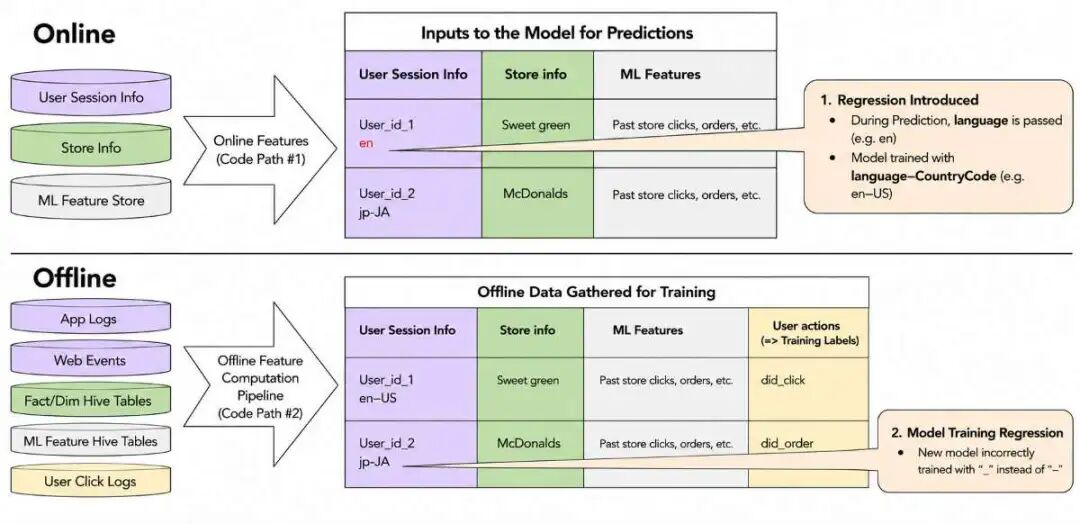
线上预测与离线训练走不同的数据路径。
除了字符串格式,还有缺失分区、上游 ETL 变化和数据新鲜度的问题。Uber 指出,一些关键特征从生产变化到训练可见,要经历数天延迟。这类故障就麻烦在:模型、接口、数据任务单独看都能运行,但拼在一起,训练时的世界和上线时的世界已经不同了。
Uber 换了一个问题:为什么还要重新猜模型看到了什么?
他们的做法是,在推理时记录模型实际消费的特征值,再把这些记录作为下一轮训练的标准数据来源。不是事后按用户 ID 重新查一遍数据库,而是保留那次预测现场真正用过的值。
举个自拟的例子:午饭前,模型给某个用户推荐一家餐厅。那一刻用户近 7 天订单数是 3,餐厅状态是营业。第二天回填训练数据时,不能因为用户后来又下了一单,就把那次预测的订单数改成 4。后来的数据更完整,不代表它更适合还原当时的决策。
这也是 Feast 文档里 point-in-time join 要解决的问题:按样本时间找特征,避免把未来信息塞回过去。还要留意迟到与回填数据的"可用时间"——只比较事件时间并不能还原线上当时能读到什么。
听起来只要打日志,为什么大厂还要专门写一篇?
因为量上来以后,日志本身就会成为一个系统。Uber 在原文中给出的规模是每秒约 800 万次预测,并估算全量 特征日志 可达到每天约 1.7 PB。这是其推荐场景的规模与估算,不是普通团队应套用的容量指标。他们主要做了三件事。
第一,只记录模型真正需要的特征。 请求带来的字段可能比模型实际使用的多。引入特征白名单后,原文报告载荷缩小了 4 到 5 倍。
第二,别在每条日志里重复长字段名。 把冗长名称映射成确定性的整数 ID,用更紧凑的表示传输;名称与 ID 的映射也必须可以正确解码。
第三,把预测记录和真实曝光事件连起来。 模型打过分的候选,不一定最终被用户看见。Uber 使用 Flink 关联推理特征与客户端曝光事件,再写入离线存储。
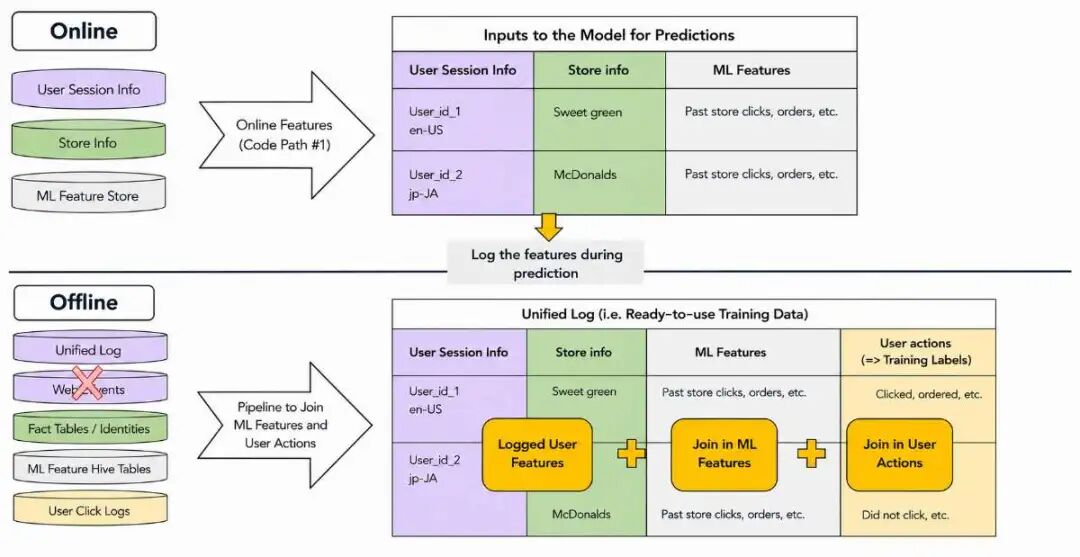
记录线上实际特征,并与用户行为关联。
这里有个容易误学的地方:只保留曝光样本适合它讨论的训练任务,不等于"没曝光的数据永远没价值"。如果你研究召回、探索策略或样本偏差,需要的记录范围可能完全不同。
小团队最值得学的,不是直接上同一套架构
Uber 还做了算子分析、状态裁剪、去重和序列化优化,原文报告峰值消费积压处理改善约 70%。这些措施说明,数据一致性做成生产系统,最终也要付出存储、计算与维护成本。小团队不妨先从一张能对账的记录表开始:
{
"prediction_id": "example-001",
  "model_version": "rank-v12",
  "feature_schema": "v3",
  "served_at": "2026-09-22T11:50:00Z",
  "features": {
    "language": "en-US",
    "orders_7d": 3
}
}
这是教学字段示意,不是 Uber 的生产协议。抽样记录需要的非敏感字段,然后用 prediction_id 关联结果;再拿同一批预测,与离线生成的特征逐字段比较。先查格式,再查缺失值,再查时间窗口。每一次找到的差异,都应该能回答:它影响了多少请求、哪些人群、哪个模型版本。
在 Uber 这次上线中,部分此前不一致率超过 10% 的关键特征,观测到的不一致率降到了 0%。这是指定特征的结果,不是整个机器学习系统从此零误差。下次模型上线掉效果,不妨先问一句:我们真的留过模型当时看到的输入吗?
参考:Uber Engineering《Taming the ML Firehose: Scaling Feature Consistency》,作者 Paarth Chothani、Chirag Agrawal、Amrith M;配图与生产数字来自原文。补充资料为 Feast 的 point-in-time joins 文档。
 发表于 前天 01:45
|
查看: 4|
回复: 0


