这是《从零造一个桌面 Agent Harness》系列的第 2 篇。系列的目标:带你从零造一个桌面 AI 助手(Agent),每篇讲透一个工程机制,对照两个真实产品的公开教学源码,看它们各自怎么做。
- WorkBuddy:桌面 AI 助手产品,有一份公开的 24 章复刻教程,只看产品的外部行为重建实现,不接触内部源码;
- Claude Code:Anthropic 的命令行 AI 编程助手,社区写了一份 17 章的开源教程,把它的机制一个个重新实现出来。
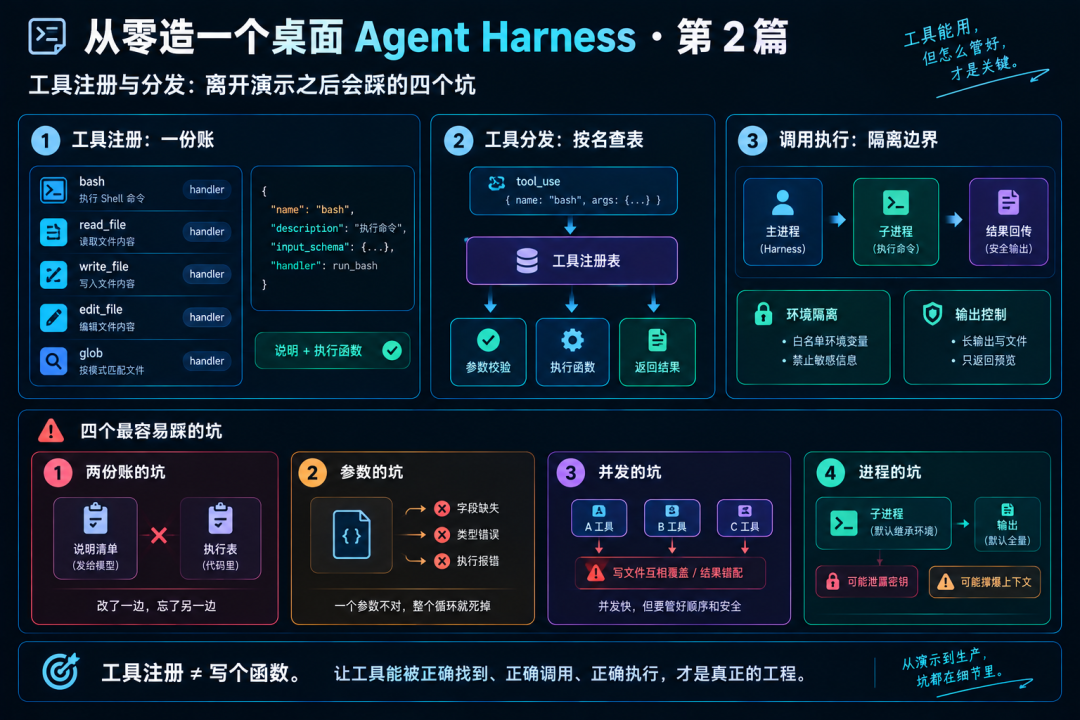
这篇不教「怎么给模型定义工具」。你早就会了:把工具的名字、说明、参数格式发给模型,模型回一个 tool_use(工具调用请求)块,里面带着工具名和参数。你按名字找到函数、把参数塞进去执行、把结果喂回去。
这篇讲的是「按名字找到函数、把参数塞进去执行、把结果喂回去」这一步离开演示之后会发生什么。证据来自两个开源教学仓库的源码:learn-claude-code 的 s02 章、learn-workbuddy 的 s02 章和它的可运行内核 mini_workbuddy。对照下来,总结出四个最容易踩的坑:
- 两份账的坑:加工具要改两个地方——发给模型的说明清单,和代码里按名字找执行函数的表。改了清单忘了表,模型照着说明发起调用,代码查表查不到,任务卡死在那一次调用上;改了表忘了清单,模型按旧说明传参,函数一接就炸。
- 参数的坑:模型的参数是它自己生成的文本,漏字段、传错类型都很常见。直接塞进函数就跑,一个 TypeError 就能让整个循环死掉。用户看到的是程序崩溃,实际上模型只是拼错了一个参数名,告诉它一声就能自己改。
- 并发的坑:模型一轮要调三个工具,你并发执行省时间,可两个都在写文件,就会互相覆盖刚写下的内容。就算全是读,结果按完成顺序回来,第一条结果配到第二个调用上,模型拿着错配的答案继续推理。
- 执行边界的坑:模型要跑的命令是另开子进程执行的,这个子进程默认把你程序的环境变量全套拿走,一句
echo $ANTHROPIC_API_KEY 就让密钥进了对话记录。命令的输出也默认全量回进上下文,一条 grep 的八万行当场把它撑爆。
一、基线:最简单的查表分发
这是 learn-claude-code 教学仓库第二章的核心代码。上一章循环里只有一个写死的 bash 工具,这一章加工具变成「查表」:
TOOLS = [
    {"name": "bash", "description": "Run a shell command.",
     "input_schema": {"type": "object", "properties": {...},
                      "required": ["command"]}},
    # …共五个工具的说明(bash、read_file、write_file、edit_file、glob),
    #   每次请求全量发给模型
]
TOOL_HANDLERS = {
    "bash": run_bash, "read_file": run_read, "write_file": run_write,
    "edit_file": run_edit, "glob": run_glob,
}
# 循环里相对上一章只改了工具执行这几行:
for block in tool_calls:
    handler = TOOL_HANDLERS.get(block.name)
    output = handler(**block.input) if handler else f"Unknown: {block.name}"
    results.append({"type": "tool_result",
                    "tool_use_id": block.id, "content": output})
README 原话是「加一个工具,只加一个 handler」:循环不用动,新工具注册进分发表就行。这里有一个正确的决定——按名字查表找到执行函数,不写一串 if-else 分支,循环代码不认识任何具体工具。
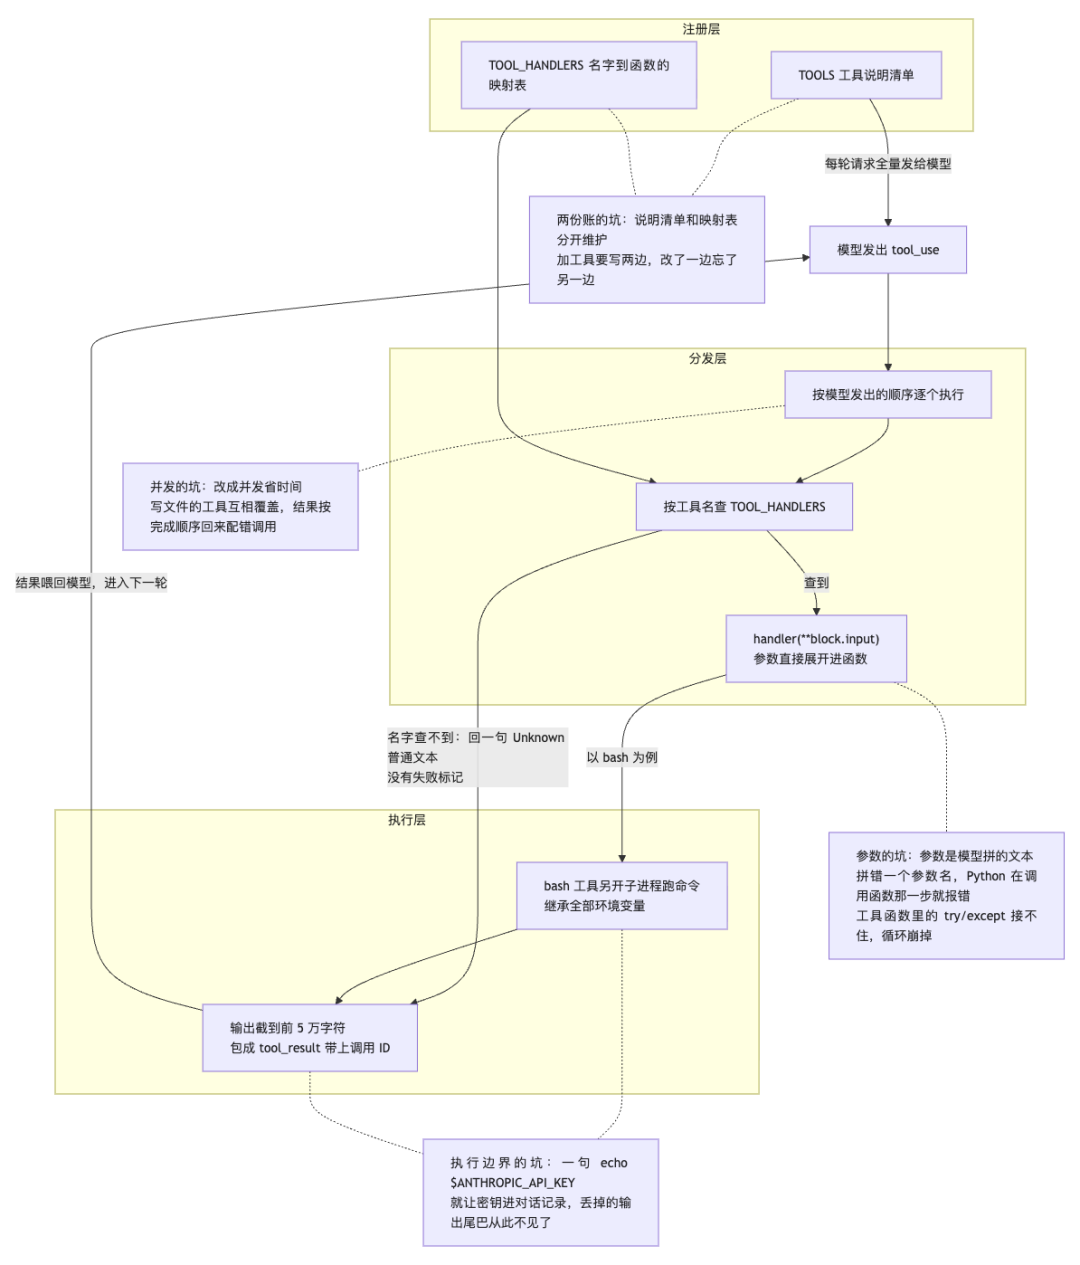
把这张查表放回整个 harness 里看:模型发出的 tool_use 要经过它,才变成机器上真正执行的命令。四个坑都发生在这条路上,按位置分三层,每层一个问题:
- 注册层:能调什么的账,是不是只有一份?
- 分发层:调用怎么过边界?校验参数、安排执行顺序、把失败变成数据都算。
- 执行层:过了边界,两头的默认是什么?子进程能拿走什么,结果能带回什么。
一次调用从模型发出到结果喂回模型,经过的就是这三层:
但仔细看这个版本,演示里没事,生产里每一条都是坑:
- 工具说明(
TOOLS)和映射表(TOOL_HANDLERS)是两份账;
- 模型参数用
**block.input 直接展开进函数;
- 失败返回的是一句普通文本;
- bash 子进程继承全部环境变量,输出超过五万字符直接丢尾。
下面一个一个看。
二、两份账的坑:改了一边,忘了另一边
TOOLS 和 TOOL_HANDLERS 分开维护:加工具要写两边,改参数格式也要改两边。五个工具靠人小心还能撑住;工具一多就撑不住了。更麻烦的是,工具清单可能要到程序跑起来才定得下来——有哪些工具都不知道,两边的账根本没法手工对齐。
learn-claude-code 的 s14 里,工具不再写在代码里,而是放在外部服务器上,程序要先连上服务器,才知道有哪些工具。拿回一个工具,同一段代码紧接着做两件事:把这个工具的说明加进发给模型的清单,把它的执行函数加进映射表。
tools.append({
    "name": prefixed,
    "description": tool_def.get("description", ""),
    "input_schema": schema,
})
handlers[prefixed] = (
    lambda *, client=server, tool=raw_name, **kwargs:
    client.call_tool(tool, kwargs)
)
learn-workbuddy 的 s02 从头就把两份账合成一份。一个工具就是一条 ToolSpec 记录,说明和函数放在一起:
@dataclass(frozen=True)
class ToolSpec:
    """One tool's model contract, local implementation, and execution policy."""
    name: str
    description: str
    input_schema: Mapping[str, Any]
    handler: ToolHandler
    concurrent_safe: bool = False
README 原话是「项目中不再存在一份独立的 TOOLS 列表和另一份 TOOL_HANDLERS 字典」。
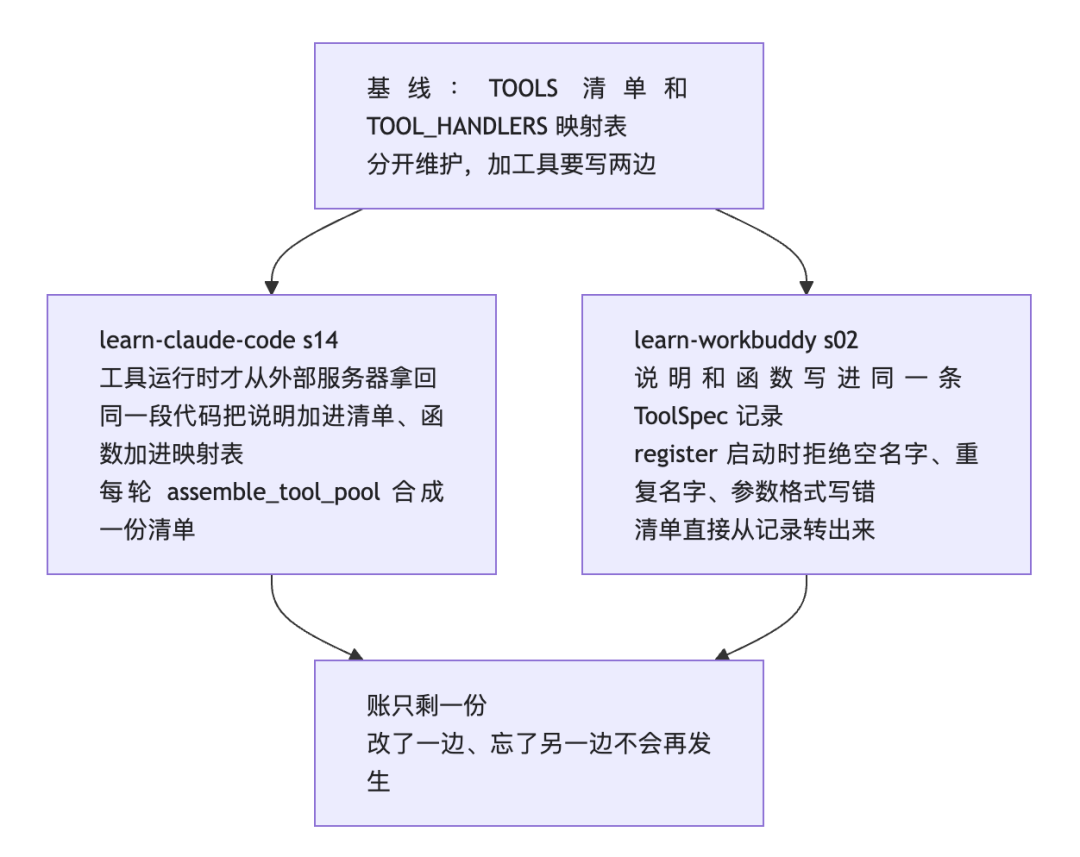
同时往注册表里加工具要经过 register()。空名字、重复名字、参数格式定义写错,它当场拒绝:报错发生在程序启动时,不用等模型哪天调到这个工具才发现。
三、参数的坑:一个参数不对,整个循环就死掉
模型参数是它自己拼出来的文本,只要有一处不对,Python 在调用函数那一步就报错,函数体还没开始运行。所以工具函数内部写的 try/except 接不住它:异常穿透,循环崩掉。
learn-claude-code 的基线就是这个写法:每个工具函数内部自己接错,但调用那一步出的错没人管。模型调一个不存在的工具,得到的也只是一句普通文本,没有错误标记,只能靠字面猜这次调用是不是失败了。这个洞到 s14 才堵上:try/except 包在工具执行的外面,异常转成文本还给模型。
learn-workbuddy 的 s02 把「按名字找到函数、执行」固定成三步:先查工具存不存在,再查参数合不合规矩,两步都过了才执行函数。哪一步没过,就把失败当成一条结果还给模型,不抛出异常把循环搞崩。模型传来的参数在检查通过之前都不被信任,这条要求写在 ToolCall.arguments 字段的注释里:
spec = self.get(call.name)
if spec is None:
    return self._error(call, ToolErrorCode.UNKNOWN_TOOL,
                       f"tool is not registered: {call.name or '<empty>'}")
validation_error = _validate_arguments(spec.input_schema, call.arguments)
if validation_error:
    return self._error(call, ToolErrorCode.INVALID_ARGUMENTS, validation_error)
# 校验通过后,参数才转成字典 arguments
try:
    output = spec.handler(**arguments)
except Exception as exc:  # The dispatch boundary must not crash the agent loop.
    return self._error(call, ToolErrorCode.EXECUTION_ERROR, str(exc))
三步各对应一种失败,各有一个固定的错误码:
- 查不到工具名,报
unknown_tool;
- 参数不合规矩,报
invalid_arguments——教学版只查两件事:必填的参数齐不齐、类型对不对;
- 函数执行中抛了错,报
execution_error,最外层的 try/except 接住它,执行的错再也不会把循环搞崩。
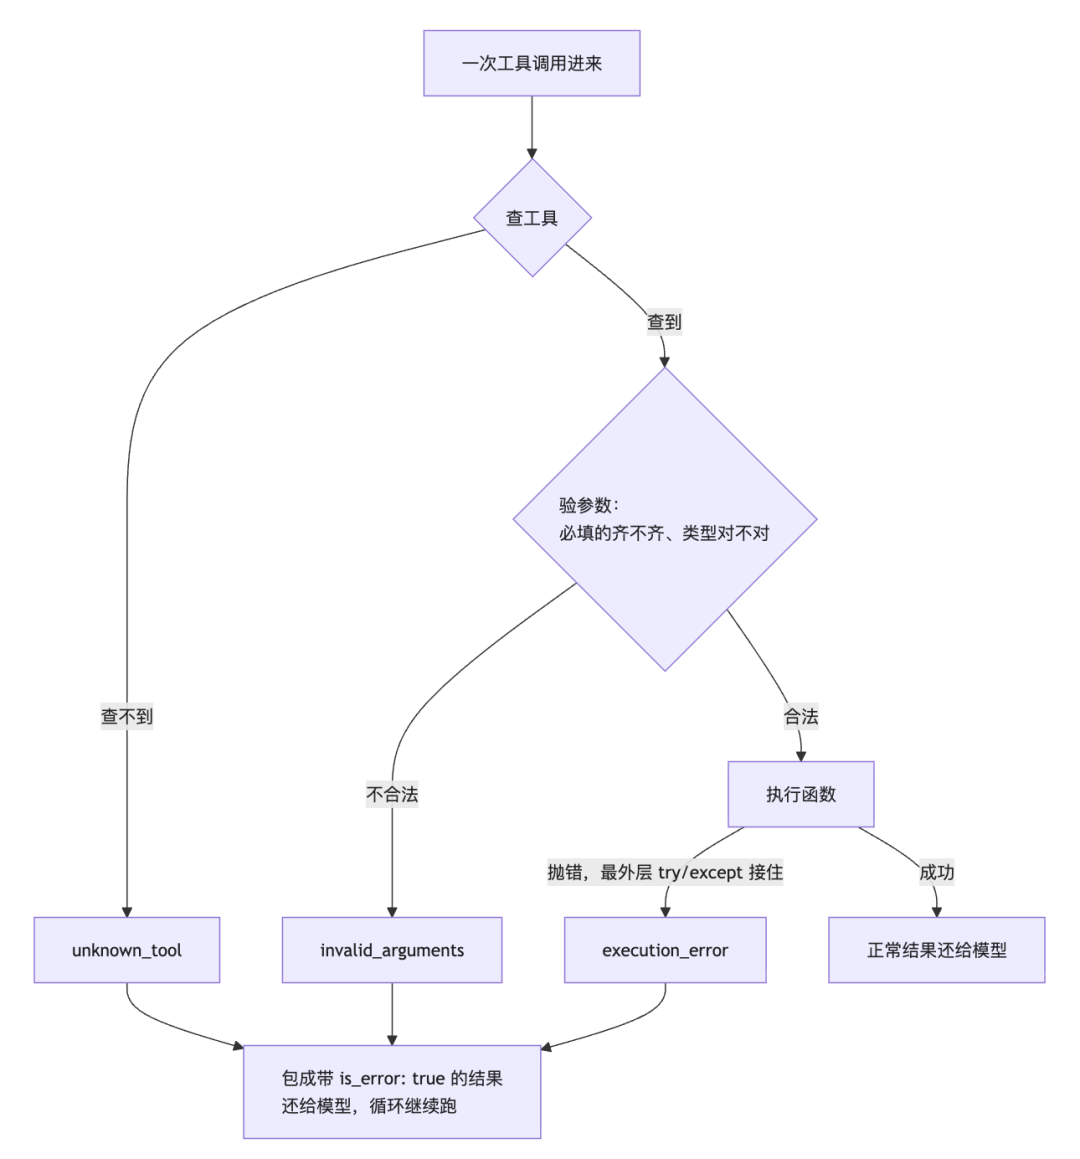
失败和成功一样,都是一条还给模型的结果,失败的那条多带一个 is_error: true 标记。标记很关键:没有它,模型拿到的只是一段文本,分不清这次调用是成是败,learn-claude-code 的基线缺的就是这个。README 把这节标题就叫「错误也是正常协议结果」:失败是一条普通的结果,不是事故。
四、并发的坑:写工具一起跑会互相踩
一批工具调用,执行有两种办法:按顺序一个一个跑,或者几个同时跑。一个一个跑最慢,但不会出事;几个同时跑快,代价是写操作可能互相踩,结果可能配错调用。
learn-claude-code 的基线选第一种:一批调用按模型给出的顺序逐个执行,根本没有同时跑这回事。按顺序执行,结果就按顺序回来,每条自然对上自己的调用。
learn-workbuddy 的 s02 要并发,办法是把「这个工具能不能和别人同时跑」记在注册信息里:每条 ToolSpec 有一个 concurrent_safe 字段,read_file 和 glob 这类只读工具标 True,bash、写文件、编辑文件默认都是 False。dispatch_many 拿到一批调用,先看整批工具的这个字段,再决定这批怎么跑:
specs = [self.get(call.name) for call in calls]
can_run_concurrently = len(calls) > 1 and all(
    spec is not None and spec.concurrent_safe for spec in specs
)
if not can_run_concurrently:
    # Unknown, invalid, bash, and mutating calls take the conservative path.
    return [self.dispatch(call) for call in calls]
with ThreadPoolExecutor(max_workers=min(4, len(calls))) as pool:
    # executor.map preserves input order even if handlers finish out of order.
    return list(pool.map(self.dispatch, calls))
整批调用进来之后怎么跑,判定就一步:
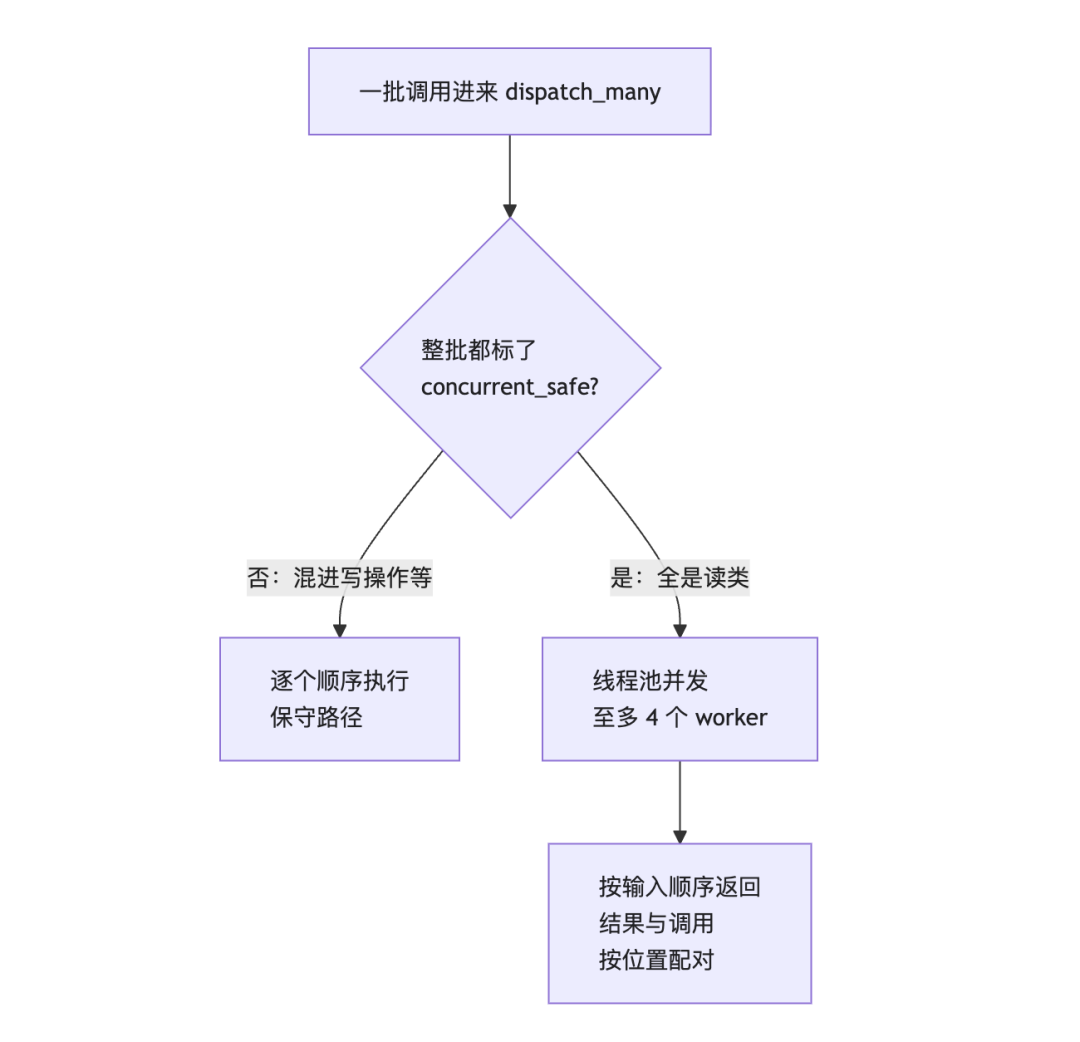
代码里的两条英文注释就是全部策略。第一条管保守路径:未知工具、参数不合法、bash、写操作,只要批里有一个,整批都一个一个顺序跑,没有「拆开批、安全的那部分并发」这种中间选项。
第二条针对并发时结果乱序的危险。几个工具同时跑,第二个调用可能先完成,它的结果排在返回列表的最前面;按位置把结果和调用配对,就会配错,结果绑到错误的 tool_use_id 上。用的办法是 pool.map:不管哪个先跑完,返回的结果列表永远按调用的原始顺序排,第一条对第一个调用。
五、进程的坑:循环放界面进程里会卡死界面
调模型用的 API 密钥 放在 harness 进程的环境变量里,bash 工具却在另开的子进程里跑每条命令,中间的进程边界就是执行边界。子进程默认拿走全套环境变量,命令跑完默认带回全量输出,两个默认都没人管。
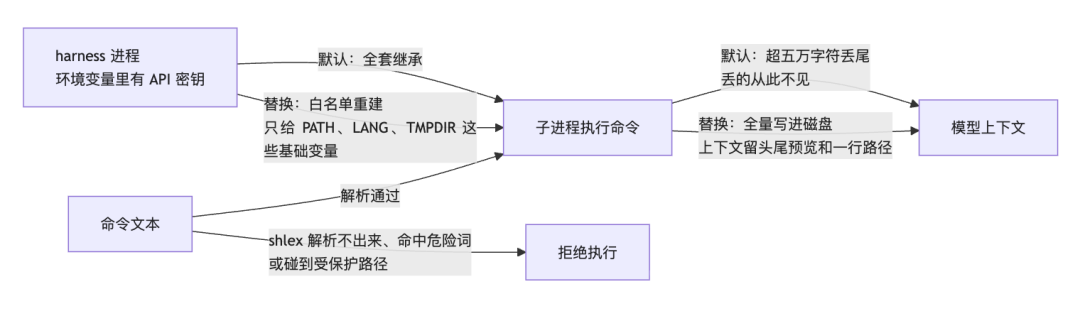
先看漏密钥这一头。learn-claude-code 的基线 run_bash 开子进程时不限制环境变量,后续章节也没补这一处。基线只有一张黑名单,拦 rm -rf /、sudo 这类危险命令;读环境变量是完全合法的命令,没有哪个黑名单会拦它。
learn-workbuddy 的 s02 不让子进程继承,照一张白名单重建环境变量,只放 PATH、LANG、TMPDIR 这些 shell 正常工作需要的基础变量;API 密钥不在名单里,子进程根本拿不到。
再看命令带回来的输出。基线只有一招:超过五万字符,丢掉尾巴——上下文不会爆,丢掉的部分却从此不见了。learn-workbuddy 的可运行内核不丢:结果超过阈值就全量写进磁盘上的一个文件,上下文里只留一段头 6000、尾 24000 字符的预览和一行文件路径,模型想看全量自己照路径去读。
if len(content.encode("utf-8")) <= self.config.tool_result_threshold:
    return ToolResult(content=content, ...)  # 没超阈值,原样返回
# 超过阈值:全量写进磁盘,上下文只留预览和路径
path = self.storage.tool_result_path(session, tool_call_id)
path.write_text(content, encoding="utf-8")
preview = content[:6_000] + "\n\n...[externalized output]...\n\n" + content[-24_000:]
pointer = f"\n\nFull output written to: {path}"
return ToolResult(content=preview + pointer, ...)
learn-claude-code 的解法出现在 s08:做上下文压缩时,被裁短的工具结果同样全量落盘,每条一个文件放在 .task_outputs/tool-results/ 下,上下文里留一个可取回的路径。
本篇参考
- learn-claude-code
s02_tool_use/(README.zh.md + code.py)——本篇基线代码的出处:工具说明和执行函数的表分开维护,模型参数直接塞进函数,run_bash 靠黑名单拦危险命令,输出超五万字符就丢尾。
- learn-claude-code
s14_mcp_plugin/README.zh.md——连上外部工具服务器后,同一段代码把说明加进清单、把函数加进映射表;外部工具名加 mcp__{server}__{tool} 前缀,重名直接报错;工具执行的错转成文本还给模型。
- learn-claude-code
s08_context_compact/README.zh.md——被裁剪的工具结果落盘,留一个 .task_outputs/tool-results/ 里的文件路径,模型需要时自己读回来。
- learn-workbuddy
s02_tool_dispatch/(README.md + code.py)——说明和执行函数存在同一条 ToolSpec 记录里,注册时就检查;分发分三步:查工具、验参数、执行,三种失败各有固定的错误码;concurrent_safe 字段决定一批调用能不能同时跑;build_subprocess_env 用白名单决定子进程能拿到哪些环境变量。
- learn-workbuddy
mini_workbuddy/tools.py——命令解析不出来就拒绝执行;调用编号先验格式再拼进文件路径;大输出全量写进磁盘,上下文里只留预览和一行路径。
工具注册从来不只是写个函数。让工具能被正确找到、正确调用、正确执行,才是真正的工程——从演示到生产,坑都在细节里。
 发表于 9 小时前
|
查看: 5|
回复: 0


