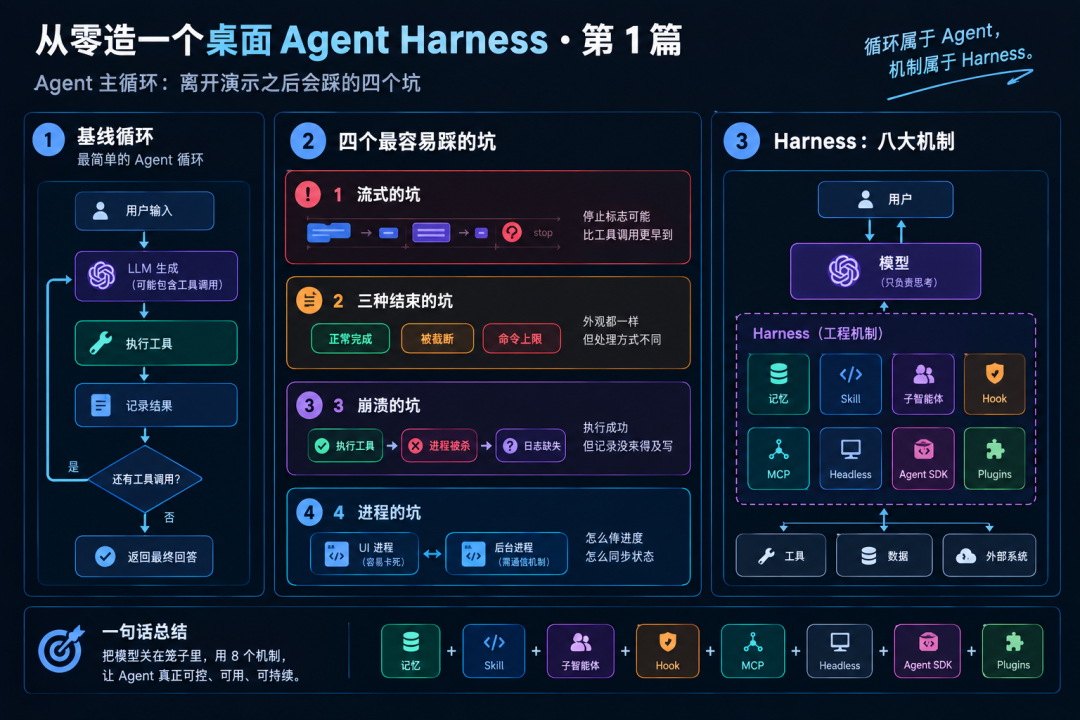
这是《从零造一个桌面 Agent Harness》系列的第 1 篇。系列的目标:带你从零造一个桌面 AI 助手(agent),每篇讲透一个工程机制,对照两个真实产品的公开教学源码,看它们各自怎么做?
- WorkBuddy:桌面 AI 助手产品。有一份公开的 24 章复刻教程,只看产品的外部行为重建实现、不接触内部源码;
- Claude Code:Anthropic 的命令行 AI 编程助手。社区写了一份 17 章的开源教程,把它的机制一个个重新实现出来。
这篇不教「什么是 agent 循环」。你天天用 Claude Code 这类工具,那个 Agent Loop 你早就会写了:把模型的响应放进循环,它要调工具就执行,把结果喂回去,直到它不再要求调工具为止。
这篇讲的是这个循环离开演示之后会发生什么。我们对照两个开源教学仓库(learn-workbuddy 和 learn-claude-code)的源码,总结出四个最容易踩的坑:
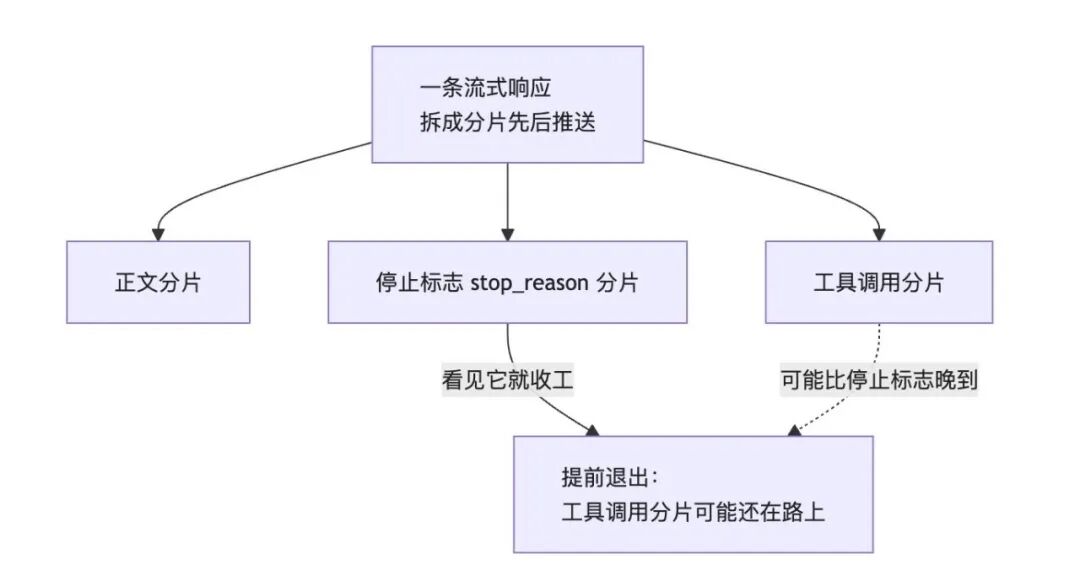
- 流式的坑:模型返回的响应大多是流式的,一条响应会拆成很多个分片先后推过来。正文是几个分片,「我要调工具」是一个分片,表示「我说完了」的停止标志(stop_reason)也是一个分片。哪个分片先到、哪个后到没有保证,停止标志完全可能比工具调用先到。你要是看见停止标志就收工,就会在工具调用分片还没到的时候退出:模型明明还想执行一条命令,被你终止了;
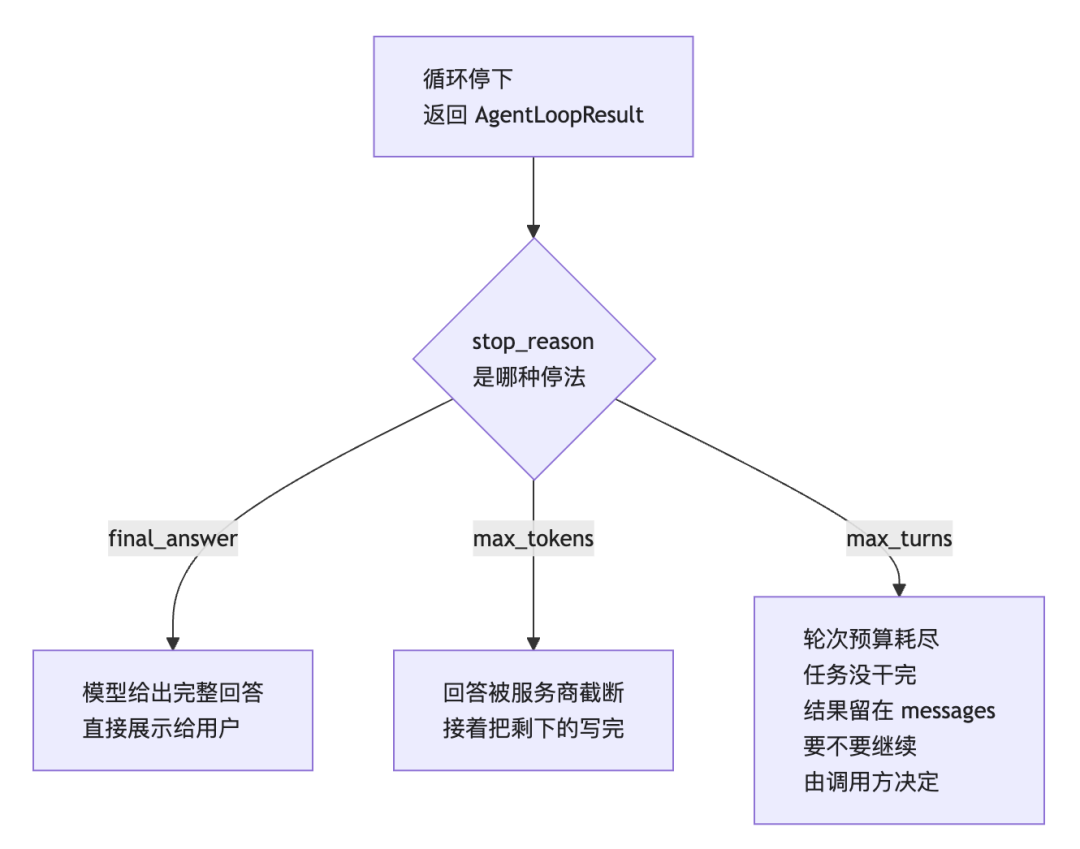
- 三种结束的坑:循环有三种结束方式,后续处理完全不同。模型给出了完整回答,直接展示给用户就行;回答太长被服务商强行截断,得接着把剩下的写完;模型不停调工具,你设的轮数上限到了,任务还没干完,得保留现场再想办法。麻烦在于,这三种结束从外面看长得一模一样,都是一段文本。分不清,半截话就会被当成完整答案交给用户;
- 崩溃的坑:agent 跑在用户的电脑上,进程随时可能被杀(崩溃、强退、断电)。最要命的时机是工具刚执行完、记录还没写:文件真的写进去了,界面上也显示过「文件已写入」,进程却在记录落盘之前被杀。重启之后,日志里没有这一条,界面历史和日志对不上,你说不清到底发生过什么;
- 进程的坑:循环放在哪个进程里跑?放在界面进程里,循环一卡住长任务,整个窗口就动弹不得;窗口一崩,跑到一半的任务跟着死。搬到独立的后台进程里,窗口稳了,新问题跟着来:两个进程怎么通信,任务的进度怎么传回界面显示。
一、基线:先写出那个最简单的循环
这是 learn-claude-code 教学仓库第一章的核心代码:
def agent_loop(messages: list):
    while True:
        response = client.messages.create(
            model=MODEL, system=SYSTEM, messages=messages,
            tools=TOOLS, max_tokens=8000,
        )
        messages.append({"role": "assistant", "content": response.content})
        tool_calls = [b for b in response.content if b.type == "tool_use"]
        if not tool_calls:
            return                                # 没调工具 = 最终回答
        results = []
        for block in tool_calls:
            output = run_bash(block.input["command"])
            results.append({
                "type": "tool_result",
                "tool_use_id": block.id,          # 用编号把结果对回调用
                "content": output,
            })
        messages.append({"role": "user", "content": results})
这个仓库的 README 原话是:后面 16 个章节都在这个循环上叠加机制,循环本身始终不变。根 README 还把整个产品概括成一个公式:
Claude Code = 一个 agent 循环
            + 工具 + 按需技能加载 + 上下文压缩
            + 子 agent 派生 + 带依赖图的任务系统
            + 团队协调 + 任务绑定的 worktree 并行执行
            + 权限治理 + hooks 扩展系统
            + 记忆持久化 + MCP 外部能力路由
然后补了一句:「循环属于 agent,机制属于 harness。」harness 是模型外面包着的那层工程设施,工具执行、权限审批、崩溃恢复这些机制都归它管。循环保持基线这个样子不动,工程精力全部花在循环周围的机制上——这句话也是整个系列的总纲。
基线代码里有一个容易忽略但很正确的决定:判断循环要不要继续,看的是响应里结构化的 tool_use 内容块,而不是对返回的文本做正则匹配。内容块是模型接口协议里正式定义的数据结构,比猜文本可靠得多。
这段代码在测试里能跑通,放到生产环境就会踩坑。下面一个一个看。
二、流式的坑:只看停止标志会提前收工
流式响应里,stop_reason 和内容块分开到达,顺序没有保证。拿 stop_reason 决定要不要收工,模型明明还想调工具,就被你终止了。
一条流式响应的分片,和出错的位置:
两个教程用的其实都是同步调用,没真正撞上这个时序:learn-claude-code 的 client.messages.create 没开流式参数;learn-workbuddy 的 README 简化对照表注明「流式响应 → 同步响应」。但两家留下的写法,都对流式安全。
learn-claude-code 的基线简单直接:循环要不要继续,判断条件是「响应里有没有 tool_use 块」,从头到尾不看 stop_reason。工具调用块没到,循环就不会停。
learn-workbuddy 把同一个顺序固定成了一个独立函数。README 先给了警告:
流式 provider 往往会让内容块和最终停止元数据在不同事件中到达。因此 harness 不应只用 stop_reason 决定是否执行工具。
代码是这样的:
def stop_reason_for(turn: AgentTurn) -> LoopStopReason | None:
    """Return None to continue, otherwise the explicit harness stop reason."""
    # Inspect content instead of trusting stop_reason alone. This also works
    # when a provider reports its stop metadata later than its content blocks.
    if turn.tool_calls:
        return None                      # 有工具调用:继续,不管服务商说什么
    if turn.provider_stop_reason == "max_tokens":
        return LoopStopReason.MAX_TOKENS
    return LoopStopReason.FINAL_ANSWER
检查内容,不要单独信任 stop_reason;这样即使停止元数据比内容块晚报到,判断也是对的。做成独立函数还有一个直接的好处:「元数据先到、内容块后到」这种时序可以专门写测试用例覆盖。
这个函数能成立,有个前提:原始响应只解析一次。learn-workbuddy 先把响应转成 AgentTurn 这个内部结构,文本、工具调用、停止元数据都在这一步解析出来。后面的判断和执行,读的是同一份数据。
from_response 的文档字符串说的就是这件事:"Read text and tool calls once so loop decisions use one source of truth"——只解析一次,让循环的判断用同一个数据源。解析两遍的话,判断看到一份、执行看到另一份,两份可能不一致。
规则一句话:内容块决定「要不要继续」,stop_reason 只负责解释「为什么停」。代价是多一层转换、多一个类型定义;换来的是以后接真正的流式接口,循环一行都不用改。
三、三种结束的坑:分不清循环是哪种停法
基线的 agent_loop 没有返回值,调用方想知道结果,只能去 messages 里捞最后一段文本。完整回答、被截断、预算耗尽,三种结局捞出来长得一样。两个教程的解法侧重不同:learn-workbuddy 给结束加上类型,learn-claude-code 减少含糊的结束。
learn-workbuddy 的 s01 让循环返回一个结构化的结果:
class LoopStopReason(str, Enum):
    """Why the harness stopped asking the model for another turn."""
    FINAL_ANSWER = "final_answer"   # 模型给出完整回答
    MAX_TOKENS   = "max_tokens"     # 回答被服务商截断
    MAX_TURNS    = "max_turns"      # harness 轮次预算耗尽

@dataclass(frozen=True)
class AgentLoopResult:
    stop_reason: LoopStopReason
    turns: int                      # 实际跑了几轮
    tool_calls: int                 # 共调了几次工具
    final_text: str                 # 遗留文本
    provider_stop_reason: str | None
返回值把调用方最关心的三件事各自变成了一个字段:为什么停、跑了几轮、调了几次工具。基线版本没有返回值,调用方只能去 messages 里捞最后一段文本猜;现在直接读字段。结果对象声明成 frozen=True,创建之后不能再改,拿到它的任何一层都只读不改。
三种停法里的 max_turns 来自循环的预算:while True 改成 for turn_number in range(1, max_turns + 1),默认 8 轮。第八轮跑完模型还想调工具时,for 循环没有第九轮可迭代,自己退出,循环以 stop_reason 为 MAX_TURNS 返回。
源码注释原话是 "the harness refuses to start an unbounded ninth turn without an explicit caller choice"——没有调用方的明确选择,harness 拒绝开启无上限的第九轮。
预算耗尽时任务没干完,但现场是完整的:最后一轮的工具结果已经按常规写进 messages,调用方可以检查之后决定是再起一轮循环续上,还是就此停下。
循环的三种停法,各自对应一条后续路径:
- 对「被截断」:s08 上下文压缩 不等上下文塞满、被服务商硬切,章节格言是「上下文总会满,要有办法腾地方」。压缩分四步:核定预算、裁剪、微压缩、历史摘要,低成本的操作先做;
- 对「模型说做完了」:s17 目标核对在停下之前加了一道闸门——「模型不再调用工具,只代表这一轮想停;目标是否完成,再交给一个独立判断器」。判断器的结论只有三种:完成了(停)、没完成(自动续轮)、无法完成(把控制权交还用户)。判断器自己调用失败时,停止自动续轮但保留目标,绝不在无法判断的时候宣称成功。
规则一句话:停循环的权力在三方手里——模型(不再调工具)、服务商(截断)、harness(预算用完),每种停都要有自己的字段,不许混在一起。 代价是调用方要处理三个分支,轮次预算要按任务调(长任务 8 轮不够用);但这个代价摆在明面上、可以配置,比半截话冒充完整答案好得多。
四、崩溃的坑:命令跑了,记录没写
进程可能在任何一行被杀,时机不巧就是三种事故:
- 鬼事件:界面显示过「文件已写入」,日志里却没有这一条,重启后谁也说不清界面显示过什么;
- 账外调用:工具执行到一半崩了,或者被权限拦了、超时了,日志里毫无痕迹,重启后不知道 harness 曾想干什么;
- 副作用重放:命令跑成功了,写日志这一步报错,框架自动重试整个工具,于是
rm 执行了两次。
learn-workbuddy 的可运行内核 mini_workbuddy/agent.py 对三种事故各有一条规则,全部写在源码注释里。先交代事件的固定形状:message → tool_call → tool_result / tool_error,每一步都先调 storage.append_event(...) 把事件写进磁盘,再做别的。
一次工具调用的完整时序,三条规则各守住一个位置:
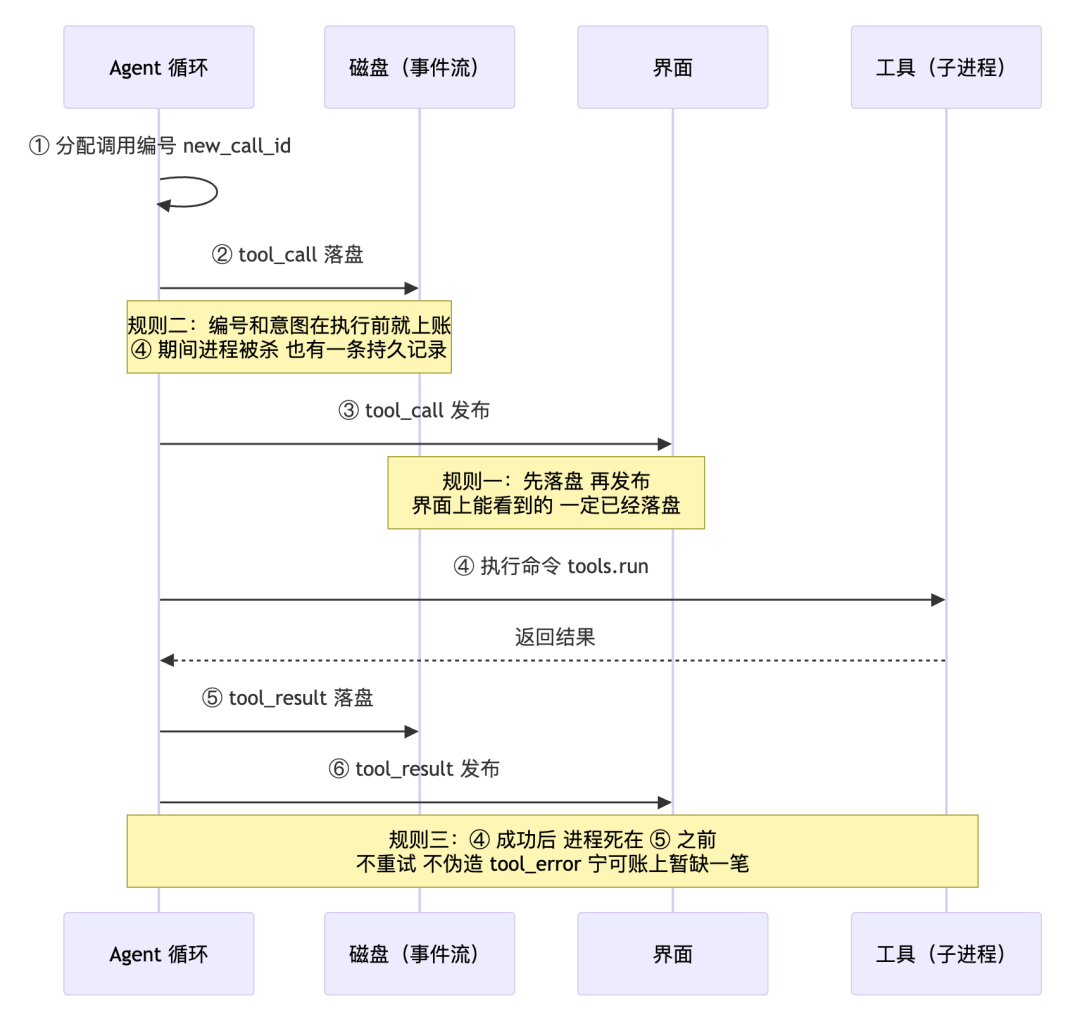
规则一:先落盘,再发布。 _publish 的文档字符串只有一句:"Publish only after the corresponding transcript event is durable"——对应的事件已经持久化到磁盘之后,才允许发布(推给界面)。反过来说:界面上能看到的事件,一定已经落盘了。
规则二:调用编号在执行之前分配。
# Allocate the correlation ID before execution so a crash, denial, or
# timeout still leaves a durable record of what the harness attempted.
tool_call_id = self.tools.new_call_id(tool_name)
在执行之前就分配好关联编号,崩溃、被拒、超时这三种「没跑完」的情况就都能留下一条持久记录,说明 harness 当时想干什么。失败路径写出的 tool_error 事件带同一个编号,一次调用和它的结局永远能按编号配上对。
规则三:副作用已经发生,就不要试图撤销。 工具成功分支的注释:
# Only exceptions from tools.run belong to the tool-error branch.
# A later persistence, publication, or audit failure does not undo
# execution. Let it propagate without inventing a tool_error or
# retrying a tool whose side effects may already have happened.
只有 tools.run 自己抛的异常才算工具错误。之后的落盘、发布、审计失败,不撤销已经执行的命令——异常直接往上抛,不伪造 tool_error,也不重试副作用可能已经发生的工具。
为什么这么狠?重试意味着命令可能跑第二次。伪造 tool_error 等于告诉模型「这步没成」,而实际上它成了,模型会基于假状态做出错误决定。两种「补救」都比「账上暂时缺一笔、重启后人工对账」更糟糕。
三条规则归结成一句话:记录比展示重要。当记录追不上现实,宁可诚实地缺一笔,也不要造假。
这里还有一个「两本账」的设计:事件流(transcript)记对话里发生了什么,审计日志(audit)记每一步的合规信息。_audit 每次写审计记录,都带上对应事件流条目的 transcriptEventId,两本账靠这个编号互相索引。崩溃之后,拿任何一本都能核对另一本。审计账本自身怎么防篡改,是后面文章的主题。
learn-claude-code 的教程把持久化放在任务层:s10 任务系统给每个任务写一个 .tasks/{id}.json 文件。README 原话是「跨会话时,.tasks/ 目录还在,Agent 读文件就能恢复进度」。
真实产品层面,会话本身也落盘:每轮对话写成 JSONL(每行一条 JSON 记录)文件,按项目归档在 ~/.claude/projects 目录下。人可以直接读,崩溃后靠它续上。这和 WorkBuddy 的事件流是同一个思路,区别在账本放的位置:一个在用户自己的目录里,一个在产品内部的存储里。
五、进程的坑:循环放界面进程里会卡死界面
两个教程代表了这个坑的两种做法。
learn-workbuddy s01 的 README 给出了生产系统的进程栈:
Electron 主进程
  └─ 伴随服务(sidecar)
       └─ Unix 套接字上的 JSON-RPC
             └─ CLI 会话进程
                  └─ ACP HTTP 服务
                       └─ Agent 循环
界面(Electron 主进程)通过伴随服务(sidecar,跟主程序配套跑的独立进程)管理会话的创建、销毁和状态查询,但不直接运行 agent 循环。界面卡死或者崩溃的时候,agent 还活着。
配套还有一个机制:伴随服务用一个固定大小的环形缓冲(RingBuffer,写满之后新内容覆盖最旧内容的缓冲区)暂存 agent 的流式输出。输出特别多的时候(比如读一个大文件),超出缓冲的部分直接丢掉,但 agent 照常运行。展示内容可以丢,循环不能丢。
learn-claude-code 是另一种做法:循环就跑在命令行进程里。这不是设计失误,是产品形态决定的——它的界面就是终端,终端和循环之间没有第二个进程,没什么可拆的。
两边的代价各自清楚。WorkBuddy 这种形态要付跨进程通信的全部复杂度:序列化、套接字、进程生命周期管理,本系列后面讲进程隔离和后台任务的文章会逐层拆。Claude Code 这种形态接受长任务和界面共存亡。
选择标准就一条:你的任务是分钟级的交互,还是小时级的委托? 前者循环留在交互进程里没问题,后者必须隔离。
本篇参考
- learn-workbuddy
s01_agent_loop/code.py——LoopStopReason、AgentTurn.from_response、stop_reason_for、有界循环的实现
- learn-workbuddy
s01_agent_loop/README.md——流式 stop_reason 时序说明、「流式响应 → 同步响应」简化对照、生产进程栈与环形缓冲的对照描述
- learn-workbuddy
mini_workbuddy/agent.py——三条记录规则、两本账对账
- learn-claude-code
s01_agent_loop/(README.zh.md + code.py)——基线循环、「后面 16 章都在这个循环上叠加机制」
- learn-claude-code
README-zh.md——架构公式(「一个 agent 循环 + …」)、「循环属于 agent,机制属于 harness」
- learn-claude-code
s08_context_compact/README.zh.md——四步上下文压缩、「上下文总会满,要有办法腾地方」
- learn-claude-code
s10_task_system/README.zh.md——.tasks/{id}.json 任务文件持久化、跨会话恢复
- learn-claude-code
s17_goal_loop/README.zh.md——目标闸门、独立判断器、「不会把目标伪装成完成」
以上就是 Agent 主循环在演示之外四个工程陷阱的完整拆解。如果你也在从零构建自己的 Agent 框架,欢迎到云栈社区与更多开发者交流工程实践心得。
 发表于 13 小时前
|
查看: 4|
回复: 0


