现在的大模型即使能力再强,输出内容时仍是一个 token 接着一个 token 往外蹦。但真正的 AGI 是否一定会沿用这条路?也许未必。
近日,斯坦福大学与 Together AI 的研究者提出了一种既不同于自回归、也不同于扩散的第三种文本生成范式。他们把 NeurIPS 2024 最佳论文 VAR 在图像上的「下一尺度预测」思路搬进文本领域,让模型先并行写出几句话级别的「概念大纲」,再逐层并行填充细节,直到还原成完整文字。
这套方法名为 Next-Concept Modeling(NCM,下一概念建模),正面叫板主流的 Next-Token Modeling(下一 token 建模)。
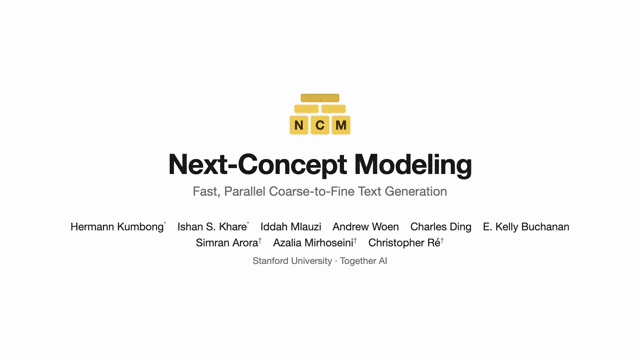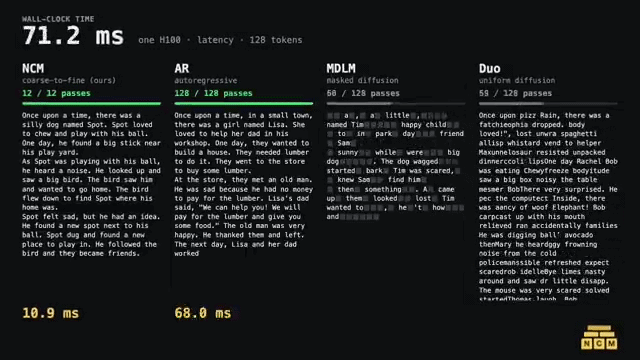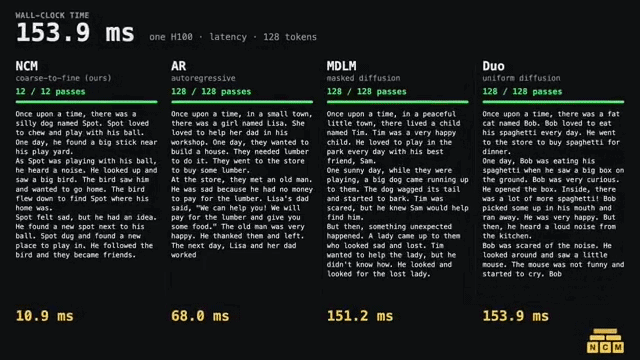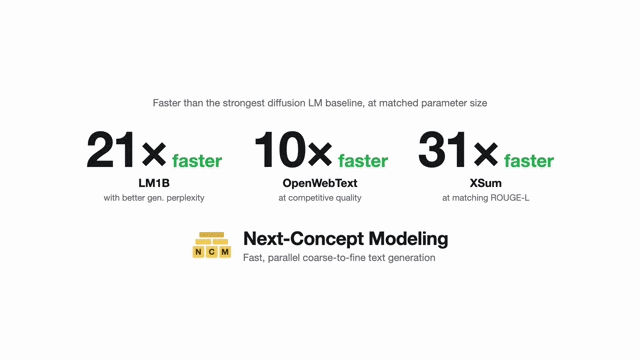
在多项实验中,NCM 在质量相近或更好的前提下,实现了比扩散语言模型快 10—31 倍的生成速度。
先有大纲,再填细节
先看背景。目前主流的大语言模型大多属于自回归模型,包括 GPT、Claude、DeepSeek 等,它们根据已有内容预测下一个 token,后续输出高度依赖前序结果。近两年逐渐升温的扩散语言模型则能够同时处理多个位置,通过反复去噪逐步生成文本。但并行生成并不等于一步到位:迭代次数减少可能牺牲质量,每轮处理整段序列也会带来额外开销。
NCM 的核心变化,是连同「每一步到底生成什么」一起重新设计。它借鉴图像生成中的 next-scale prediction:画面可以先出低分辨率版本,再逐级补充细节。既然如此,文本是否也能拥有自己的「缩略图」?
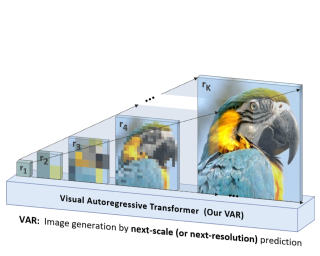
图片来自 NeurIPS 2024 Best Paper《Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction》。
难点在于,文本和图像是两种很不同的对象。图片缩小后通常还能看出主体,一句话删掉几个字却可能完全改变原意。因此,需要让模型自行学会一种既具备概括性、又方便继续细化的表示。NCM 为此设计了两阶段训练流程。
两阶段训练:粗粒度编码与并行预测
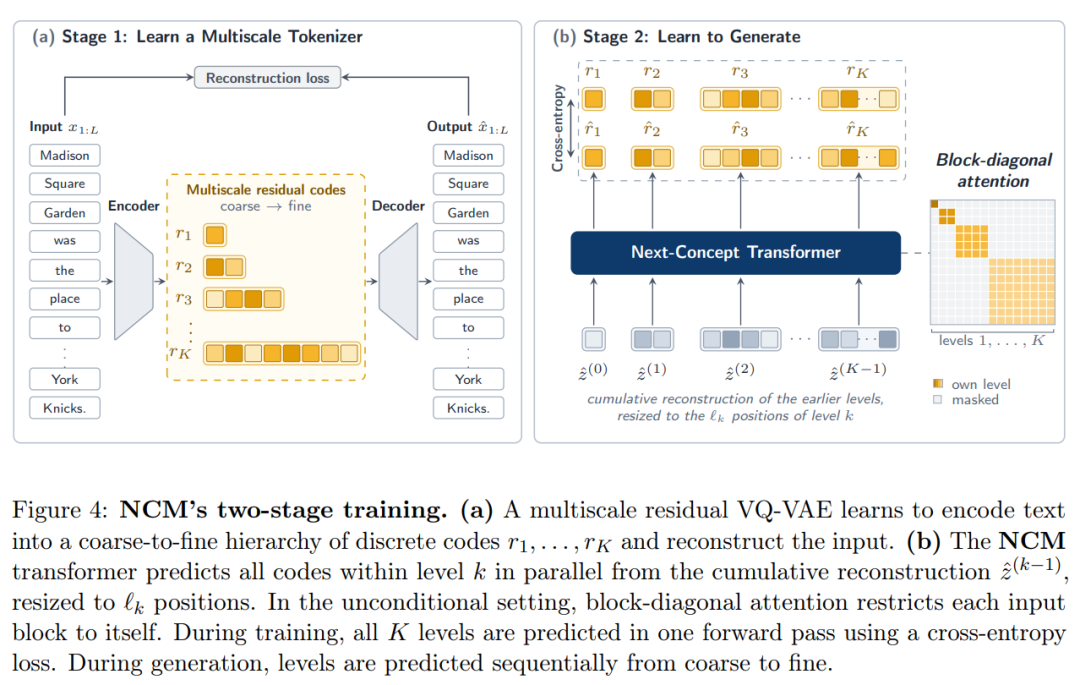
首先是训练一个多尺度残差 VQ-VAE。我们可以把它理解为一套文本编码与还原系统:先把原文转换成多层离散编码,较前面的编码数量较少,后面的编码更多,每一层都在补充此前尚未表达的信息。为了防止粗粒度层「偷懒」,训练时还会随机截掉后面的细粒度层,要求系统仅凭留下来的一部分尽量还原原文。这样一来,模型就被迫让靠前的层也承载有用信息。
第二阶段再冻结这套系统,训练 Transformer 根据此前各层累积的表示预测下一层。生成时模型逐层推进,同一层的编码可以同时预测,最后交给解码器还原成完整文本。
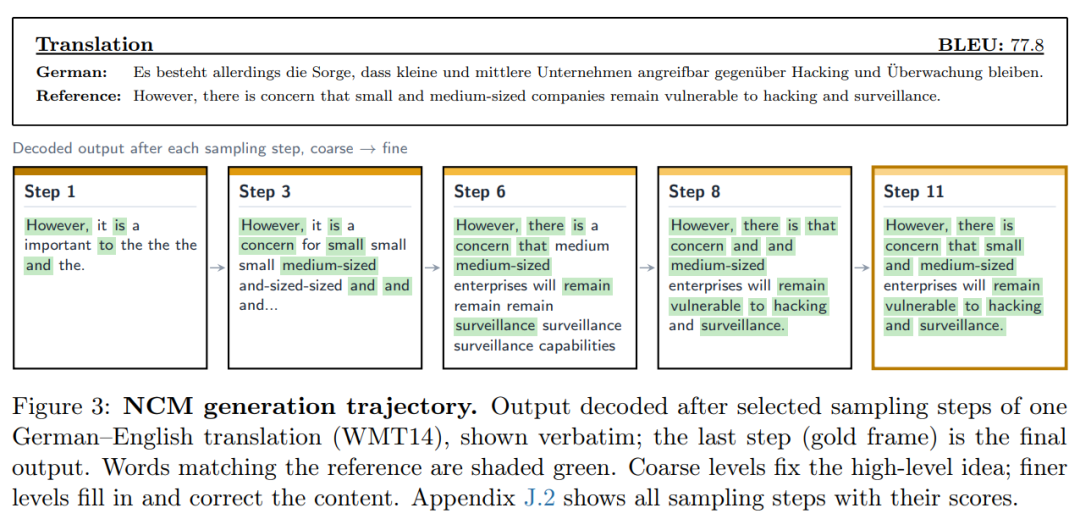
效果怎么样?论文展示了一个德译英翻译示例。NCM 先解码出较粗的中间层,早期输出里还夹杂着重复和不完整表达;随着层级逐步推进,内容越来越清晰,到第十一步形成通顺译文。这个由粗到细的修正过程,是不是也更接近真人翻译时的思路?
NCM 的另一个明显优势是快。一方面,必须串行执行的生成轮数变少了;另一方面,早期只处理较短的编码序列,每轮的平均开销也有下降空间。
作者在单块 H100 SXM 80GB 上做了评估:LM1B 无条件生成比最强扩散基线快约 21 倍,生成困惑度还更好;OpenWebText 上质量具备竞争力,速度约快 10 倍;XSum 摘要任务在 ROUGE-L 相当的前提下,速度约快 31 倍。训练成本同样更友好,两个数据集分别少用了 4.9 倍和 4 倍 token。作为对比,DUO、MDLM 在 OpenWebText 上需要跑到 100 万步,处理超过 5000 亿个 token。
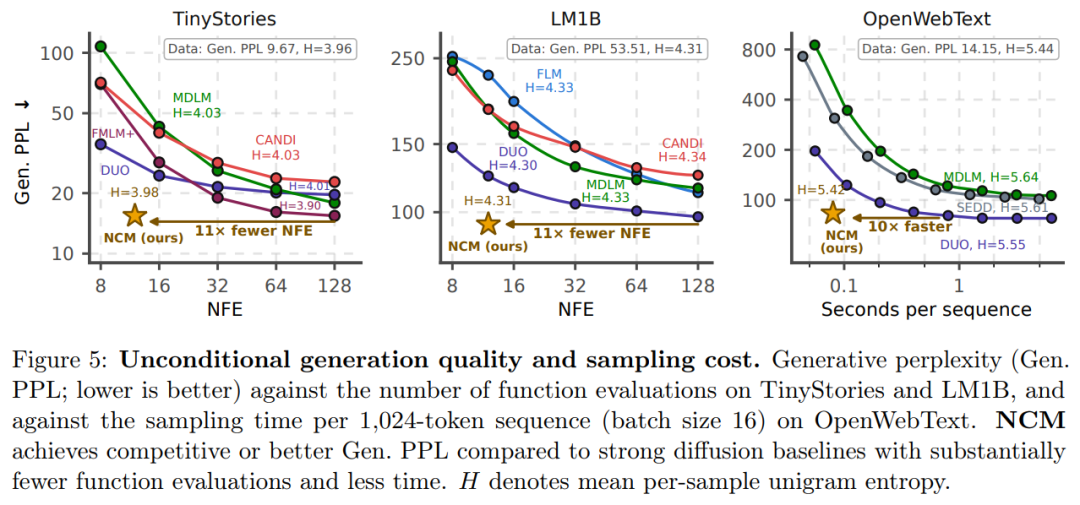
生成质量、推理与候选挑选
在数独这类推理任务中,NCM 也能用更少的采样步骤优于自回归和扩散基线。在只有 30 条线索的困难题上,NCM 完整解出率为 86.1%,高于 FMLM+ 的 81.3%;生成器调用次数分别是 12 次和 16 次。逐层细化整个棋盘,似乎更利于协调全局约束,相当于让 AI 换个角度看待问题。
如果把速度红利换一种用法,也可以在相同时间内多生成几个候选,再做挑选。团队尝试了最小贝叶斯风险解码,利用候选之间的相似性进行选择,进一步改善了翻译和摘要指标。
距离通用大模型还有多远?
当然,距离通用大模型,NCM 还有不少问题要回答。论文主体实验使用的生成器约为 1 亿参数,规模扩展也只到 7.25 亿参数。继续扩大规模后能否保持优势?精确文本和长篇内容的表现如何?这些都需要后续验证。
如果说文字生成也可以被表示成「概念—细节」的层级结构,模型就可以先想清楚再动笔。这确实更接近人类写作的方式,也可能意味着未来文本生成的路线图会被改写。
参考内容:
 发表于 昨天 23:35
|
查看: 5|
回复: 0


