一条每天运行的报表 SQL,慢上几分钟,通常还不至于让人重写数据平台。但当这几分钟乘上成百上千条任务,集群扩容就会变成一笔持续支出。我关注 Auron,正是因为它选择在已有计算框架内部改进执行效率,让团队有机会保留熟悉的作业入口。
10 月 14 日,Apache 软件基金会宣布 Auron 成为顶级项目。这是一次社区治理上的里程碑,并不是当天突然发布了某个性能翻倍的新版本。对准备评估它的数据团队来说,新闻提供了重新审视这个项目的理由;是否能省机器,仍然需要自己的工作负载来回答。
Auron 的工作位置在 SQL 执行链路里。分布式计算框架已经把查询优化成物理执行计划,它再把计划映射到 DataFusion 的执行计划,在原生执行层完成计算。Spark 仍然承担原有框架中的职责,Auron 则尝试把可加速的计算交给 Rust 实现的执行能力。
这条路线吸引我的地方,是优化可以贴着现有系统发生。企业积累的不只是 SQL 文件,还有调度依赖、权限边界、数据目录和排障经验。替换整个数据平台要同时搬动这些东西;在执行层切入,至少给了团队一个可以逐步验证的入口。当然,插件接入并不等于完全没有兼容成本。
它使用 Arrow 列式格式进行批量计算。可以把这理解成把同类数据排在一起处理,减少逐条处理的额外开销,也让底层有机会利用 SIMD 指令。项目还围绕内存管理、Shuffle 数据格式与自适应执行做了优化。这些能力最终有没有收益,要看查询究竟把时间花在计算、读盘、网络传输还是数据倾斜上。
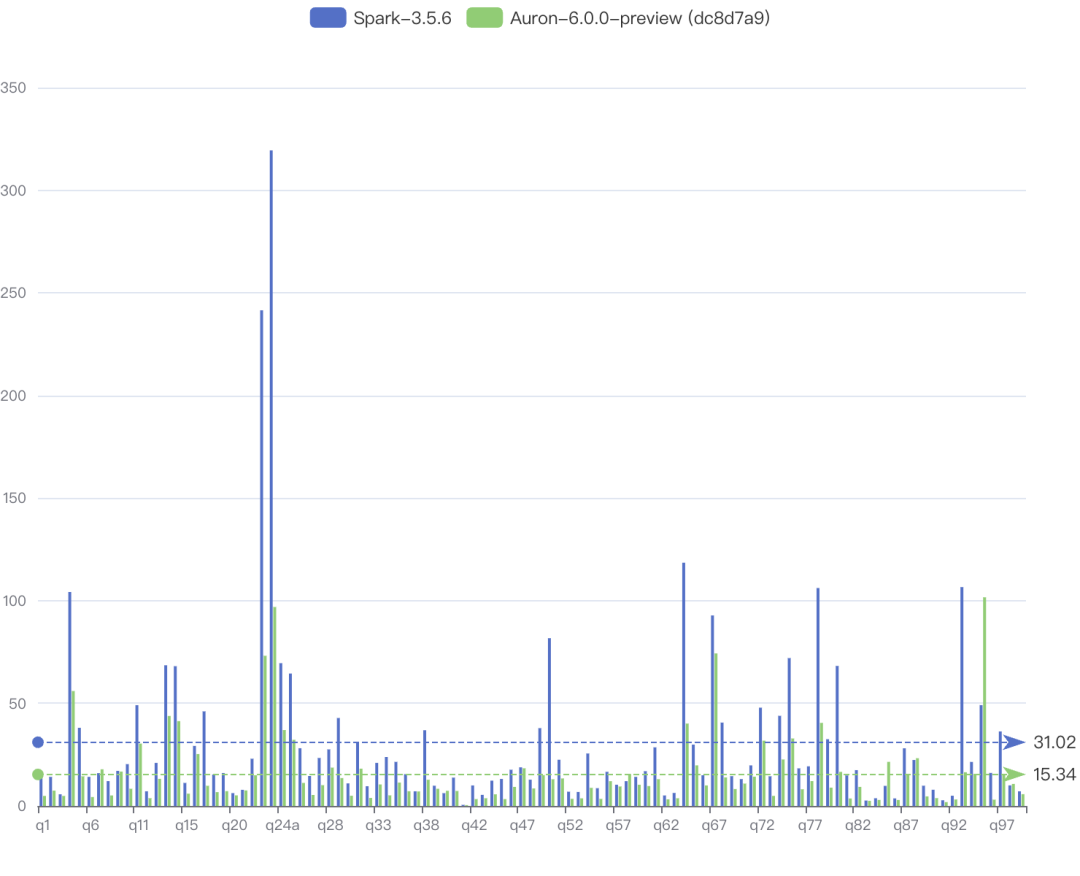
这张官方基准图比一句“整体更快”更有参考价值:不同查询的差距并不相同,个别查询里绿色柱子也会高于蓝色。图中还是特定预览构建的结果,不能直接套到另一套 Spark 版本和生产数据上。我会先挑每天最耗时的几条 SQL,再挑几条包含复杂表达式的任务,同时核对结果一致性、运行时间和资源消耗。
准备动手时,可以从仓库提供的构建脚本开始。检出代码、进入仓库后,先运行官方 README 中这条命令查看构建选项:
./auron-build.sh --help
本地编译需要准备 Rust nightly 和合适的 JDK,并正确设置 JAVA_HOME;脚本也支持 Docker 构建。生成的依赖打包 JAR 放入 Spark 客户端的类路径后,再按官方接入说明配置扩展和 Shuffle 管理器。下面是 README 中的关键配置片段,不是脱离 JAR 和版本条件就能独立工作的完整部署文件:
spark.auron.enable true
spark.sql.extensions org.apache.spark.sql.auron.AuronSparkSessionExtension
spark.shuffle.manager org.apache.spark.sql.execution.auron.shuffle.AuronShuffleManager
spark.memory.offHeap.enabled false
这里最容易被忽略的是内存。原生执行层参与工作之后,只看 JVM 堆大小并不足以理解整个进程的资源需求。官方示例同时给出 executor memory 和 memory overhead 的配置,恰好提醒了这一点:评估应记录完整资源占用,不能只比较一个漂亮的查询耗时。
对已经依赖 Spark、又确实有计算成本压力的团队,Auron 值得放进测试环境。对于数据量不大、任务主要在等待外部接口,或者连慢查询瓶颈都还没定位的系统,增加一层执行组件未必是优先事项。我愿意给它的机会,是让同一批真实作业跑出一份可以复查的账单。
项目地址: https://github.com/apache/auron |  发表于 昨天 23:37
|
查看: 5|
回复: 0


