10月14日晚,安全研究员古河(Yuki Chen)在 X 上宣布加入智谱,称自己开启了“新征程、新使命”。他表示,很高兴有机会借助前沿 AI 的力量帮助构建更安全的网络空间,并在帖文中提及智谱海外品牌 Z.ai。
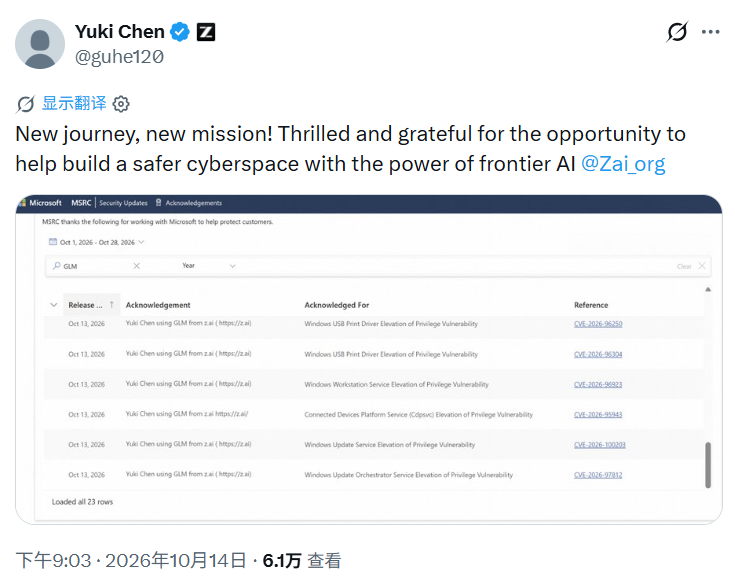
与这条消息一起出现的,还有一张微软安全响应中心(MSRC)的漏洞致谢截图。截图中,搜索框输入的是“GLM”,页面底部显示共加载 23 条记录。多条致谢采用了相同的表述:
“Yuki Chen using GLM from z.ai”。
这位长期研究 Windows 漏洞的安全专家,已经把 GLM 用进了实际工作。
在安全圈,古河并不是一个陌生名字,早年曾在 360 从事漏洞研究。Black Hat Europe 2015 大会官网显示,他当时是 360 安全攻防研究小组旗下 360Vulcan 团队的核心成员,并管理一个专注于漏洞研究的团队,研究方向包括漏洞挖掘、分析与利用开发。
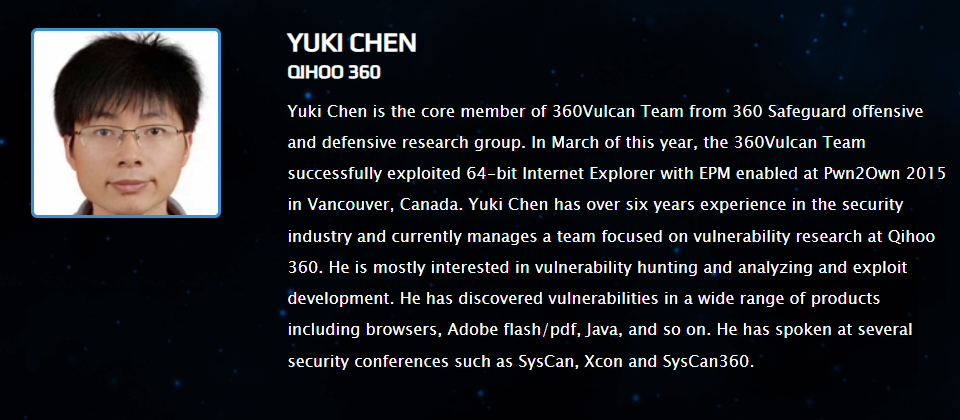
2015 年 3 月,古河所在的 360Vulcan 团队在 Pwn2Own 大赛中,成功攻破开启增强保护模式(EPM)的 64 位 IE 浏览器。他本人也曾在浏览器、Adobe Flash、PDF 及 Java 等产品中发现漏洞。
据安全会议 SAS 官网介绍,古河拥有 15 年以上攻防安全经验,曾五次登顶微软 MSRC 年度最具价值安全研究员榜单,分别是 2019 年及 2021 年至 2024 年。
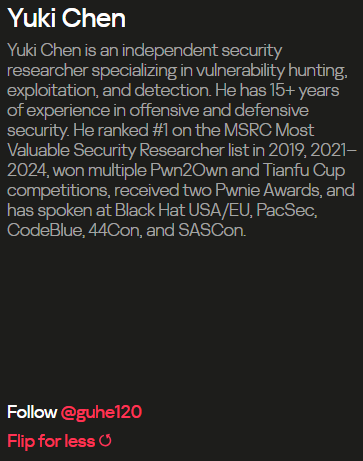
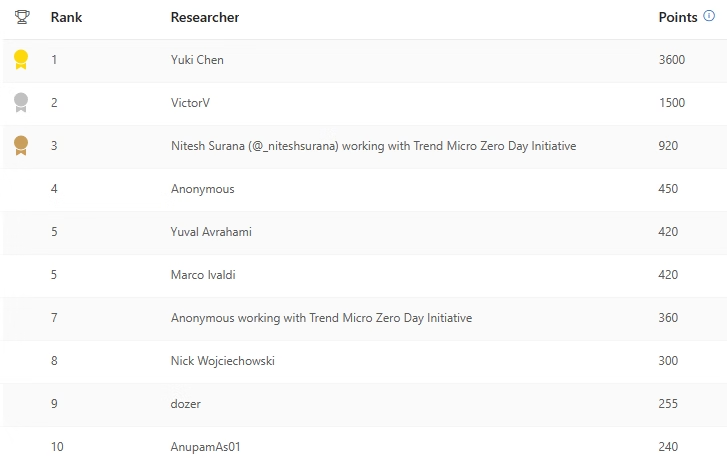
此外,他还曾在 Pwn2Own、天府杯等赛事中获奖,获得两项 Pwnie Awards,并在 Black Hat、CodeBlue、SAS 等安全会议分享研究。微软自己的公开记录也能看到他持续活跃的轨迹:在 2024 年第一、二季度安全研究员榜单中,Yuki Chen 均位列第一。
这样的履历,让这次加入智谱有了更多看点。
当大模型逐渐具备代码分析和工具调用能力,如何把这些能力用于真实漏洞研究,已经成为模型厂商与安全行业共同关注的问题。模型能否发现异常只是第一步,研究员还需要判断线索是否有效、复现问题、验证影响,并将结果整理成软件厂商能够处理的报告。古河这次贴出的微软致谢截图,恰好展示了这一方向上的实际进展。
从截图可见,相关记录的发布日期为 10 月 13 日,涉及 Windows USB 打印驱动、工作站服务、连接设备平台服务、Windows 更新服务等多个组件,展示的漏洞类型包括权限提升。
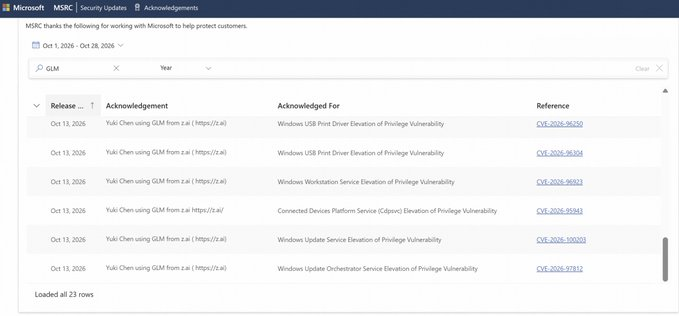
微软在致谢栏里,同时写出了研究员姓名和所使用的模型。
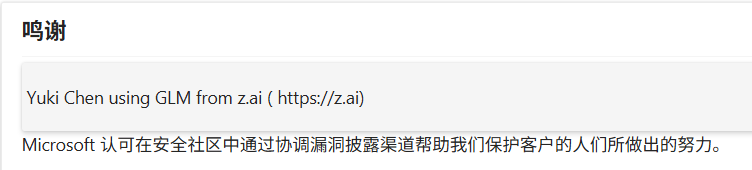
模型的名字,开始出现在真实软件漏洞的致谢记录中。
这提供了一个比模型演示更具体的观察入口:在这些研究工作中,GLM 已经成为研究员使用的工具,并在公开署名中得到体现。不过,截图尚未披露完整的工作过程,包括使用了哪个版本的 GLM、模型负责哪些环节,以及研究员投入了多少时间。因此,现阶段更准确的说法是,古河使用 GLM 参与 Windows 漏洞研究,其分享的 MSRC 页面显示了 23 条相关致谢记录,尚不能据此判断这些漏洞全部由模型独立发现。
古河加入智谱的时间点,也恰逢 GLM 的网络安全能力受到更多外部关注。
9 月 17 日,美国国家标准与技术研究院(NIST)旗下的 AI 标准与创新中心 CAISI,发布了对 GLM-5.3 网络安全能力的评估。
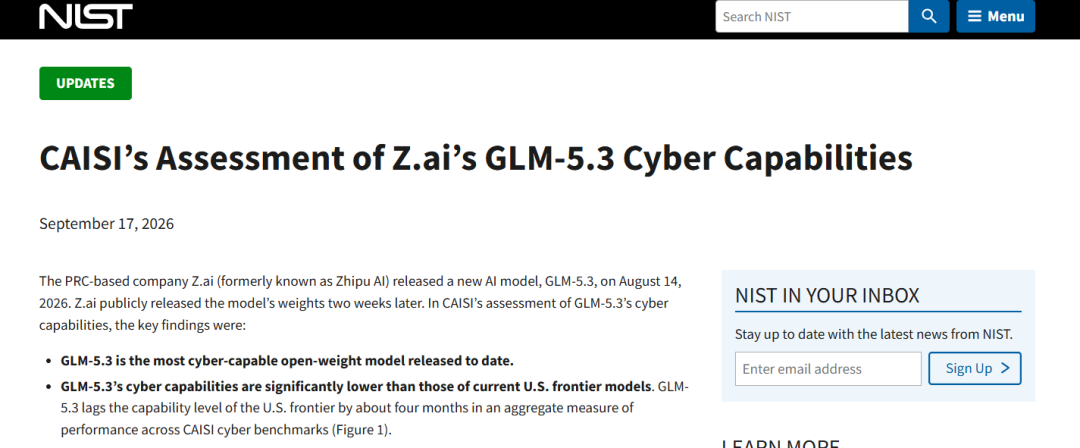
CAISI 认为,在其当时的评估范围内,GLM-5.3 是网络安全能力最强的开放权重模型。同时,其综合表现仍落后于美国前沿模型,能力差距约为四个月。这项评估覆盖漏洞发现、漏洞利用开发等任务,关注模型能否在给定软件环境中找到问题,并完成相应验证。
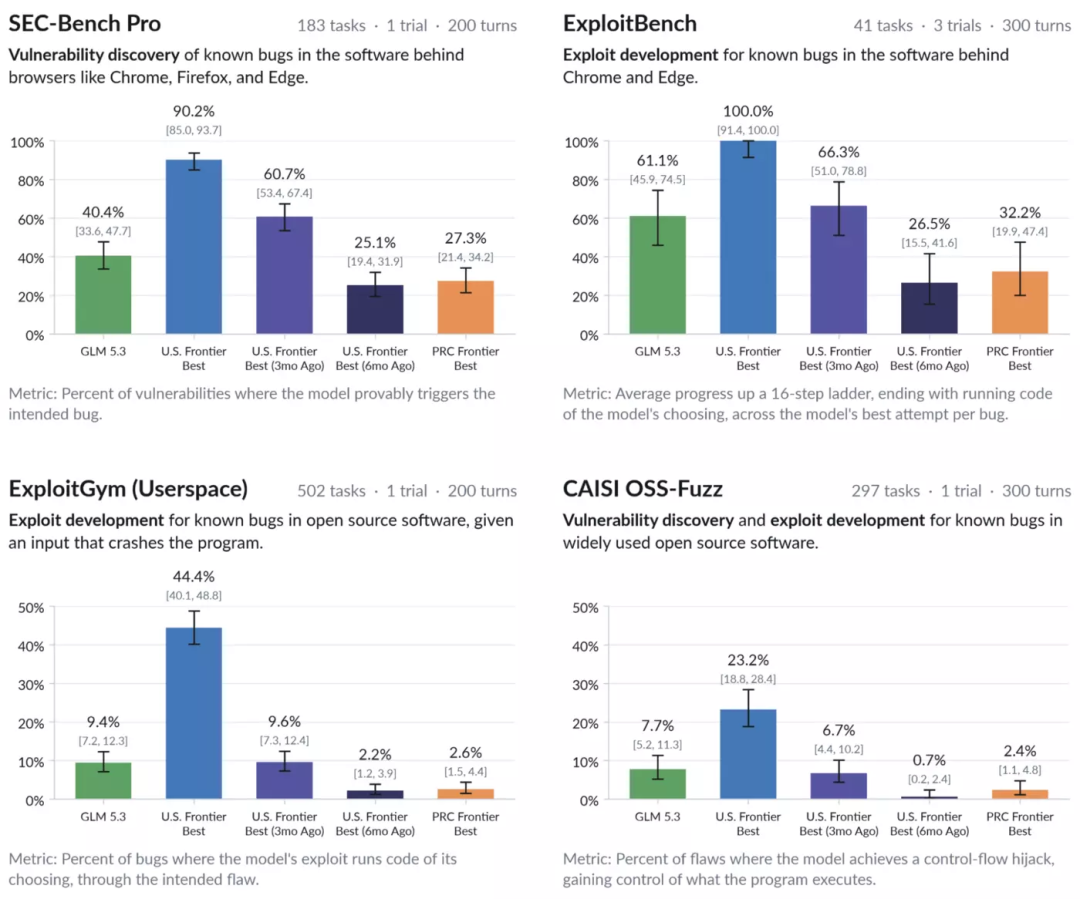
9 月 29 日,Anthropic 也发布了一篇专门分析 GLM-5.3 网络安全能力的文章,题为《GLM-5.3 and the spread of advanced cyber capabilities》。
在其 ExploitBench 测试中,GLM-5.3 在 410 次尝试中有 50 次完成端到端漏洞利用,Claude Mythos Preview 为 56 次;在另一项内部二进制漏洞利用测试中,两者的成功率分别为 4% 和 6%。
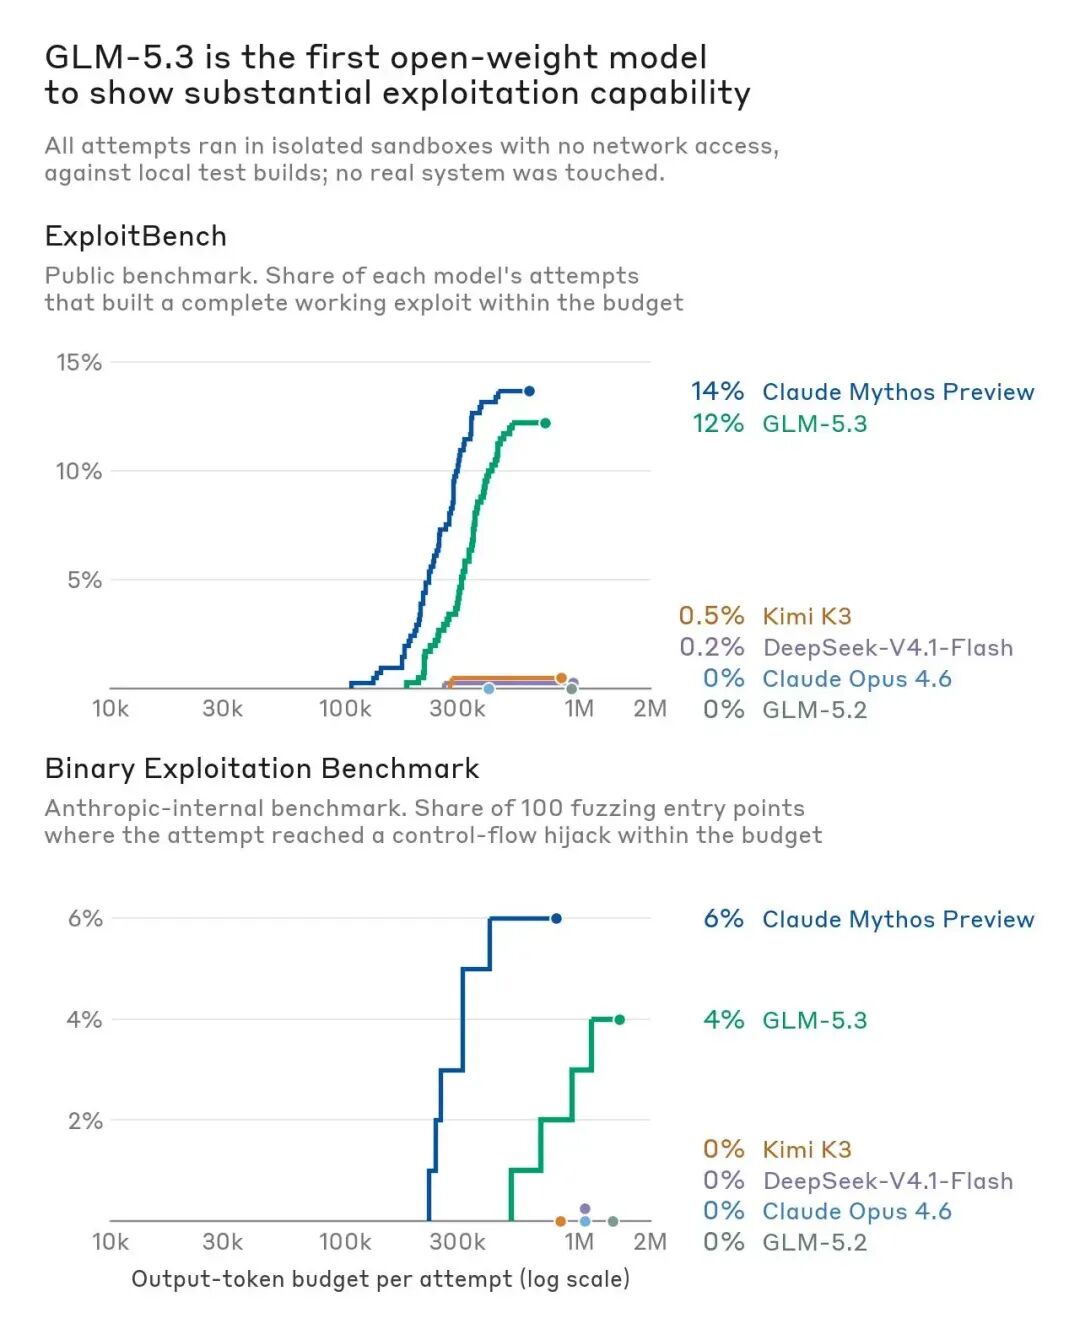
这些结果来自特定的隔离测试环境,衡量的是指定任务下的漏洞利用能力,不能直接等同于开放环境中的漏洞挖掘表现。但它们与古河分享的 Windows 漏洞致谢记录,提供了两种不同的观察:
- 前者展示模型在受控测试中能够做到什么。
- 后者展示专业研究员已经把模型用到了哪里。
Anthropic 的报告也讨论了 GLM-5.3 的防护机制与滥用风险。这类能力可以帮助研究员发现并修复软件问题,也可能被攻击者使用,模型能力与防护措施需要同时接受检验。
对智谱而言,古河的加入,使模型研发与实际漏洞研究之间多了一位熟悉两端的参与者。长期从事漏洞研究的专家,能够帮助团队判断哪些任务值得交给模型、哪些输出需要进一步验证,以及怎样才能把模型发现的问题转化为有效报告。
目前,古河尚未在这条官宣中披露具体职位、团队安排和后续项目。但随帖附上的微软致谢记录,已经让这次人事消息有了一个具体落点:
这位五次登顶微软年度榜单的安全研究员,已经带着 GLM 参与了真实的 Windows 漏洞研究。
 发表于 昨天 23:31
|
查看: 10|
回复: 0


