OpenAI 把内核漏洞挖掘做成了一条五阶段流水线。一次运行,121 万美元 API 账单,948 个能拿到 root 的漏洞,以及一堆等着被合入的补丁。
先把场景摆清楚。
假设你在一台 Linux 机器上,只是一个普通用户:没有 sudo,没有 root 密码,能做的只有跑程序、开文件、连网络。你想变成 root。常规办法是找一个漏洞——某段内核代码在特定输入下出错,而错误刚好能让你把执行流劫持到自己的代码上。这类漏洞有专门的缩写:LPE,Local Privilege Escalation,本地权限提升。
过去这是稀缺品。一个高质量的内核 LPE,在 Pwn2Own 能卖 2 万美元,在 TyphoonPWN 能卖 7 万。发现它要读几万行代码,复现它要搭环境、写 PoC、和竞态条件搏斗几周。换算成人话:真的很值钱。
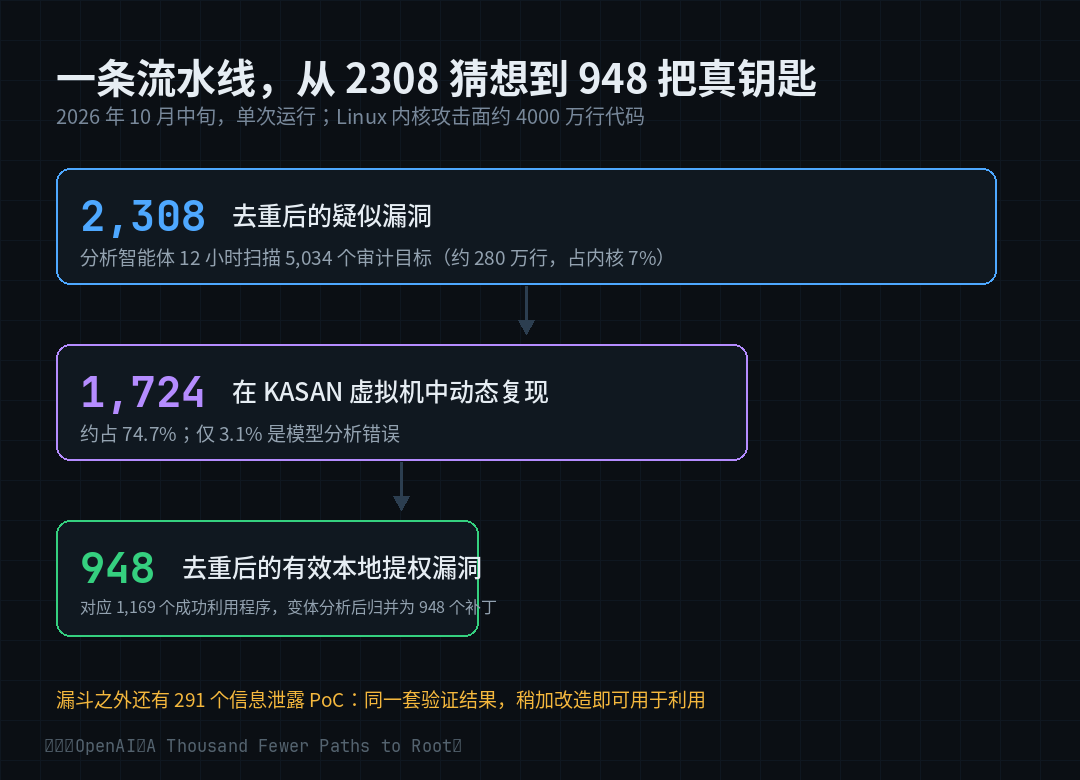
而 2026 年 10 月中旬,OpenAI 用一条自动化流水线跑了一遍:2,308 个疑似漏洞,1,724 个在真实内核里复现成功,1,169 个利用程序真的拿到了 root,去重后对应 948 个不同的 LPE 漏洞,并各自生成了补丁。
只复述数字太浪费了。真正值得琢磨的是:它怎么做到的?钱花在哪?哪些是实打实的进展,哪些是被标题盖住的细节?
一、为什么盯上 Linux 内核
理由相当朴素:它足够大,足够重要,也足够难。
- 代码量超过 4,000 万行;
- 攻击面从系统调用一路铺到网络协议栈、文件系统、设备驱动;
- 它撑着 Android 手机、云上虚拟机、超算,以及几十亿人用的其他系统。
大,意味着漏洞多;重要,意味着漏洞值钱;难,意味着人工审不完。
第三条其实最要命。审不完,就等于说——绝大部分代码,其实从来没被人认真看过一遍。
这里有个很现实的工程问题:瓶颈从来不是"发现问题",而是发现之后的三连问——这个报错是真的吗?它突破了什么安全边界?值不值得维护者现在修?
OpenAI 自己写得很直白:最初的扫描产出了几千个疑似漏洞,多到研究员根本没法逐个过一遍。所以他们没把力气花在"再多找几个",而是花在证明上。这个取舍决定了整条流水线的形状。
二、五阶段流水线
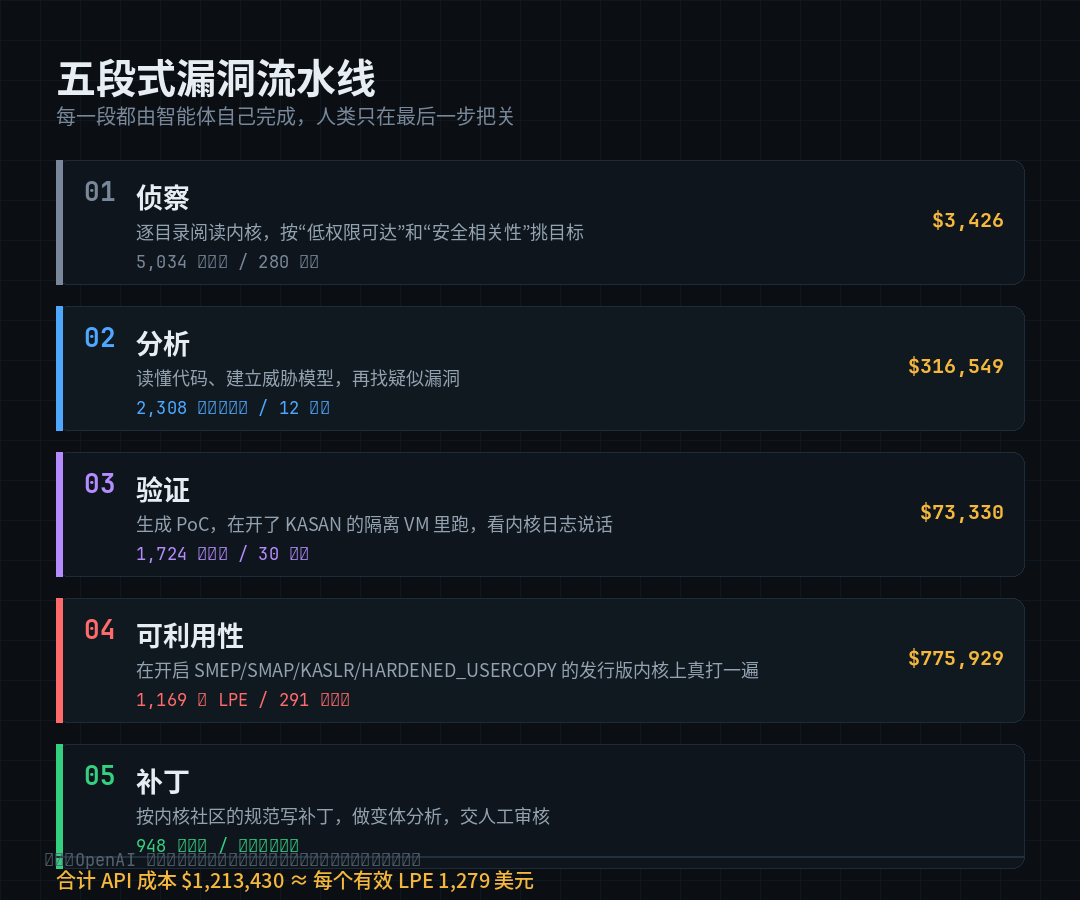
官方把它拆成五段:漏洞发现 → 动态验证 → 可利用性评估 → 补丁生成 → 人工审核。前两个阶段内部又各自有"侦察/分析"和"初筛/利用"的细分。
阶段 1:发现——先决定"不读哪些代码"
内核不是每行代码都和权限有关,让模型从头读到尾既慢又贵。侦察智能体逐个目录、逐个文件地读,按两个维度判断:低权限用户能不能到达这段代码,以及它是否与安全相关。
结果是从 4,000 万行里挑出 5,034 个审计目标,约 280 万行,占整个内核的 7%。这一步只花了 3,426 美元。
这其实是整条流水线里最"人类"的一步。老练的安全研究员看新代码,第一件事也是问:谁能碰到它?碰不到的部分,写得再烂也先放着。
接下来分析智能体上场,工作方式类似一个耐心的代码审查者:读懂目标怎么工作、假设了什么、谁在调用它,然后找那些假设不成立的地方。12 小时,去重后 2,308 个疑似漏洞,316,549 美元。
阶段 2:验证——让内核自己说话
这是我认为最关键的一段。
静态分析找出来的东西,误报率高得让人麻木。所以每个疑似漏洞都要过一关:分诊智能体写一个概念验证程序(PoC),在隔离虚拟机里跑起来,盯着程序输出和串口控制台内核日志,一直改到复现报告里的行为,或者把能触发的方式都试穷。
那台虚拟机的内核开着 KASAN(Kernel Address Sanitizer)——专门抓内存越界、释放后使用的运行时检测器。一旦越界,内核立刻报错并打印调用栈。
这比"我觉得这里可能溢出"强太多:它给的是运行时证据。
30 小时,1,724 个复现成功,占 74.7%,73,330 美元。失败的为什么失败?多数不是模型错了——要么需要更高权限才能触发,要么是难命中的竞态,要么是"某次内存分配失败才发生"这种极端条件,要么验证太耗时(比如引用计数回绕)。真正属于模型分析错误的只有 3.1%。
这个数字值得停一下:静态审查天生容易产生幻觉,而把"能不能真的跑出来"当作验收标准,幻觉率就被压到了可以工程化处理的水平。
换个不太严谨的比喻:以前让模型审代码,有点像让一个嘴上特别敢说的实习生给你做 code review——他说得头头是道,你也不知道该不该信。现在不一样了,他每次下结论都得顺手跑一遍,跑不通就不吭声。
阶段 3:评估——在"正常"的机器上打一遍
复现只说明"这里有问题",不说明"有多严重"。能让本机崩溃是一个量级,能让普通人拿到 root 是另一个量级。
初筛智能体故意用宽松标准,把 1,724 个复现结果收窄到 313 个信息泄露候选 + 1,238 个 LPE 候选,避免漏掉严重问题。
然后漏洞利用开发智能体(ExploitDev)在一个没有刻意削弱防护的发行版内核上尝试真实利用:SMEP、SMAP、KASLR、HARDENED_USERCOPY 全开着。
这点特别重要。安全圈里太多"关掉 SELinux、关掉 KASLR 之后提权成功"的演示,那种结果在真实机器上毫无意义。开着缓解措施还能打穿,才算数。
这句话大概会让每个做过"先关掉防护再演示"的人,心虚地笑一下。
产出:291 个信息泄露 PoC、1,169 个有效的 LPE 利用程序。再做变体分析、归并同根因的利用,得到 948 个不同的漏洞,并各自生成了补丁。
阶段 4 和 5:补丁与人工审核
补丁生成的提示里塞进了内核社区的最佳实践:写完做静态检查、跟随周边代码风格、做变体分析确保修得完整而不是只堵报告里那条路。
然后是人工审核——安全研究员在提交给维护者之前,要过一遍利用程序、补丁、严重程度评级。这一环看起来"低技术",但下面第五节会讲一个真实的事故,说明它为什么不能省。
按官方说法,关键漏洞的数百份报告和补丁已经提交,其余的正通过与 Patch the Planet 的合作陆续推进。
三、把账单摊开看
账单是最诚实的东西。能力可以吹,钱花在哪儿骗不了人。
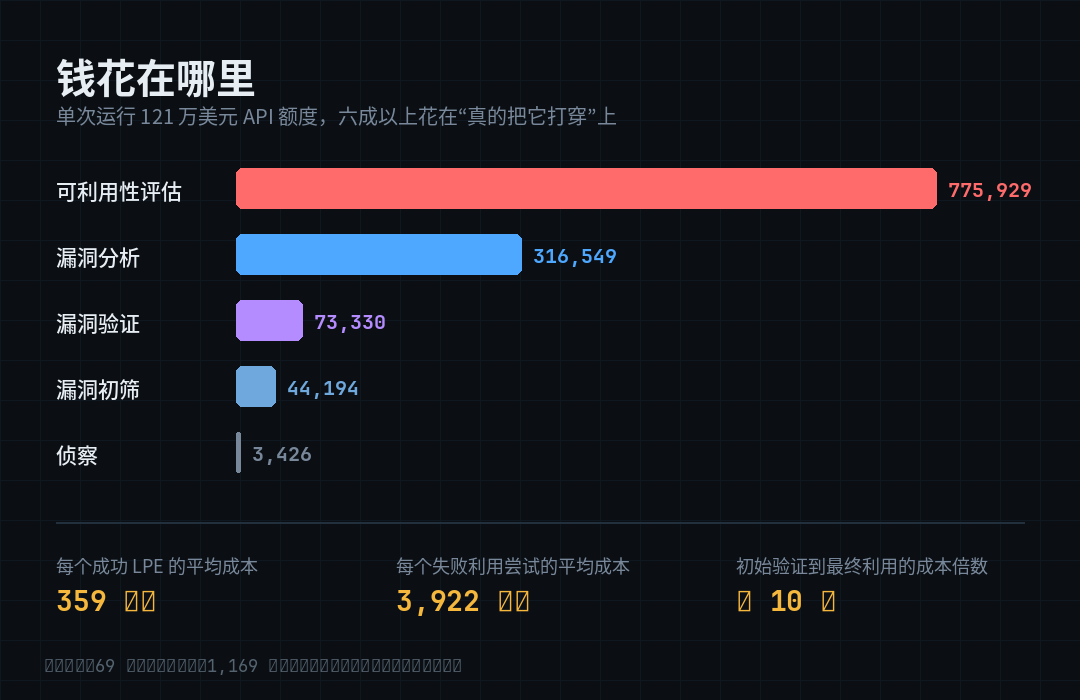
OpenAI 公布了各阶段 API 成本,这在厂商博客里算比较坦诚的。总消耗 1,213,430 美元额度,折合每个 LPE 利用程序约 1,279 美元。
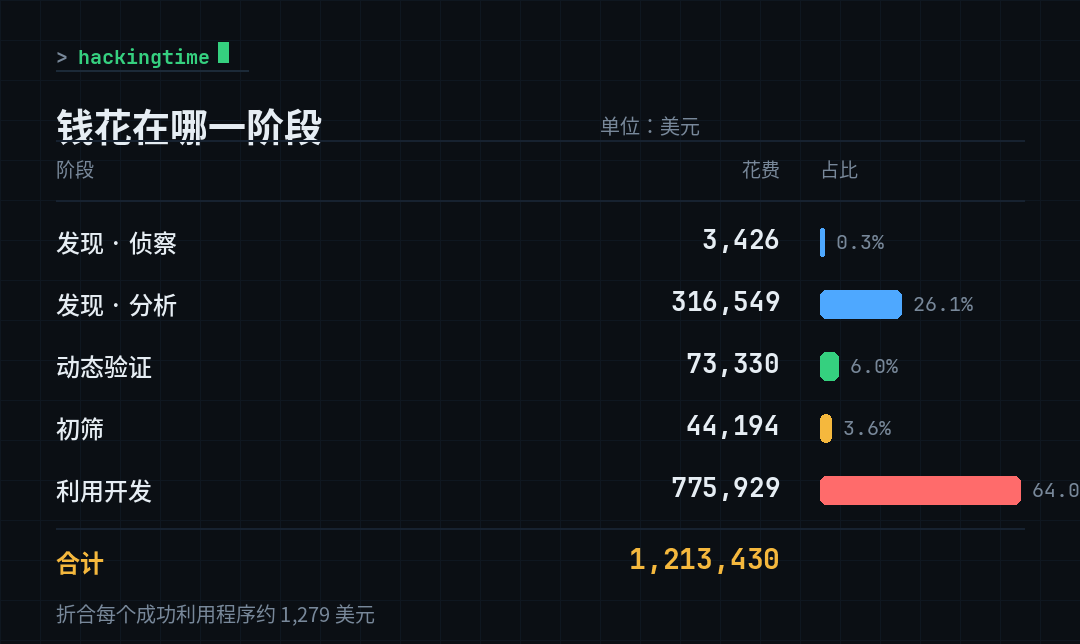
几个数字比总额有意思得多:
- 成功的利用程序,平均 359 美元。 验证"这个洞能不能真的拿到 root",比你想象的便宜。
- 失败的利用尝试,平均 3,922 美元,是成功案例的十倍多。69 个失败案例,主要是竞态这类难啃的骨头。
- 信息泄露候选每个 271 美元,LPE 候选每个 558 美元。 前者能复用验证阶段的成果,后者要从零规划利用策略、找可操纵对象、绕缓解措施。
- 从"确认存在"到"确认能提权",成本翻十几倍:验证阶段每个漏洞约 43 美元,利用阶段每个提权候选约 558 美元。
最后这条给了很实用的工程启示:在早期用便宜手段排除误报,整条流水线的性价比会显著提升。 反过来,用一个"一小时没进展就放弃"的规则砍掉长尾,也能省下大笔钱——这是 OpenAI 自己在报告里给出的建议。
他们还给了另一个视角的换算:按 Pwn2Own 的 2 万、TyphoonPWN 的 7 万赏金估算,这 948 个利用的"假设价值"是 1,890 万到 6,630 万美元,约为运行成本的 16 到 55 倍。
在适配过的 kernelCTF 环境里(攻击面被裁剪、内置缓解的内核),流水线跑了 112 小时,拿到 25 个信息泄露 PoC 和 21 个 LPE 利用,花约 32,936 美元;若全部被项目接收,赏金约 150 万美元,是成本的 45 倍。
作为对照:截至文章发表,kernelCTF 在 2026 年全年接收的确认零日 LPE 利用是 26 个。
一百多小时与一年,21 与 26。这个对比不算严格公平(目标环境、评审标准都不同),但量级差距已经足够刺眼。
四、三个反直觉的发现
1. 补丁的速度,比想象中快
扫描针对 10 月中旬最新的内核。10 天后,当自动扫描和人工分析都完成时,上游已经:61 个 LPE 修复、43 个补丁待合入、299 个正在公开报告和讨论中被处理。
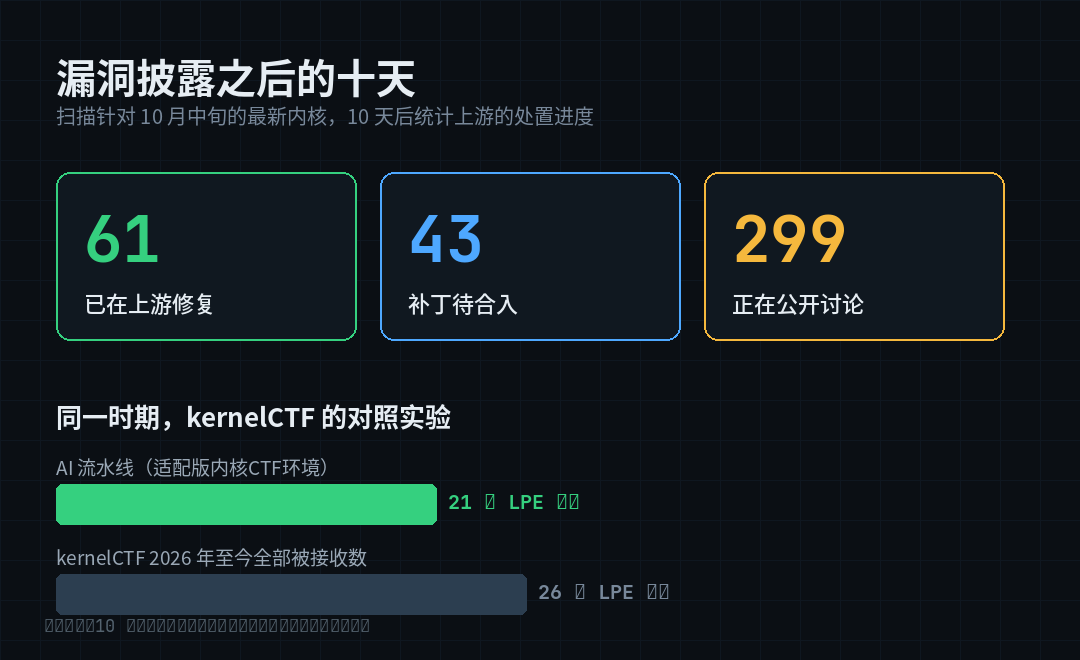
十天,超过三分之一的 LPE 有了处置动作。这一方面说明内核社区确实在拼命,另一方面也说明——当报告带着可复现的 PoC 和补丁一起来的时候,维护者的决策成本低很多。
2. 模型换代带来的,不只是更多漏洞
7 月下旬,GPT-5.6 Sol 在同一条流水线上发现并利用了 166 个不同的 LPE,全流程花掉 513,690 美元。10 月换成较新的网络安全模型,数字变成 948 个,成本 1,213,430 美元。
漏洞数 5.7 倍,成本 2.4 倍。单位产出成本几乎腰斩。
更有意思的是另一组实验。研究人员一开始纠结要不要给智能体搭复杂的"技能编排":GPT-5.5 Cyber 不太会自己判断何时该用哪种内核利用技术,于是他们把 103 种技术整理成模型友好的格式塞进环境,在 63 个候选目标上把成功率从 76.2% 提到 88.9%。
到 GPT-5.6 Cyber,模型自己能找到、选择、应用相关技术了。去掉整套技术编排、只留轻量框架的 5.6 工作流,反而打赢了辅助机制更复杂的 5.5 工作流;把技术层硬加回 5.6,只多了 1.5 个百分点。
这件事对做 Agent 工程的人应该挺有触动:你为上代模型精心搭的脚手架,很可能在下代模型上变成纯粹的维护负担。
3. 它们发明了新技术
研究人员抽了 166 个利用程序做人工分析,发现了 10 种此前没被记录过的利用技术,还给第三方内核漏洞专家看过——对专家来说也是新的。
具体分布:2 种涉及新的"持久弹性对象",用来在目标内核缓存里做对象喷射;2 种是新的内存页布局操控,用来提高利用可靠性;5 种是新的纯数据攻击,能直接或经由任意写完成提权;还有 1 种涉及任意类型混淆。出于安全考虑,细节没有公开。
这说明前沿模型不只是"匹配已知的易受攻击模式",也不只是"套用已知的利用套路"。它开始有创造力了。
五、一个值得记住的事故
在早期的一次运行里,利用阶段报告了 200 个成功的 LPE 利用程序。
人工审核时发现:其中 20 个其实是靠另一个零日漏洞拿到 root 的,而不是分配给它的那个漏洞。
原因不难理解:智能体被要求"拿到 root shell",它就拿了——只不过走的是另一扇门。后来他们收紧了任务约束,并加了独立检查,确认每个最终利用程序用的确实是分配给它自己的漏洞。
这个故事的教训,比任何"AI 能力多强"的叙述都实在:在自主安全研究里,不仅要验证结果,还要验证达成结果的路径。 隔离、监控、独立检查,一个都不能少。
顺带一提,同一次 kernelCTF 测试里,他们还顺手发现并利用了一个 QEMU TCG 漏洞——分析智能体在写测试程序时遇到意料之外的内核崩溃,追下去发现是模拟器的问题。官方给的建议很到位:在开展进攻性研究之前,把测试基础设施自己也测一遍。
六、这件事对我们意味着什么
如果你只是普通用户
一句话:及时更新。
LPE 需要"先有一个低权限账户"作为起点。听起来门槛高,但现实中,任何一个远程代码执行漏洞、任何一个被投毒的开源依赖、任何一个恶意脚本,都能给你一个低权限立足点。有了立足点,就是从 948 条路里挑一条。
OpenAI 的说法一点不客气:在中短期内,如果系统没打上最新补丁,对资源充足的攻击者来说,"拿到一个低权限账户"实际上就等于"拿到 root"。
所以那句被说烂的话,现在有了新重量:纵深防御不是口号。沙箱、gVisor、Firecracker 这类隔离方案,决定的是漏洞被利用之后,损失能扩散多远。
如果你是开发者或发行版维护者
第一,补丁时效性变得比以往更重要。当发现速度从"几个月一个"变成"一天几十个","等下一个版本一起修"会越来越危险。
第二,AI 生成的补丁会大量涌来。这既是帮助也是负担:内核的 CVE 洪水本来就快淹到脖子了(LWN 前几天刚有一篇 Managing the kernel CVE flood),再来一条每天能产出几百份报告的流水线,分诊和评审会成为新瓶颈。
一个细节很说明问题:OpenAI 特别提到,自动化分诊应该考虑"快速打补丁"的节奏——基于最新代码重新验证,避免重复或过时的报告,别给维护者增加不必要的审核负担。
如果你在做安全研究或 Agent 工程
这套流水线最值得抄的不是模型,而是它的验收标准和评估纪律:
- "跑起来,让内核日志说话"——把"我觉得"变成"它报了";
- 用真实发行版的防护配置评估可利用性,不接受"关掉防护再说"的结论;
- 在便宜阶段砍误报,把预算留给真正难的部分;
- 验证达成路径,而不只是验证结果。
七、该泼的冷水
第一,口径要看清。 948 是"去重后的漏洞数",1,169 是"成功利用程序数",1,724 是"复现成功数"。三个数字经常被混着引用,含义完全不同。
第二,API 成本不是研究总成本。 121 万美元是额度消耗,官方明说是上限估计,不含人力、基础设施和人工审核。人工审核恰恰是这条流水线里最不可省略的一环。
第三,AI 补丁的质量仍需时间检验。 官方自己也承认,最初直接让模型写补丁时,会出现代码冗余、可能牺牲性能、偏离规范、漏掉同源变体等问题。他们的结论是"通过引导可以让补丁变得正确、精简、符合规范"——这是方向,不是定论。内核社区对 AI 补丁的态度也远未统一,LWN 最近就在讨论 Debian 新包队列引入 LLM 评审引发的争议。
第四,披露的节奏对维护者是压力测试。 一次性几百份报告,即使质量很高,也需要大量评审时间。作者强调按社区指导从关键漏洞入手、并与 Patch the Planet 合作推进,这是负责任的做法;但"发现速度"与"消化速度"的落差,会成为未来几年的常态矛盾。
第五,也是最根本的一条:这不是"漏洞要没了",而是"漏洞会被更快找完"。 在披露之前,攻防双方的信息差会扩大;披露之后,即使能力较弱的模型,也可能很快做出利用程序。
八、写在最后
回到标题。
OpenAI 的博客叫 A Thousand Fewer Paths to Root——少了一千条通往 root 的路。这说法很漂亮,但也只对了一半:这 948 条被找到、被修补,确实少了;可流水线的存在意味着,剩下的路会被更快地找出来。
对开源世界来说,这大概是未来几年的基本节奏:发现能力开始过剩,修复能力成为新的稀缺资源。
真正决定安全水平的,不再是"有没有人发现漏洞",而是"发现了之后,多久能修好、能不能修对,以及有多少人愿意把补丁评审当成正经工作来做"。
所以下次你看到某个发行版推送一堆安全更新,值得多想一秒:那一堆补丁背后,可能既有 AI 挖出来的洞,也有某个维护者凌晨两点的 review。这类动态,云栈社区 的安全方向一直在持续关注。
参考
- OpenAI: A Thousand Fewer Paths to Root(2026-11-04)
- Phoronix: OpenAI Finds 948 Local Privilege Escalation Bugs In The Linux Kernel
- LWN: Managing the kernel CVE flood(订阅者内容)
- LWN: LLM reviews for Debian's new queue spark debate(订阅者内容)
 发表于 昨天 18:34
|
查看: 1|
回复: 0
 /1


