让 AI 助手设计一张表,它几秒就能输出一份语法正确、外键齐全、索引合理的 DDL。这套答案在单机数据库上够用,但放到分布式数据库上就经常走反了。CockroachDB 在 11 月 5 日发布的 ChatGPT 与 Codex 插件,要解决的正是这个断层:把 34 个任务技能和一个可选的实时数据库连接装进编码环境,让 agent 在动笔写代码之前,先问清楚工作负载长什么样。
一、通用答案在分布式数据库上错在哪
官方博客里举的第一个例子就很有代表性:编码助手给出一份干净的 schema,命名合理、外键正确、索引齐全,快速审阅看不出问题。但持续写入之下,单调递增的键会把写集中到索引的某一段,原本合理的 schema 在负载下变成热点。
问题不在语法,而在于 CockroachDB 虽然讲的是熟悉的 SQL,但每一条设计都跑在分布式系统上。key 的顺序决定写落在哪一段,索引既影响读性能也决定写成本,事务可能跨节点、跨区域;locality 的选择同时影响延迟与韧性;迁移计划要考虑应用行为、验证、切换与回滚,而不只是搬数据。
这些都不是“提示词写得更详细”能补上的。模型必须知道,哪些细节在分布式环境下是要紧的,这也是这个插件想提供的第一样东西。
二、三层结构:技能、连接、权限
官方把这个插件拆成三部分。
第一层是 34 个任务技能,覆盖 schema 设计、SQL 优化、事务行为、迁移、集群运维、多区域部署、可观测性、安全、合规与维护。这些技能来自公开的 cockroachdb-skills 仓库,来源公开意味着后续版本能持续把改进带进来。技能按任务触发,需要时才加载,官方特别说明它们不会重训底层模型——它改变的是“该看哪几个细节”,不是模型本身的能力。
第二层是一个可选的、经过认证的 CockroachDB Continuum 连接,通过 MCP 把当前的 schema、query plan 和集群上下文接进来。官方的分工说得很清楚:MCP 连接能给出表定义或查询计划,技能负责解释这些细节里哪些要紧、怎么变成一条有用的建议。两者分开,正是它与“再写一段提示词”之间的差别。
不需要连接也能用。把 schema、迁移要求或查询计划直接贴进对话里,插件照样工作;接上 CockroachDB Cloud 之后,看到的是真实环境,而不是你记得粘贴的那一段。
第三层是权限。技能能干什么、连接能看什么,最终都由用户自己的 CockroachDB Cloud 权限和审批决定。
官方给出的动机可以概括成一句话:开发者正在把 agent 带进 schema 设计、迁移规划和查询调优,而这些决定会直接影响应用后续的性能、扩展性与韧性,所以 CockroachDB 的经验需要从一开始就参与这些工作。这句话也解释了这个东西为什么做成插件而不是文档——文档要等人主动去查,插件则是在人写代码的那一刻就在场。
三、三个场景里,插件多问了什么
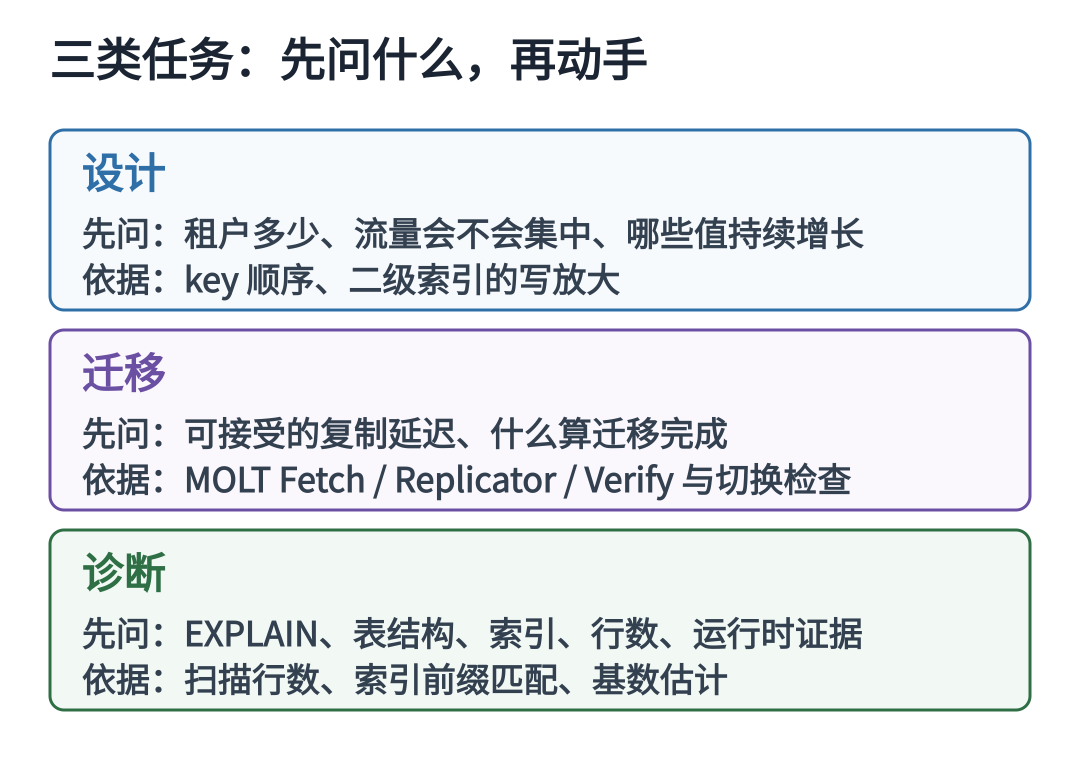
官方给了三类任务,值得逐个看,因为差别不在结论,而在提问顺序。
设计:为多租户 SaaS 设计一个避免写热点的 schema。通用助手几秒给出 DDL;插件则要求先问清楚预期多少租户、流量会不会集中在少数租户、哪些值会持续增长、读写是否限定在单个租户、要不要租户级 locality。问完之后才谈 key 顺序、hash 分片索引的取舍,以及每个二级索引带来的写放大与存储成本。
迁移:用 MOLT 做 PostgreSQL 的低停机迁移。通用助手给一串命令;插件先做兼容性评估,指出哪些 PostgreSQL 特性需要特别处理,再按 MOLT Fetch、MOLT Replicator(合适时)、MOLT Verify 和最终切换检查来组织工作。真正要问的是:可接受的复制延迟是多少,什么能证明目标端完整且健康,什么时候停写,到哪个时间点之后回滚就不再安全。
诊断:从 EXPLAIN 计划定位慢查询。插件的纪律是证据优先——先要查询和计划,再补表定义、索引、行数、统计信息和运行时证据;如果慢只出现在负载下或只在某个区域,这条上下文必须带上。然后才去找具体问题:扫描处理的行数远多于返回行数、重复查找本可以用覆盖索引避免、过滤条件与索引前缀不匹配、基数估计偏差、多余的排序,以及分布式执行代价大于收益的步骤。最后一步要求把改动做成可验证的:改一个索引或一个谓词,在可比条件下重跑,对比计划与实际表现,有证据支持才保留。
官方的总结是:有用的结果不是一串命令,而是带假设、责任人、决策点、验证与回滚步骤的计划。
四、权限边界:能看、能做、不能做
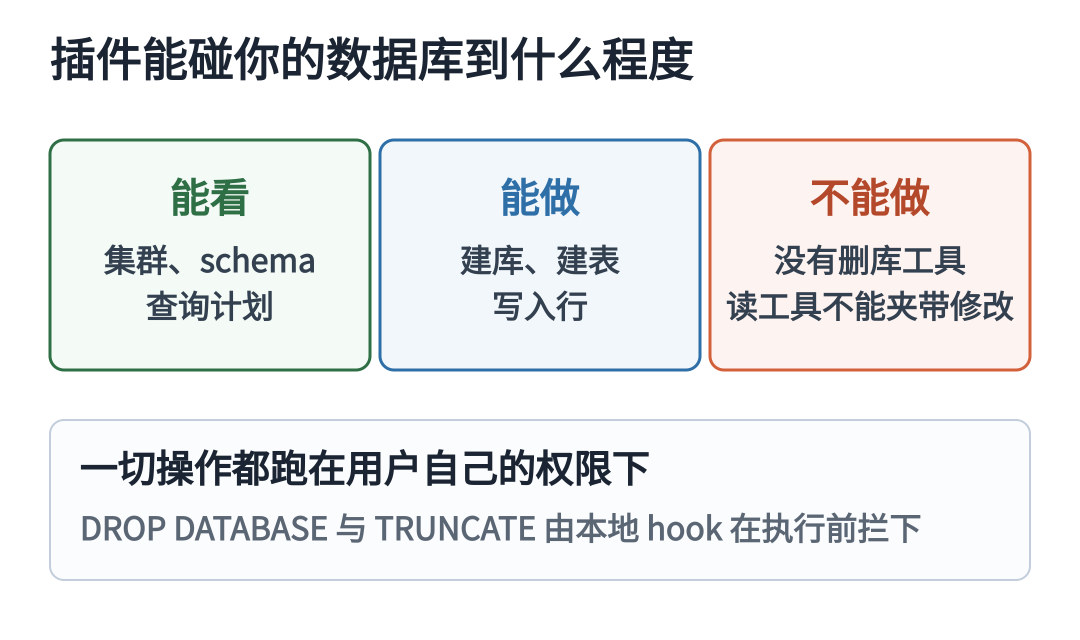
插件接上 CockroachDB Cloud 之后,能看到的东西有一份明确清单:集群、数据库、schema、query plan、运行中的查询,以及取回有限的一批查询结果。
能做的写操作只有创建类动作——建数据库、建表、写入行,且仅在任务确实需要时才做。
不能做的部分官方说得很具体:没有删除数据库的工具;读查询的工具不能被用来夹带一次修改;明确的 DROP DATABASE 或 TRUNCATE 会被本地 hook 在执行前拦下。所有操作都跑在用户自己的 CockroachDB Cloud 权限之下,不会超过用户自己本来就能做的事。
安装有两种方式。最简单的是用 ChatGPT 与 Codex 共用的公共插件目录,开箱就有全部 34 个技能和 Cloud 连接。在 Codex CLI 里用的话,官方提供了开源包(GitHub 上的 cockroachdb/codex-plugin),可以连 CockroachDB Cloud,也可以连自己的自建集群——自建集群走 Toolbox,默认只读,除非你自己改。可选的本地 hook 会检查你编辑的 SQL 与应用文件里的常见问题,启用之前官方建议先读一遍。
五、这套做法能复制到什么程度
厂商把“哪些细节要紧”公开成一份可安装的技能包,本质上是把自己的工程经验变成了可分发的资产。对其他数据库厂商来说,这比多写几篇博客更直接:博客里的判断留在读者脑子里,技能包里的判断则会在每次评审时被调用一次。
这条路径的成本也看得见。技能要覆盖真实故障模式,意味着厂商得把自己的排障经验一条条整理出来并持续维护;连接要给出足够上下文,意味着得接受 agent 以只读方式查看真实环境。这两件事都不轻松,但比让用户去读几十页文档然后自己总结要省事得多。
但它能不能替掉一位资深工程师,取决于三件事:技能是否覆盖了真实故障里会遇到的那类问题;连接给出的上下文是否足以让判断落到具体改动上;权限边界是否让一次错误在造成影响之前被拦住。
这三点都可以验证,而且成本不高。拿一个自己线上真实存在的慢查询,把 EXPLAIN 计划、表结构、索引和行数都给它,看它给出的第一步改动能不能被测。如果它只能给出“加个索引”这种无法证伪的建议,说明技能没拿到现场上下文;如果它能指出“这个过滤条件与索引前缀不匹配”,并要求你在同样负载下重跑对比,那就是真的在用证据。
一个更实用的判断标准,是看它敢不敢拒绝给出答案。官方在迁移场景里强调“什么能证明目标端完整且健康”,在诊断场景里强调“有证据支持才保留改动”。这种把“无法判断”显式说出来、而不是硬凑一个结论的倾向,才是技能包和提示词模板之间真正的分界。
 发表于 4 小时前
|
查看: 1|
回复: 0
 /1


