过去要让一个 AI 应用“记得住”,每个团队都得自己拍板:记忆存在哪、存多久、什么时候该被忘掉。这三件事没有标准答案,于是每家都写了一套定时清理任务和一套向量检索。MongoDB 在 2026 年 11 月 5 日开源发布的 Vercel AI SDK 集成,给出的做法是把这套决定直接做进包里:记忆被拆成五类,每类自带默认过期规则,保留策略有四种可选,用户说“忘掉这条”时模型自己就能删。
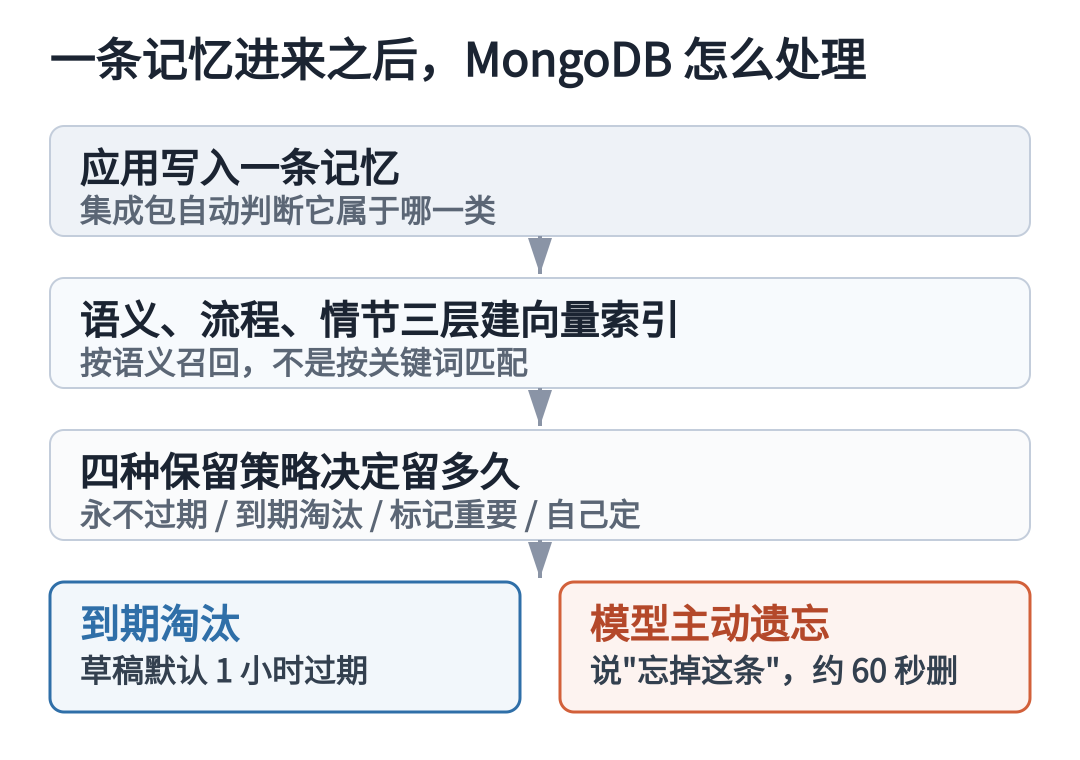
一、记忆为什么不能只存一张表
集成包 @mongodb-developer/vercel-ai-memory 的出发点是 Vercel AI SDK 的能力边界。Vercel AI SDK 是个 TypeScript 工具包,负责调用模型、流式返回、调用工具、跑多步任务,但它不带任何跨运行的记忆存储。没有记忆,应用每次对话都从零开始:不知道用户是谁,不知道昨天问过什么,也不知道上一轮学到的东西。
官方的描述很直白:开发者本来得自己搭这一层,通常意味着设计一套数据库结构、写清理旧数据的任务、再搭一套向量检索,好让应用能按语义而不是关键词找到以前的信息。这三样都不难,但每一样都会成为线上事故的来源——清理任务漏跑、旧数据在检索里飘着、向量库和业务库对不上账。
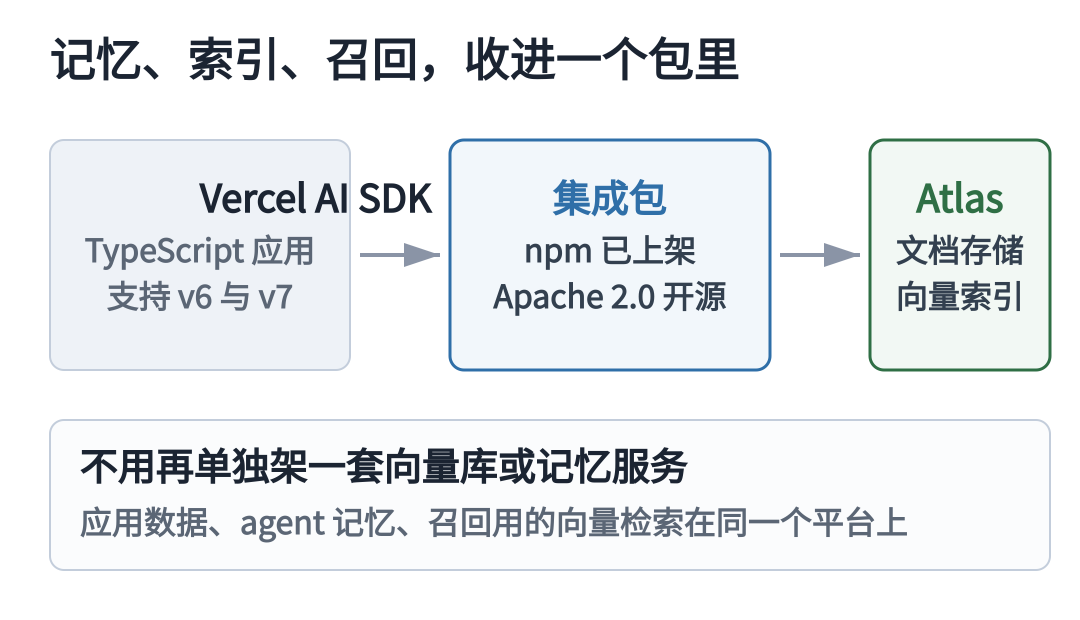
这个集成的做法是把三样一起收进 MongoDB Atlas:记忆按文档存、需要语义召回的那几层自动建向量索引、过期由保留策略处理。
官方的框架也值得记一下:一个 AI 应用需要五种记忆,每种保存时长不同、召回方式也不同。这个说法把“记忆”从一个笼统概念拆成了可以分别设计的五个部件,也让“该保留多久”这个问题有了对应的答案位置——每类记忆各自带着自己的过期规则,而不是所有记忆共用一个清理周期。
二、五类记忆,五套生命周期
官方把记忆分成五类,每类的用途、默认寿命、召回方式都不一样。
两个容易被忽略的细节是版本与提升。Semantic 与 Procedural 两类是带版本的:事实被改写时保留历史,模型看到的不只是最新的一条,可以判断一条偏好是刚改的还是老早就定了。Scratchpad 到期不等于直接丢弃,官方设计里它可以被提升为 Episodic,这正好对应“工作中试出来的一条经验值得长期记住”这个场景。
三、四种保留策略,与模型主动遗忘
保留策略是一组开关,每类记忆都能单独配:
none:永不过期。ttl:到设定时间就过期。ttl + importance:到时间也先不删,除非这条被标记为不重要。dynamic:自己定义遗忘期。
官方对为什么要做这组开关给出的解释是一个取舍:记忆留得越久,检索成本越高;删得太早,应用就忘了本该记住的上下文。这四种模式覆盖了从“永久保留”到“按业务自己定义”的区间。
集成包对每一类记忆都给出了默认配置,开发者可以逐类覆盖。这一点比“给一个全局保留天数”要实用得多:会话记忆和情节记忆的生命周期本来就不该是同一个数量级,用一个开关管全部,代价要么是会话留太久拖慢召回,要么是情节被清太早丢掉了真正有价值的经历。
另一条路径是模型主动遗忘。集成暴露了 memory_forget,当用户说“忘掉这条”时,模型可以删掉指定的一条记忆,官方给的删除时延通常约 60 秒。这条能力的存在意味着隐私诉求不必等到过期策略自然淘汰——用户明确表达的删除意图可以在几秒内落地。
四、召回路径:哪三层走向量检索
五类记忆里,Semantic、Procedural、Episodic 三层使用 MongoDB Vector Search,召回靠语义匹配而不是关键词精确匹配;Session 与 Scratchpad 走普通查询。
向量索引不需要用户手工建:集成在启动时自动创建索引并探测嵌入维度。嵌入模型也不绑定,官方列出 Voyage AI、OpenAI、Cohere、Google 都可以用,用哪个由应用传入的嵌入模型决定。
五、生产环境里必须改的三处
集成包给了三处面向生产的调整,官方逐条列了出来。
第一处是会话记录。默认情况下由模型自己决定什么时候保存、什么时候读取对话轮次,偶尔会漏。生产环境应该改用 AI SDK 的 hook,让应用自己的代码在每一轮都加载和保存记录,保证用户、助手、工具的每条消息都恰好存一次。
第二处是租户隔离。给向量索引加一个过滤字段(比如 tenant_id),就能把一次检索限制在单个客户的记忆范围内。官方用的词是“按客户分开数据”,做法就是在索引上加过滤字段。
第三处是命名与索引裁剪。集合和索引可以改名以贴合已有应用的结构,也可以直接关掉用不到的那几类记忆的索引——这在只需要会话和语义两类记忆的应用里能省下可观的存储与维护成本。
这三处调整的共同点是:默认值对原型够用,对生产不够。原型的场景是“先跑起来看看”,生产的场景是“多租户、每轮都不能丢记录、索引不能白占存储”。官方把这些开关放在集成包而不是文档里,意味着升级到新版本不会丢掉这些设置。
接入方式是三步:npm install @mongodb-developer/vercel-ai-memory ai mongodb,用 Atlas 连接串加嵌入模型创建 memory 实例,再把 memory 工具按用户和会话作用域挂到应用上。集成支持 AI SDK v6 与 v7,需要一个 MongoDB Atlas 集群,包本身采用 Apache 2.0 协议。
这套设计真正的落点,是把应用数据、agent 记忆和召回用的向量检索放进同一个平台。不必再单独架一套向量库或记忆服务,也不用维护把它们同步起来的管道,出问题时也不存在“三套数据对不上”的排查现场。
一个可以拿去验证的判断是:这套东西的价值不在于少写多少代码,而在于“记忆什么时候该被忘”从团队各拍各板变成了产品默认行为。但它的收益有前提——如果应用侧已经跑着一套自己的记忆服务,迁移的主要成本不是接包,而是把历史记忆按新的分类重新嵌入一遍,这一步的数据量和维度差异需要先算清楚再动手。对 Agent 记忆机制感兴趣的开发者,也可以在云栈社区找到更多相关讨论与实战分享。
 发表于 4 小时前
|
查看: 2|
回复: 0
 /1


