把 EmbeddingGemma 2 的权重文件下载到本地,转成 GGUF、量化到九个档位,逐档测试检索质量和处理速度。任务前缀怎么拼、多模态端点有哪些坑,也一并试了一遍。
测试环境
表 1 测试环境
| 项目 |
配置 |
| 系统 |
Windows 11 |
| 显卡 |
AMD RX 7900 XTX 24GB,gfx1100,Vulkan 后端 |
| 引擎 |
llama.cpp b11461,提交 4d756bc,win-x64-vulkan |
| Python |
3.13.14 |
| 模型 |
google/embeddinggemma-2,提交 914f7f8 |
| 评测集 |
NFCorpus,3633 篇文档、3237 条查询、323 条标注查询,nDCG@10 用分级增益 |
先说明评测口径。NFCorpus 是生物医学领域的检索数据集,323 条查询上有分级相关性标注,本文的分数就是这个口径下的 nDCG@10。数字看着不高是数据集本身难,跨数据集不能直接比大小。测速度用 llama-bench,每次跑三遍取平均。
转换没有损失
模型原始权重是 safetensors,官方转换脚本把文本部分的 413 个张量搬进 GGUF。为了确认没搬坏,把两边逐个张量对了一遍账。
表 2 文本张量对账(共 413 个)
| 类别 |
数量 |
说明 |
| 字节级全等 |
219 |
全部权重矩阵,含 token_embd(262144×512),SHA256 完全一致 |
| BF16 精确提升到 F32 |
194 |
norm、layer_scalar 这类,左移 16 位的 F32 位模式与 BF16 完全对应 |
| 真实数值差异 |
0 |
无 |
token_embd 是词嵌入那张大表,1.34 亿个元素,SHA256 是 56ebbdb 开头的那串,两边一模一样。194 个 norm 张量从 BF16 提到 F32 不是误差,是精度反而更高,因为 BF16 存 F32 时本来就只留了高 16 位。整个 GGUF 的张量总数是 1376,等于文本的 413 加视觉投影的 963,一个都没漏。转换这一步可以放心。
量化到哪一档,检索分才掉
文本部分可以继续量化,从 BF16 起了 Q8_0、Q6_K、Q5_K_M、Q5_K_S、Q4_K_M、Q4_K_S、Q4_0、IQ4_XS、Q3_K_M 九个档,每档都在 NFCorpus 上测检索。视觉投影那部分不能量化,后面单独说。
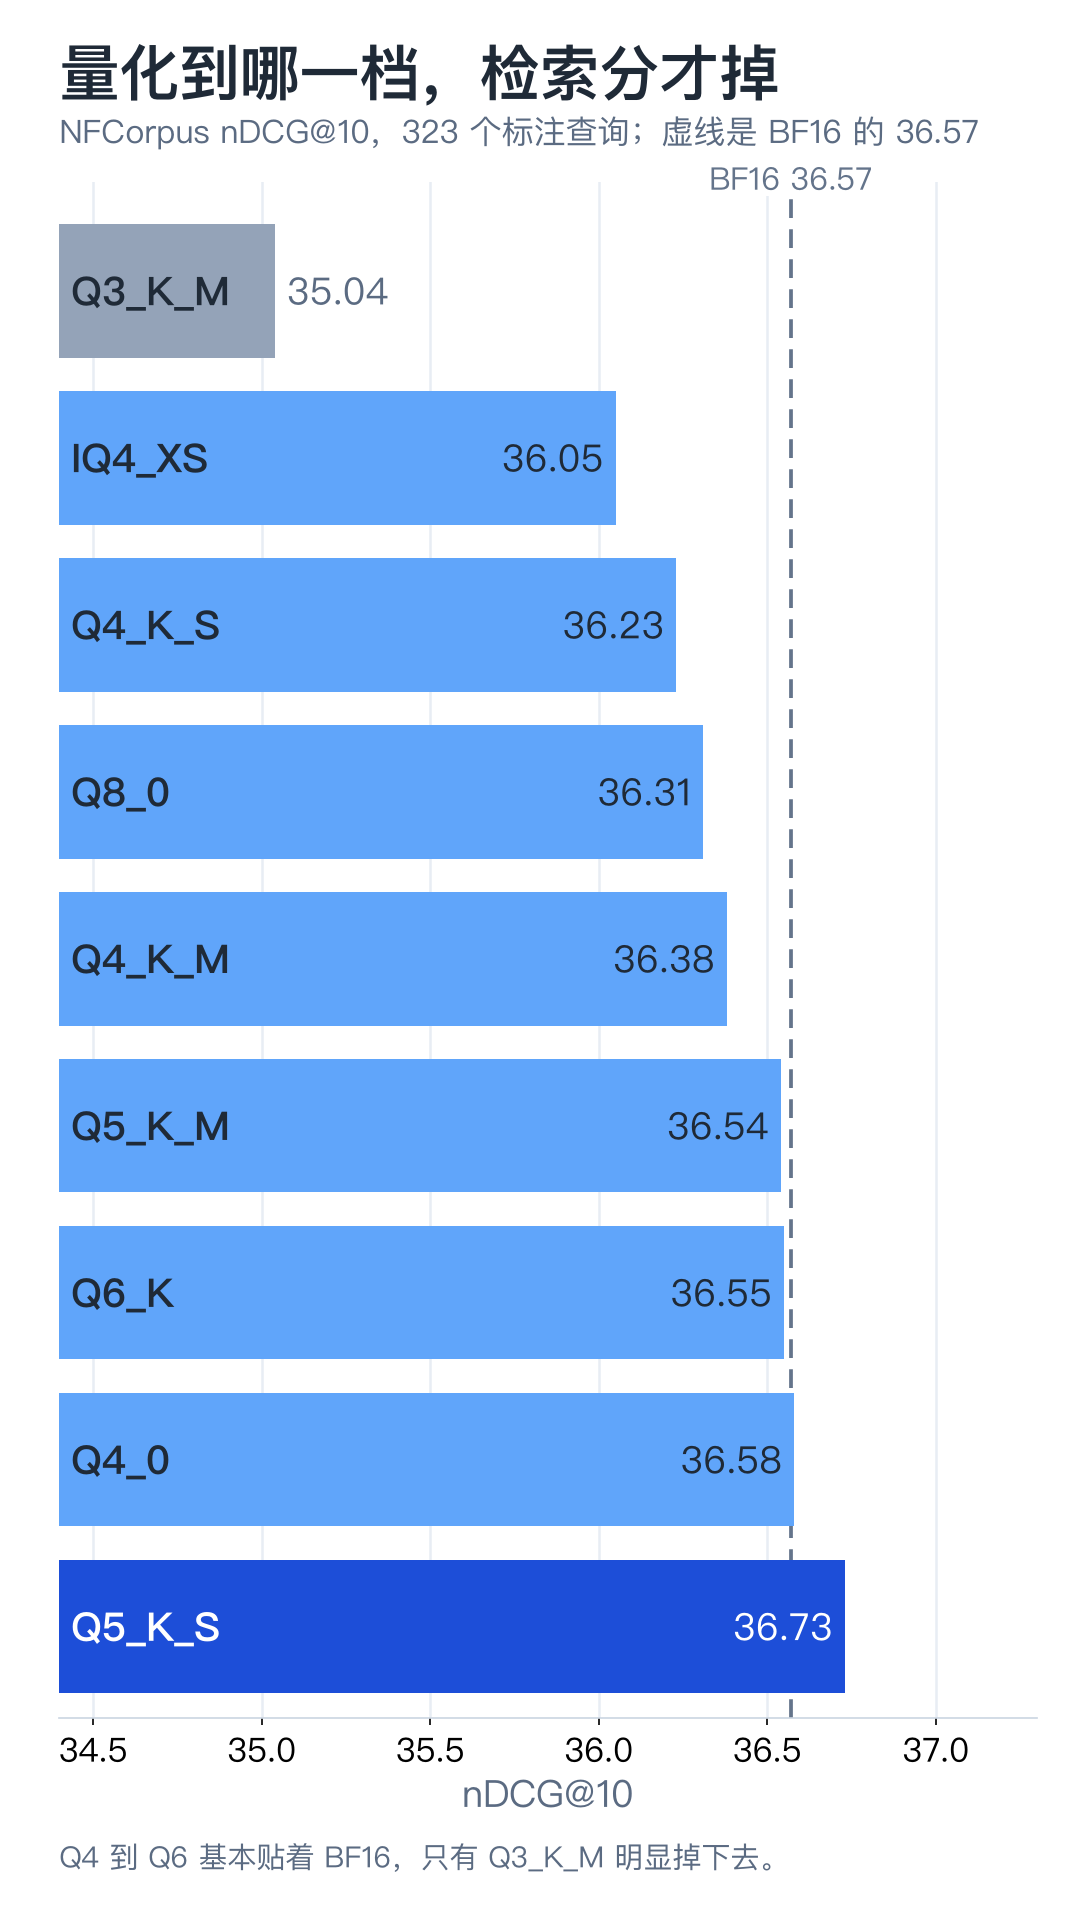
图 1 量化到 Q6 之前,检索分基本贴着 BF16,只有 Q3_K_M 明显掉下去。
表 3 量化矩阵(NFCorpus,带任务前缀)
| 量化 |
体积 |
nDCG@10 |
MRR@10 |
Recall@10 |
Recall@100 |
余弦均值 |
top-10 重合 |
| BF16 |
532.1MB |
36.57 |
57.00 |
17.80 |
35.80 |
— |
— |
| Q8_0 |
295.5MB |
36.31 |
56.32 |
17.78 |
35.90 |
— |
— |
| Q6_K |
234.4MB |
36.55 |
56.33 |
17.98 |
35.93 |
0.99907 |
0.938 |
| Q5_K_M |
202.9MB |
36.54 |
56.54 |
17.42 |
35.86 |
0.99725 |
0.8895 |
| Q5_K_S |
200.9MB |
36.73 |
56.84 |
17.96 |
36.04 |
0.99670 |
0.881 |
| Q4_K_M |
173.3MB |
36.38 |
57.39 |
17.83 |
34.94 |
0.99149 |
0.8125 |
| Q4_K_S |
169.9MB |
36.23 |
56.79 |
17.72 |
34.91 |
0.98903 |
0.814 |
| Q4_0 |
169.4MB |
36.58 |
57.42 |
17.69 |
34.84 |
0.98498 |
0.7735 |
| IQ4_XS |
162.0MB |
36.05 |
56.63 |
17.35 |
35.03 |
0.98943 |
0.8155 |
| Q3_K_M |
142.0MB |
35.04 |
56.03 |
16.67 |
33.01 |
0.97658 |
0.696 |
看两个地方。体积从 BF16 的 532MB 降到 Q4_K_M 的 173MB,少了三分之二,分数却从 36.57 只降低到 36.38,差别落在这批查询本身的波动范围里。九个档里最高的是 Q5_K_S 的 36.73,比 BF16 还高一点点,但这大概就是误差了。真正掉下去的是 Q3_K_M,nDCG 掉到 35.04,和前十个检索结果的重合率只有 0.696,也就是排出来的东西有近三成和 BF16 不一样,这个档就别用了。
速度不是选型理由
同一个 NFCorpus 向量库,用不同量化档处理 2048 token 输入,吞吐几乎一样。
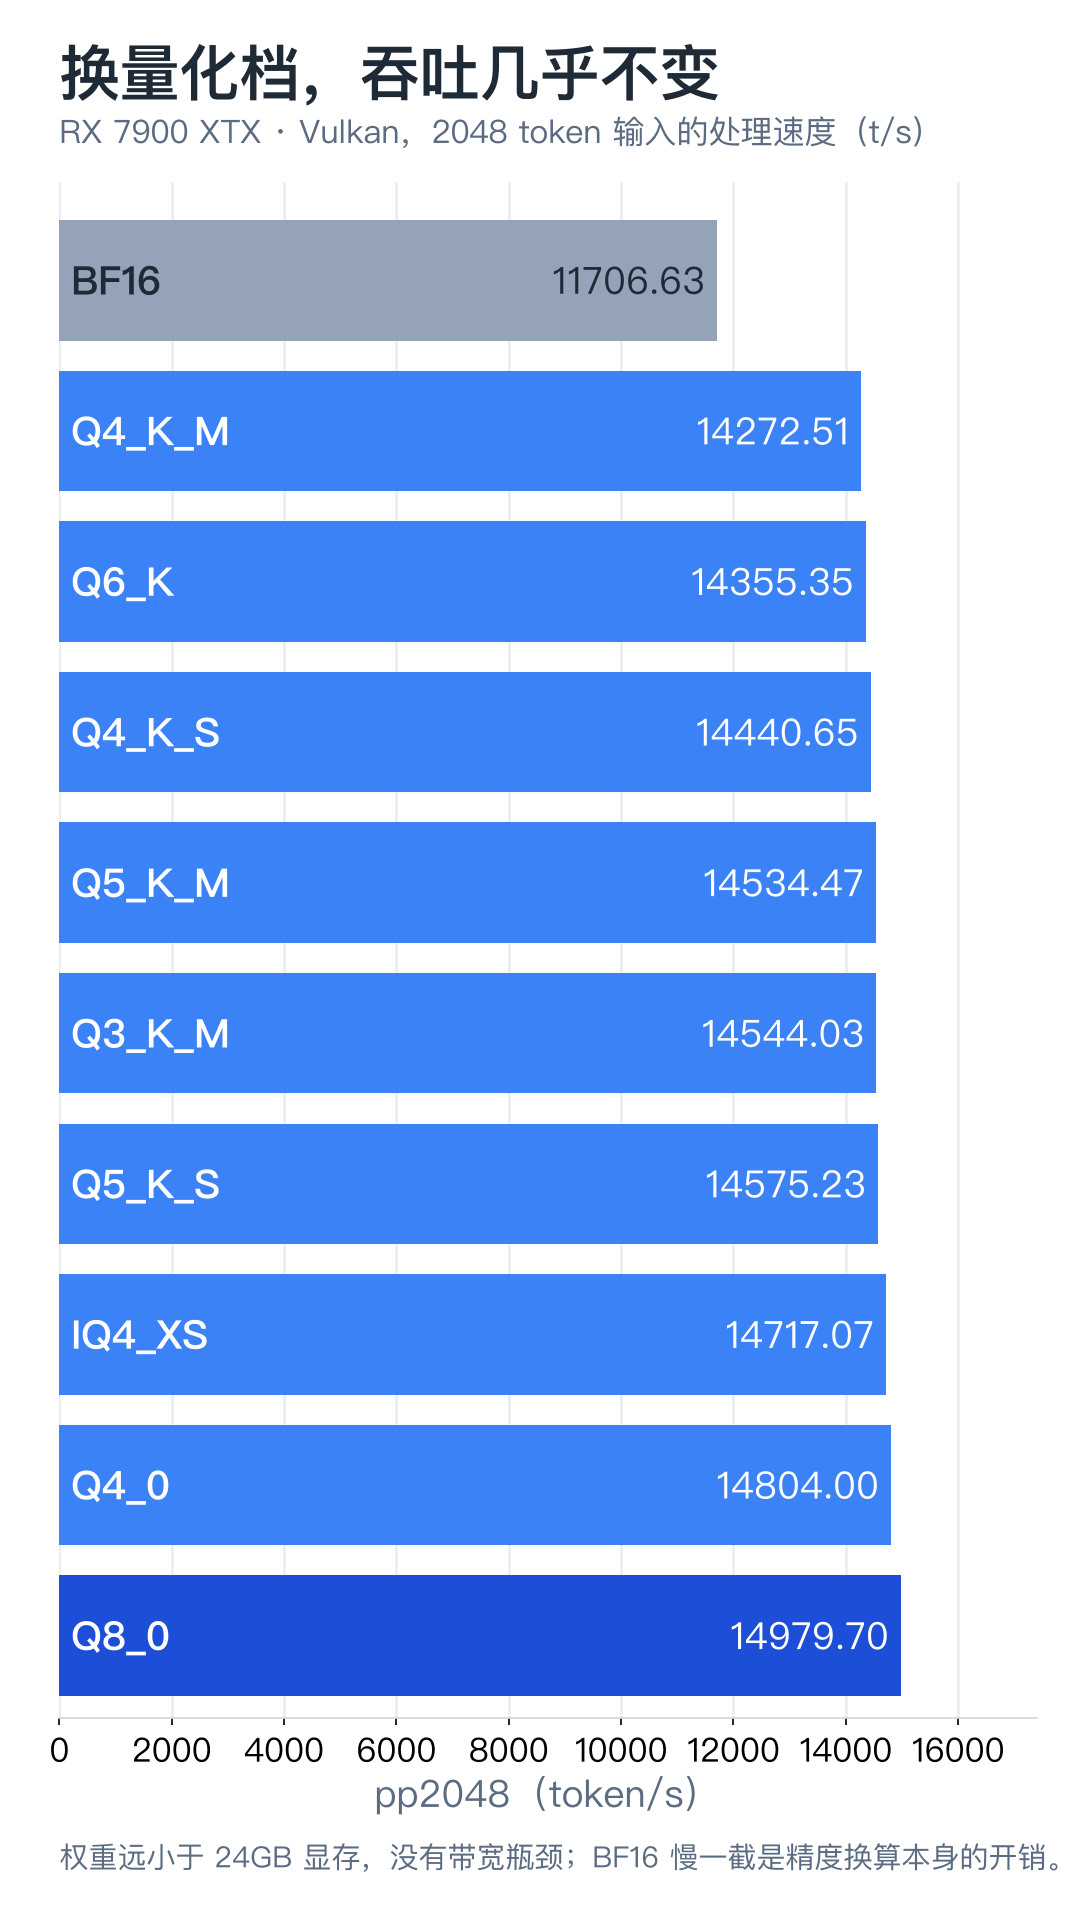
图 2 换量化档,2048 token 输入的处理速度几乎不变。
除了 BF16 的 11706 t/s,其余九档都挤在 14273 到 14980 t/s 之间,最快的 Q8_0 和最慢的 Q4_K_M 差不到 5%,这个差距还在测量噪声里。更短的序列更快,512 token 时能到 2.6 万到 3 万 t/s;拉到 8192 token 掉到 4000 到 4400 t/s,这是注意力随长度平方增长的正常表现。
权重体积远小于这块卡的 24GB 显存,压根碰不到显存带宽瓶颈,所以选哪一档对速度没影响,只影响质量和占用的存储。BF16 慢一截,是因为它每层都要把 BF16 转成 F32 再算,这个换算开销是它独有的。
测试时 Q4_0、Q4_K_S、Q4_K_M 三档的 pp512 出现过 3000 到 6000 t/s 的大幅波动,查下来是当时别的东西在抢 GPU,换了空闲端口单独复跑,Q4_K_M 的检索分和第一次完全一致,是 36.38,数据没被污染。
向量像不代表检索好
量化的直接后果是向量和 BF16 有了微小偏差,用余弦相似度和 top-10 重合率衡量。直觉上越像分数越高,实际不是这么回事。
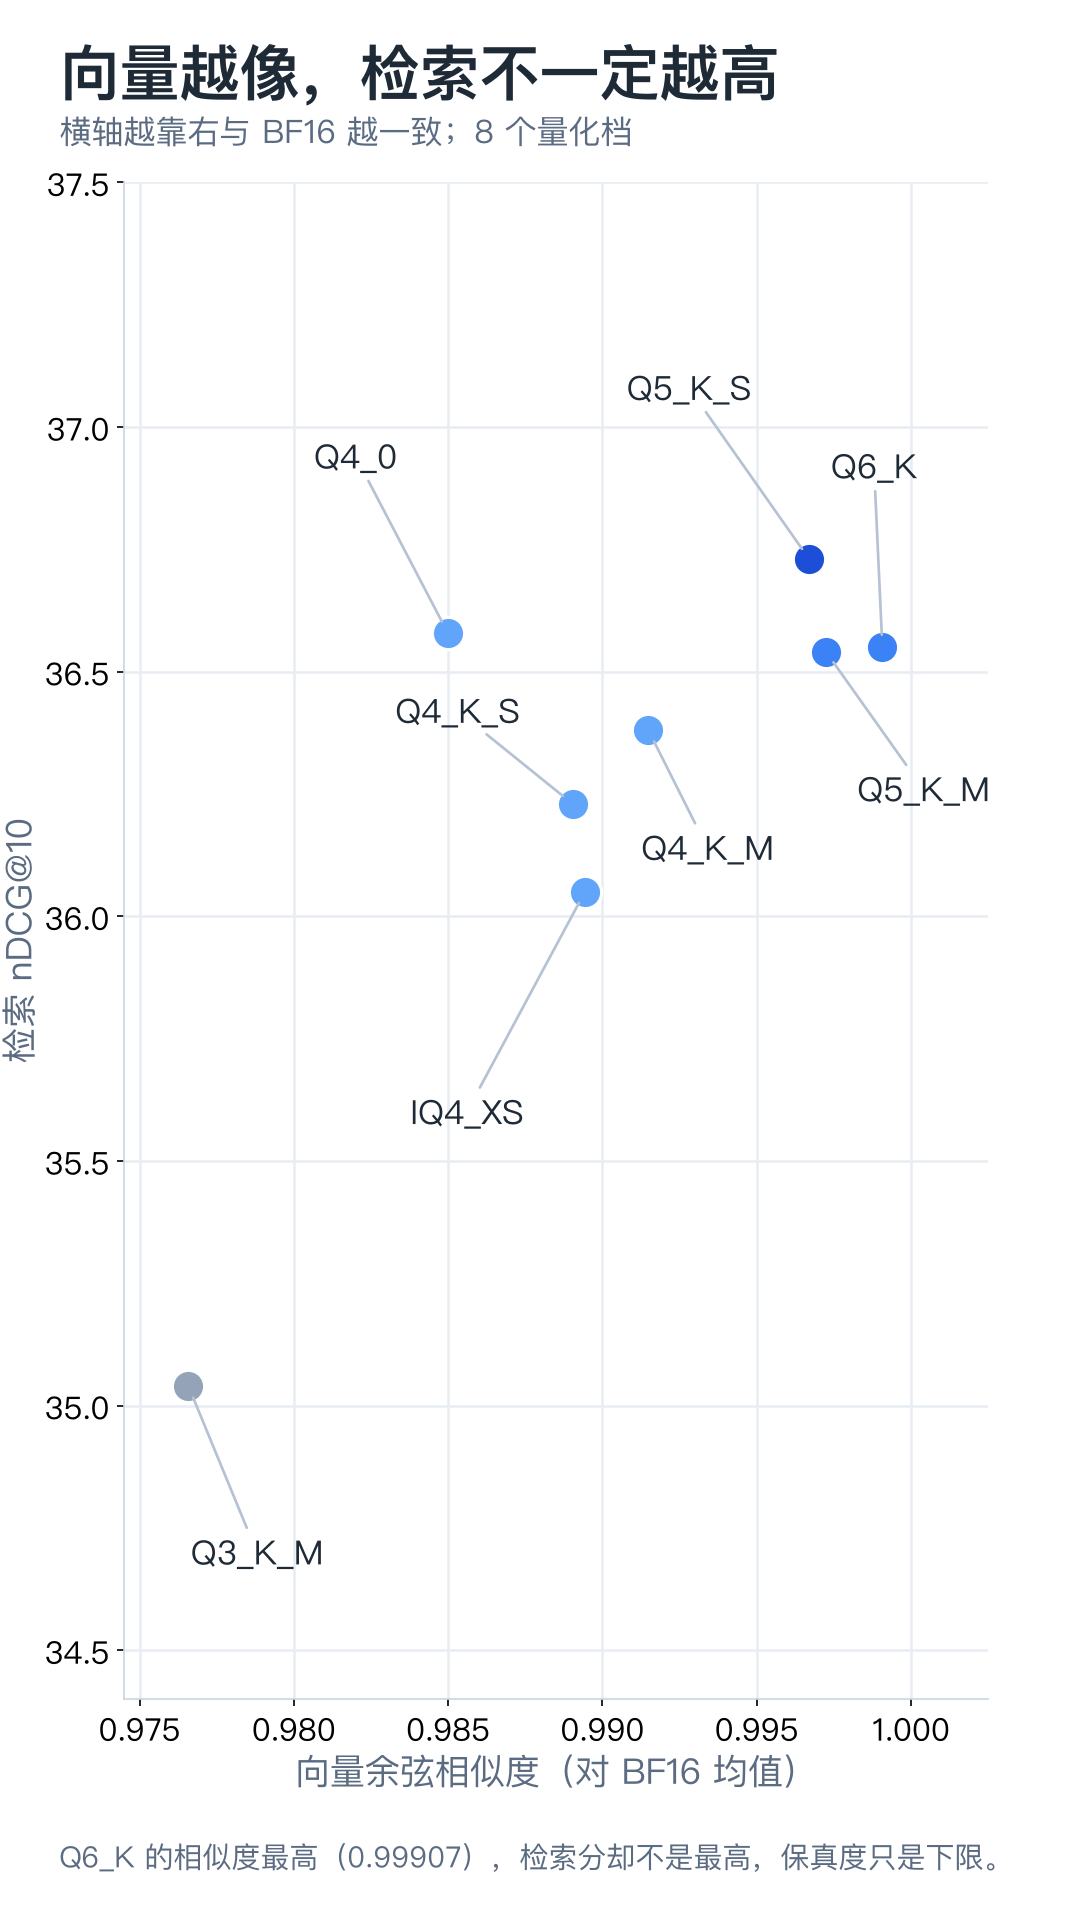
图 3 向量与 BF16 越接近,检索分不一定越高;Q6_K 相似度最高,分数却不是最高。
Q6_K 的余弦相似度最高,0.99907,但它的 nDCG 只有 36.55,排在中游;Q5_K_S 的相似度是 0.99670,分数反而最高。反过来看 Q3_K_M,相似度 0.97658 掉得明显,检索分跟着掉,这一档是真的伤了。大致规律是余弦到 0.989 以上(约等于 Q4_K_S)检索就稳定,再往上加精度收益很小。保真度只是条底线,不是成绩单。
和四个基线横评
同一台机器、同一套 NFCorpus,把几个常见的开源嵌入模型放在一起跑。
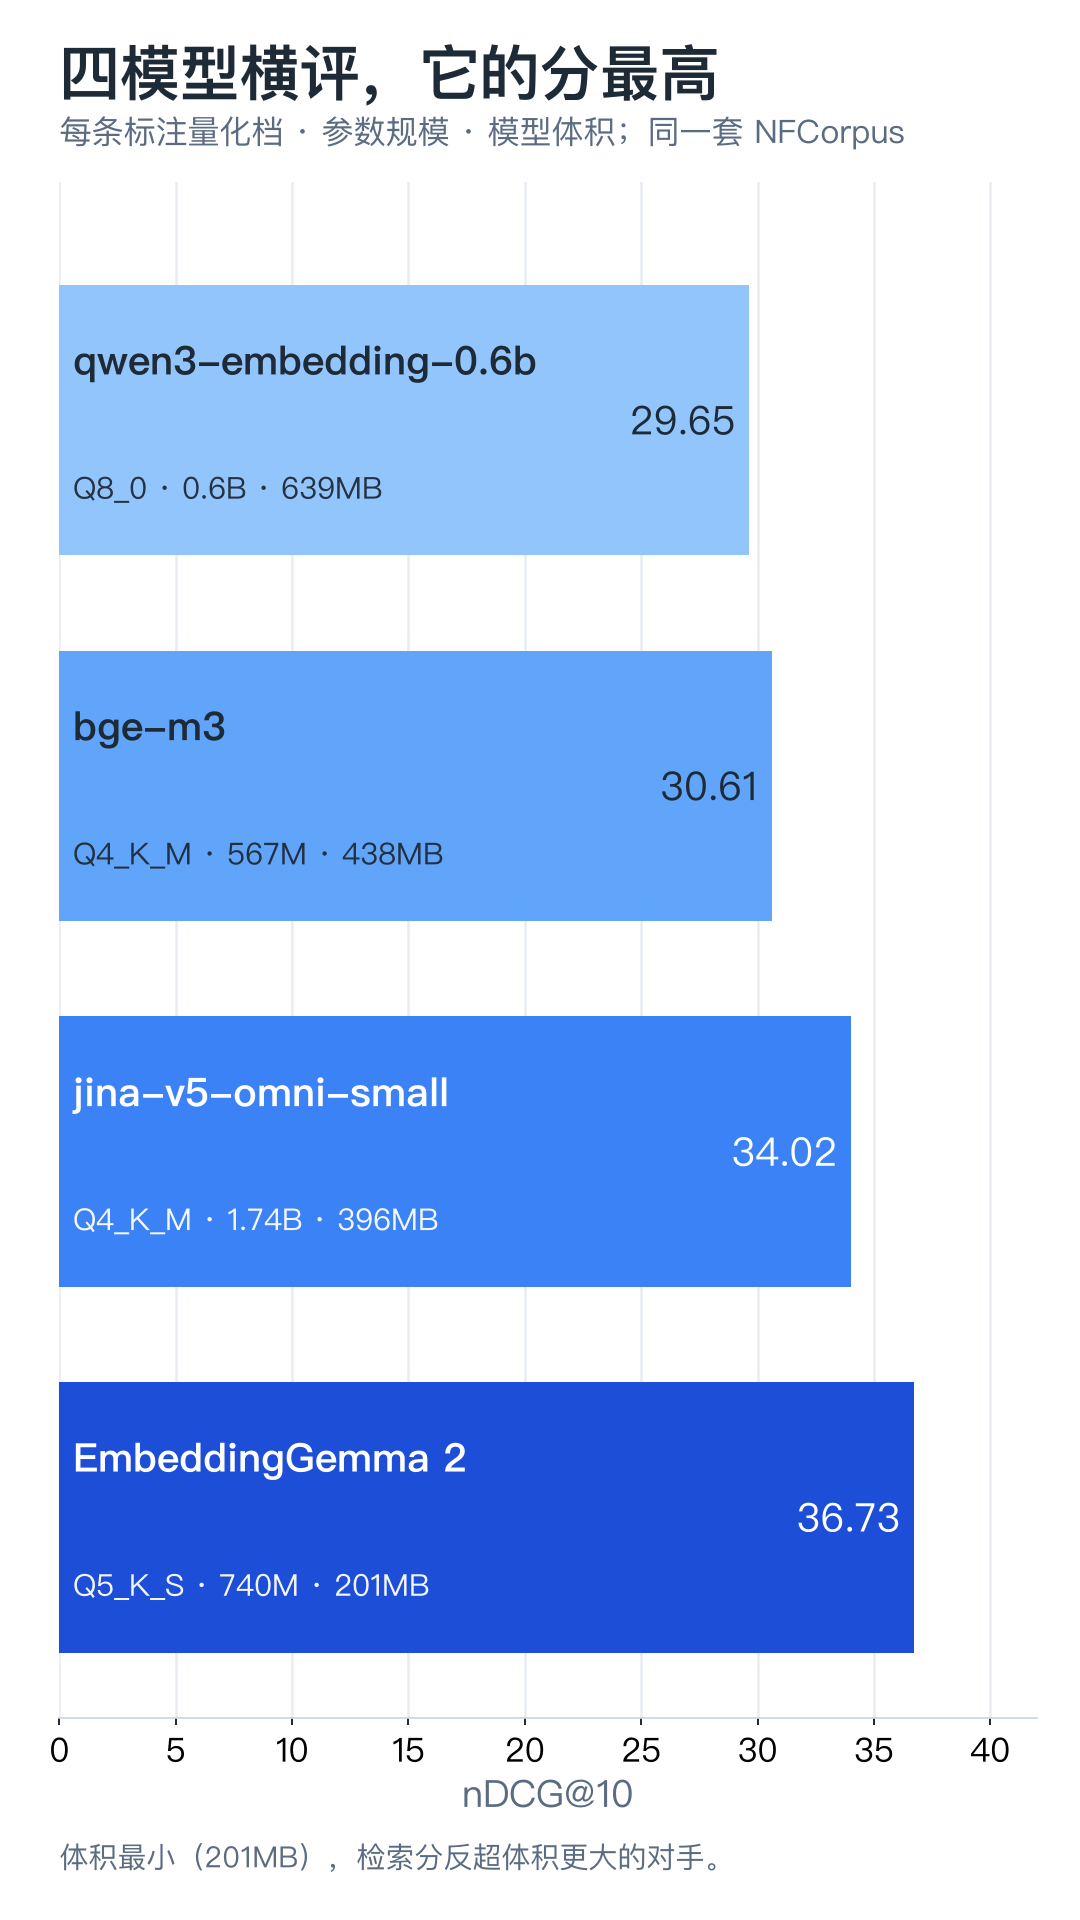
图 4 四个模型的 nDCG@10,条上标了量化档、参数量和体积。
表 4 横评明细
| 模型 |
参数 / 体积 |
维度 |
nDCG@10 |
MRR@10 |
Recall@10 |
Recall@100 |
P@1 |
| EmbeddingGemma 2(Q5_K_S) |
740M / 201MB |
768 |
36.73 |
56.84 |
17.96 |
36.04 |
47.68 |
| jina-v5-omni-small(Q4_K_M) |
1.74B / 396MB |
1024 |
34.02 |
53.57 |
16.51 |
33.58 |
44.58 |
| bge-m3(Q4_K_M) |
567M / 438MB |
1024 |
30.61 |
51.12 |
14.34 |
27.09 |
42.41 |
| qwen3-embedding-0.6b(Q8_0) |
0.6B / 639MB |
1024 |
29.65 |
47.61 |
14.47 |
31.15 |
36.84 |
这一组里 EmbeddingGemma 2 的体积最小,201MB,维度也最低,768,检索分却最高,把体积更大的三个都压下去了。jina-v5-omni-small 整模 1.74B、量化后 396MB,大约它的两倍重,分却低了 2.7。MRR、Recall、P@1 这几项上 EmbeddingGemma 2 也都靠前,不是只赢了一个指标。这几个基线全部走量化 GGUF,条件一致。
前缀用错,分数会掉
嵌入模型对输入前缀很敏感,EmbeddingGemma 2 尤其明显。同一个 Q8_0 权重,换三种前缀写法,分数差出一大截。
表 5 任务前缀对检索分的影响(Q8_0)
| 文档写法 |
nDCG@10 |
title: 真实标题 \| context: 正文 |
36.31 |
title: none \| text: 正文 |
35.30 |
| 不加前缀,标题拼正文 |
34.43 |
官方推荐文档按 title: 标题 | text: 正文 拼、查询按 task: search result | query: 问题 拼,这一档拿了最高分。官方默认的 title: none 写法掉了 1 分,完全不加前缀再掉一分。前缀不是锦上添花,用错就是实打实掉分。
多模态端点有个坑
模型带视觉和音频编码器,但怎么调用很讲究,用错接口会静默出错。
表 6 图像、音频在不同端点上的行为
| 输入 |
旧版 /embedding |
/v1/embeddings(content 格式) |
| 文本 |
正常 |
正常 |
| 图像 |
静默忽略,返回的向量和空输入完全一样 |
生效,448×448 约 83 token、512×512 约 123 token |
| 音频 |
静默忽略 |
生效,440Hz 一秒约 29 token,不同频率的向量能区分到余弦 0.956 / 0.911 |
旧版 /embedding 接口收到 image、audio 字段不会报错,直接当没看见,返回的向量和空输入一模一样,余弦是 1.0。要真正编码图像和音频,得走 /v1/embeddings 的 content 格式。音频目前在 llama.cpp 里还是实验状态,官方也标了可能掉质量,正经用之前得自己拿数据验。
怎么用,选哪档
最省事的一条路是 Ollama,官方库已经把这个模型上架了,一条命令就能拉。模型刚发布那几天 Ollama 上还没适配,现在库里已经有了。
ollama pull embeddinggemma-2
库里有四个标签,正好对应文本主干加不同编码器的组合,按要用的模态选。
表 7 Ollama 上的标签
| 标签 |
大小 |
加载的编码器 |
页面标注的输入 |
| embeddinggemma-2:270m |
378MB |
仅文本 |
文本 |
| embeddinggemma-2:440m |
714MB |
文本 + 视觉 |
文本、图像 |
| embeddinggemma-2:570m |
990MB |
文本 + 音频 |
文本 |
| embeddinggemma-2:740m(latest) |
1.3GB |
全模态 |
文本、图像 |
默认的 latest 指向 740m,上下文标到 256K。有一点要留意,Ollama 页面上的输入一栏只写了文本和图像,没列音频,想在本地喂音频大概率还是得走下面的 llama.cpp。
不想依赖 Ollama,自己用 llama.cpp 跑也不复杂。量化从 BF16 源起,服务端开 8192 的物理批,评测和测速分开跑:
export GGML_VK_VISIBLE_DEVICES=1

llama-quantize embeddinggemma-2-BF16.gguf embeddinggemma-2-Q5_K_S.gguf Q5_K_S

llama-server -m embeddinggemma-2-Q5_K_S.gguf \
    --mmproj mmproj-embeddinggemma-2-Q8_0.gguf \
    --embedding -b 8192 -ub 8192 --port 8080

llama-bench -m embeddinggemma-2-Q5_K_S.gguf -p 512,2048,8192 -n 0 \
    -b 8192 -ub 8192 -d 8192 -r 3
选档看用途。要最高检索分、存储也不紧,用 Q5_K_S,200MB。想再省一点存储、分数几乎不差,Q4_K_M 更划算,173MB,36.38。要保真度最高、方便以后复算,用 Q6_K,余弦 0.99907。Q3_K_M 别碰,142MB 省出来的那点空间,换的是 top-10 里近三成结果变了样。
权重这么小、速度这么快,一块十年前的普通显卡,甚至纯 CPU 和 Mac 统一内存,都能跑得动。对想做本地 RAG、又不想把文档发到云端的人来说,这是个门槛很低的选项。
几个踩到的坑
表 8 踩坑记录
| 现象 |
原因和办法 |
| 量化视觉投影直接崩 |
llama-quant.cpp:1365 断言失败,卷积层通道数 ncols%256≠0,mmproj 不能量化,保持原始精度加载 |
| Q8_0 文件无法再量化 |
llama-quantize 拒绝从已量化文件 requantize,要换档得从 BF16 源重新起 |
| 文档一长服务就返回 500 |
物理批大小必须不小于最长文档的 token 数,起服务时把 -b 和 -ub 都设到 8192 才稳 |
参考链接
[1] google/embeddinggemma-2 模型卡(Hugging Face) https://huggingface.co/google/embeddinggemma-2
[2] ggml-org/embeddinggemma-2-GGUF(官方 GGUF) https://huggingface.co/ggml-org/embeddinggemma-2-GGUF
[3] NFCorpus 评测集(MTEB) https://huggingface.co/datasets/mteb/nfcorpus
[4] llama.cpp 仓库 https://github.com/ggml-org/llama.cpp
[5] llama.cpp 音频输入讨论 https://github.com/ggml-org/llama.cpp/discussions/13759
[6] Ollama:embeddinggemma-2 库页 https://ollama.com/library/embeddinggemma-2
[7] ModelScope(魔搭)google/embeddinggemma-2 https://www.modelscope.cn/models/google/embeddinggemma-2
本文数据来自 2026 年 10 月 8 日在 RX 7900 XTX 上的本地测试,模型、引擎与数据集都可能更新,请以各自官方页面为准。
 发表于 2 小时前
|
查看: 11|
回复: 0


