这是「Go × AI 应用开发」系列第 4 篇。上一篇我们用 200 行标准库 Go 写了一个最小 Agent 循环。但 Agent 再会调工具,也只能调用你提前写好的函数;它不知道你的私有知识。要让 Agent 基于你的文档回答,先得把「检索」做对——这就是 RAG 的上半场。
最近在整理一个内部 RAG 项目时,我发现一个被严重低估的事实:大部分"答非所问",不是大模型不行,而是检索阶段召回的文档就是错的。资料已经错了,模型只能照着错的编。
比如用户问:"我们线上 goroutine 泄漏怎么排查?" 结果向量检索返回的第一条是"向量数据库如 Milvus 和 Qdrant 专门存储和检索高维向量",模型就算再强,也只能在那上面硬憋一个回答。
所以今天我不引任何框架,用纯标准库 Go 从零写一个向量检索,把 Embedding 到底是什么、相似度到底比的是什么、RAG 上半场到底怎么做,一次讲透。
一、问题到底是什么
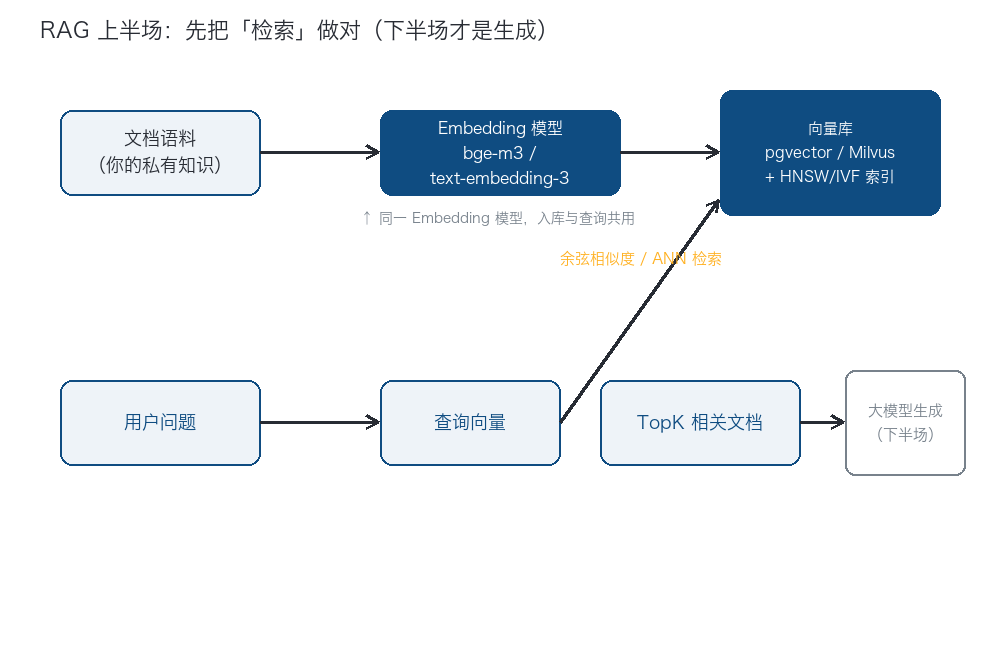
RAG(Retrieval-Augmented Generation)常被简化成"先搜再生成"。但生成只是下半场,上半场是检索。检索失败,下半场免谈。
向量检索的核心链路就三步:
- 把文本转成向量(Embedding);
- 用某种相似度度量在向量库里找最近的 TopK;
- 把这 TopK 条资料喂给大模型。
问题可能出在任何一步。今天我们聚焦第一步和第二步:Embedding 与检索。只有理解它们,才能定位"召回不准"的根因。
二、先写一个最小 Demo
为了不依赖 API key 和外部模型,我用一个"教学用简化 Embedding":把文本按 n-gram 切分、做 TF-IDF 加权、哈希到一个定长向量,然后用余弦相似度做暴力检索。
这不是真实语义模型,但它能完整跑通"文本 → 向量 → 检索"链路。生产环境请换成 OpenAI text-embedding-3-small、智源 bge-m3 等真实模型。
下面是完整可运行的 Go 代码(Go 1.23,纯标准库,零第三方依赖):
// Go 最小向量检索 demo(Go 1.23,go run 即可,无需 API key)
//
// 教学用「简化 embedding」:基于 n-gram hashing + TF-IDF,把文本变成定长向量。
// 它是确定性的、可离线运行,让整条「文本 -> 向量 -> 检索」链路能本地跑通。
// 生产环境请换成真实 embedding 模型(OpenAI text-embedding-3-small / bge-m3 等),
// 存储与检索请换成 pgvector / Milvus / Qdrant,并上 ANN 索引。
package main

import (
"fmt"
"hash/fnv"
"math"
"math/rand"
"sort"
"strings"
"time"
"unicode"
)

const Dim = 512

// tokenize:英文/数字按「词」、汉字按「单字 uni-gram + 相邻 bi-gram」切分。
func tokenize(text string) []string {
text = strings.ToLower(text)
runes := []rune(text)
var tokens []string
var buf strings.Builder
flush := func() {
if buf.Len() > 0 {
tokens = append(tokens, "w:"+buf.String())
buf.Reset()
}
}
for i := 0; i < len(runes); i++ {
r := runes[i]
switch {
case unicode.Is(unicode.Han, r):
flush()
tokens = append(tokens, "u:"+string(r))
case unicode.IsLetter(r) || unicode.IsDigit(r):
buf.WriteRune(r)
default:
flush()
}
}
flush()
// 汉字 bi-gram
for i := 0; i+1 < len(runes); i++ {
if unicode.Is(unicode.Han, runes[i]) && unicode.Is(unicode.Han, runes[i+1]) {
tokens = append(tokens, "b:"+string(runes[i])+string(runes[i+1]))
}
}
return tokens
}

func hashIdx(t string) int {
h := fnv.New32a()
h.Write([]byte(t))
return int(h.Sum32()) % Dim
}

// embed:把文本映射成 L2 归一化的 Dim 维向量。
// idf 非空时做 TF-IDF 加权;idf 为 nil 时退化为纯 TF。
func embed(text string, idf map[string]float64) []float64 {
tf := map[string]float64{}
for _, t := range tokenize(text) {
tf[t]++
}
vec := make([]float64, Dim)
for t, c := range tf {
w := c
if idf != nil {
w *= idf[t]
}
vec[hashIdx(t)] += w
}
var norm float64
for _, v := range vec {
norm += v * v
}
norm = math.Sqrt(norm)
if norm > 0 {
for i := range vec {
vec[i] /= norm
}
}
return vec
}

// cosine:向量已 L2 归一化,点积即余弦相似度。
func cosine(a, b []float64) float64 {
var dot float64
for i := range a {
dot += a[i] * b[i]
}
return dot
}

type doc struct {
text string
vec  []float64
}

type Index struct {
docs []doc
idf map[string]float64
}

// NewIndex:先统计文档频率 DF,再算 IDF,最后把每篇文档向量化。
func NewIndex(corpus []string) *Index {
df := map[string]int{}
for _, c := range corpus {
seen := map[string]bool{}
for _, t := range tokenize(c) {
if !seen[t] {
df[t]++
seen[t] = true
}
}
}
n := float64(len(corpus))
idf := map[string]float64{}
for t, d := range df {
idf[t] = math.Log((n+1)/(float64(d)+1)) + 1
}
idx := &Index{idf: idf}
for _, c := range corpus {
idx.docs = append(idx.docs, doc{text: c, vec: embed(c, idf)})
}
return idx
}

type hit struct {
text string
score float64
}

func (ix *Index) Query(q string, topK int) []hit {
qv := embed(q, ix.idf)
hits := make([]hit, 0, len(ix.docs))
for _, d := range ix.docs {
hits = append(hits, hit{d.text, cosine(qv, d.vec)})
}
sort.Slice(hits, func(i, j int) bool { return hits[i].score > hits[j].score })
if topK > len(hits) {
topK = len(hits)
}
return hits[:topK]
}

func main() {
corpus := []string{
"Go 的 goroutine 泄漏通常发生在忘记关闭 channel 或者没消费完的时候",
"Go 的 channel 用于 goroutine 之间安全地传递数据",
"Go 的 context 用来在 goroutine 之间传递取消信号和超时控制",
"Go benchmark 用 testing 包的 Benchmark 函数测量 ns/op",
"Go 的 sync.Pool 可以复用临时对象从而减少 GC 压力",
"Go 的 GMP 调度模型决定了 goroutine 如何映射到操作系统线程",
"Go 的 http server 默认没有超时,生产环境需要手动设置",
"Go 的 pprof 可以用来做 CPU 和内存的性能分析",
"文本 embedding 模型可以把一句话变成高维向量,用于语义检索",
"向量数据库如 Milvus 和 Qdrant 专门存储和检索高维向量",
"余弦相似度衡量两个向量方向的接近程度,常用于文本匹配",
"RAG 把检索到的文档喂给大模型,让它基于资料回答而不是凭空生成",
}

q := "goroutine 泄漏怎么排查"
fmt.Println("Query:", q)
fmt.Println("--- 无 IDF(纯 TF)的召回,看错排 ---")
tfIdx := &Index{docs: nil, idf: nil}
for _, c := range corpus {
tfIdx.docs = append(tfIdx.docs, doc{c, embed(c, nil)})
}
for i, h := range tfIdx.Query(q, 3) {
fmt.Printf("  Top%d  score=%.4f  %s\n", i+1, h.score, h.text)
}

fmt.Println("--- 加 IDF 加权后的召回 ---")
ix := NewIndex(corpus)
for i, h := range ix.Query(q, 3) {
fmt.Printf("  Top%d  score=%.4f  %s\n", i+1, h.score, h.text)
}

fmt.Println()
rng := rand.New(rand.NewSource(42))
for _, n := range []int{10_000, 50_000, 100_000, 500_000} {
vecs := make([][]float64, n)
for i := 0; i < n; i++ {
v := make([]float64, Dim)
var norm float64
for j := 0; j < Dim; j++ {
v[j] = rng.NormFloat64()
norm += v[j] * v[j]
}
inv := 1 / math.Sqrt(norm)
for j := 0; j < Dim; j++ {
v[j] *= inv
}
vecs[i] = v
}
qv := make([]float64, Dim)
var qn float64
for j := 0; j < Dim; j++ {
qv[j] = rng.NormFloat64()
qn += qv[j] * qv[j]
}
inv := 1 / math.Sqrt(qn)
for j := 0; j < Dim; j++ {
qv[j] *= inv
}
start := time.Now()
var dummy float64
for _, v := range vecs {
dummy += cosine(qv, v)
}
fmt.Printf("暴力扫描 N=%d 条向量, 单次 Query 耗时=%v\n", n, time.Since(start))
_ = dummy
}
}
把上面存成 main.go,go run . 就能跑。零依赖、无 API key,但已经把"文本 → Embedding → 余弦相似度 → TopK 召回"全跑通。
三、跑一下看看
直接 go run .,输出分两部分。
第一部分是语义检索对比。我先演示不加 IDF 时错排,再加 IDF 后正确召回:
Query: goroutine 泄漏怎么排查
--- 无 IDF(纯 TF)的召回,看错排 ---
  Top1  score=0.1761  向量数据库如 Milvus 和 Qdrant 专门存储和检索高维向量
  Top2  score=0.1703  Go 的 goroutine 泄漏通常发生在忘记关闭 channel 或者没消费完的时候
  Top3  score=0.1485  Go 的 pprof 可以用来做 CPU 和内存的性能分析
--- 加 IDF 加权后的召回 ---
  Top1  score=0.2996  Go 的 goroutine 泄漏通常发生在忘记关闭 channel 或者没消费完的时候
  Top2  score=0.2324  Go 的 pprof 可以用来做 CPU 和内存的性能分析
  Top3  score=0.1442  向量数据库如 Milvus 和 Qdrant 专门存储和检索高维向量
对比很直观:没有 IDF 时,查询被一些高频词和短文档撞到了高处,把不相关的"向量数据库"排到了第一。加了 IDF 后,稀有词"goroutine""泄漏"权重被拉高,正确文档才浮上来。
第二部分是暴力扫描的 benchmark:
暴力扫描 N=10000 条向量, 单次 Query 耗时=1.773792ms
暴力扫描 N=50000 条向量, 单次 Query 耗时=6.132208ms
暴力扫描 N=100000 条向量, 单次 Query 耗时=12.221292ms
暴力扫描 N=500000 条向量, 单次 Query 耗时=61.13575ms
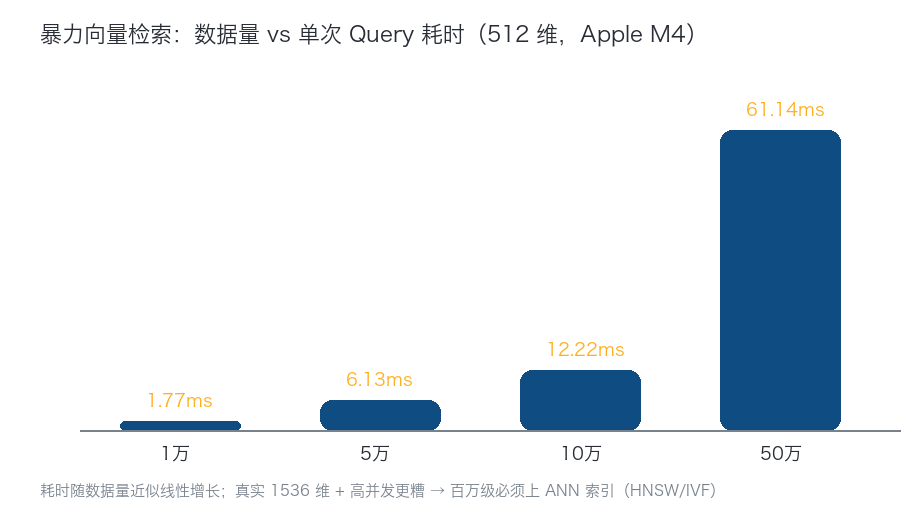
数据近似线性增长。10 万条单次查询 12ms 看着还能用,但 50 万条已经 61ms,而且还是 512 维、纯内存、单并发。真实场景里维度是 1536、有网络 IO、有并发,百万级暴力扫描基本不可用。
四、为什么会这样
不加 IDF 时错排,本质上是因为我们的简化 Embedding 给每个维度累加了 TF。短文档向量更"集中",长文档向量被 L2 归一化后摊平。结果短文档和几个高频词一碰撞,相似度就冒了上来。
IDF 做了两件事:
- 惩罚高频但信息量低的词(比如"的""Go""可以");
- 放大稀有但区分度高的词(比如"goroutine""泄漏""排查")。
真实 Embedding 模型内部已经做过类似处理(训练目标本身就包含"区分不同语义"),所以生产上不需要你手动算 IDF。但这个 Demo 说明了一个通用道理:检索质量取决于"谁能把真正相关的信号放大、把噪声压低"。
另外召回不准还有三个常见生产原因:
- 文档切块(chunking)不对:一个 chunk 塞进太多主题,Embedding 被稀释成"四不像"。
- Embedding 模型和领域不匹配:用通用模型搜法律/医疗/代码,相关专业词会被错误映射。
- 只看 Top3,没有重排:双塔 Embedding 召回快但精度有限,Top 50 里常常混入噪声。
五、Embedding 不是魔法:向量的本质
我对 Embedding 有三个判断:
第一,Embedding 不是"理解",它是一个确定性函数。 给定同一个模型,输入同样的文本,输出永远是一样的向量。它不会"思考",只是把文本映射到一个高维空间里的点。f("goroutine 泄漏") = [0.01, -0.05, ...],仅此而已。
第二,向量空间里的"近"只是统计相关性,不是语义等价。 余弦相似度高,只说明两个向量方向接近,也就是它们在该模型训练语料中经常以相似上下文出现。它不等于"两者可以互相替换"或"后者能回答前者的问题"。
第三,维度、模型、领域三者必须匹配。 不是维度越高越好。1536 维的 OpenAI 模型效果好,但存储和检索成本也更高;384 维的小模型体积小、速度快,但区分能力可能不足。领域专用场景,通用模型往往打不过领域微调模型。
六、生产环境怎么处理
Demo 能跑后,上生产至少需要想清楚这几件事。
1. Embedding 模型选型
| 场景 |
推荐 |
维度 |
备注 |
| 中英混合、通用 |
bge-m3 |
1024 |
支持多语言,开源可本地部署 |
| 纯英文、通用 |
text-embedding-3-small |
1536 |
便宜、API 方便 |
| 纯英文、成本敏感 |
nomic-embed-text |
768 |
轻量,可本地跑 |
| 代码/法律/医疗 |
领域微调模型 |
不等 |
通用模型在这些领域召回会差一截 |
中英混合场景不要用只训了英文的模型。我踩过的坑:用 OpenAI 模型搜中文技术文档,专有名词(如"errgroup""context cancel")召回精度明显比 bge-m3 低。
2. 向量库与索引
- 小规模、已有 PostgreSQL:直接用
pgvector 扩展,零新增组件。
- 中等规模、想自托管:
Qdrant 用 Rust 写,单机性能好,REST API 对 Go 友好。
- 大规模、多租户:
Milvus 是专门为向量检索设计的系统,功能最全。
ANN 索引主要有两类:
- HNSW:图索引,召回率高、查询快,但内存占用大、构建慢。
- IVF(倒排文件):把向量空间分区,查询时只搜部分分区,省内存但召回率略低。
pgvector 同时支持 ivfflat 和 hnsw,启动时根据数据规模和召回要求选。
3. 召回评估不能靠肉眼
生产上至少看两个指标:
- recall@K:正确答案在 TopK 里的比例;
- precision@K:TopK 里真正相关的比例。
"看起来前几个挺相关"不足以上线。建议准备 50~100 条人工标注的查询-文档对,作为回归测试集。
4. 切块与重排
chunk size 和 overlap 是调参重灾区。一般从 256~512 token 开始试,overlap 20% 左右。
召回后做两阶段检索是常见做法:
- 用轻量 Embedding 召回 Top 50;
- 用 cross-encoder(比如 bge-reranker)对这 50 条重排,取 Top 5 喂给大模型。
重排模型慢但精度高,只处理 50 条完全可以接受。
七、常见错误
- 把 Embedding 当黑盒,不复核召回结果。 上线前必须抽样看 TopK 是否真的相关。
- 数据量到几十万还线性扫描。 本文 benchmark 已经说明,50 万条纯内存就 61ms,真实并发下会更快崩。
- 中英文混合用纯英文模型。 中文词会被拆成字或乱映射。
- Chunk 切得太碎或太大。 太碎丢失上下文,太大主题混淆。
- 只调 Prompt,不调检索。 一半以上的"模型胡说"其实是检索给错了资料。
八、我的理解
RAG 的上半场和下半场应该分开看:
- 上半场负责"把对的资料找出来";
- 下半场负责"基于资料把话说清楚"。
如果上半场失败,下半场越努力越糟糕——因为它会在错资料上硬编。Embedding 和向量检索就是上半场的核心。把它们当黑盒,你就会一直盯着大模型找原因,真正的问题其实在检索。
我的判断:RAG 的效果上限由检索决定,生成只决定把检索结果表达得多好。
九、总结
一句话记住今天的内容:RAG 上半场 = Embedding 把文本变成向量 + 向量库按相似度召回 TopK。不要只盯着大模型,召回质量才是 RAG 的天花板。
下一篇按计划讲 RAG 完整链路:把检索接进生成——把今天召回的 TopK 文档拼进 Prompt,让大模型基于资料回答。
参考资料
- OpenAI 官方文档:Embeddings(
text-embedding-3 系列模型说明)
- 智源 BGE 模型:
bge-m3、bge-reranker
- pgvector GitHub 与文档
- Qdrant 官方文档
- Milvus 官方文档
 发表于 20 小时前
|
查看: 4|
回复: 0


