如果你的团队正在做企业文档管理、知识库,或者标书关键信息提取,这篇文章或许能帮你省下几个月的试错成本。
在云栈社区,我们复盘过一个真实项目,从检索算法选型一路走到数据资产化。下面把当时的实践拆成 8 个问题,逐个展开聊。
一、从一个真实需求说起
最近在做一个企业级文档管理系统,核心需求有三条:
- 用户按部门上传文档
- 在项目管理系统中,把项目相关的招标文件、投标文件、技术协议、合同、发票、对账单、凭证等,按项目维度聚合展示
- 从招标文件中精准提取 60+ 个关键指标,并支持点击跳转到原文位置
看起来是“文档管理”,实际上触及了一个更深层的问题:如何把企业沉睡的非结构化文档,变成可检索、可关联、可分析的数据资产?
二、BM25:优势、劣势与召回率提升
2.1 BM25 的本质
BM25(Best Matching 25)是一种基于词频统计的精确匹配排序算法,也是 Elasticsearch / Lucene 的默认相似度算法。
它的核心机制有三个:
- 词频饱和:词出现 10 次,不是 1 次的 10 倍相关性,收益递减
- 文档长度归一化:长文档天然词多,会被惩罚
- IDF 加权:罕见词权重高,常见词权重低
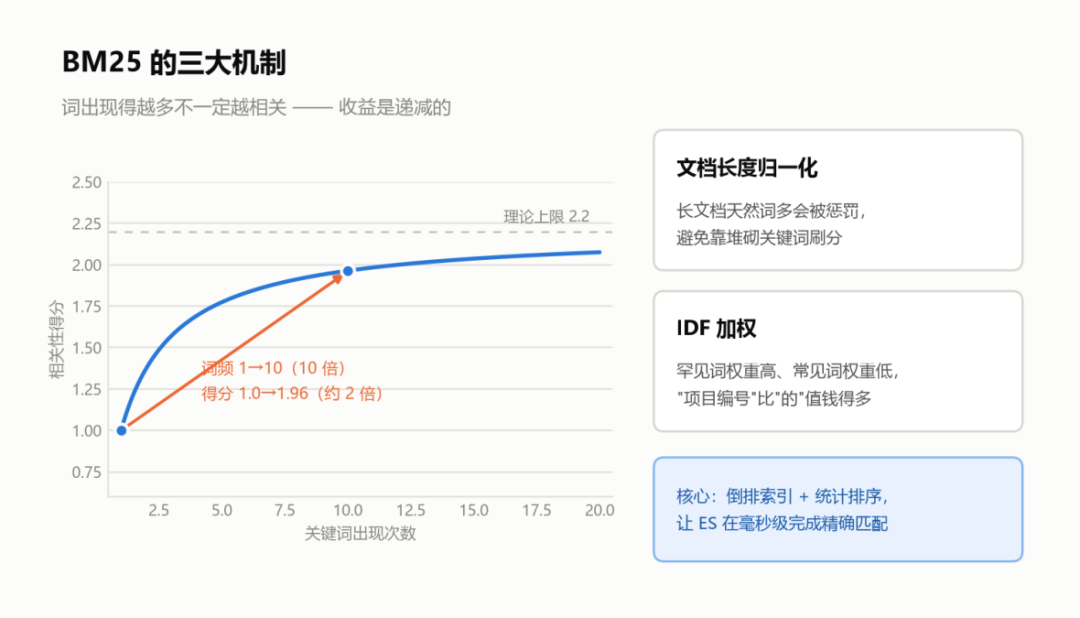
▲ BM25 的词频饱和曲线:词频翻 10 倍,得分只涨约 2 倍
2.2 BM25 的优势
| 优势 |
对你的价值 |
| 精准匹配强 |
标书中的项目编号这类专有名词几乎不会漏 |
| 零训练成本 |
上传文档即可建立索引,冷启动快 |
| 可解释性强 |
每个词的贡献可拆解,得分可追溯 |
| 毫秒级响应 |
倒排索引,适合大量文档实时检索 |
| 对短文本友好 |
标书切片、标题、字段值匹配效果好 |
2.3 BM25 的劣势
| 劣势 |
对你的影响 |
| 词汇鸿沟 |
搜“交货时间”,文档写“交付周期”,直接漏召回 |
| 无法处理同义词 |
“甲方” vs “采购人” vs “招标人”被当成三个词 |
| 对分词极度敏感 |
“潼关储能”被切成“潼关 / 储能”,搜全称匹配不上 |
| 无上下文理解 |
“不接受联合体投标”和“接受联合体投标”几乎一样 |
| 无法处理拼写错误 |
少打一个字就召回失败 |
2.4 提升召回率的手段(按投入产出比排序)
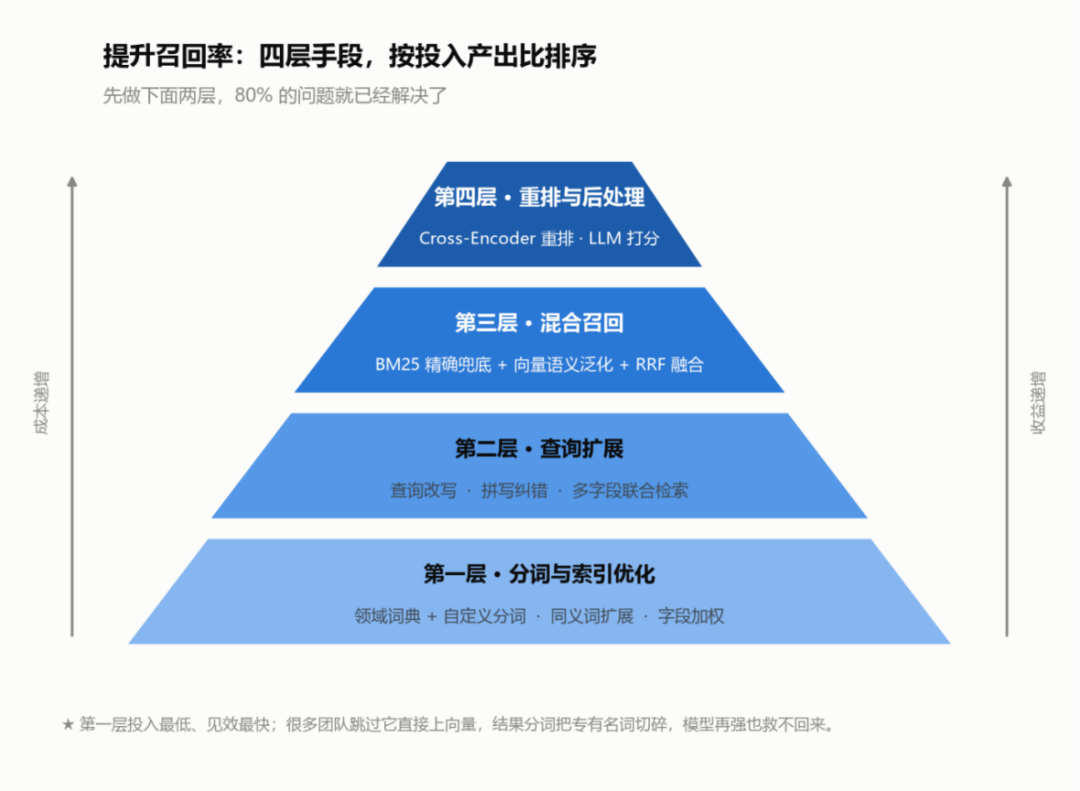
▲ 四层手段:越靠下,投入越低、见效越快
第一层:分词与索引优化(成本最低,收益最高)
- 领域词典 + 自定义分词:把“产投集团”“潼关储能”这类业务术语加进分词词典
- 同义词扩展:建立 甲方 = 采购人 = 招标人 = 客户 的同义词表
- 字段加权:标题 > 摘要 > 正文,例如 title^ content^1
第二层:查询扩展(成本中等,收益显著)
- 查询改写:用户输入“交货时间”,自动扩展为 交货时间 OR 交付周期 OR 工期
- 拼写纠错:fuzzy 查询或编辑距离算法
- 多字段联合检索:把元数据字段也纳入检索范围
第三层:混合召回(成本较高,收益最大)
- BM25 + 向量检索:BM25 负责精确匹配兜底,向量检索 负责语义泛化
- RRF 融合排序:用排名倒数融合两路结果,无需调参
第四层:重排与后处理(成本最高,精度提升)
- Cross-Encoder 重排:对 Top100 结果逐条打分重排
- LLM 相关性判断:适合标书这种高价值场景
2.5 一个关键认知
BM25 的召回率瓶颈,80% 来自分词和同义词问题,只有 20% 来自语义鸿沟。先把分词和同义词做好,比急着上向量模型更划算。
很多团队一上来就搞向量检索,结果发现分词把“潼关储能”切成了“潼关 / 储能”——向量模型再强也救不回来。
三、关键字元数据:BM25 的燃料
切片里的关键字元数据,和 BM25 关系非常紧密——它是 BM25 能有效工作的燃料。
- 直接使用:把切片内容直接喂给 BM25,它自动分词、计算词频
- 元数据增强:手动把关键实体提取成独立字段,查询时加权检索,匹配到关键字的文档得分更高
但要注意:如果关键字与业务无关,不仅没用,还会严重拖后腿——引入噪音、稀释真正权重、拉低召回率。
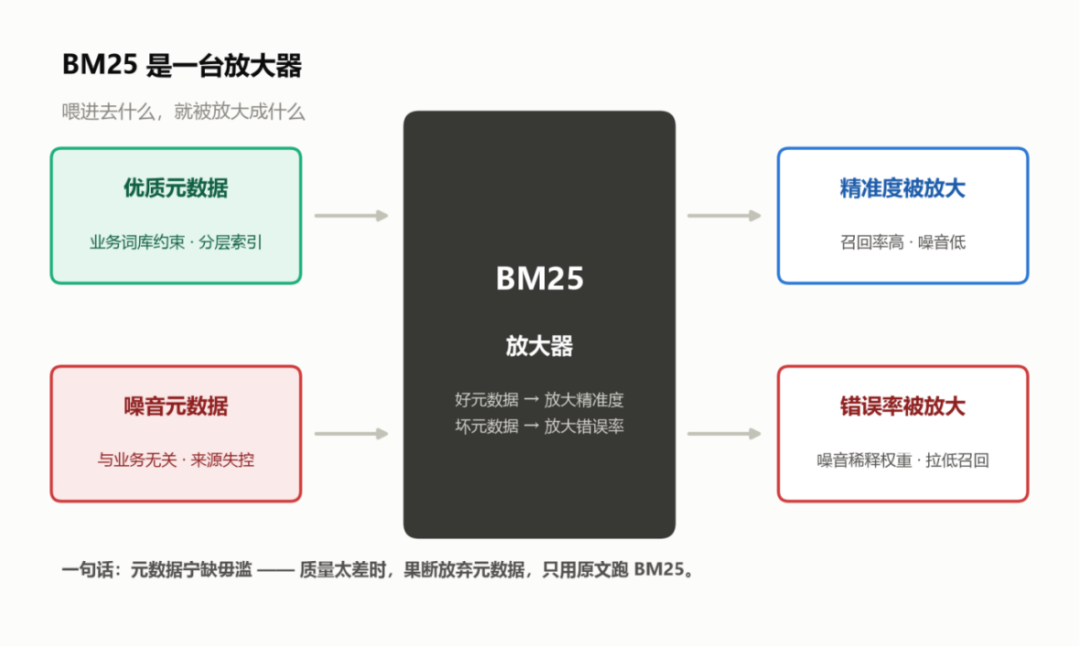
▲ BM25 是一台放大器:喂进去什么,就被放大成什么
解决方案分三层:
- 源头治理:用业务词库约束,只允许从“产品库”“物料号表”里选词
- 分层索引:业务核心层高权重,通用描述层低权重
- 极端情况降级:如果元数据质量太差,果断放弃,只用原文跑 BM25
一句话总结:BM25 是放大器——好元数据放大精准度,坏元数据放大错误率。宁缺毋滥。
四、标书场景的特殊性:为什么通用方案不够用
标书关键信息提取,有几个独特挑战:
- 必须按原文提取:不能改写,不能概括
- 信息分散:同一个指标可能出现在文档各个位置,比如“废标项”分散在全文多处
- 需要溯源:提取结果要能点击跳转到原文位置
- 指标众多:60+ 个字段,涵盖基础信息、商务、技术、报价等多个维度
- 用 Dify 知识库循环抽取,为什么不准?
核心原因是:把“知识库问答”的通用流程,用在了“文档结构化”这个专业任务上。知识库切片会割裂上下文,向量检索靠“猜”信息在哪,导致漏召回和误召回。
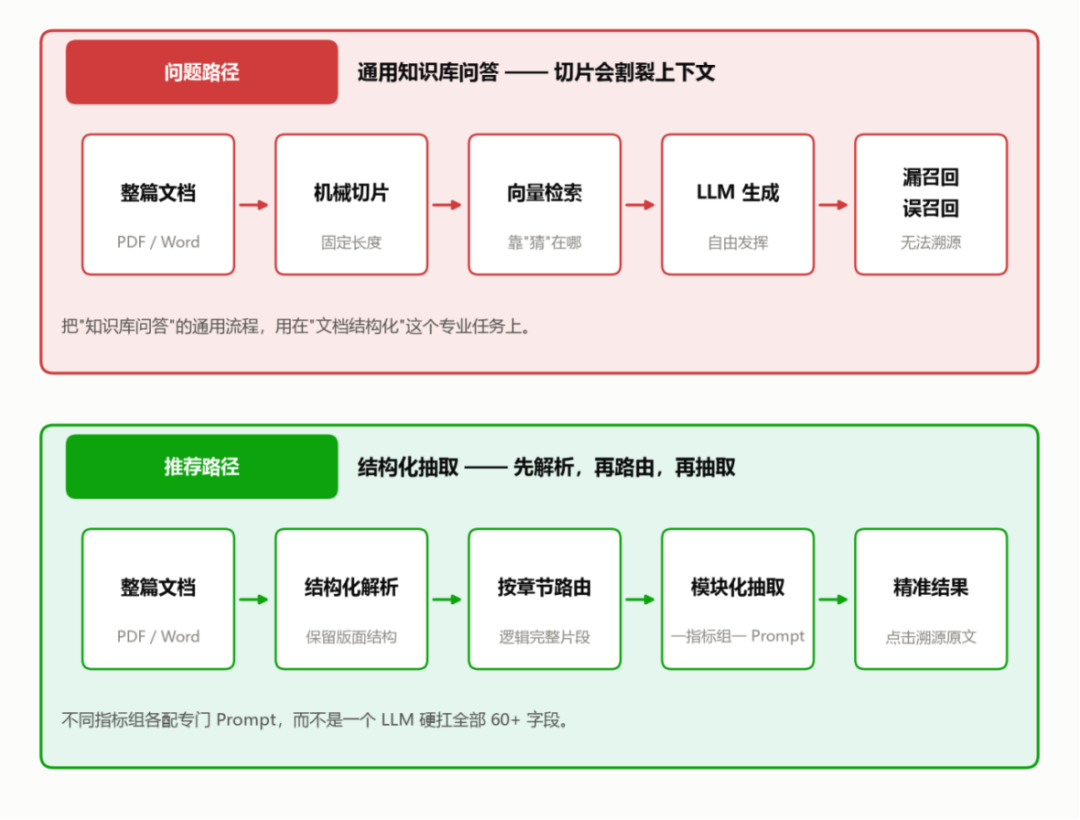
▲ 两条路径对比:问题出在“切片”,解法在“按结构路由”
更优的方案:
- 先解析,再拆分:用专业工具把文档解析成带结构的中间格式
- 按章节路由:根据标题层级把长文档切分成逻辑完整的章节片段
- 模块化抽取:针对不同指标组配置专门的 Prompt,而不是一个 LLM 硬扛所有字段;如果需要同时调度多个大模型 API,可以用 RouteFast.ai 这类中转服务统一管理
五、PageIndex vs Agentic Search:谁更适合标书提取?
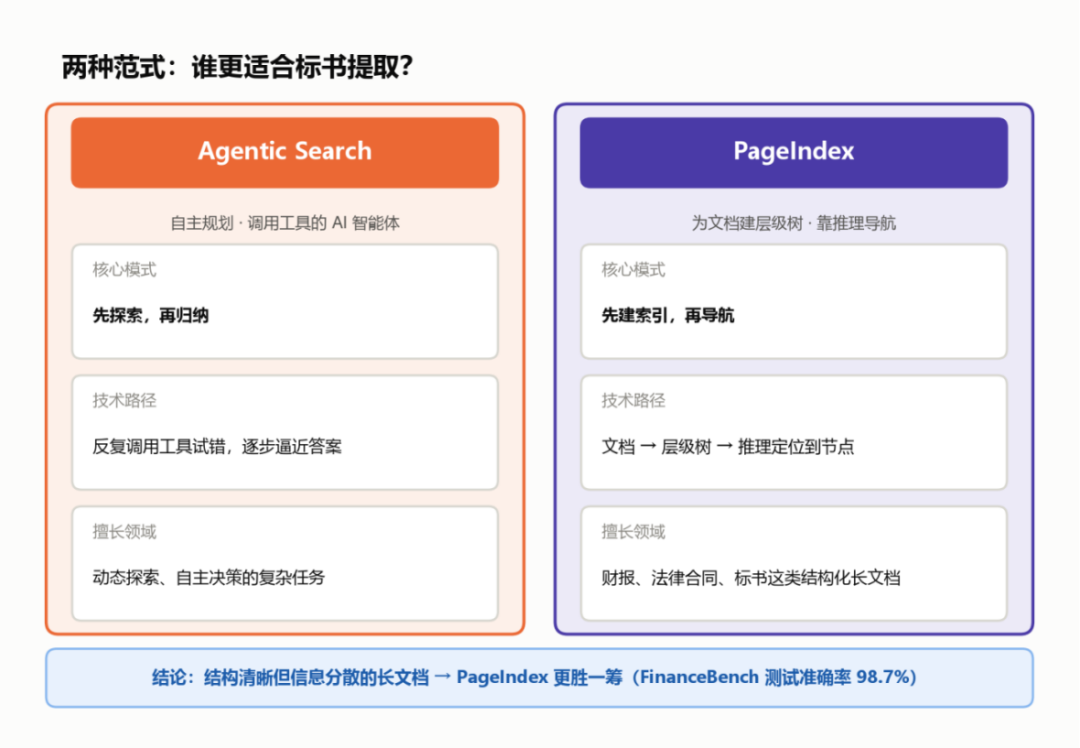
▲ 两种范式的正面对比
| 对比维度 |
Agentic Search |
PageIndex |
| 核心模式 |
自主规划、调用工具的 AI 智能体 |
为文档构建层级树,AI 靠推理导航 |
| 技术路径 |
先探索,再归纳 |
先建索引,再导航 |
| 擅长领域 |
动态探索、自主决策的复杂任务 |
财报、法律合同、标书等结构化长文档 |
结论:对于标书这种结构清晰但信息分散的长文档,PageIndex 更胜一筹。它的精准定位与溯源能力,完美契合“点击指标跳转到原文”的需求。在 FinanceBench 测试中,PageIndex 架构取得了 98.7% 的准确率。
六、企业级文档管理系统的架构设计
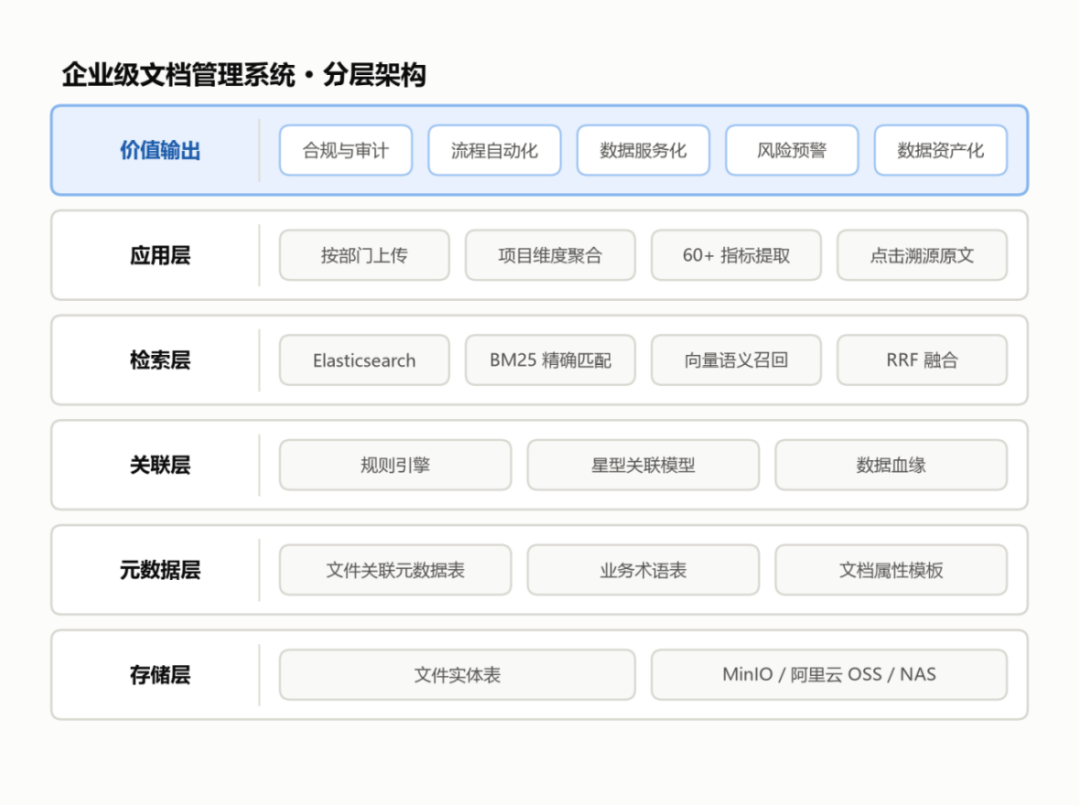
▲ 分层架构:从存储底座到价值输出
6.1 核心思路:物理存储与逻辑关联分离
传统“文件夹—文件”树形结构是排他的(一个文件只能放一个文件夹)。要实现多维度展示,必须引入“物理文件 + 逻辑关联”模型。两张核心表:
- 文件实体表:只负责存储文件的原始属性和物理位置
- 文件关联元数据表:建立文件与业务实体的多对多关系
6.2 元数据标签库:解决“叫法不一”的问题
| 层级 |
名称 |
作用 |
| 业务层 |
业务术语表 |
定义全公司统一的业务名词,如“客户 = 甲方 = 采购人 = 招标人” |
| 技术层 |
文档属性模板 |
为每类文档定义属性字段,如招标文件模板含项目名称、客户名称、开标日期等 |
6.3 规则引擎或者 Ontology:建立数据血缘
不要只做“文档 A 关联文档 B”的简单链表,而是建立“以项目为核心的星型关联模型”。
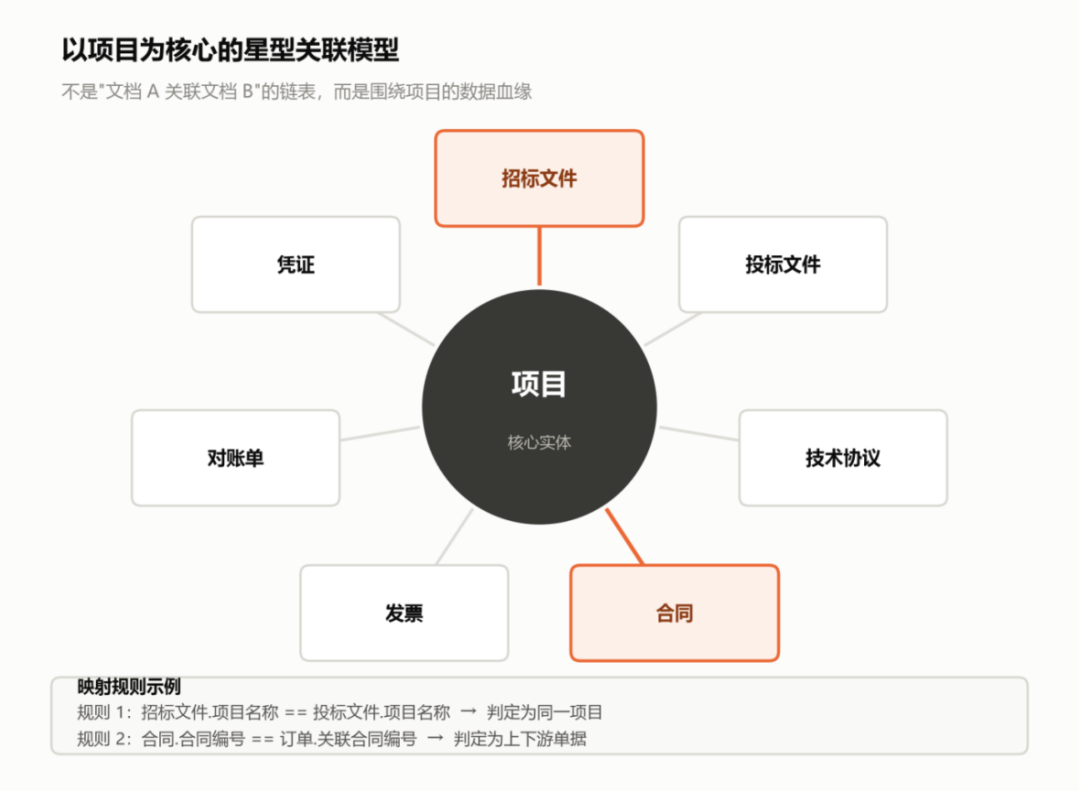
▲ 以“项目”为中心的星型关联:所有单据挂在一个核心实体上
- 规则 1:招标文件.项目名称 == 投标文件.项目名称 → 判定属于同一项目
- 规则 2:合同.合同编号 == 订单.关联合同编号 → 判定为同一项目的上下游单据
6.4 技术选型参考
- 文件存储:MinIO、阿里云 OSS 或本地 NAS
- 元数据数据库:PostgreSQL(支持 JSONB 字段)
- 检索与展示:Elasticsearch
七、商业价值:从“管文件”到“数据资产化”
如果只是为了“找文档方便、消除混乱”,投入产出比确实不高。这套架构的真正价值,在于把数据从非结构化的文档形态,转化为结构化的数据资产。
7.1 五条商业价值路径
- 合规与审计价值:快速提供完整交易链路证据链,降低合规风险
- 流程自动化:财务对账自动比对,异常项目标红
- 数据服务化:实时输出结构化数据,支撑 BI 报表和业务决策
- 风险预警:规则引擎配置风控规则,如“合同金额 > 中标金额 15% 自动预警”
- 数据资产化:把结构化数据封装成数据产品,对外输出变现
7.2 数据资产等级模型
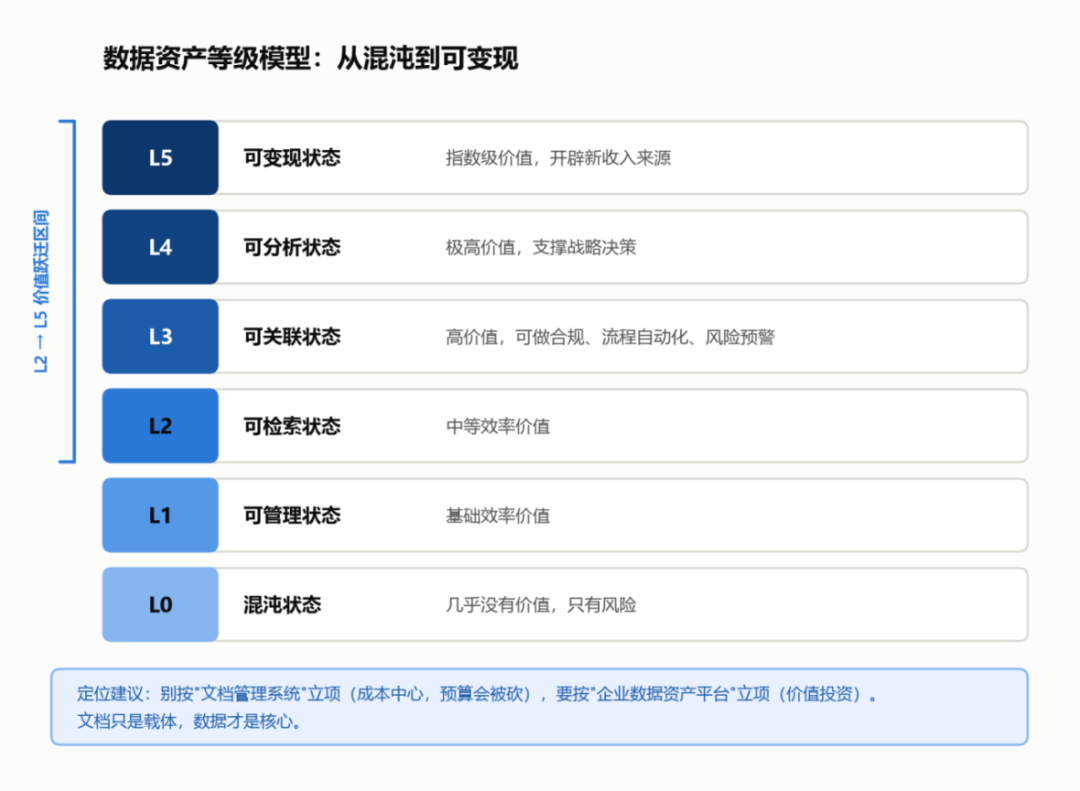
▲ 从 L0 混沌到 L5 可变现:每升一级,价值量级跃迁一次
7.3 一个重要的定位建议
不要把这件事定位成“文档管理系统”去立项,要把它定位成“企业数据资产平台”或“业务流程数字化平台”去立项。前者是成本中心,预算会被砍;后者是能创造价值的投资,老板愿意投。
文档只是载体,数据才是核心。
八、总结
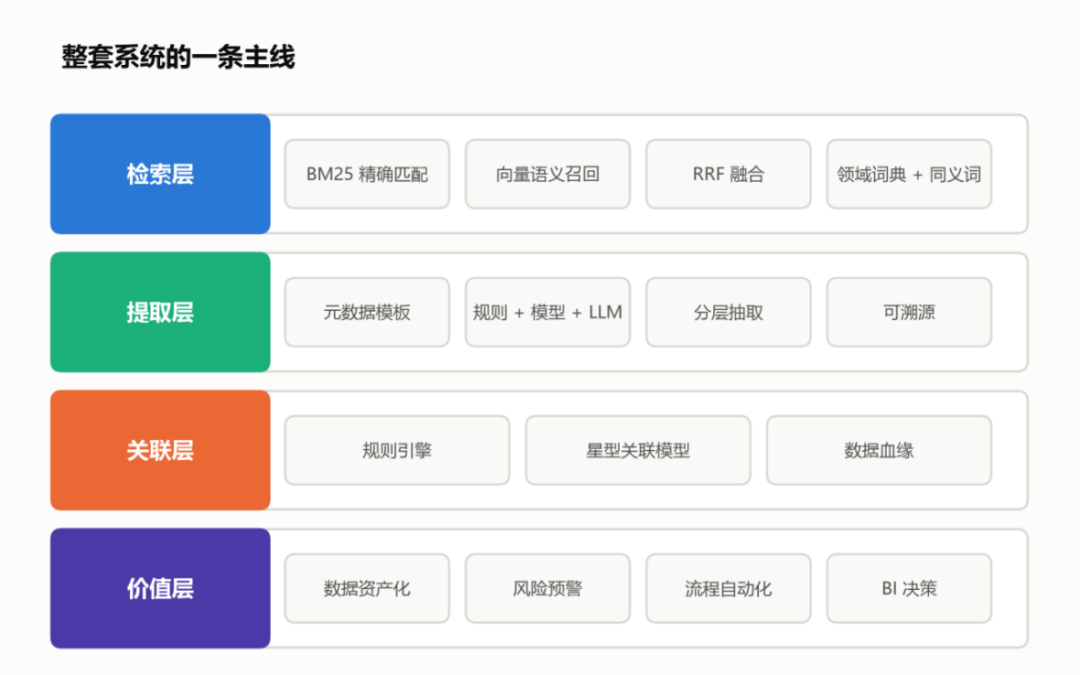
▲ 一条主线:检索 → 提取 → 关联 → 价值
这套企业级文档管理系统的核心逻辑,可以概括为四层:
- 检索层:BM25 + 向量混合召回,配合领域词典、同义词、查询改写提升召回率
- 提取层:基于元数据模板,用规则 + 模型 + LLM 分层抽取,保证精准和可溯源
- 关联层:通过规则引擎建立以项目为核心的星型关联模型
- 价值层:从文档管理升级为数据资产管理,最终实现数据驱动决策和数据变现
一句话总结:这不仅是管文件的工具,而是企业数字化转型的基础设施。
 发表于 21 小时前
|
查看: 4|
回复: 0


