先给结论
16GB 显卡跑 27B 模型,最优解是 UD-Q3_K_XL。
社区把 Qwen3.8-27B 的 21 个量化档位在单张 16GB 卡上全部实测了一遍。128K 上下文选 UD-Q3_K_XL(13.15GB,每秒 42.9 个字);要 256K 超长上下文就换 UD-IQ2_S,速度几乎不掉。
上周末,一篇实测帖在社区里传开了。帖主拿一张 16GB 的 RTX 4070 Ti SUPER,把 Qwen3.8-27B 的 21 个量化版本从头到尾跑了一遍。三轮测试下来,连显示器插哪个口都单独对比了。
这件事值得展开聊聊。几个结论都挺反直觉,顺便也回答了一个老问题:16GB 显存到底能不能跑 270 亿参数的模型?
01 卡点在哪
最主流的档位,恰好塞不进 16GB。
先补一句背景。Qwen3.8-27B 是阿里 8 月 开源 的模型,270 亿参数。参数可以理解成模型的“脑容量”,越大通常越聪明,但也越吃显卡。
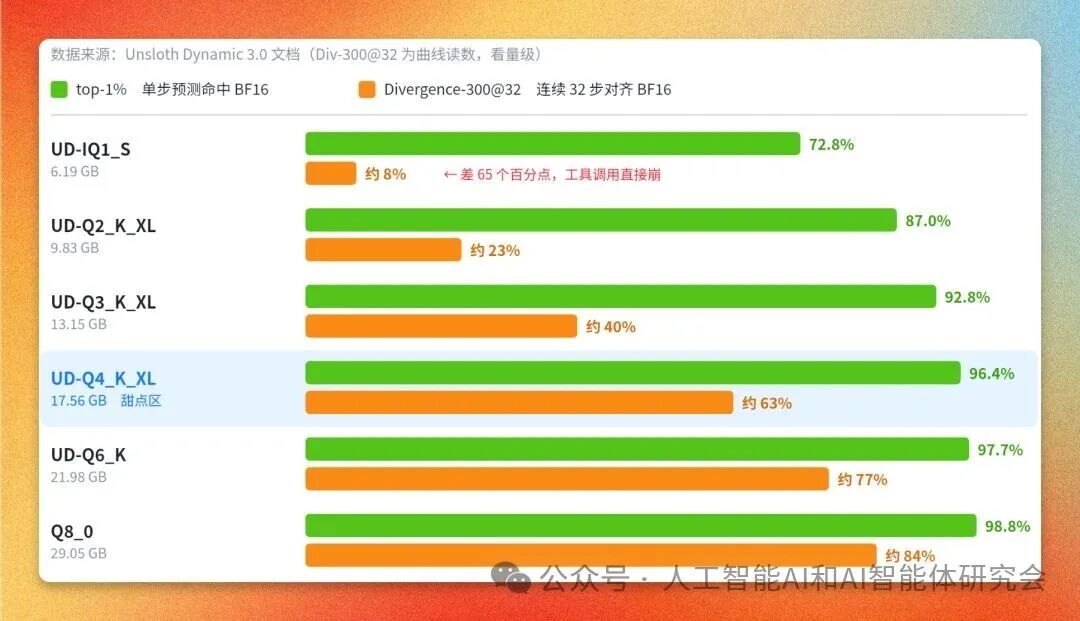
原版模型有多大?55.59GB。家用显卡根本装不下,所以要 量化——把模型“瘦身”的压缩术。体积变小,代价是脑子稍微钝一点。砍得越狠,体积越小,钝得越明显。社区常说的 Q4、Q3、Q2 就是砍的力度档位,数字越大砍得越轻。
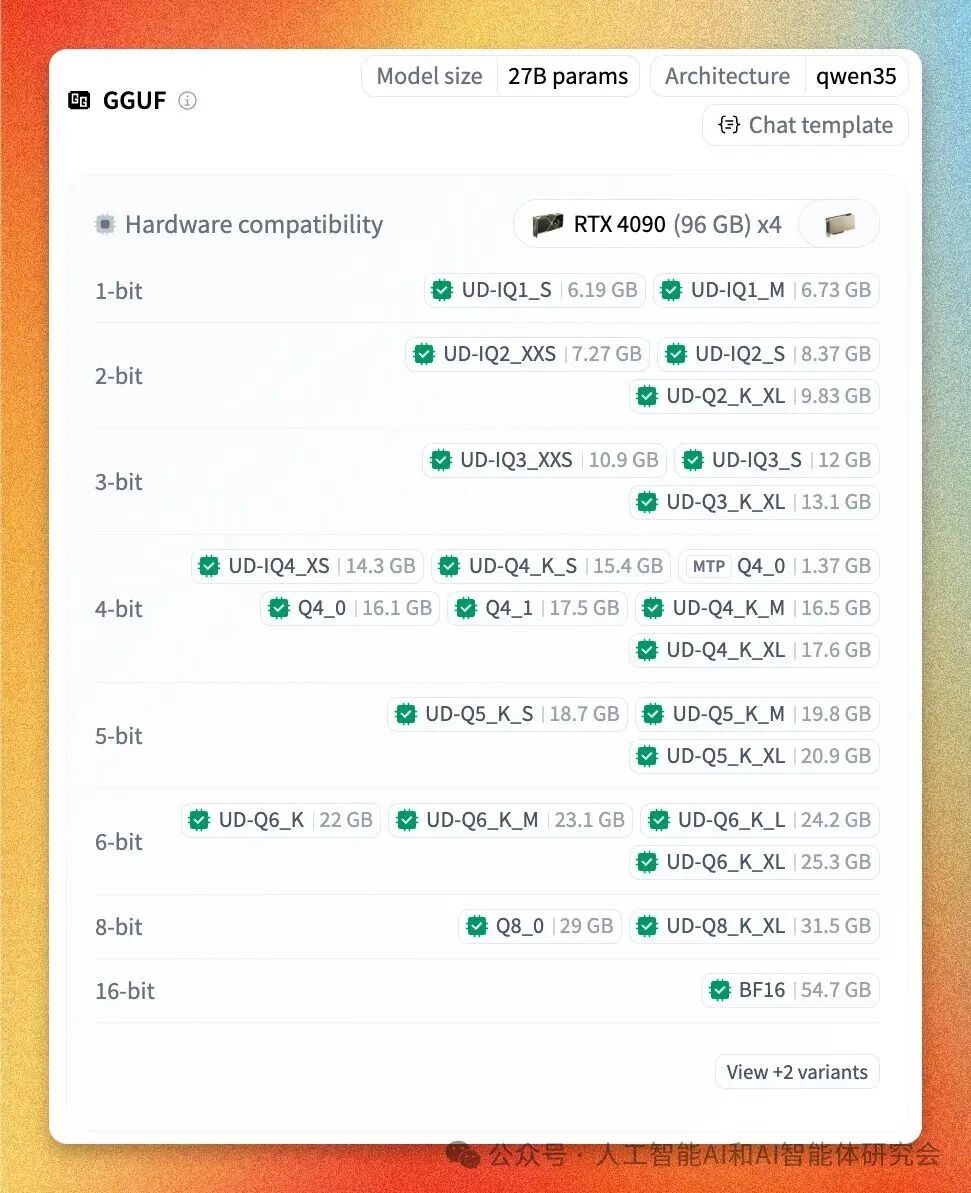
问题就出在这。最主流的 Q4_K_M 档,体积 16.46GB,离 16GB 显存只差了 0.46GB。“16GB 跑不了 27B”这个说法卡的就是这个默认档——不是模型跑不了,是大家都在下载同一个档位。
那 16GB 卡到底能装什么?看这张表(数据来自 Unsloth 仓库的实际文件大小):
常见档位体积对照
| 档位 |
体积 |
适配显存 |
| UD-Q2_K_XL |
9.83 GB |
12GB 卡 |
| UD-Q3_K_XL |
13.15 GB |
16GB 卡 |
| UD-Q4_K_M |
16.46 GB |
24GB 卡 |
| Q8_0 |
29.05 GB |
32GB 以上 |
| BF16 原版 |
55.59 GB |
多卡 / 专业卡 |
02 测法:21个版本怎么测的
这 21 个档位来自三家:bartowski 的标准量化 6 档,Unsloth 的动态量化 8 档,还有 Huihui-ai 的“消审”版 7 档。消审版就是把“我拒绝回答”那部分摘掉的版本,回答更放得开。
测试方法是三种分载方案轮着来。分载,就是把模型一部分搬去内存、一部分留在显卡——搬多少层、怎么搬,直接影响速度。三轮实测下来,连显示器接独显还是接主板核显都单独对比了一轮。
这事还有个前情:8 月小红书博主 @miaomiaozii 发过一篇 16GB 显卡跑 27B 的部署帖,社区去复现时踩了一脚泥,索性把整个坑摸了个遍。他们发现:Windows 下 nvidia-smi 显示的显存是预留地址空间,不是真实占用;社区流传的分载正则对这种模型一个张量都匹配不上;还有默认的惰性加载会拖慢读文档速度。
丑话说在前面:以下数据来自社区实测,不是官方跑分,机器配置不同成绩会有出入。
03 四个反直觉的发现
发现一:显示器插主板,白捡 15% 速度。显示器接独显时,Windows 桌面会周期性占用独显的拷贝引擎和一点显存,跟推理互相干扰。改接主板核显后,独显成了纯计算设备,平均生成速度涨 15.4%、读文档速度涨 9.3%。这是全部优化里最便宜的一条——零成本。
发现二:256K 上下文是 3bit 档的悬崖。这里要插一句大白话。模型聊天时要拿一个“记事本”记前面说过的内容,学名叫 KV Cache,上下文越长,本子越厚,越占显存。上下文从 128K 翻倍到 256K,本子跟着翻倍,把模型本体往外挤。结果很惨:128K 下每秒 60 多个字的 3bit 档们,集体跌到 10~45。
发现三:2bit 反而几乎不动。最有意思的一条。UD-IQ2_S 在 256K 下速度 49.8,和 128K 的 49.3 几乎持平;1bit 档更是稳定在 57。原因也简单:模型本体小,给记事本留足了地方。所以 256K 超长上下文的实际可用区,恰恰是这些小体积档位。
发现四:消审版性能和原版一致。同一档位两边数据落在正常波动范围内,想用消审版的放心用。
代表档位三轮最优成绩(tok/s)
| 档位 |
128K 生成 |
256K 生成 |
| UD-Q4_K_M |
11.5 |
9.4 |
| UD-Q3_K_XL |
42.9 |
9.4 |
| UD-IQ2_S |
49.3 |
49.8 |
| UD-IQ1_S |
56.7 |
57.0 |
上下文翻倍=记事本翻倍。128K 的甜点配置直接搬到 256K,大多会失效。
04 抄作业
第一步,对号入座。按你的显存选档位,这是这 21 个版本测出来最省的组合:
显存档位选择表
| 你的显卡 |
下这个档 |
一句话点评 |
| 12GB |
UD-Q2_K_XL |
勉强装下,只跑短上下文 |
| 16GB · 128K |
UD-Q3_K_XL |
16GB 的甜点,42.9 tok/s |
| 16GB · 256K |
UD-IQ2_S |
速度稳,但只适合简单任务 |
| 24GB |
UD-Q4_K_M |
质量和体积的平衡点 |
第二步,把显示器插到主板的视频口上,让独显专心干活。
第三步,用 llama.cpp 加载,KV Cache 开量化。参考命令长这样(按自己的档位改文件名):
llama-server -m Qwen3.8-27B-UD-Q3_K_XL.gguf -ngl 99 \
 -c 131072 -fa on -ctk q4_0 -ctv q4_0 \
 -b 512 -ub 256 -t 12
最后是这轮实测换来的避坑清单:
避坑清单
- 别只信 nvidia-smi 的数字,Windows 下那显示的是预留空间,不是真实占用。
- 128K 的配置直接搬去 256K 会翻车,先降一档量化。
- 2bit 档只适合问答、摘要这类简单活,写代码别用它。
- 质量优先就选 UD-Q4_K_M,但 16GB 卡装不下,要么换卡要么接受分载变慢。
- 消审版随便用,性能和原版一致,已实测确认。
写在最后
写这篇的时候顺手查了下行情:内存合约价同比涨了 146%,英伟达那台小主机涨到 4699 美元。“本地跑 AI 省钱”这话,越来越像一句口号。
但一张 16GB 卡加一个 13GB 的文件能跑 270 亿参数这件事,还是让人高兴。至少你手里的卡没白买。
不说了,我先去把显示器插回主板。这是今天最便宜的一笔提速。
 发表于 5 天前
|
查看: 0|
回复: 0


