上个月,硅谷开发者圈最火的一个模型,是一个不会说话的模型,叫 Jev。
它是前 OpenAI 研究员 Diogo Almeida 发布的。不写文章,也不陪你聊天。你给它一段话和几个选项,它只回你选哪个、有几成把握。
就这么一个"哑巴"模型,上线 Vercel 的 AI 网关 24 小时,将近 13% 的付费团队就接进去用了。一周之内,网上冒出来 20 来个仿品,Kev、Laya、TinyJev……光 Laya 一个,开源 5 天就破了 1.9 万 Star。
说实话,我第一眼看到 Jev 的时候,心想:我半年前给 MobileClaw 也干过这事。
4 月我爆肝两天搓了个语音唤醒的 Agent App。当时为了省钱,也为了快,在前面塞了个速度很快的免费模型 GLM-4.7-Flash,专门做意图识别:你说"看一眼、这是什么",它就把摄像头抽的几帧图一起传给后面的大模型;你说帮我设个闹钟,它就只传文字。
这其实跟 Jev 在干的事类似——做选择题。
但选完之后呢?闹钟设几点,明早 7 点还是 7 点半,周末响不响?最后还是得交给后面那个又慢又贵的大模型去执行。再比如你对家里音箱说,把卧室的灯调成暖黄。系统要搞清楚的不止你想开灯,还有哪个房间、亮度调多少、色温调多少。Jev 能告诉你用户想控制灯光,剩下这几个空它管不了,因为它只做选择。
我原本以为 Jev 是个开源模型,结果一搜,发现还是闭源的。
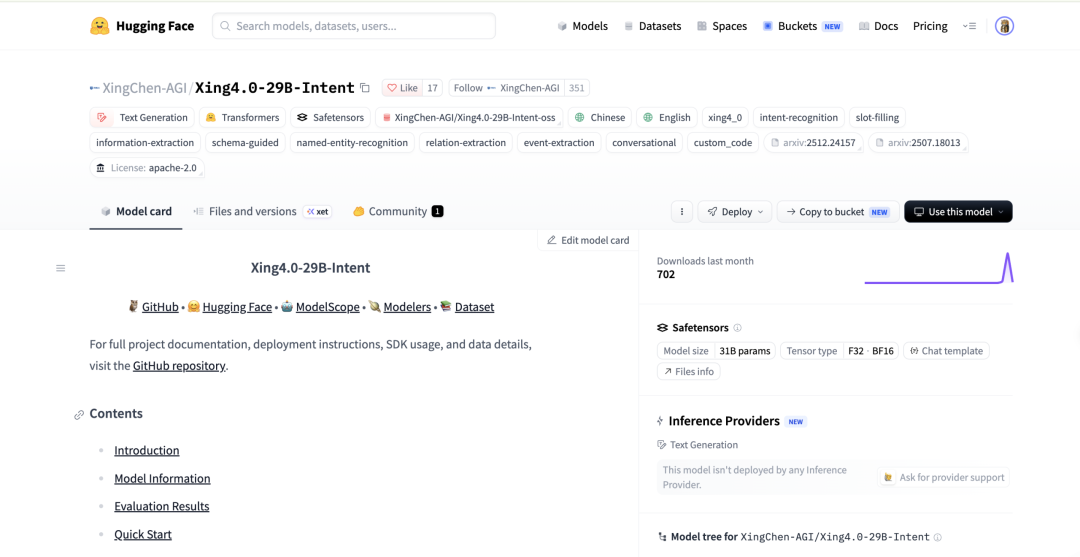
不过前两天,我刷到中电信人工智能科技有限公司星辰通用人工智能实验室(下文简称星辰实验室)开源了一个意图理解专用模型,叫 Xing4.0-29B-Intent。名字太长了,就叫它 Xing(行)吧,行模型😄,看完感觉它刚好补齐了 Jev 的短板。关键是开源!!!29B 完全可以本地部署了~
模型仓库地址:
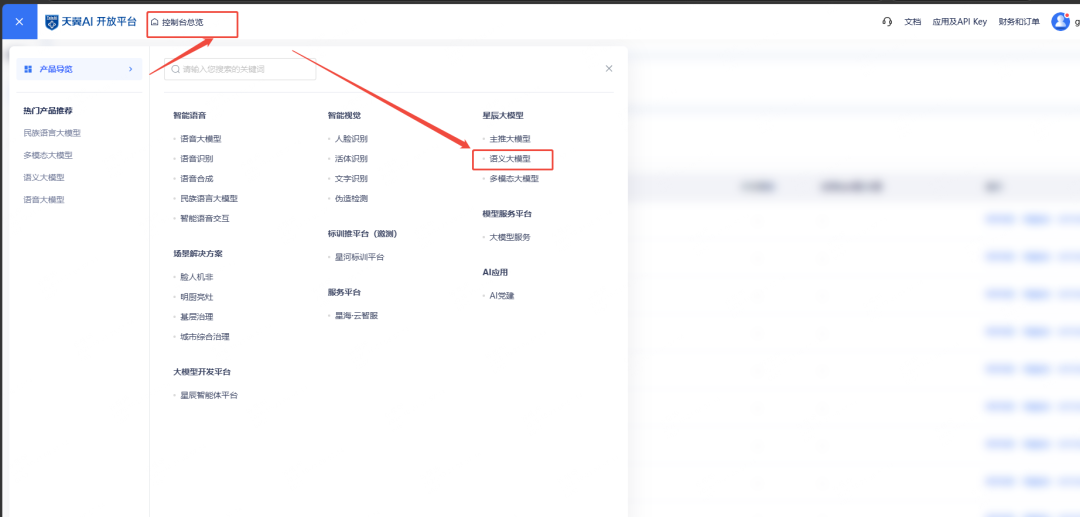
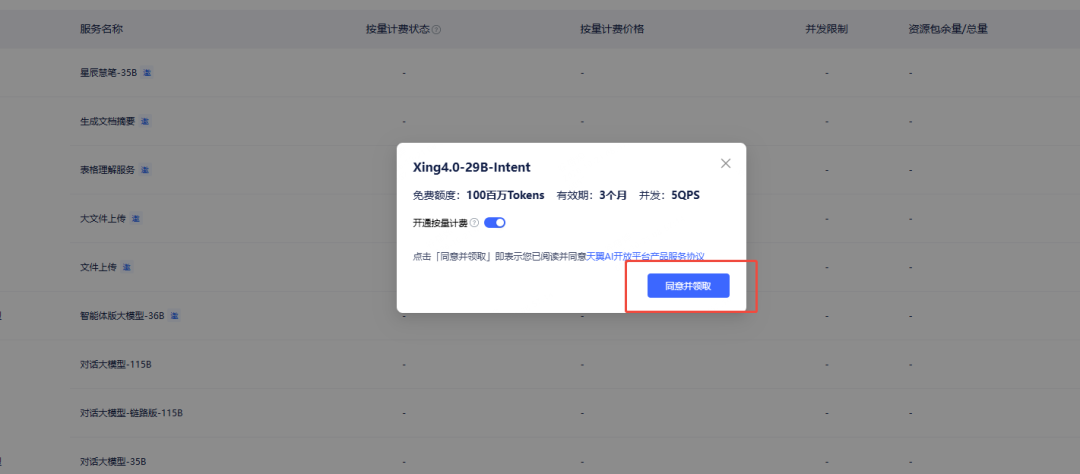
最爽的是,现在天翼 AI 开放平台可以免费体验 API,有 3 个月和 1 亿 tokens 的免费试用额度。
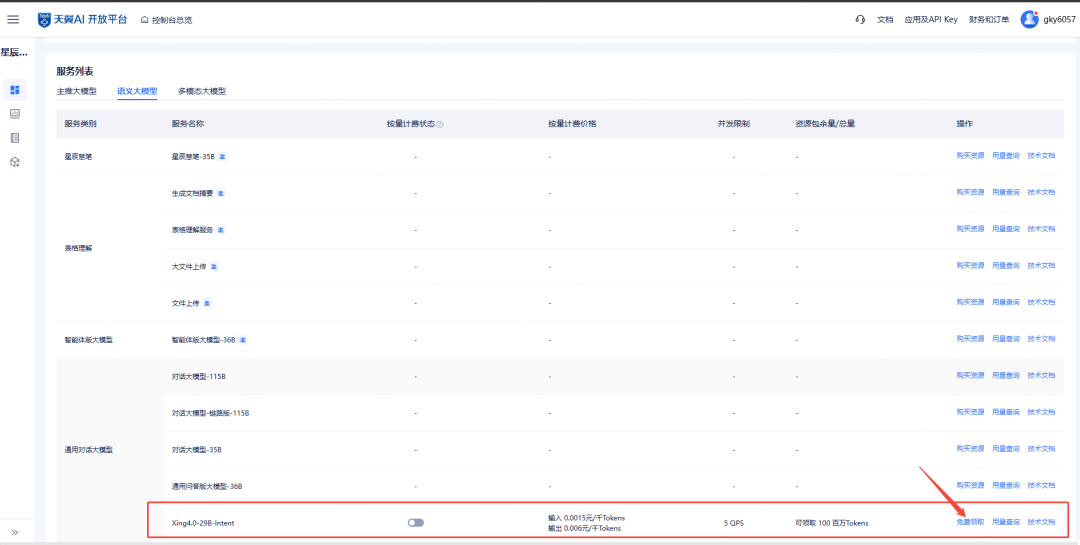
这里直接领取即可。
Xing4.0-29B-Intent 除了能选择,还能告诉你怎么干、参数是什么。也就是说,它除了能做选择题,还能做填空题。
我刚看到"既能做选择题,又能做填空题"时,其实也有点懵:这两件事,放到一个 AI 产品里,到底有啥差异?后来实际放到程序里跑了一下,就懂了。
拿找客服改收货信息这个场景举例。比如我说:"这个包裹还没发货,把地址改成杭州市西湖区文三路 88 号,收件人改成林晓。"
系统先要判断,我是想退款、查物流,还是修改收货信息。这一步就是做选择题:业务类型已经列好,模型根据用户的意思选中其中一个。但选对业务类型,还不足以处理这件事。系统还要把新地址、新收件人分别记下来。这一步像填表(填空):"地址"和"收件人"两个变量是提前设置好的,模型从原话里提取具体内容赋值即可。
Jev 主要围绕给定选项做判断,也支持是非判断和评分;Xing4.0-29B-Intent 则可以把意图识别与参数抽取一起干了,既判断要办什么业务,也提取后续程序需要的信息。当然,如果地址本来就有几条备选,Jev 也可以选。Xing4.0-29B-Intent 更省心的地方,是不必先把所有可能的字段值列成菜单。
对系统来说,这一步的价值,是把一句用户要求整理成程序可以继续处理的工单。可能有点抽象,这块还是需要写过代码的人更容易看懂。还不清楚的话可以看下面这张图,会更形象:
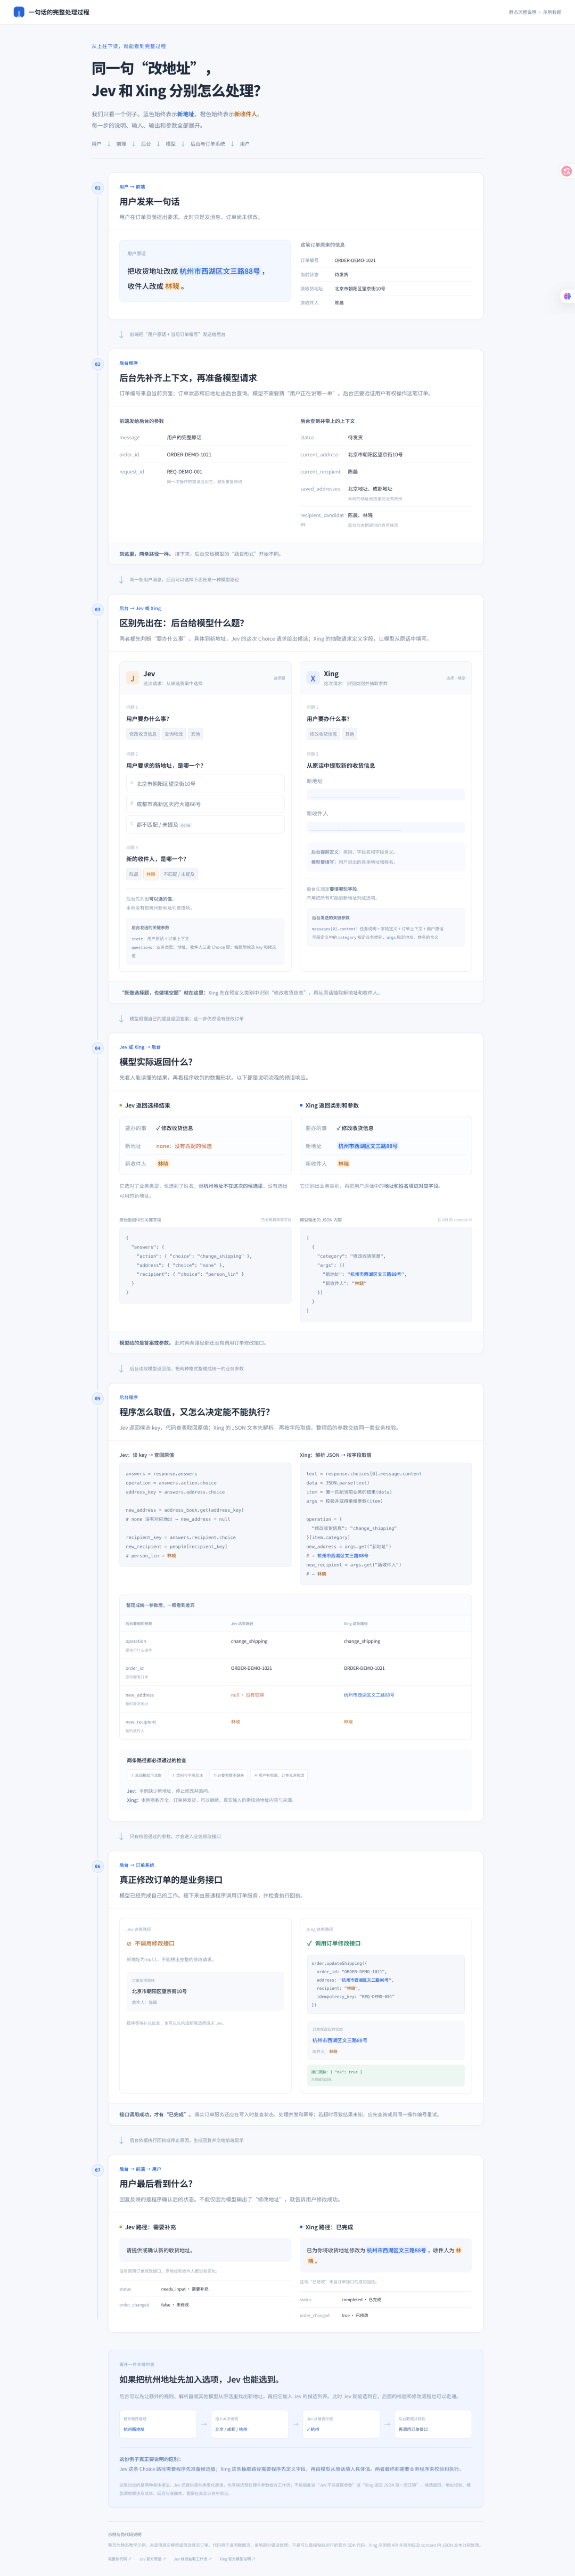
可以上下滚动的图片。
我自己也跑了一些 Xing4.0-29B-Intent 和 Jev 的案例,下面一个个说。
一、冷启动比 Jev 更稳
先说大家最关心的,跟 Jev 正面比。GitHub 上 Xing4.0-29B-Intent 有个评测表格。
他们准备了 5606 道意图分类题,所有模型同一批题、同一份提示词,一个示例都不给,全靠模型自己读懂类别描述,也就是冷启动。Jev 只能做选择题,所以测了两种回答方法:N 个选项里挑一个,和每个选项单独判是非。
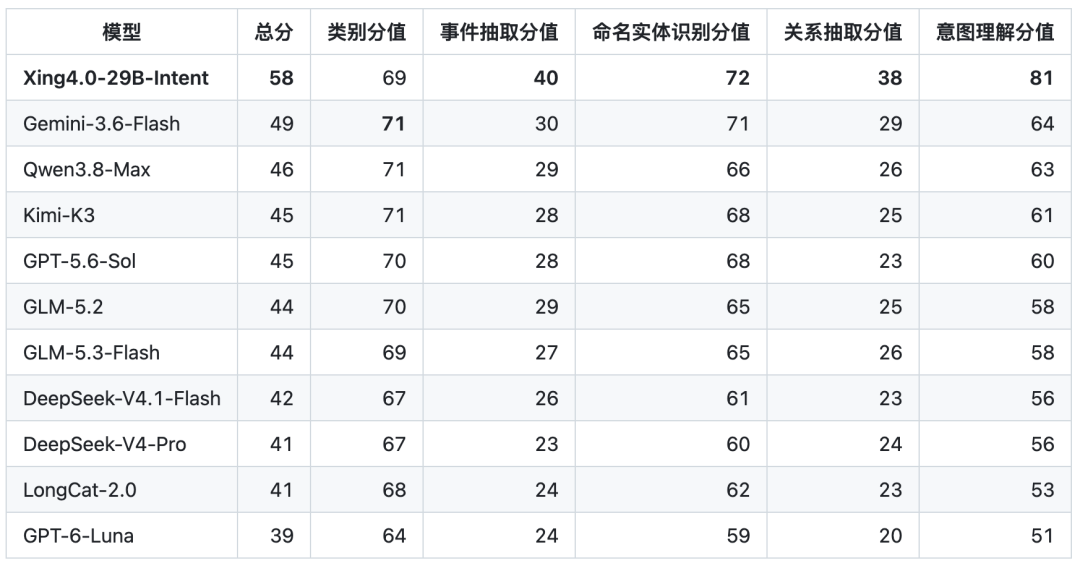
类别 F1 上,Xing4.0 是 70,比 Jev 最好的那种答法高出十几个点,也超过了 GPT-4.1,跟 GPT-5.5 基本打平。
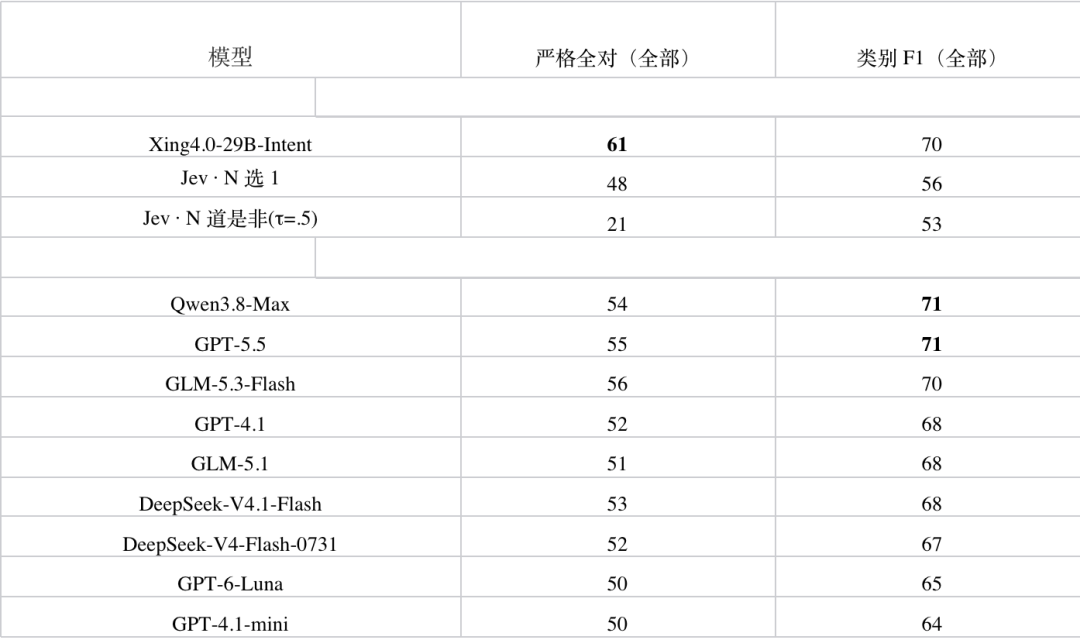
拉开差距的是严格全对,也就是答案一个不漏、一个不多才算对。Xing4.0-29B-Intent 是 61,通用大模型在 50 到 56 之间,Jev 最低只有 21。
最让我意外的是题库里那 839 道正确答案是什么都不该选的题。Xing4.0-29B-Intent 拿了 70 分,Jev 逐个判是非的答法只拿了 5 分。有点像考场上那种必须选一个的学生,题目明明在说以上都不对,他还是硬着头皮蒙了个 C。如果放到产品里面,这就很要命了:用户随口说了句跟业务无关的话,系统非要给他匹配一个意图,然后真的去执行。
肯定有人会问,这种模型到底有什么实际的用途?我实际应用之后,发现还真有很多场景可以用。
二、电商过滤差评
要是我第一份工作有它就好了。
我的第一份工作是在一家做跨境电商的创业公司。有一个工作是过滤差评(哈哈,不给老外展示差评,他们能看到的全是好评),几千万个评论,各式各样。当时是写程序去尽量过滤差评,比如关键词过滤,过滤 2 颗星以下的评论等等,设置了非常多的条件,逻辑复杂,过滤效果还很一般。
PS:当然这种做法肯定是不可取的,我们这里主要讨论模型的应用。不过这家公司在疫情的时候就倒闭了。
现在用像 Xing4.0-29B-Intent 这样的模型,效果会更好,而且实现逻辑更简单,速度也很快。
为了验证,也为了对比测试一下 Xing4.0-29B-Intent 和 Jev 在选择题上到底孰强孰弱,我专门在网上找了 6 万条真实的电商评论,覆盖各种品类。
文件里有个 label 字段,为 1 表示好评,为 0 代表差评。
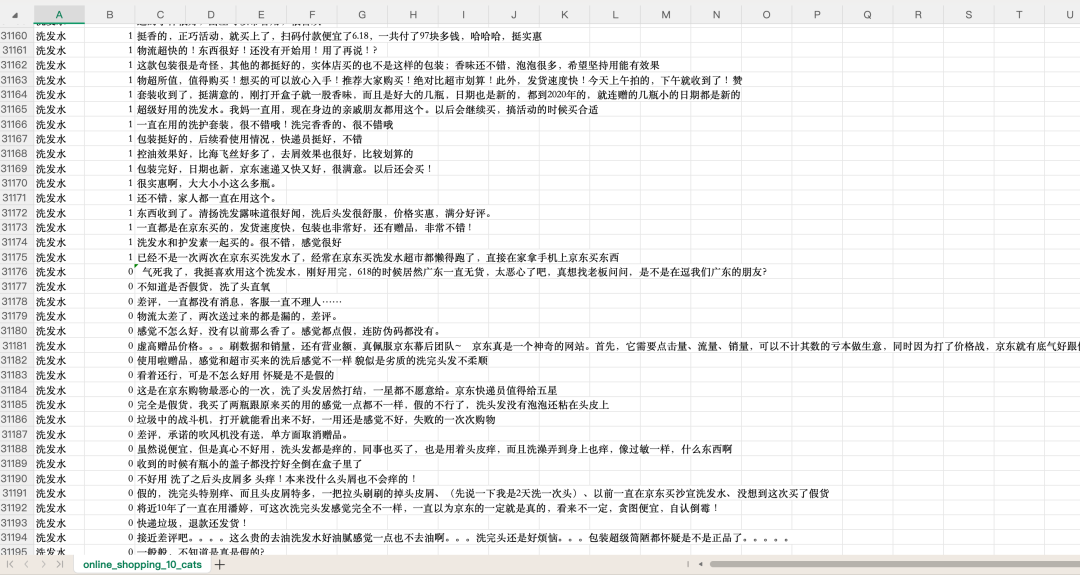
6 万条太多了,测试起来比较费时。所以我让 codex 帮我按每种品类各抽 200 条好评和差评,抽齐 2000 条,丢给 Xing4.0-29B-Intent 和 Jev 去判断好评和差评。因为有标准答案,最后很方便判断准确性。
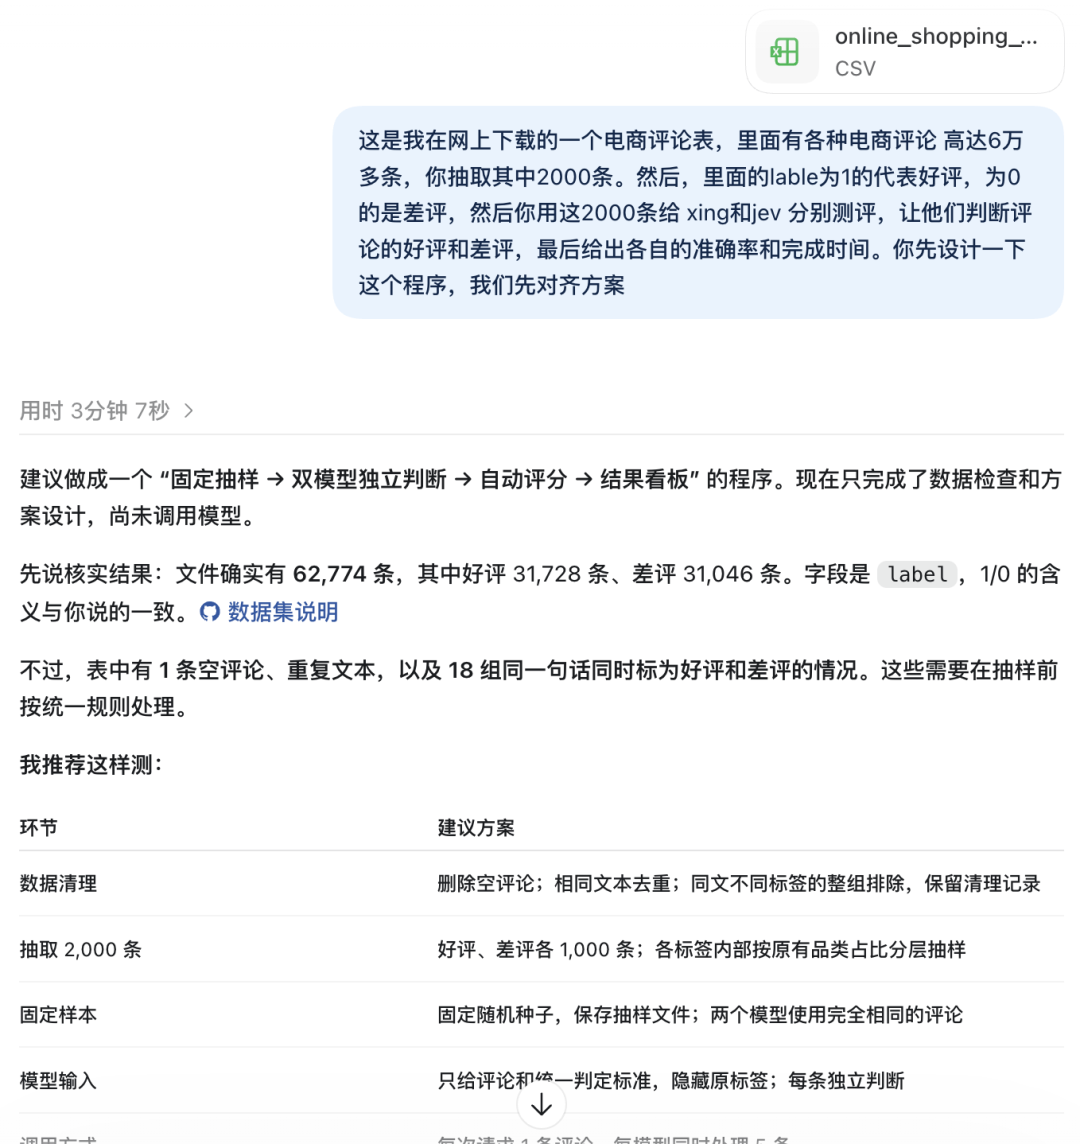
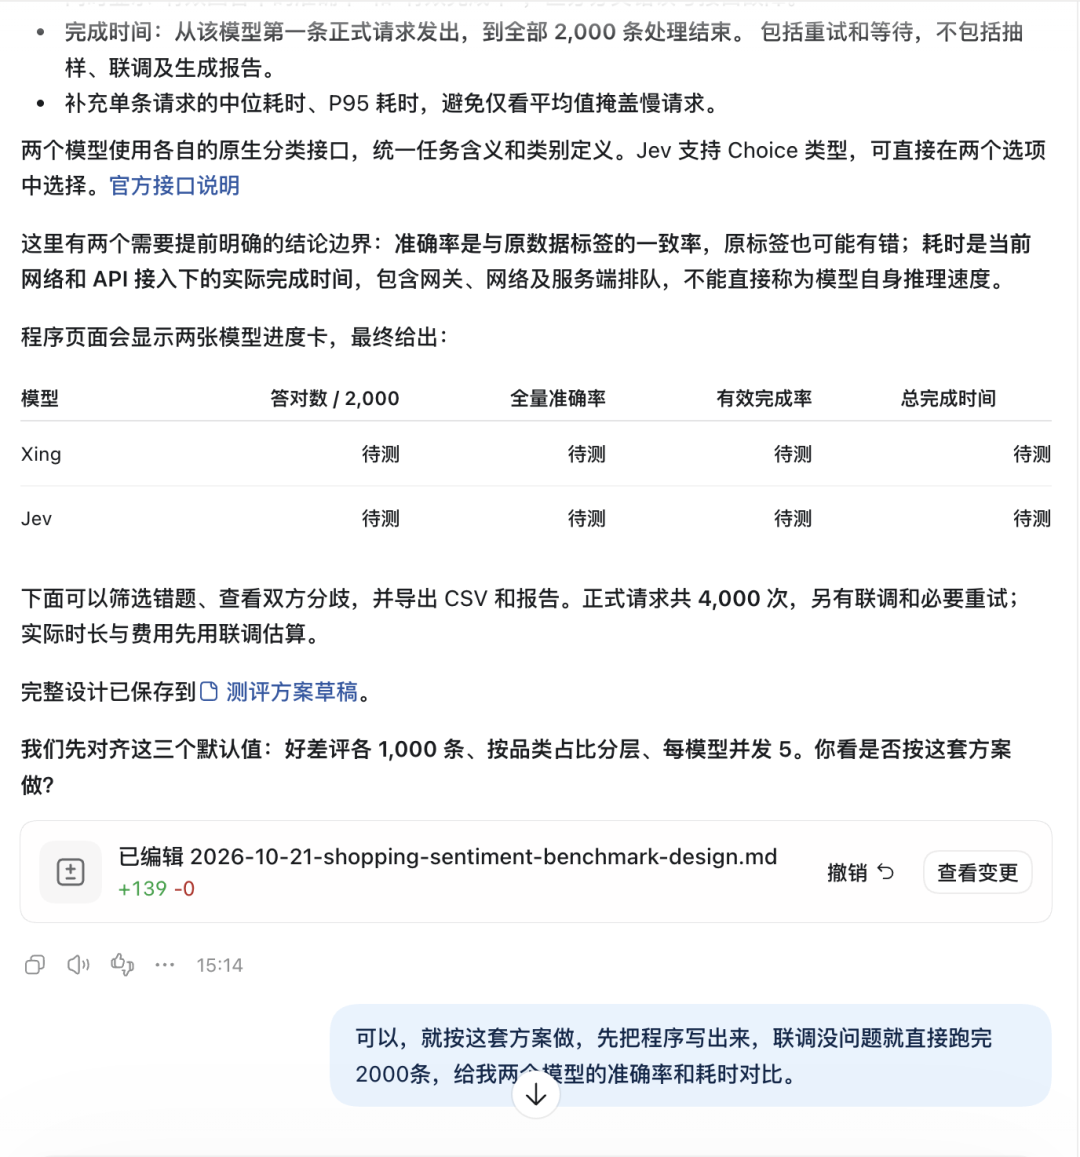
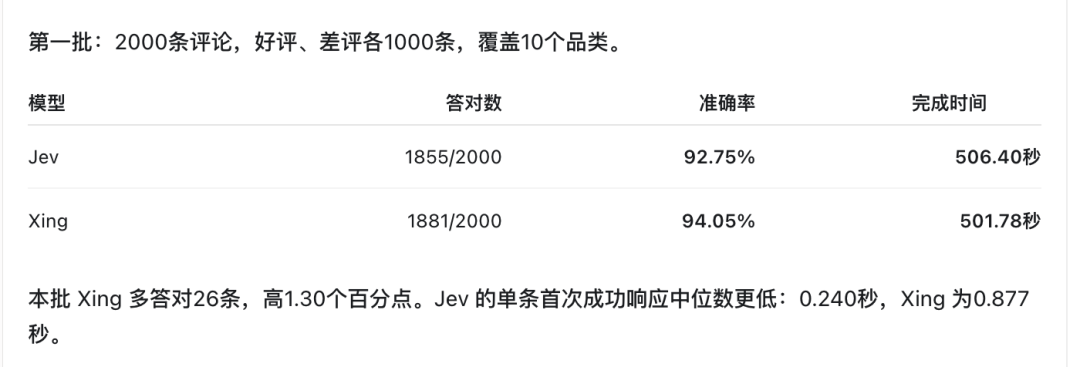
测试结果如下:
可以看到 Xing4.0-29B-Intent 的正确率会高一些,完成得也更快。
三、融入我的开源 AI 截图产品:Ta
还有个非常给力的用法,我把 Xing4.0-29B-Intent 融入了我的开源项目 Ta,它是一个 AI 原生截图工具。
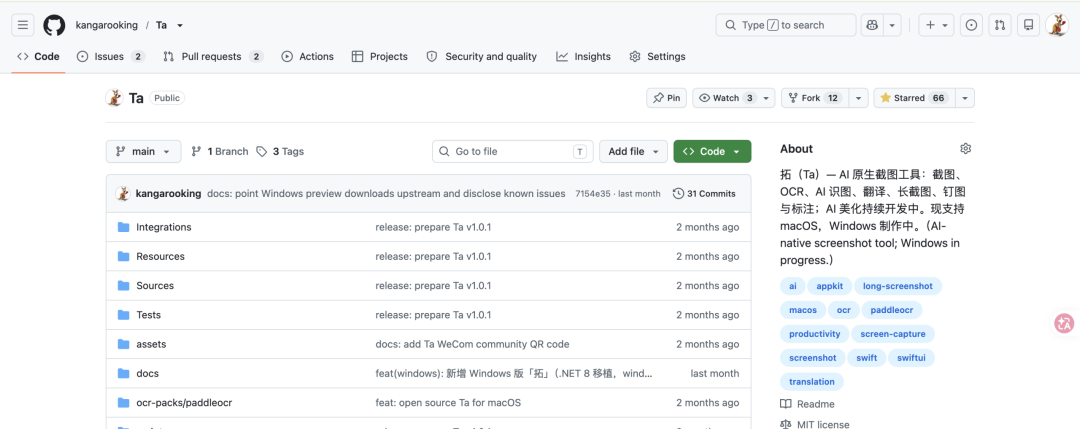
先给你们看下我是怎么用的。我通过 Xing4.0-29B-Intent 的能力,给 Ta 新增了一个「智能标注」功能。
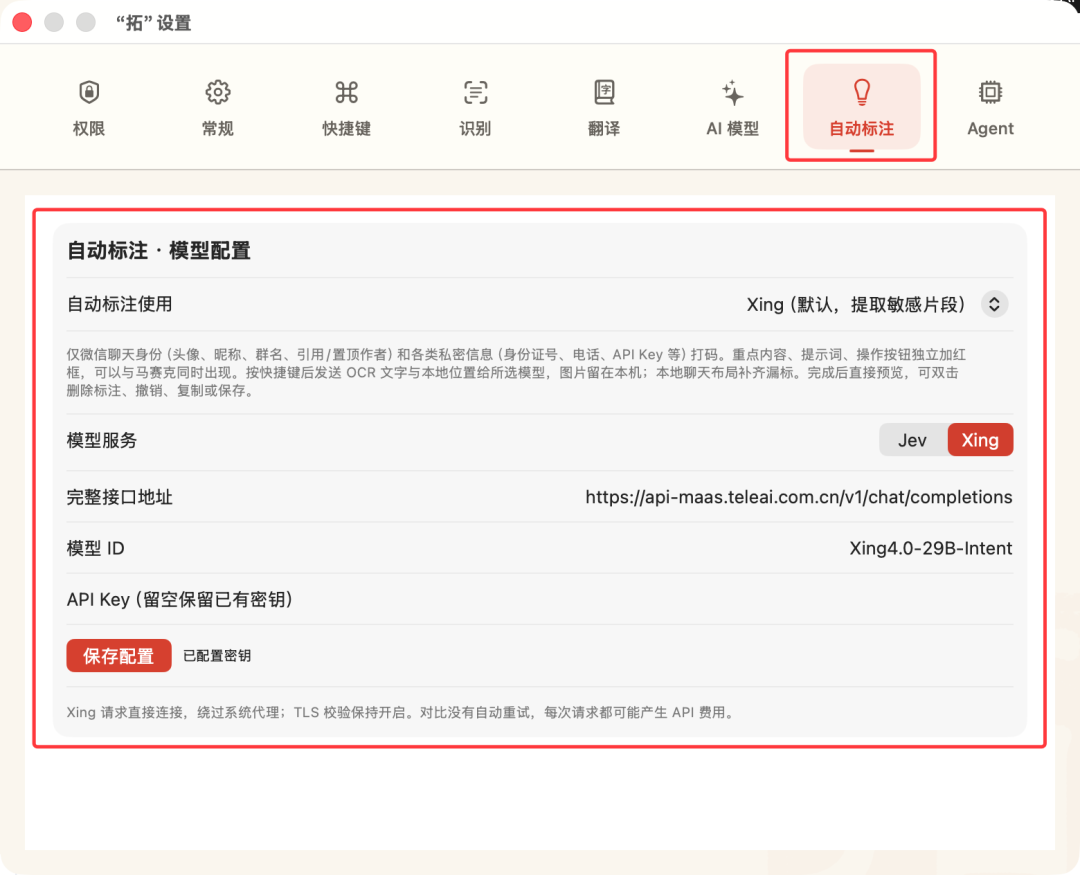
比如我写文章,经常需要用到一些微信聊天记录的截图。但是每次都需要给聊天记录里面所有头像、昵称、备注的电话、群名等打码。这样不仅繁琐,还容易漏打码。有一次就是忘记给聪哥的电话打码了,都是看评论区有人提醒才知道🤣。
所以这次利用 Xing4.0-29B-Intent 的判断能力,可以实现截图之后自动打码,而且处理速度也很快,关键可以免费。
类似这种效果:
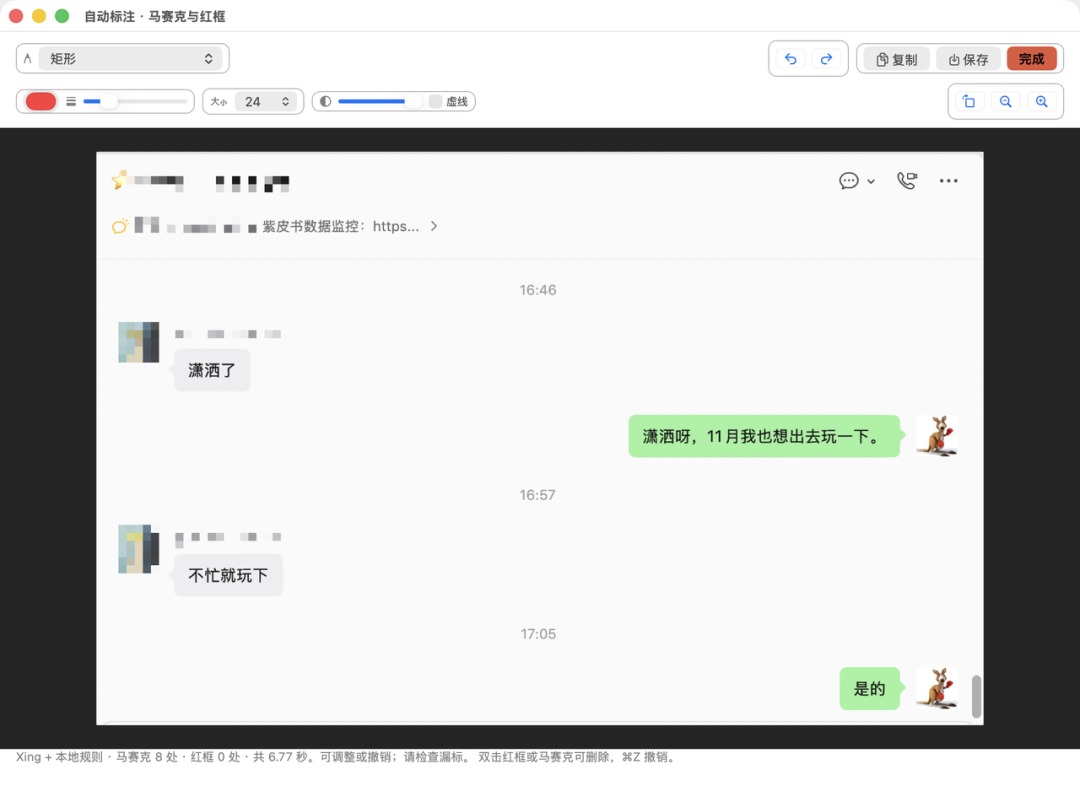
它能快速判断哪些地方需要打码,并自动处理。你看它连引用的那种名字也能打码,确实方便不少。
除了打码,我经常写教程需要画红框,也可以让它自动帮我们框选,减少工作量。不需要的框选可以手动去除,还是挺方便的。这里也跟 Jev 对比了一下,Jev 还是有点问题,第二次直接啥都没选,第三次还给打上马赛克了。
还可以混合使用:
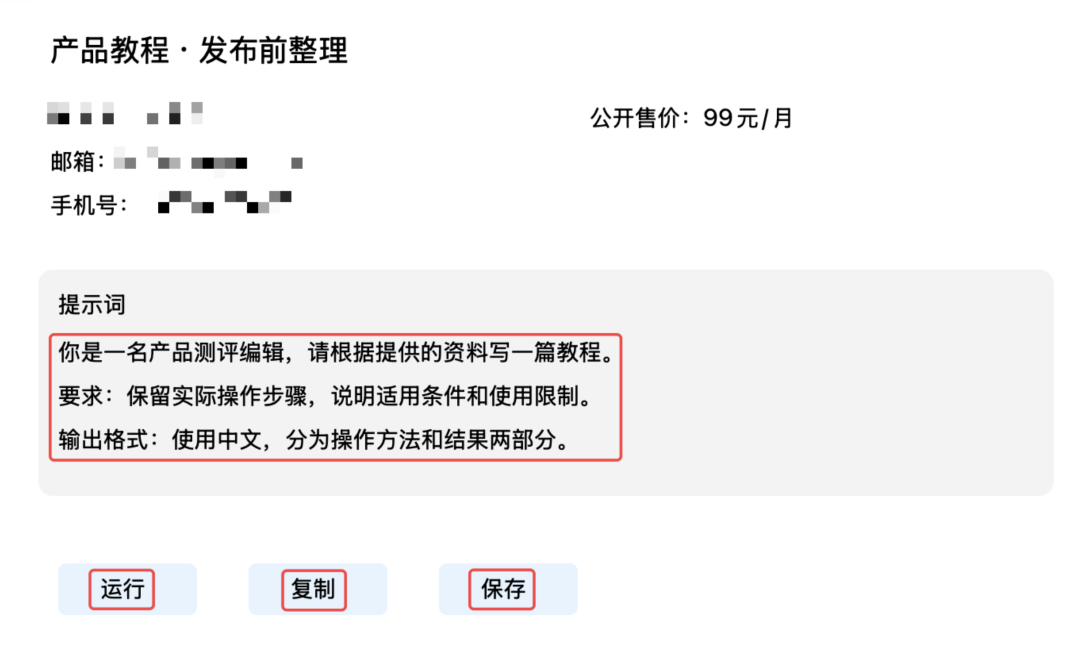
虽然这种功能用正常的大模型也能实现,但开源的小模型 Xing,不仅免费,而且非常快,非常适合在这种小节点上发挥作用。这就是属于它的位置。
所以,大家也可以想想自己的产品、自己的业务,是否有可以融入 Xing 的地方。不仅可以提高速率,还能本地部署使用,降低成本,还能保证数据私密性。
最后
写这篇文章的时候,我一直在思考一个问题。
做判断的 AI,早就有了。ChatGPT 出来之前,搜索广告要判断你爱不爱点击,邮箱要判断是不是垃圾邮件,小爱同学、Siri 这些语音助手背后,也是一套意图识别加槽位填充:先判断你想干嘛,再把时间、地点这些参数提取出来。
Xing4.0-29B-Intent 这次评测用到的 ATIS,是 1990 年的航空订票语料;SNIPS 是 2018 年一家语音助手公司放出来的数据集,都是老演员了。更好玩的是,最火的开源 Jev 平替 Laya,底座用的是 ModernBERT,算是 2018 年那个 BERT 的后代。
所以 Jev 爆火,是不是轮回?我觉得是。但要说是旧瓶装新酒,我不太认同。
以前的分类器,标签是训练时就写死的。想加一个查看摄像头回放的意图,得先标几千条数据,再重训一遍。小公司玩不起,所以大家宁愿用程序写规则,就像我第一份工作那样。现在的标签直接写在请求里,相当于现场出题,换一份意图清单就能用。这是有了大模型之后才做得到的,这些专用模型本身就是从大模型底座里练出来的。
再说说小模型。很多人可能觉得大模型越来越强,小模型就没活路了。我感觉不是。
Jev 这个名字取自经济学家杰文斯:蒸汽机越省煤,煤反而用得越多。AI 可能也一样,单次判断越便宜,用到的地方就越多。Agent 跑一圈,背后是成百上千次小判断,不可能每次都用最贵的那个模型。
但只会做选择题可能还不够。Agent 真要干活,最后都需要调工具,调工具要的是参数。光知道用户想开灯没用,得知道开哪盏、开多亮。所以我觉得,意图模型下一步拼的是谁能把参数填对、填全,这也是我觉得 Xing4.0-29B-Intent 这条路走对了的地方。
还有一点,Jev 目前只有托管 API,服务在美国西海岸。但手机、车机、智能家居对延迟和隐私都敏感,国内厂商要落地,大概率还得靠开源、能本地部署的模型。所以,我推荐有需要的朋友都去试试开源的 Xing4.0-29B-Intent。
对意图识别、参数抽取这类技术方向感兴趣的朋友,也欢迎到云栈社区和更多开发者一起交流。
 发表于 4 小时前
|
查看: 2|
回复: 0
 /1


