面试官这个连环问,说穿了是一道送分题,同时也是一道送命题。第一问大部分人能答上来,真正容易卡住的是第二问。今天就把这道题的完整逻辑捋一遍,下次再碰到,可以直接秒答。
一、主流范式:ReAct 循环
把这些 code agent 的“引擎盖”拆开看,会发现一个共同点:它们几乎都基于同一个核心模式——ReAct 循环,也就是 Reasoning 加上 Acting。
简单说,就是一个“思考、行动、观察”的循环。模型先推理下一步该做什么,然后调用工具去执行,拿到结果之后再继续推理,如此往复,直到任务完成。
举个例子:用户说“帮我修一下登录接口报 500 的 bug”,这个 agent 的循环大概是这样:
- 思考:这个报错可能跟登录逻辑有关,先看看相关代码
- 行动:调用 grep 工具搜索 "login" 相关的文件
- 观察:找到了
auth.py,把内容读出来
- 思考:发现某处调用了一个可能为空的字段,得看看调用方传的是什么参数
- 行动:搜索这个函数的调用点
- 观察:确认问题出在参数校验缺失上
- 思考:修复方案确定了,写代码,跑测试,看结果
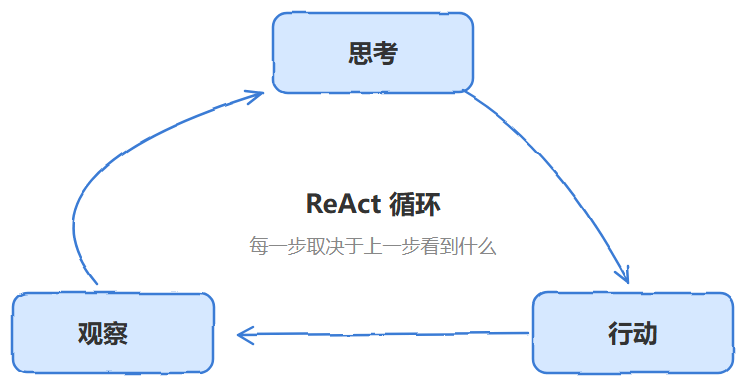
注意,这里没有一步是提前写死的。每一步都取决于上一步“看到”了什么,这就是 ReAct 循环最直观的体现。
围绕这个循环,有几个关键的设计要素,逐个来看。
第一个是工具化操作,也就是 Tool Use 或者说 Function Calling。
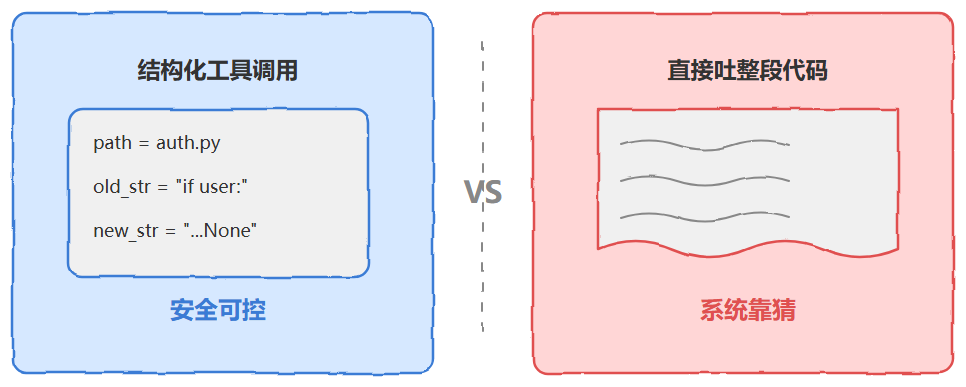
读文件、写文件、执行命令、搜索代码,这些操作全都被封装成结构化的工具调用,而不是让模型直接“生成代码去跑”。好处很明显:既安全,又可控。
比如 Claude Code 里面有 bash、str_replace、create_file、view 这些工具。模型要改一行代码,会调用类似 str_replace(path="auth.py", old_str="if user:", new_str="if user is not None:") 这样的结构化指令,而不是直接吐出一整段代码让系统自己去猜怎么应用。
第二个是上下文管理。
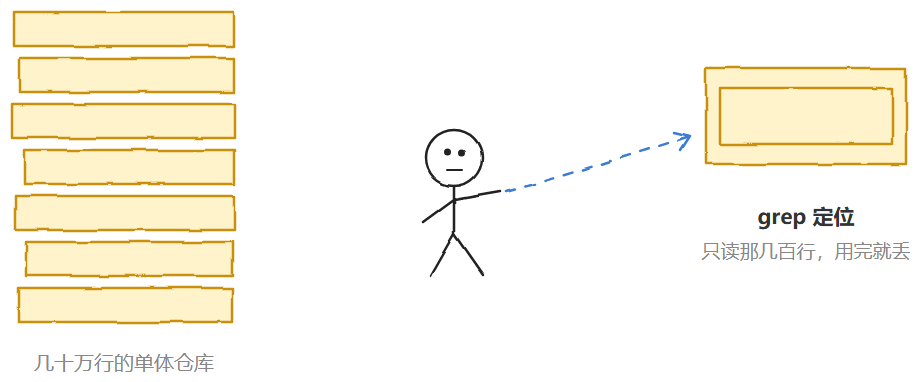
真实的代码库往往大到装不进上下文窗口。所以 agent 不会试图一次性把整个项目“读完”,而是靠 grep、向量检索、文件树导航这些方式按需获取信息。
比如一个几十万行代码的单体仓库,agent 不会尝试全部塞进上下文。它会先用 grep "class UserService" 定位目标文件,再针对性地读那几百行,用完就丢,需要的时候再检索。这种看代码的方式,其实跟人类工程师很像。
第三个是轻量级的计划与分解。
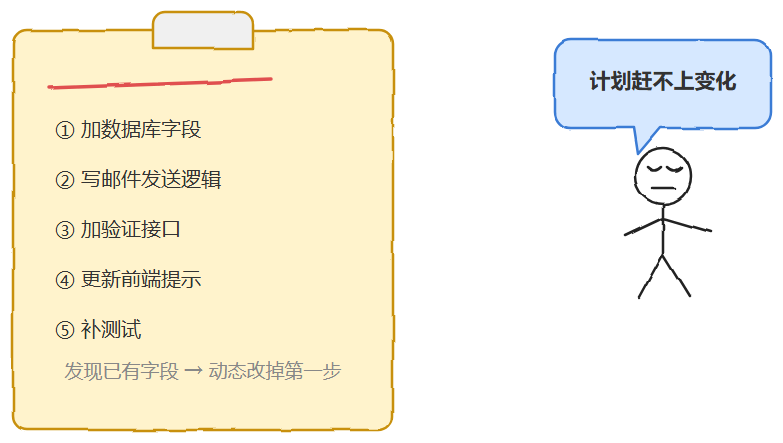
复杂任务会先拆成子任务,比如维护一份可以随时更新的 TODO 列表,而不是一次性把所有步骤写死。
拿“给项目加一个用户注册的邮箱验证功能”来说,agent 可能会先列出:加数据库字段、写发送验证邮件的逻辑、加验证接口、更新前端提示、补测试。但执行过程中如果发现数据库层已经有类似字段了,它就会动态调整列表,把第一步改掉,或者干脆删掉,而不是死板地按原计划走完。
第四个是验证闭环。
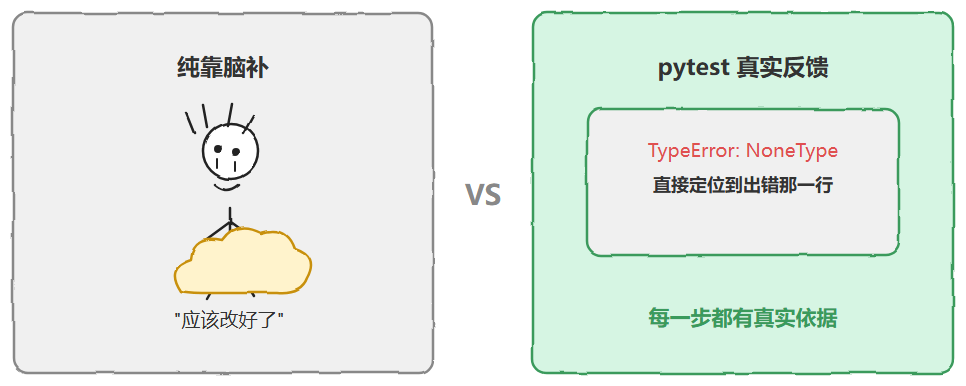
代码任务有个天然优势:可以被验证。跑测试、跑编译,看看报错,再回头修正。这个反馈闭环让 agent 的每一步都有真实依据,而不是靠“脑补”。
比如改完代码跑 pytest,如果报了 TypeError: NoneType has no attribute 'id',agent 能直接拿到具体的报错信息,定位到出问题的那一行,而不是凭感觉猜“应该改好了”。这种确定性的反馈,是写文案、做设计这类任务不具备的。
第五个是人在回路,也就是 Human-in-the-loop。
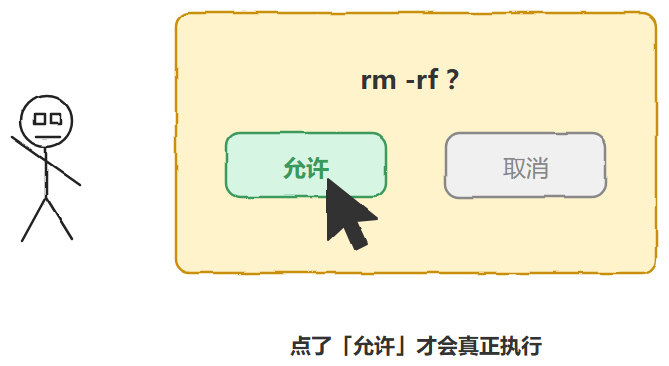
关键操作,比如执行命令、写文件,通常需要用户确认。这是安全性设计里很重要的一环。agent 想执行 rm -rf 或者 git push --force 这种有风险的命令,通常会先弹出确认框,等用户点了“允许”才真正执行,而不是“先斩后奏”。
至于架构上的变体,目前工业界主流还是单一强模型加上好用的工具集。多智能体编排(Multi-Agent)更多用在特定场景,比如需要并行探索、需要隔离上下文的时候,它并不是用来取代主循环的。
二、为什么不用其他模式?
更有意思的问题来了:为什么大家没有走向别的路线?一个一个拆开看。
‣ 不用纯 Plan-and-Execute(先定计划再执行)
早期一些 agent,像 BabyAGI,流行的是这种模式:先让模型把任务拆成一个完整计划,然后逐步执行。
但代码任务的不确定性太高了。你读了一个文件之后,才知道下一步该读哪个;编译报错之前,根本不知道会报什么错。提前把计划定死,一旦现实跟预期不符,就要频繁推倒重来,反而不如“走一步看一步”高效。
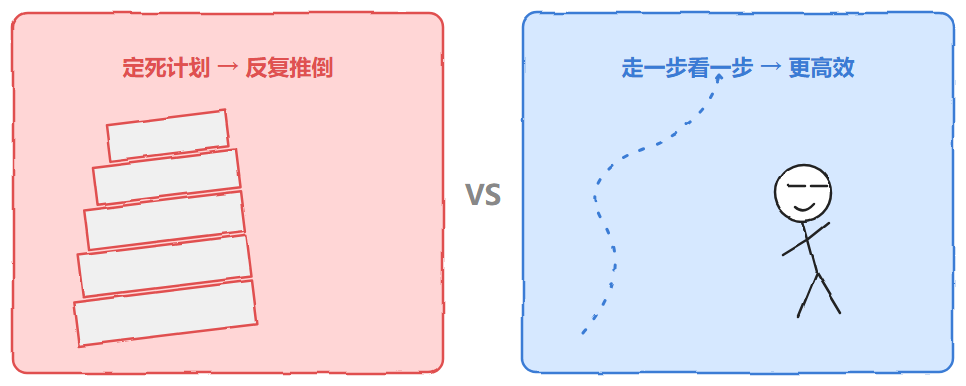
所以现在更常见的,是一种动态的、可以随时调整的轻量计划,而不是严格的“先规划、后执行”两阶段流程。
‣ 不用纯多智能体编排(Multi-Agent)
理论上你可以让“架构师 agent”“编码 agent”“测试 agent”分工协作,听起来挺美好,但实践中问题不少。
智能体之间传递上下文有损耗,容易“传话传歪”;协调开销大,排查“多个 agent 配合出错”比排查单个 agent 难得多。而且当单个模型的推理能力已经足够强时,人为拆分反而增加复杂度,收益有限。
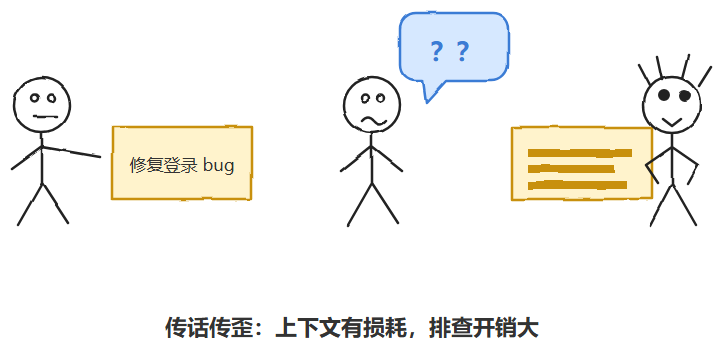
所以现在更流行的是“主 agent 加上按需派生的临时子任务执行者”这种轻量形态,而不是长期存在的多角色协作体系。比如 Claude Code 里的 sub-agent 机制:主 agent 遇到一个需要大量探索、但结果可以简单总结的子任务,比如“在整个仓库里找出所有用到某个废弃 API 的地方”,就会派生一个临时子 agent 专门跑搜索,拿到结果摘要后就结束,而不是让这个子 agent 长期存在、参与所有后续决策。
‣ 不用纯 Chain-of-Thought(无工具调用,纯靠“脑补”)
早期做法是让模型直接“想”出完整代码,一次性输出。但代码任务需要真实世界的反馈:当前文件到底长什么样?编译过没过?测试通没通过?纯靠模型内部推理,很容易产生幻觉——比如它以为某个函数存在,其实根本没有。
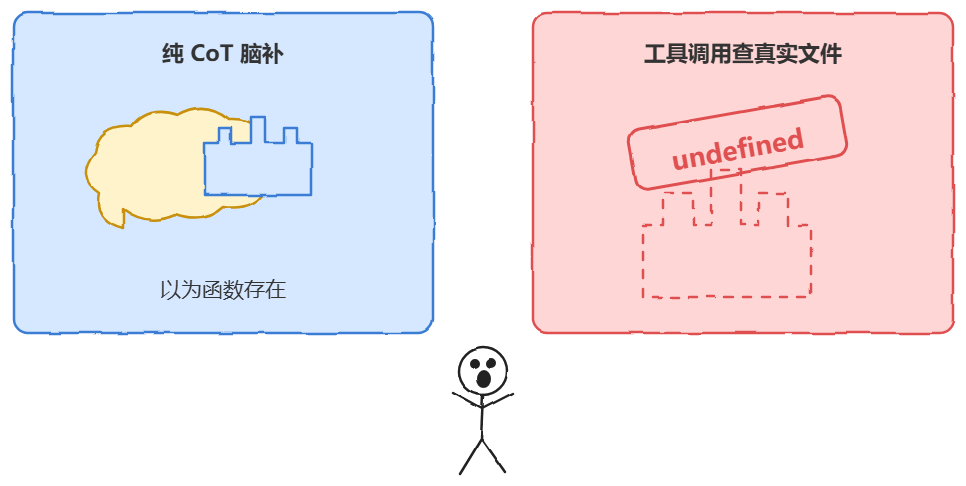
工具调用加上真实环境的反馈,才是解决这个问题的关键。这也是 ReAct 相对纯 CoT 的核心优势。
‣ 不用严格的工作流引擎/状态机
一些企业级系统会用预定义流程,比如“步骤一固定读代码,步骤二固定跑测试”。这在任务高度同质化的场景里很好用,固定 CI 流水线就是典型例子:“每次提交后自动跑 lint、跑单元测试、跑集成测试”,这种流程本来就该固定,不需要“智能”。
但代码任务的种类太多了:修 bug、加功能、重构、答疑。死板的流程很难覆盖这些长尾场景。同样是“修 bug”,有的只需改一行,有的需要跨多个模块排查根因。用同一套固定步骤去套,要么浪费步骤,要么覆盖不全,灵活性牺牲太多。
三、核心原因:三个约束决定了范式
说到底,代码任务有三个特别鲜明的特点:
- 环境是部分可观测的:代码库太大,装不进上下文。
- 有真实可执行的反馈:编译、测试能给出确定的信号。
- 路径高度依赖中间结果:下一步该做什么,往往取决于上一步“看到”了什么。
这三点共同决定了一件事:边推理、边行动、边观察的 ReAct 循环,比“提前定死计划”或“复杂角色分工”更贴合现实约束,也更容易调试和扩展。
这或许就是为什么,尽管 agent 设计的思路百花齐放,一旦落到“写代码”这个具体场景,大家最终都殊途同归了。如果你正在深入 Agent 开发,或者想系统补上从 RAG 到多智能体框架的完整链路,云栈社区上有不少实战导向的课程值得翻一翻,配合真实项目练手效果会更好。
 发表于 1 小时前
|
查看: 8|
回复: 0
 /1


