当前大模型分布式系统最核心的痛点,是随着模型规模与集群规模的持续扩张,通信开销在端到端训练中的占比不断攀升。在生产级 MoE 训练中,通信时间可占前向传播的 43.6%、端到端训练时间的 32%,部分场景下接近一半的执行时间都消耗在设备间数据传输上。
算力与网络的发展失衡正在加剧这一矛盾:新一代 GB300 NVL72 整机柜可提供 720 PFLOP/s 的 FP8 算力,但单张 GPU 跨机柜的出口带宽仅为 400-800 Gb/s,算力增速远远超过网络带宽的增长速度。如果不能更高效地隐藏通信开销,分布式系统的算力利用率将持续走低,集群扩展的边际效益也会越来越差。
内核级融合被认为是解决通信瓶颈的重要技术方向,通过在内核内部以 tile 粒度重叠计算与通信,可以大幅提升通信隐藏的粒度与效率。但现有融合内核方案大多局限于单个 NVLink 域内,跨节点通信始终需要独立的集合通信阶段完成,无法在内核内部与计算形成流水重叠,成为了融合性能进一步提升的核心瓶颈。
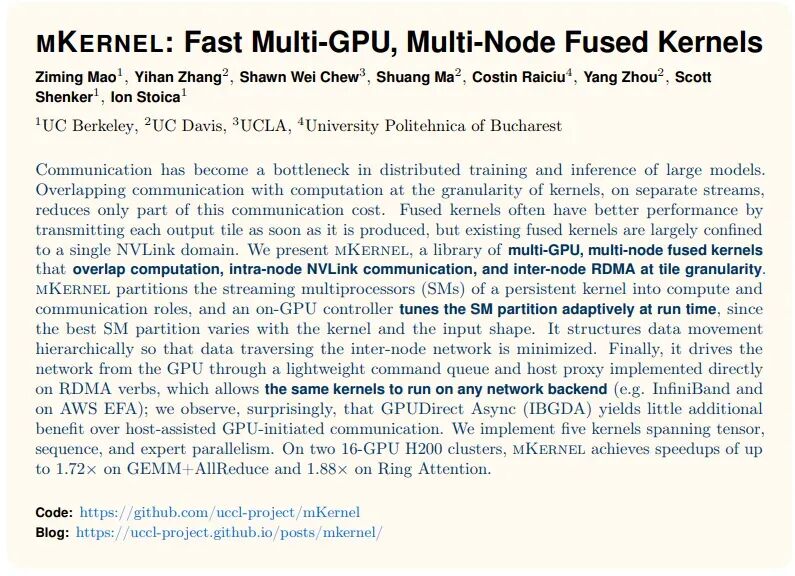
mKernel 的出现正是为了突破这一瓶颈。作为一套多 GPU、多节点融合内核库,mKernel 在单个持久内核内部实现了计算、节点内 NVLink 通信、跨节点 RDMA 通信的三层 tile 级重叠,通过 SM 专业化分工、分层数据移动、跨平台主机辅助通信、运行时自适应 SM 划分四大核心设计,将融合内核的边界从单节点拓展到了多节点。
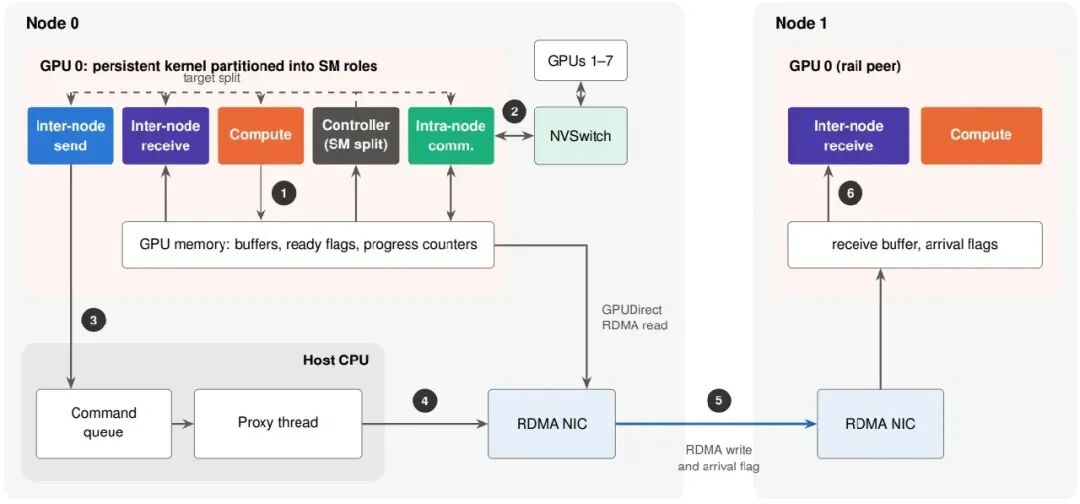
图 2:mKernel 架构图(双节点;每个节点仅详细展示一张 GPU)。每张 GPU 运行一个持久内核,其线程块被分配不同的功能角色。①计算线程块将完成的 tile 写入 GPU 内存并设置就绪标志。②节点内通信线程块通过 NVLink 与其余七张 GPU 交换 tile,利用 NVSwitch 实现广播与归约操作。③跨节点发送线程块将传输命令排入主机内存的队列。④主机代理线程将成批的命令提交给网卡。⑤网卡将数据传输到 1 号节点的对等 GPU;根据传输协议不同,由网卡或接收端代理通知数据到达。⑥接收线程块检测到到达标志后消费数据。可选的控制器读取进度计数器并发布目标通信块数量(虚线所示)。
在双节点 16 卡 H200 集群的测试中,mKernel 实现了 GEMM+AllReduce 最高 1.72 倍、Ring Attention 最高 1.88 倍的性能提升,同时兼容 InfiniBand 与 AWS EFA 两种主流网络架构,且无需针对每种输入尺寸做静态调优。
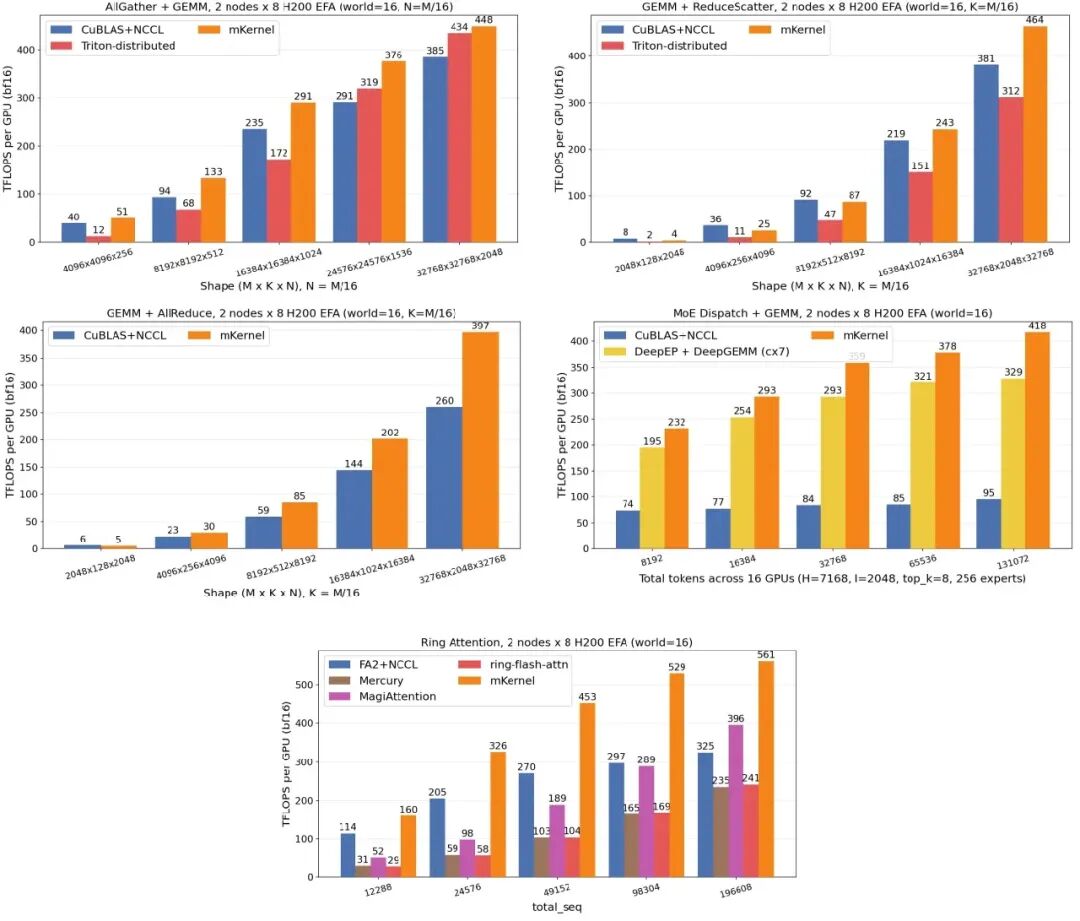
图 5:AWS EFA 测试平台的吞吐量结果(2 节点 ×8 张 H200;单位为单 GPU TFLOPS,数值越高越好)。橙色柱代表 mKernel。测试所用的 DeepEP+DeepGEMM 实现不支持 EFA;其柱体为 ConnectX-7 平台的测量值,仅作参考。该组实验验证了 mKernel 在公有云 EFA 网络环境下的通用性能优势,覆盖三大并行模式的五类内核。相比 cuBLAS/FlashAttention+NCCL 的非融合基线,mKernel 在所有场景下都取得了性能提升,其中 MoE Dispatch+GEMM 加速比可达 3.1-4.5 倍,Ring Attention 最高 1.78 倍,GEMM+AllReduce 最高 1.53 倍。相比其他融合内核方案如 Triton-distributed,mKernel 也普遍领先,尤其在小问题规模下优势更明显,因为细粒度融合能更有效抵消短序列下通信占比高的问题。DeepEP+DeepGEMM 即便在性能更强的 InfiniBand 平台上,也不如 EFA 平台上的 mKernel,进一步体现了 mKernel 融合设计的性能优势。
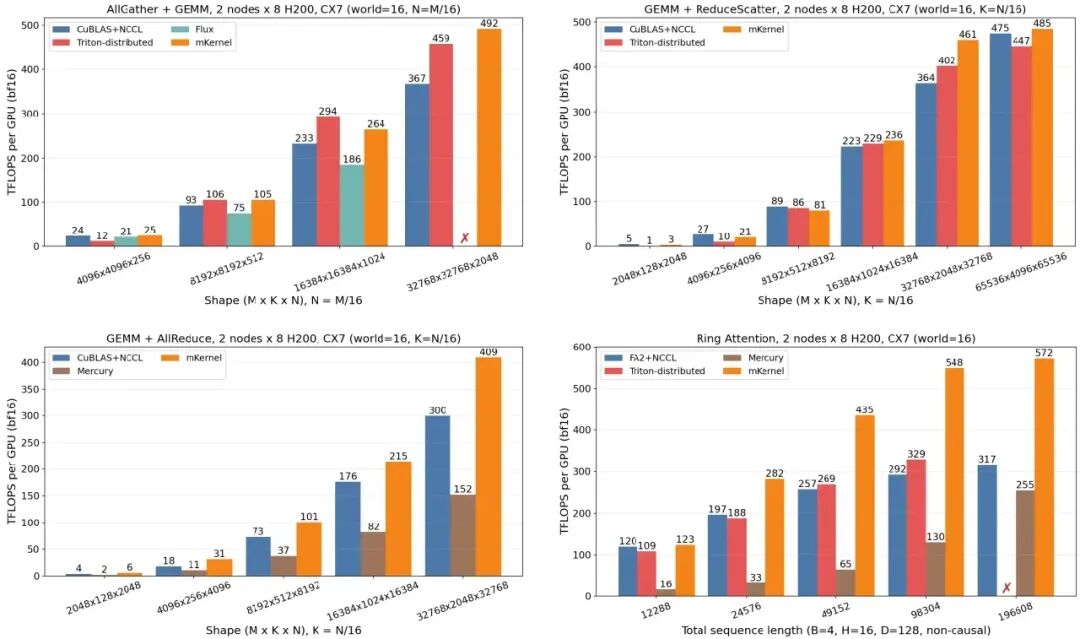
图 6:ConnectX-7 InfiniBand 测试平台的吞吐量结果(2 节点 ×8 张 H200;单位为单 GPU TFLOPS)。红色叉号代表对应基线在该问题规模下运行失败。该组实验是 mKernel 在高性能 InfiniBand 集群上的核心性能验证,也是论文最优性能结果的来源。相比非融合基线,GEMM+AllReduce 最高加速 1.72 倍,Ring Attention 最高加速 1.88 倍,AllGather+GEMM 最高 1.34 倍,全面领先各类基线方案。相比 Triton-distributed、Mercury、MagiAttention 等同类型融合方案,mKernel 在所有规模下都保持性能领先,且在长序列等基线无法运行的场景下仍能正常执行。InfiniBand 平台下性能提升略高于 EFA 平台,因为更低的网络延迟让 tile 级流水的优势能更充分发挥。该组结果充分证明了多节点融合内核架构的性能价值,能够有效缓解分布式大模型的通信瓶颈。
本文目录
- 一、分布式训练的通信困局:为什么内核级融合走到了跨节点这一步
- 1.1 从粗粒度到细粒度:通信隐藏的三代技术路径
- 1.2 跨节点融合的五大核心挑战
- 二、mKernel 整体架构:单内核内实现三层流水的 tile 级重叠
- 2.1 分层数据移动:用节点内聚合压缩跨节点流量
- 2.2 SM 专业化分工:角色实现与资源分配解耦
- 三、关键技术拆解:自适应 SM 划分与跨平台通信层的核心巧思
- 3.1 运行时自适应 SM 划分:让内核自己调整资源配比
- 3.2 跨平台通信层:主机代理为何胜过 GPUDirect Async
- 四、五类融合内核实现:覆盖三大并行范式的全场景支持
- 4.1 张量并行三类内核:从 AllGather 到 AllReduce 的全链路融合
- 4.2 序列与专家并行:长上下文与 MoE 场景的性能突破
- 五、实验性能全面评测:双网络环境下的性能验证
- 5.1 张量并行内核性能表现
- 5.2 专家与序列并行内核性能表现
- 5.3 自适应 SM 划分效果验证
- 六、行业启示与未来展望:融合内核的下一个阶段
- 6.1 分层通信是跨节点优化的核心思路
- 6.2 软件架构可以抵消硬件功能的差异
- 6.3 内核级资源动态调优是必然趋势
一、分布式训练的通信困局:为什么内核级融合走到了跨节点这一步
大模型分布式训练的性能优化史,本质上就是一部计算与通信的重叠效率提升史。从最初的算子级串行执行,到双流流水线重叠,再到内核内 tile 级融合,优化粒度越来越细,通信隐藏的效率也越来越高。
当融合优化深入到内核内部的 tile 粒度之后,单节点内的通信开销已经可以被很好地隐藏,但跨节点通信依然作为独立阶段存在,成为了新的性能瓶颈。要理解 mKernel 的价值,首先需要理清通信重叠技术的演进路径,以及跨节点融合面临的核心挑战。
1.1 从粗粒度到细粒度:通信隐藏的三代技术路径
通信隐藏的核心逻辑,是让计算与通信在时间上重叠,避免计算资源闲置等待数据。根据重叠粒度的不同,业界主流方案可以分为三类,图 1 清晰展示了三种调度方式的差异。
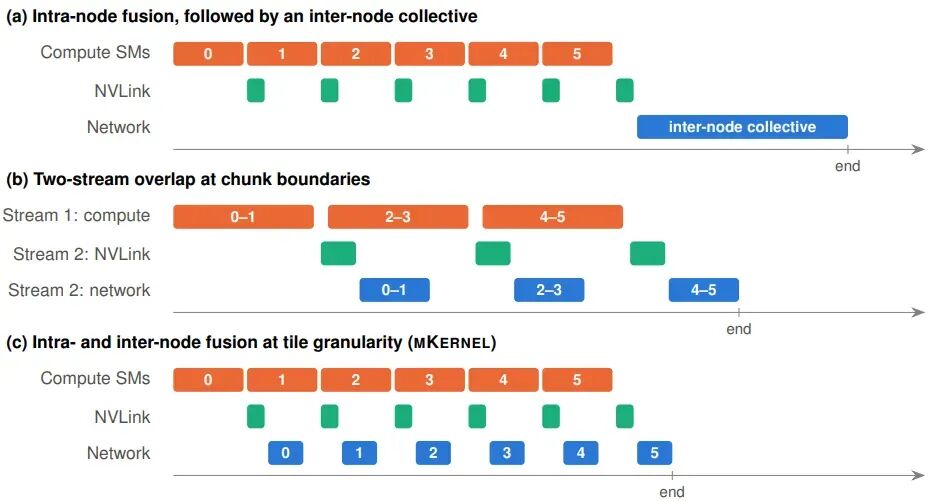
图 1:三种计算与通信调度方案。(a) 节点内融合后接独立的跨节点集合通信;(b) 双流方案在块边界重叠,每个生产者内核结束时释放一个数据块;(c) mKernel 在内核内部调度两层通信,暴露 tile 级就绪信号。现有计算内核本身就以 tile 为单位运行,因此 GEMM 计算效率不会受到影响。图中数字代表输出 tile 编号,宽度仅为示意,不代表实际比例。
-
第一种是节点内融合加独立跨节点集合通信,也就是图 1(a) 的模式。 这种方案将计算与节点内的 NVLink 传输做融合,但跨节点的网络通信依然作为独立的集合操作,在计算内核全部完成之后执行。其优势是实现简单,兼容性好,但跨节点通信完全无法与计算重叠,开销占比很高。
-
第二种是双流流水线重叠,对应图 1(b) 的模式。 这种方案将计算与通信放在不同的流上,把数据拆分成多个大块,计算完一个块就立刻启动该块的通信,同时计算下一个块。这种模式的重叠粒度是块级别,相比全串行有明显提升,但每个块都需要等待内核边界才能释放,依然存在不小的气泡。
-
第三种就是 tile 级内核融合,对应图 1(c) 的 mKernel 方案。 这种方案将通信的粒度细化到内核内部的计算 tile,每生成一小块输出 tile,就可以立刻启动对应的传输,无需等待整个内核或整个块完成。这种模式的重叠粒度最细,通信隐藏效率最高,但实现难度也最大,尤其是跨节点场景下。
现有大多数融合工作都集中在单节点场景,跨节点融合的成熟方案非常少。而随着集群规模越来越大,跨节点通信的占比持续升高,单节点融合带来的收益已经逐渐触顶,跨节点内核级融合成为了必须突破的方向。
1.2 跨节点融合的五大核心挑战
跨节点融合之所以难以实现,根源在于节点内与跨节点的通信路径存在本质差异,无法用统一的方式处理。作者总结了五大核心挑战:
| 挑战维度 |
核心问题描述 |
| 带宽不对称 |
节点内 NVLink 单卡带宽可达 450 GB/s,跨节点网络仅约 50 GB/s,两者相差近 9 倍,不能同等对待 |
| 传输粒度不对称 |
节点内通信是内存语义,可直接操作对等端显存;跨节点是消息语义,每个 RDMA 请求都有独立开销 |
| 传输序语义差异 |
InfiniBand 可靠连接保证写入顺序,AWS EFA 的 SRD 传输不保证顺序,完成标志不能直接依赖写入顺序 |
| 跨设备同步开销 |
网络完成事件与 GPU 内存可见性之间存在同步开销,频繁全局同步会抵消融合收益 |
| SM 分配适配性 |
不同内核、不同输入尺寸下,计算与通信的最优 SM 配比差异极大,静态配置无法适配所有场景 |
这五大挑战层层递进,从底层的硬件带宽差异,到编程模型的语义差异,再到上层的资源调度问题,共同构成了跨节点融合内核的设计门槛。mKernel 的整套架构设计,也正是围绕着逐一解决这五大挑战展开的。
总而言之,单节点融合已经无法匹配大模型跨节点分布式的性能需求,跨节点内核级融合是进一步隐藏通信开销的必经之路。带宽、粒度、语义、同步、资源分配这五大挑战,是所有方案都必须跨越的门槛。
二、mKernel 整体架构:单内核内实现三层流水的 tile 级重叠
mKernel 的核心设计目标,是在单个持久内核内部,同时完成计算、节点内 NVLink 通信、跨节点 RDMA 通信三个阶段的 tile 级重叠,让每一块输出 tile 一旦生成就可以立刻进入后续传输链路,无需等待整个内核完成。
为了实现这一目标,mKernel 采用了持久内核加 SM 专业化分工的架构,将 GPU 的流多处理器按功能划分为计算、节点内通信、跨节点发送、跨节点接收四类角色,配合分层数据移动机制与主机代理通信层,实现端到端的 tile 级流水。图 2 完整展示了双节点场景下的架构细节。
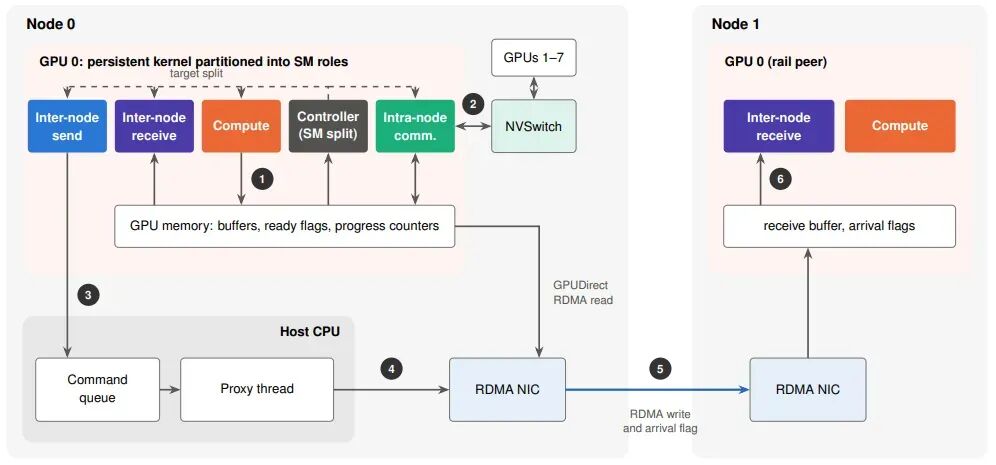
图 2:mKernel 架构示意图(双节点,每个节点仅详细展示一个 GPU)。每个 GPU 运行一个持久内核,其线程块被分配不同角色:1. 计算块将完成的 tile 写入显存并设置就绪标志;2. 节点内通信块通过 NVLink 与其他七个 GPU 交换 tile,用 NVSwitch 完成广播与规约;3. 跨节点发送块将传输命令写入主机内存的队列;4. 主机代理线程将批量命令提交给 NIC;5. NIC 将数据传输到对端节点的 rail peer GPU,传输完成后由 NIC 或接收代理发出到达信号;6. 接收块检测到标志后消费数据。可选的控制器读取进度计数器,发布通信块的目标数量。
整个数据流转可以分为六个步骤,从计算生成 tile 到远端消费数据,全程在内核运行过程中并行推进。计算 SM 持续生成新的 tile,通信 SM 持续处理就绪的传输任务,主机代理持续批量提交网络请求,三者形成独立又协同的流水,没有统一的全局同步点,只通过就绪标志传递进度。
这种设计的核心优势,是完全消除了内核边界带来的通信延迟。 传统方案中,通信必须等整个内核执行完毕才能启动,而 mKernel 中第一块 tile 计算完成后,几乎立刻就可以进入传输流程,整个内核的执行过程中,通信链路始终处于满载状态,大幅提升了带宽利用率。
2.1 分层数据移动:用节点内聚合压缩跨节点流量
针对带宽不对称的核心挑战,mKernel 采用了分层数据移动的设计,也就是先在节点内通过 NVSwitch 完成数据聚合或复制,再进行跨节点传输,尽可能减少经过低速网络的数据量。
这一设计基于 rail 优化的拓扑结构,也就是当前集群中普遍部署的架构:跨节点的数据交换只在相同本地索引的 GPU 之间进行,这些 GPU 被称为 rail peer,节点内的数据移动则全部通过 NVLink 和 NVSwitch 完成。比如双节点各 8 张 GPU 的场景下,节点 0 的 0 号 GPU 只和节点 1 的 0 号 GPU 做跨节点通信,节点内的其他 GPU 需要收发跨节点数据时,都通过 0 号 GPU 中转。
以 GEMM+AllReduce 为例,完整的分层传输流程是:首先每个节点内部的 8 张 GPU 通过 NVSwitch 完成规约,每张 GPU 负责八分之一的输出 tile;然后每张 GPU 只需要把自己负责的这部分部分和,发送给对端的 rail peer;两边合并得到最终结果后,再通过 NVSwitch 在节点内广播给所有 GPU。整个过程中,跨节点传输的数据量只有总数据量的八分之一,大幅降低了网络链路的压力。
除了分层传输之外,mKernel 还做了粒度解耦的设计:计算 tile 的大小、节点内传输的粒度、跨节点网络 chunk 的大小,三者可以独立设置,不需要保持一致。这样做的好处是,计算 tile 可以保持最优的计算效率,网络 chunk 可以设置得更大来分摊单消息的固定开销,同时又不会因为 chunk 太大而导致传输启动过晚。比如 GEMM+AllReduce 场景下,每 4 个本地规约后的 tile 会组成一个 256 KiB 的网络 chunk,只要这 4 个 tile 全部就绪,就可以立刻发起网络传输,不需要等待整个 GEMM 完成。
2.2 SM 专业化分工:角色实现与资源分配解耦
mKernel 采用持久内核的设计,也就是内核启动后持续运行,直到所有任务完成再退出,而不是启动一次处理一批数据。持久内核中的线程块被划分为不同的功能角色,分别负责计算、节点内通信、跨节点发送、跨节点接收。
这种专业化分工的价值,是将角色的实现逻辑与资源分配数量解耦。 计算块的 warp 布局、寄存器分配等可以完全针对计算优化,不需要考虑通信功能;通信块的实现也可以专门针对传输效率优化。调整计算与通信的资源配比时,只需要修改分配给每个角色的 SM 数量,不需要改动各自的核心实现,大大提升了灵活性。
角色之间的协作完全通过内存中的就绪标志和进度计数器完成,没有复杂的同步原语。计算块完成一个 tile 后,就更新对应的就绪标志;通信块轮询就绪标志,发现就绪的 tile 就立刻处理。这种轻量的协作方式,保证了 tile 级调度的低开销。
总而言之,mKernel 通过分层通信架构把跨节点流量降到最低,通过粒度解耦设计平衡传输开销与启动时机,通过 SM 角色特化实现资源的灵活调配,三者共同构成了跨节点融合内核的底层支撑。
三、关键技术拆解:自适应 SM 划分与跨平台通信层的核心巧思
跨节点融合内核的性能上限,往往取决于两个核心要素:计算与通信资源的动态配比是否合理,以及跨节点通信路径的开销是否足够低。mKernel 在这两点上都给出了不同于业界常规思路的解决方案。
很多融合内核方案都需要针对每个输入尺寸,提前通过扫描测试找到最优的计算通信 SM 配比,使用成本很高,而且无法适配动态变化的负载。同时,跨节点通信通常依赖特定的网络硬件或软件栈,兼容性较差,不同的网络环境需要不同的实现。
mKernel 针对这两个痛点,分别设计了运行时自适应 SM 划分控制器,以及基于主机代理的跨平台 GPU 发起通信层。 前者让内核可以自动调整资源配比,接近最优性能;后者让同一套内核代码可以无缝运行在 InfiniBand 和 AWS EFA 两种完全不同的网络上,且性能表现超出预期。
3.1 运行时自适应 SM 划分:让内核自己调整资源配比
静态 SM 划分的最大问题,是最优配置随工作负载变化的幅度非常大。作者在单节点 8 卡 H100 上做了静态扫描测试,不同内核、不同输入尺寸下,最优的通信 SM 数量从 2 个到 64 个不等,最差配置的延迟可以达到最优配置的 25 倍,如果只用一套固定配置,性能损失会非常严重。
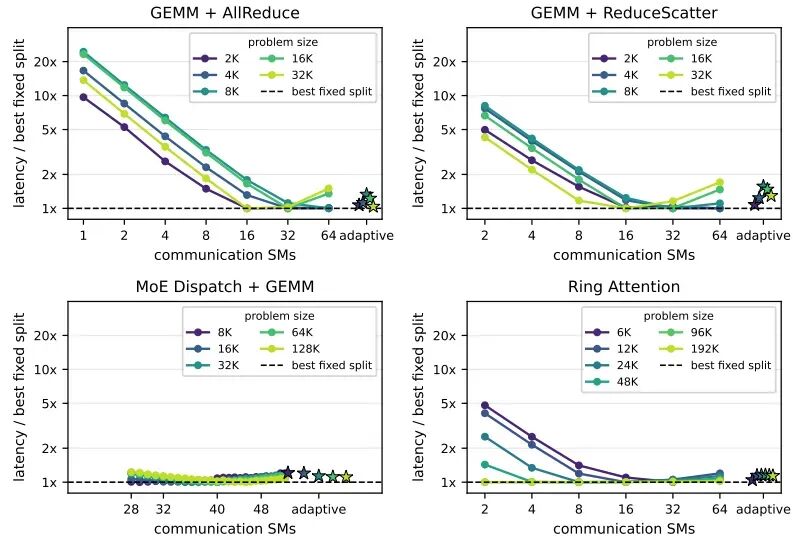
图 3:SM 划分的静态扫描结果(单节点,8 张 H100 GPU)。每条曲线代表一种问题尺寸的延迟,以该尺寸下最优固定 SM 划分的延迟为基准做归一化。右侧的星号标记代表自适应控制器在相同尺寸下的延迟。
从图 3 中可以清晰看到,不同尺寸的最优配置差异极大,没有任何一个固定的 SM 数量可以适配所有场景。 比如小尺寸下需要的通信 SM 很少,过多的通信 SM 会挤占计算资源;大尺寸下通信压力大,需要更多的 SM 来处理传输,否则会成为瓶颈。
mKernel 的自适应控制器,就是为了解决这个问题。控制器运行在 GPU 上,通过线程块累计的周期计数器,估算每个角色处理单个任务的平均成本;再根据当前剩余的计算任务量和通信任务量,计算出使两者预计完成时间相等的最优 SM 分配比例,动态更新目标值。
其核心计算思路可以概括为:设 $N_{comm}$ 为目标通信 SM 数量,$N_{SM}$ 为总 SM 数量,$R_{comp}$ 为剩余计算任务数,$R_{comm}$ 为剩余通信任务数,$C_{comp}$ 为单个计算任务的估算周期成本,$C_{comm}$ 为单个通信任务的估算周期成本。控制器通过让计算与通信的预计完成时间相等来推导目标值:
$$N_{comm} = N_{SM} \cdot \frac{R_{comm} \cdot C_{comm}}{R_{comp} \cdot C_{comp} + R_{comm} \cdot C_{comm}}$$
这个公式的核心意图在于:如果剩余通信任务多、单任务成本高,就分配更多的 SM 给通信;如果计算任务更重,就多分配 SM 给计算,目标是让两个阶段同时完成, 避免出现一个阶段干完了等另一个的情况。
每个线程块在完成一个任务后,都会检查当前的目标分配值,如果自己的角色和目标不符,就切换到对应的角色。整个调整过程完全在内核运行过程中自动完成,不需要主机介入,开销非常低。
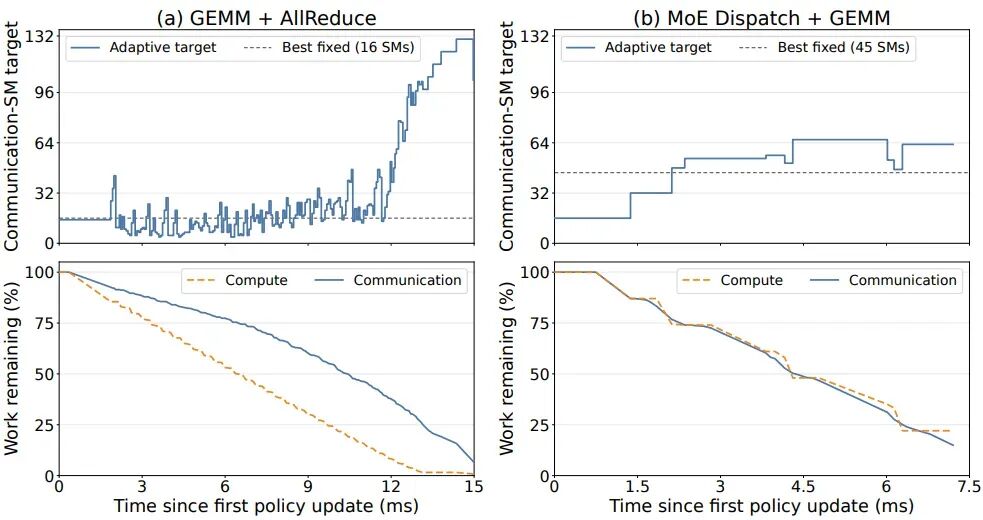
图 7:自适应 SM 划分调优过程。(a) GEMM+AllReduce 场景(M=N=32K,K=4K),随着计算接近完成,目标逐渐向通信倾斜;(b) MoE Dispatch+GEMM 场景(128K 总 token 数),计算与通信进度相近时,分发 SM 的目标保持稳定。灰色虚线代表最优固定划分,分别为 16 个和 45 个通信 SM。
从图 7 的动态调整过程可以看到,GEMM+AllReduce 场景下,前期计算任务重,分配给计算的 SM 更多;随着计算任务逐渐完成,越来越多的 SM 切换到通信角色,加快收尾阶段的传输速度,避免计算干完了通信还剩一大堆的情况。
测试结果显示,自适应模式相比每个尺寸下的最优静态配置,几何平均仅慢 1.18 倍,也就是损失不到 20% 的性能,但省去了针对每个输入尺寸的调优成本,易用性大幅提升。对于输入形状多变的生产场景,这种自适应模式的实际综合收益反而更高。
3.2 跨平台通信层:主机代理为何胜过 GPUDirect Async
跨节点通信层是 mKernel 最具颠覆性的设计之一。业界通常认为,要实现 GPU 发起的高性能网络通信,必须用 GPUDirect Async(IBGDA),让 GPU 直接操作 NIC 的工作队列,绕过 CPU。但 mKernel 的测试结果却得出了反常识的结论:主机辅助的 GPU 发起通信,性能和 GPUDirect Async 几乎没有差别,甚至部分场景下更优。
mKernel 的通信层采用 GPU 生成命令、主机代理提交到 NIC 的架构,完全基于 libibverbs 实现,不依赖 NCCL、NVSHMEM 等上层库。
具体流程是:GPU 端的发送 SM 将 48 字节的传输命令写入主机钉选内存的环形缓冲区,命令包含对端信息、源目地址偏移、字节数、chunk ID;主机上的代理线程持续轮询这个环形队列,收集到就绪的命令后,批量提交给 NIC;NIC 通过 GPUDirect RDMA 直接从 GPU 显存读取 payload,不需要经过主机内存中转。
这种设计有两个核心优势:
- 第一是批量提交。 代理可以把最多 8 个命令合并成一次提交,大幅分摊每个请求的固定提交开销。
- 第二是跨平台兼容性。 因为所有和 NIC 交互的逻辑都在主机代理层,所以只需要修改代理的实现,就可以适配不同的网络后端,GPU 端的内核代码完全不用改。
针对不同传输的语义差异,mKernel 也做了适配:
| 网络类型 |
传输顺序特性 |
完成通知方式 |
| ConnectX-7 InfiniBand |
每个 RC 连接内保序 |
先写数据,再写标志位,依靠连接保序保证数据先于标志到达 |
| AWS EFA (SRD) |
数据报不保序 |
使用带立即数的 RDMA 写,接收端代理收到完成事件后再置标志位 |
InfiniBand 的可靠连接可以保证同一个连接上的写入顺序,所以直接发两次写操作即可,接收端直接轮询显存里的标志,不需要主机介入。而 EFA 的 SRD 传输不保证顺序,如果单独写标志,可能标志比数据先到,导致接收端读到错误的数据。所以 EFA 下用带立即数的 RDMA 写,接收端的主机代理会收到完成事件,确认数据到达后再设置标志位,保证正确性。
作者还专门对比了主机辅助方案和 GPUDirect Async(IBGDA)的性能,结果如图 4 所示。
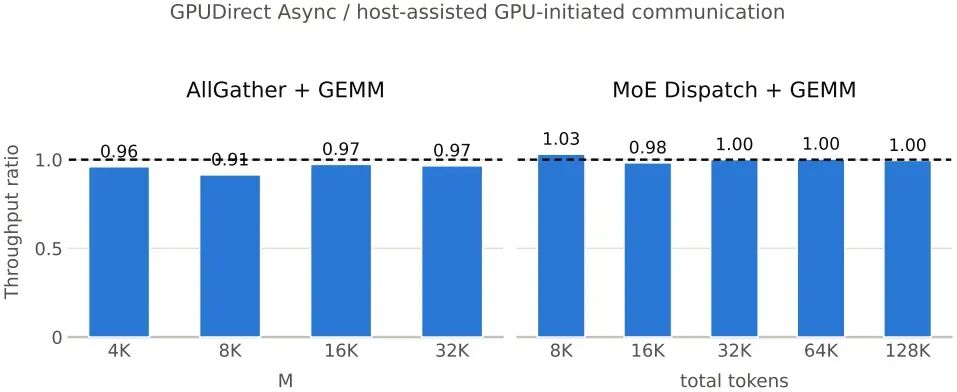
图 4:GPUDirect Async(IBGDA)与主机辅助 GPU 发起通信的性能对比(ConnectX-7 测试床,2 节点 ×8 H200,内核完全相同)。柱状图为吞吐量比值,分子是 GPUDirect Async 的性能,虚线代表两者持平。
从结果可以看到,所有测试场景下,两者的性能比值都在 1 左右,GPUDirect Async 没有带来明显的性能提升。 原因在于,GPUDirect Async 每个 chunk 都需要触发系统级的 GPU 栅栏和门铃操作,开销并不低;而主机辅助方案可以批量提交多个命令,而且代理的运行和 GPU 计算是完全重叠的,不会占用计算时间。
这个结论意味着不需要依赖专用的 GPUDirect Async 硬件支持,仅通过通用的主机代理方案,就可以实现高性能的 GPU 发起通信,同时还能获得跨平台兼容性,大幅降低部署门槛。
回顾来看,自适应 SM 划分消除了静态调优的繁琐,让内核在任意输入下都接近最优性能;主机辅助的 GPU 发起通信兼顾了跨平台兼容性与高性能,甚至反超了专用硬件加速方案,这两项技术是 mKernel 能够落地实用的关键支柱。
四、五类融合内核实现:覆盖三大并行范式的全场景支持
mKernel 基于统一的架构底座,实现了五类融合内核,完整覆盖张量并行、序列并行、专家并行三大主流分布式并行策略,几乎可以适配当前大模型训练推理中所有主流的通信+计算融合场景。
这五类内核复用了底层的 SM 分工框架、分层通信机制、自适应控制器和跨平台通信层,只针对每种场景的数据依赖和通信模式做了上层调度优化。 下表总结了五类内核的核心特性。
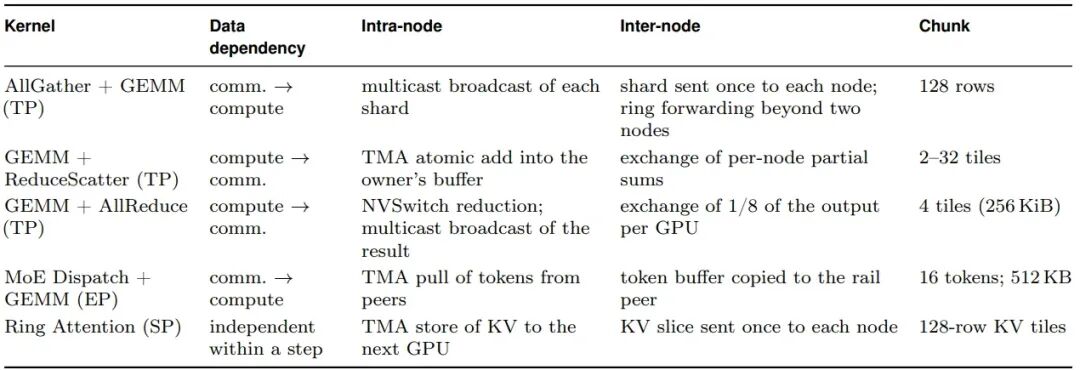
表 3:mKernel 实现的融合内核列表。TP、SP、EP 分别代表张量并行、序列并行、专家并行。
4.1 张量并行三类内核:从 AllGather 到 AllReduce 的全链路融合
张量并行是当前大模型最核心的并行方式之一,其核心操作包括 AllGather、ReduceScatter、AllReduce 三类,分别对应权重输入分发、输出结果聚合、梯度聚合等场景。mKernel 针对这三类操作都实现了和 GEMM 的融合内核。
-
AllGather+GEMM 是通信到计算的依赖模式,也就是先收集所有分片的权重,再做矩阵乘法。 mKernel 的调度策略是内核启动时就立刻发起跨节点的分片传输,每个节点只需要接收一次远端分片,由 rail peer 接收后通过 NVSwitch 在节点内广播。计算端按照本地分片、节点内其他分片、远端分片的顺序依次处理,数据就绪就立刻计算,不需要等所有分片都到齐。这种调度方式可以让跨节点传输和计算完全重叠,大幅隐藏通信延迟。
-
GEMM+ReduceScatter 是计算到通信的依赖模式,也就是先算完矩阵乘法,再把结果规约后分散到各个 GPU。 计算生成 tile 后,先通过 TMA 原子加操作,累加到节点内对应所有者 GPU 的缓冲区中;完成节点内的规约后,再通过跨节点链路交换每个节点的部分和,最终每个 GPU 得到自己负责的那部分结果。
-
GEMM+AllReduce 是性能提升最显著的张量并行内核。 它结合了节点内 NVSwitch 规约和跨节点 rail peer 交换,每个 GPU 只需要传输八分之一的输出数据,跨节点流量非常小。同时计算、节点内规约、跨节点传输三个阶段完全流水重叠,因此可以获得非常高的性能收益。
4.2 序列与专家并行:长上下文与 MoE 场景的性能突破
除了张量并行之外,mKernel 还覆盖了序列并行和专家并行两个快速增长的场景,对应的内核分别是 Ring Attention 和 MoE Dispatch+GEMM。
Ring Attention 是序列并行的核心实现,通过将 KV 缓存沿序列维度切分,在 GPU 环上依次传递,实现超长上下文的注意力计算。传统的 Ring Attention 实现中,KV 块的传输需要等待内核边界,而 mKernel 将传输粒度细化到 tile 级,每个 KV tile 计算完成后就立刻向下一个 GPU 传递,计算和传输完全重叠。 跨节点场景下,每个节点只需要发送一次 KV 切片,节点内通过 NVLink 完成转发,大幅降低跨节点的传输次数。
MoE Dispatch+GEMM 是专家并行的核心操作,需要先将 token 路由到对应的专家 GPU,再执行专家的矩阵乘法。传统方案中,all-to-all 的 token 分发是独立阶段,开销非常大。mKernel 将分发和 GEMM 做融合,token 缓冲区只需要在 rail peer 之间复制一次,节点内通过 TMA 直接从对等 GPU 拉取 token,边分发边计算,大幅降低了通信开销。测试显示,这个内核的性能提升是所有内核中最大的,相对未融合方案有数倍的提升。
总之,mKernel 的五类内核并非零散实现,而是基于统一的分层通信与 SM 分工框架,针对不同数据依赖与通信模式做了定向调度优化,实现了对主流分布式并行范式的全覆盖。
五、实验性能全面评测:双网络环境下的性能验证
研究团队在两套双节点 16 卡 H200 集群上完成了完整测试,一套采用 ConnectX-7 InfiniBand 网络,一套采用 AWS EFA 网络,单卡网络带宽均为 400Gb/s,完整覆盖了高性能计算集群与云原生集群两种典型部署场景。
测试的基线方案分为两类:一类是未融合的基础方案,使用 cuBLAS 或 FlashAttention 加对应的 NCCL 集合通信;另一类是当前业界主流的融合或通信重叠方案,包括 Triton-distributed、FLUX、Mercury、DeepEP+DeepGEMM、MagiAttention、ring-flash-attention 共七种。所有测试都经过预热,取最慢 rank 的执行时间作为结果,更符合真实流水线的约束。
5.1 张量并行内核性能表现
张量并行的三个内核分别在两套集群上做了完整测试,EFA 集群的结果如图 5 所示,InfiniBand 集群的结果如图 6 所示。
图 5:AWS EFA 测试床的吞吐量结果(2 节点 ×8 H200,单位为单卡 TFLOPS,越高越好)。橙色柱为 mKernel 的性能。DeepEP+DeepGEMM 的实现不支持 EFA,其柱为 ConnectX-7 上的测试结果,仅作参考。
图 6:ConnectX-7 InfiniBand 测试床的吞吐量结果(2 节点 ×8 H200,单位为单卡 TFLOPS)。红色叉号代表对应基线在该问题尺寸下运行失败。
-
AllGather+GEMM 场景下,mKernel 在所有测试尺寸下都优于 cuBLAS+NCCL 的未融合方案,在 EFA 集群上最高提速 1.41 倍,在 ConnectX-7 集群上最高提速 1.34 倍。收益主要来自跨节点传输的提前启动,以及和 GEMM 计算的完全重叠。
-
GEMM+AllReduce 场景下,mKernel 的提升幅度最大,EFA 集群最高提速 1.53 倍,ConnectX-7 集群最高可达 1.72 倍。如此高的收益主要来自两个方面:一是分层规约将跨节点流量降到了原来的八分之一,大幅降低了网络传输量;二是计算、节点内规约、跨节点传输三层完全重叠,几乎完全隐藏了通信开销。
-
GEMM+ReduceScatter 场景下,mKernel 在大尺寸问题上优势更明显,当 M≥16K 时,提速幅度在 1.02 到 1.27 倍之间,且多数输入尺寸下优于 Triton-distributed 方案。
整体来看,InfiniBand 集群上的绝对性能更高,但 mKernel 的相对提升幅度也更大,说明在网络性能更好的环境下,内核级融合能够更充分地挖掘带宽潜力。
5.2 专家与序列并行内核性能表现
MoE Dispatch+GEMM 场景下,mKernel 的性能提升最为突出。在 EFA 集群上,相比未融合的 all-to-all 加 GEMM 方案,提速幅度达到 3.1 到 4.5 倍。这其中既包含通信重叠带来的收益,也包含专家计算组织优化带来的提升。 同时,mKernel 的表现也优于 DeepEP+DeepGEMM 方案。
Ring Attention 场景下,mKernel 的表现同样亮眼。EFA 集群最高提速 1.78 倍,ConnectX-7 集群最高提速 1.88 倍,接近两倍的性能提升。和其他分布式注意力实现相比,优势更加明显:比 MagiAttention 快 1.4 到 3.3 倍,比 ring-flash-attention 快 2.3 到 5.6 倍,比 Mercury 快 2.2 到 8.6 倍。
值得注意的是,序列越短,mKernel 的相对优势越大。 因为短序列下,注意力计算的时间很短,通信开销占比更高,传统方案很难摊销通信的固定开销;而 mKernel 的 tile 级细粒度重叠,可以在很短的计算时间内依然有效隐藏通信,因此收益更显著。这对于实际推理场景非常有价值,因为推理的序列长度通常分布较广,短序列占比很高。
5.3 自适应 SM 划分效果验证
作者还专门验证了自适应 SM 划分的效果。静态扫描的结果显示,不同工作负载的最优通信 SM 数量从 2 个到 64 个不等,跨度非常大,如果使用固定的单一配置,很多场景下会出现数倍的性能损失。
自适应模式的表现非常接近每个场景下的最优静态配置,21 个测试配置下的几何平均性能,达到了最优静态配置的 1.18 倍以内,也就是损失不到两成的性能。 但换来的是完全免调优,不需要针对每个内核、每个输入尺寸提前做扫描测试,大幅降低了使用门槛和维护成本。
对于生产环境来说,输入形状往往是动态变化的,不可能为每种情况都预置最优配置,这种自适应模式的实际价值会比纸面性能数据更高。它让融合内核可以在保持高性能的同时,具备很好的通用性和易用性。
总而言之,mKernel 在两套完全不同的网络环境下都实现了稳定且显著的性能提升,在短序列、MoE 等通信敏感场景下收益尤为突出,同时自适应模式很好地平衡了性能与易用性。
六、行业启示与未来展望:融合内核的下一个阶段
mKernel 的出现,标志着 GPU 融合内核正式从单节点走向了多节点,也为分布式 AI 系统的通信优化打开了新的技术路径。其背后的设计思路,对整个 AI Infra 领域都有值得借鉴的价值。
这项工作关键在它验证了几个重要的技术方向,改变了很多业界固有的认知。
6.1 分层通信是跨节点优化的核心思路
算力与网络的带宽差距还会持续扩大,单纯依靠升级网络硬件来解决通信问题,成本会越来越高。而通过软件架构的优化,利用节点内的高速互联做数据聚合与分发,减少跨节点的流量,是性价比高得多的优化方向。
mKernel 的分层通信设计,本质上是用充足的节点内带宽资源,去弥补跨节点带宽的不足。 这种思路可以复制到很多其他分布式优化场景中,比如集合通信算法优化、分布式推理调度等等。随着节点内 GPU 数量越来越多,NVLink 带宽越来越高,这种分层优化的收益还会持续增大。
6.2 软件架构可以抵消硬件功能的差异
GPUDirect Async 一直被认为是 GPU 发起通信的黄金标准,很多方案都把支持 IBGDA 作为核心卖点。但 mKernel 的测试结果证明,设计良好的主机代理方案,性能完全可以和专用硬件加速方案持平,同时还具备跨平台兼容的优势。
这一点对于云场景尤其重要。云环境的网络硬件多种多样,不可能为每种硬件都做专用的内核适配。而基于主机代理的通用方案,可以用一套内核代码适配所有网络后端,大幅降低开发和维护成本。这也提示我们,做系统优化不要盲目迷信硬件专用功能,好的软件架构设计往往能带来更具性价比的收益。
6.3 内核级资源动态调优是必然趋势
过去的高性能 GPU 内核,大多依赖静态调优,针对特定输入尺寸找到最优配置,然后固化下来。但随着 AI 工作负载越来越多样化,输入形状动态变化,静态调优的成本越来越高,局限性也越来越明显。
mKernel 的自适应 SM 划分验证了在内核内部做动态资源调优的可行性,而且开销很低,效果接近最优静态配置。 未来,这种运行时自适应调优会成为高性能内核的标配,不仅是 SM 数量的调整,还可以延伸到更多硬件资源的动态分配,进一步提升内核的通用性和性能上限。
当然,mKernel 目前也还有可以拓展的空间。当前的测试主要集中在双节点场景,更大规模集群下的扩展性还需要进一步验证;支持的内核类型还可以继续扩充,覆盖更多的算子和并行模式;和上层编译器、框架的集成也需要持续完善,降低用户的接入门槛。
但无论如何,mKernel 已经迈出了跨节点融合内核的关键一步,为后续的工作打下了坚实的基础。随着技术的持续演进,内核级全链路融合未来很可能成为分布式 AI 系统的标准配置,从根本上解决通信瓶颈问题。
 发表于 2 小时前
|
查看: 8|
回复: 0
 /1


