Agent 已经能调用工具、读写文件了,团队为什么还要花时间研究 Harness?这也是云栈社区里不少开发者反复讨论的问题。
一个很实际的原因是:同一个模型,拿到不同的上下文,走过不同的工具调用流程,最后可能交出完全不同的结果。
在 Sequoia Capital(红杉资本)的 Own Your Intelligence 活动上,LangChain 联合创始人兼 CEO Harrison Chase 讨论了 Agent Harness 的选型、评估,以及如何从真实运行中持续改进。他的建议既不是"所有团队都该自建",也不是"通用框架足够解决一切",而是先从通用方案开始,再看具体任务究竟需要什么。
01|Harness,究竟在管什么?
Harrison 把智能体拆成三个部分:模型、上下文、Harness。
这里把 Harness 理解为智能体运行框架:它协调模型与上下文,安排工具调用,并决定执行循环如何继续。
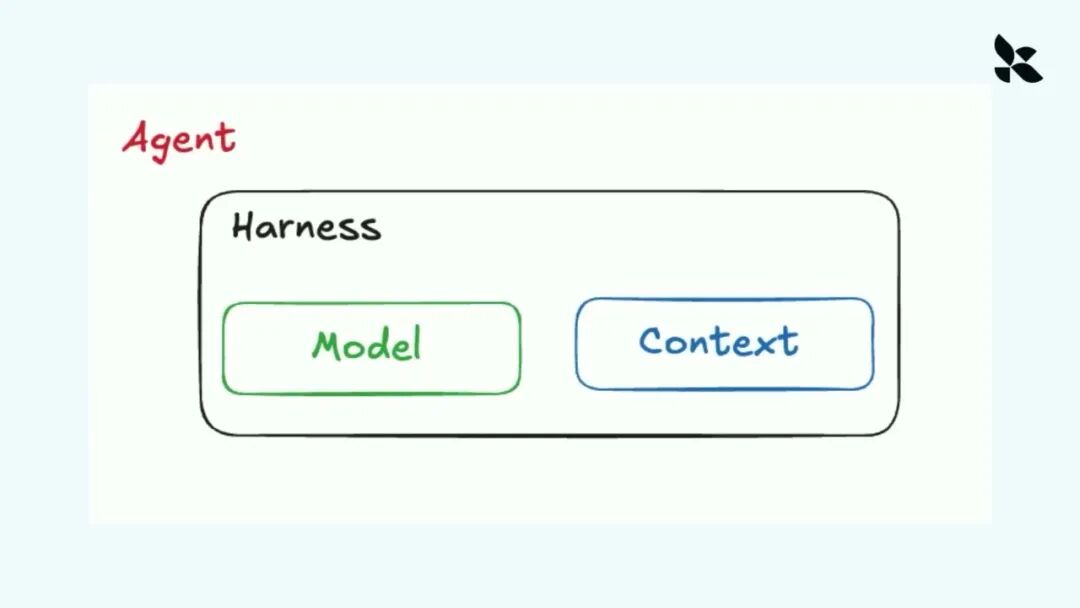
运行框架组织模型与上下文,共同构成智能体。
模型这一层,意味着你能否选择、切换合适的模型。上下文这一层,包括记忆、知识、历史对话,以及工具返回的材料。
Harness 则负责一件关键的事:把合适的信息,在合适的时间送给模型。
所以,排查一次失败,不能只问"模型够不够聪明"。还要问:
- 它当时到底看到了什么?
- 哪些工具结果已经进入上下文?
- 哪些信息仍然留在文件里,没有被读到?
- 哪些内容被摘要、截断,或者省略了?
这些问题,才把 Harness 从抽象名词变成可以检查的工程对象。
02|核心循环很简单,差别在插入点
基础循环并不复杂:收到请求,调用模型;模型要求使用工具,就执行工具,把结果送回去,再继续。复杂能力可以围绕这个循环逐渐加入。
比如,调用模型前先检查上下文是否过长,必要时做摘要;工具返回了大段内容,就把它存到外部位置;再按任务需要,加入沙箱、文件系统、记忆或子智能体。
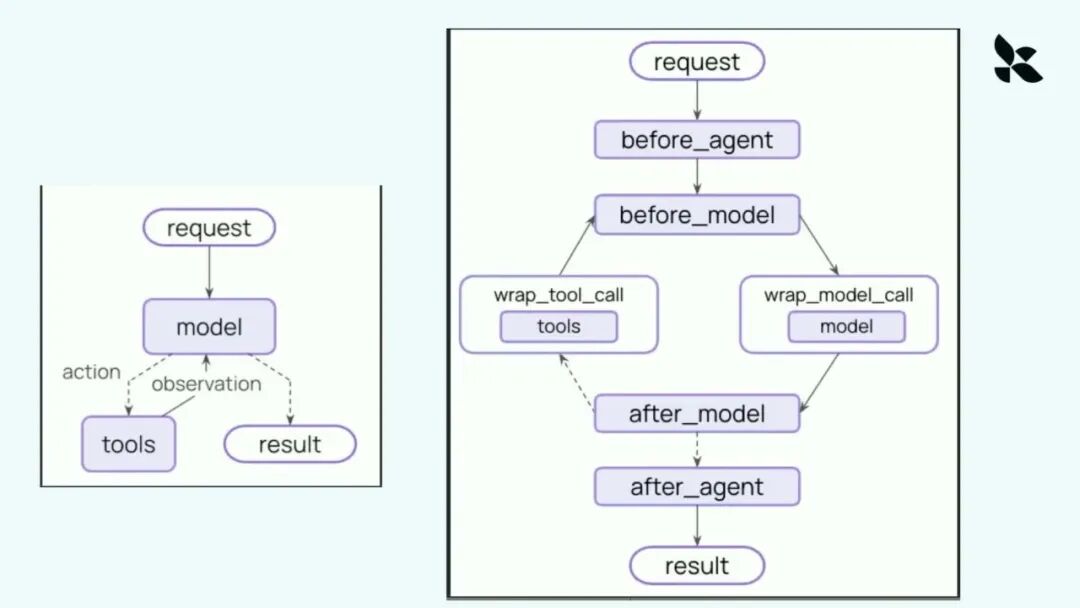
模型调用与工具调用前后,都可以插入定制逻辑。
Harrison 用 LangChain 和 Deep Agents 举例,说明丰富的运行框架如何建立在简单循环之上。hooks、plugins、middleware 的名字不同,但都可以在特定位置改变行为。
另一种做法,是把深度研究、代码审查等任务写成明确的步骤,也就是更专门的认知架构。
这两种路线并不互斥。你需要定制的,可能只是一个插入点,而不是整套框架。
03|要不要自建,先看两件事
第一件事:任务离模型熟悉的工作有多远?
Harrison 的判断是,任务越接近模型训练中熟悉的工作,现成框架越可能表现良好;偏离越大,就越可能需要领域定制。但不能把整个业务任务一刀切。
他举了法律 AI 的例子:模型未必熟悉完整的法律业务,却可能已经接受过大量文件编辑训练。团队可以定制整体业务流程,同时保留适合该模型的文件编辑工具。
他介绍 Deep Agents 的 model profiles 时提到,会根据模型切换不同的文件编辑实现。这个细节提醒我们:工具接口本身,也影响模型能否发挥已经学到的能力。
第二件事:业务需要多强的可预测性与控制?
问答中,他提到一些金融服务客户希望明确控制执行流程,而不是直接交给高度自主的通用智能体。
因此,选型不是简单的"买还是造",而是一条连续的路径:
通用框架 → 中间件定制 → 专门的任务架构
这些是讲者的经验判断,不是适用于所有法律、金融任务的结论。视频也没有给出一个可以计算的"分布距离阈值"。
04|改得好不好,不能只靠感觉
调整模型、上下文和框架之后,怎么判断系统真的变好了?
Harrison 强调私有评估和领域基准。他介绍的 Harbor 任务组织方式,包括环境、任务指令、测试,以及帮助检查任务本身的参考解。
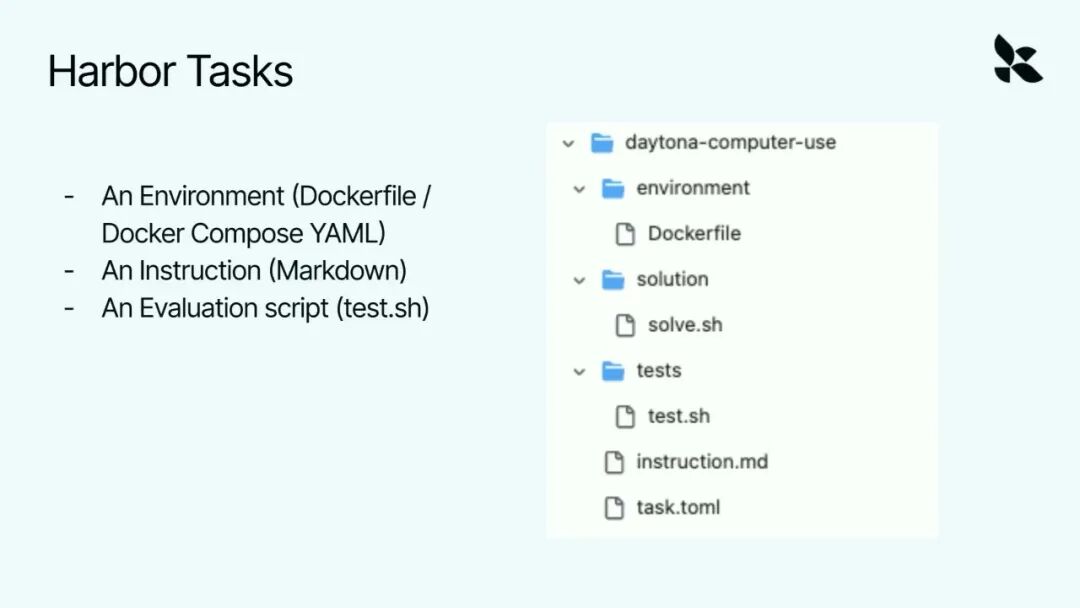
任务目录包含环境、参考解、测试与指令。
这让"什么叫好"不再停留在口头描述,而是变成可以重复验证的标准。
同时要记住,评估对象是模型与运行框架的组合,不是一个脱离工具和环境的模型名称。
展示 LangSmith 实验界面时,Harrison 还提醒听众一起看反馈分数、延迟和 token。对实际业务而言,质量、速度和成本共同决定可用性。只看一个分数,既解释不了为什么变好,也不足以支持上线取舍。
05|出错之后,先追查上下文
Harrison 认为,可观测性在智能体开发中被低估了。
一次模型调用出错,可能是模型能力不足,也可能是收到的上下文不够好。在他的经验判断中,后者更经常造成问题。
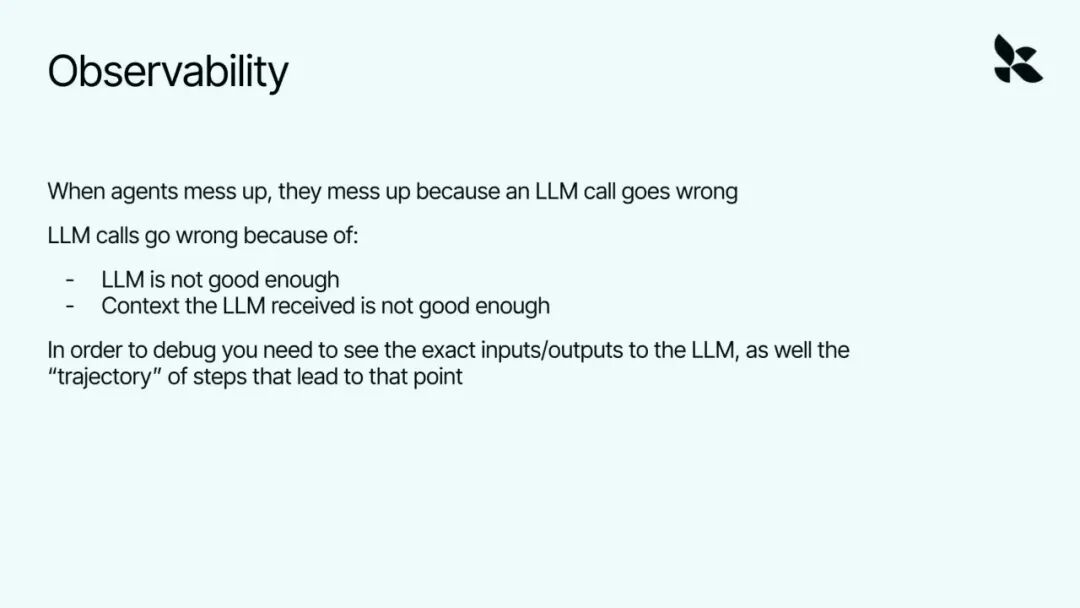
调试需要查看实际输入输出,以及形成这些输入的步骤。
这不是视频中测出的统计比例,但它提供了一个值得采用的排查顺序:
先看模型当时拿到了什么,再回溯哪些步骤让上下文变成现在这样。
易读的交互轨迹,帮助人快速浏览用户消息、工具调用和回复;更细的运行追踪,则让人进入某一次调用,查看实际输入与输出。二者不是重复建设,而是在回答不同层次的问题。
06|数据飞轮,不只用来改提示词
演讲后半段给出的循环是:运行智能体,收集追踪,整理数据,找出模式,再做实验。
反馈也不只有点赞和点踩。产品交互设计,会影响团队能否获得有用反馈;在线评估器则可以检查运行轨迹。
但检查本身有成本。Harrison 提醒,如果每条追踪都交给昂贵模型,费用会不断累积。可以考虑微调小模型、定制提示词,或者直接用代码完成足够简单的验证。
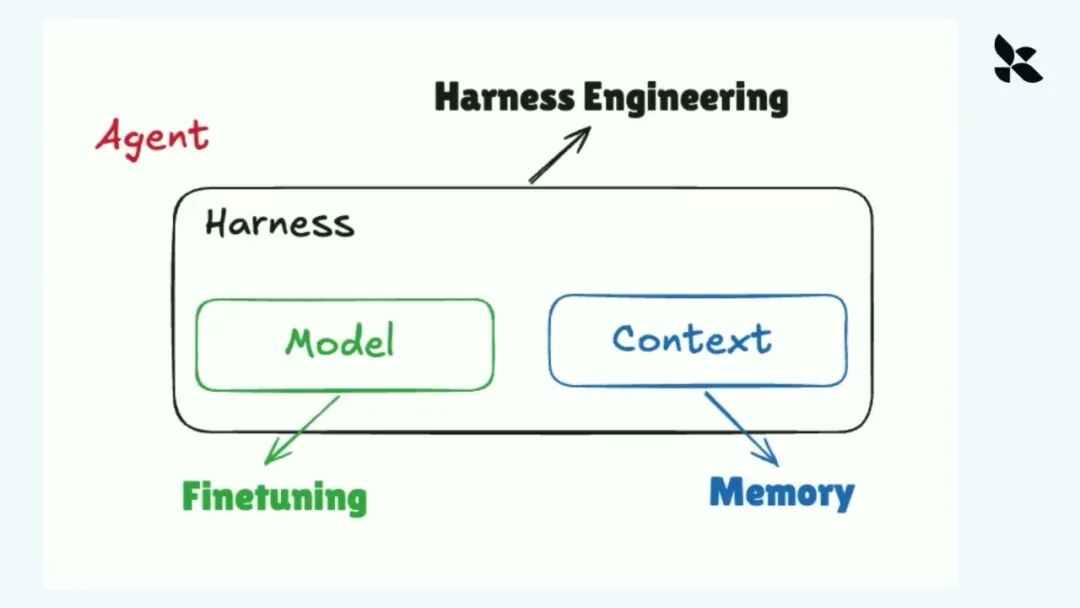
运行框架工程、模型微调和记忆更新,对应三个不同的改进位置。
这些数据最终可以改进三个地方:
- 运行框架:调整工具和执行流程。
- 模型:通过微调改善能力。
- 上下文:更新记忆与相关信息。
这与开头的三个组成部分形成了对应。
LangSmith Engine 的演示把流程进一步具体化:后台智能体查看追踪,建立问题看板,为问题关联证据,并提出提示词、上下文或代码调整。
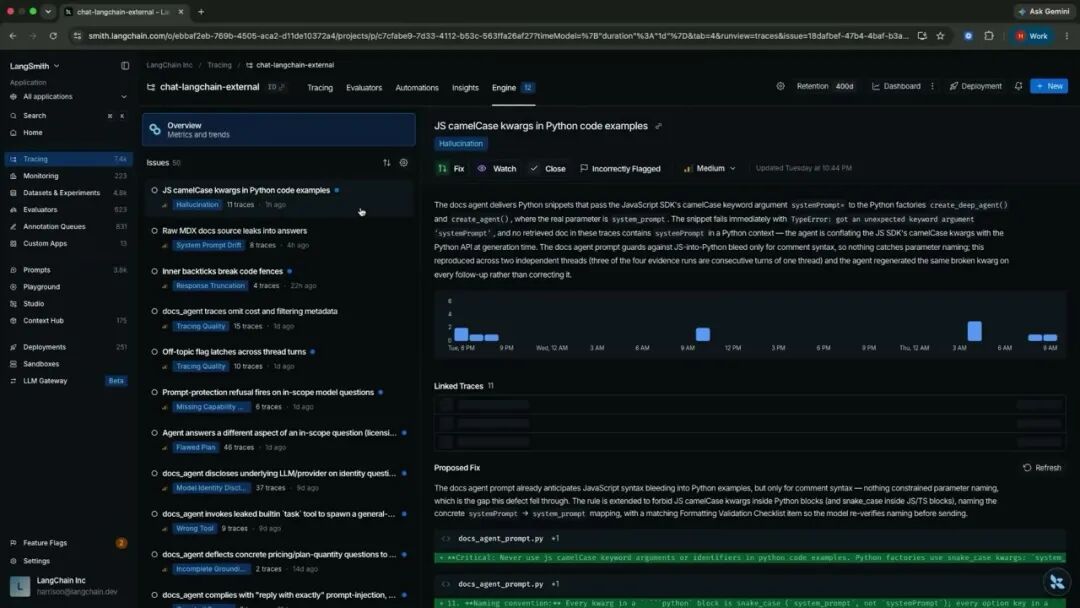
问题描述关联运行追踪,并展示建议修改。
需要区分"展示了流程"和"证明了收益"。这段演示没有提供完整的修复收益实验,也没有证明所有修改建议都可靠。
07|一次比较,学到一种可以迁移的做法
问答中,有人问:团队会不会用 Engine 分析 Engine 自己?
Harrison 回答,他们已经这样做了,也为 Engine 建立了 Harbor 格式的内部基准。
在同一任务上比较 Deep Agents、Codex 和 Claude Code 时,团队观察到 Codex 会积极编写小脚本来处理追踪。于是,他们把这种做法带回 Engine,称为 Engine 的"Codex 化"。
视频没有公布完整分数、模型版本或成本表,因此不能据此给这些产品排一个通用名次。但这个案例有一个更实用的启发:基准不只是排名工具,也可以帮助团队发现值得迁移的行为。
至于未来的 Harness 会收敛还是分化,Harrison 的回答很坦率:不知道。共同的编码能力可能推动收敛,专业领域的发展又可能推动分化。真正可以持续做的,仍然是评估与观察。
从一个真实失败案例开始
下面是根据演讲思路整理的实践建议,不是讲者已经验证的实施方案。
如果你正犹豫要不要自建 Harness,不妨先选一个结果能核验的真实任务,保留输入、工具结果与完整追踪。在模型和测试任务不变的前提下,先只改一个位置:上下文整理、工具结果处理,或者某个明确的流程检查。
再同时比较正确性、耗时与成本估计,看看失败是真的减少了,还是仅仅换了一种形式。
先找到现有系统为什么失败,再决定需要接管哪一层。
这可能比一上来就重写框架,更接近问题本身。
引用链接
[1] Sequoia Capital 原视频:When to Build Your Own Agent Harness: https://www.youtube.com/watch?v=HI2q3ci3Iuc
[2] Sequoia Capital 官方页面及文字稿: https://sequoiacap.com/podcast/owning-your-intelligence-starts-with-the-harness
 发表于 昨天 23:14
|
查看: 7|
回复: 0
 /1


