田渊栋所在的 Recursive 团队今天正式开源了 Flint-40B-A2B,一款面向本地 Coding Agent 的混合专家(MoE)模型。这意味着,开发者可以在自己的笔记本上跑起一个具备较强编程能力的本地编码模型,而不必事事依赖云端 API。
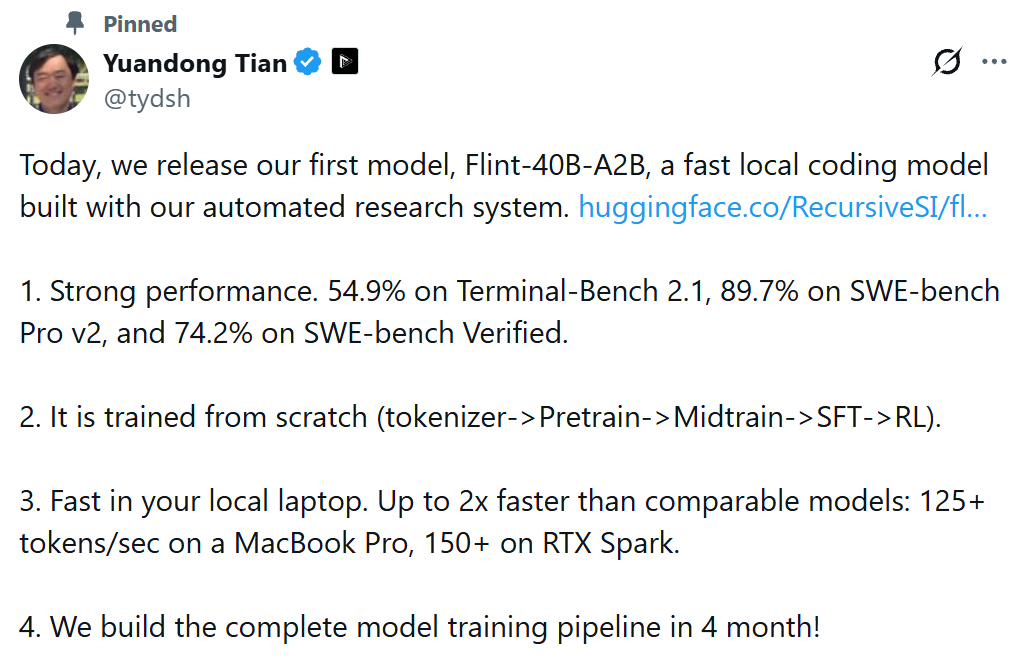
Recursive 借助自研的 AI 自动科研系统 Eureka Machine,仅用不到 4 个月就完成了整套模型研发流程,涵盖 Tokenizer、预训练、中期训练、监督微调以及强化学习等关键环节。
Flint 在编程能力之外,特别针对本地设备做了深度优化。官方给出的数据显示,它的运行速度最高可比同类模型快 2 倍:在 MacBook Pro 上生成速度超过每秒 125 Token,在 NVIDIA RTX Spark 设备上则超过每秒 150 Token。
不只是写代码,Flint 还能在笔记本上自主科研
模型发布后,Recursive 研究员 Cong Lu 展示了一个更有意思的方向:让 Flint 在本地完成一整套自动科研流程。研究者只需要提供任务和可衡量的评价指标,Flint 就能够自己提出思路、编写代码、运行实验,再根据反馈不断迭代方案。
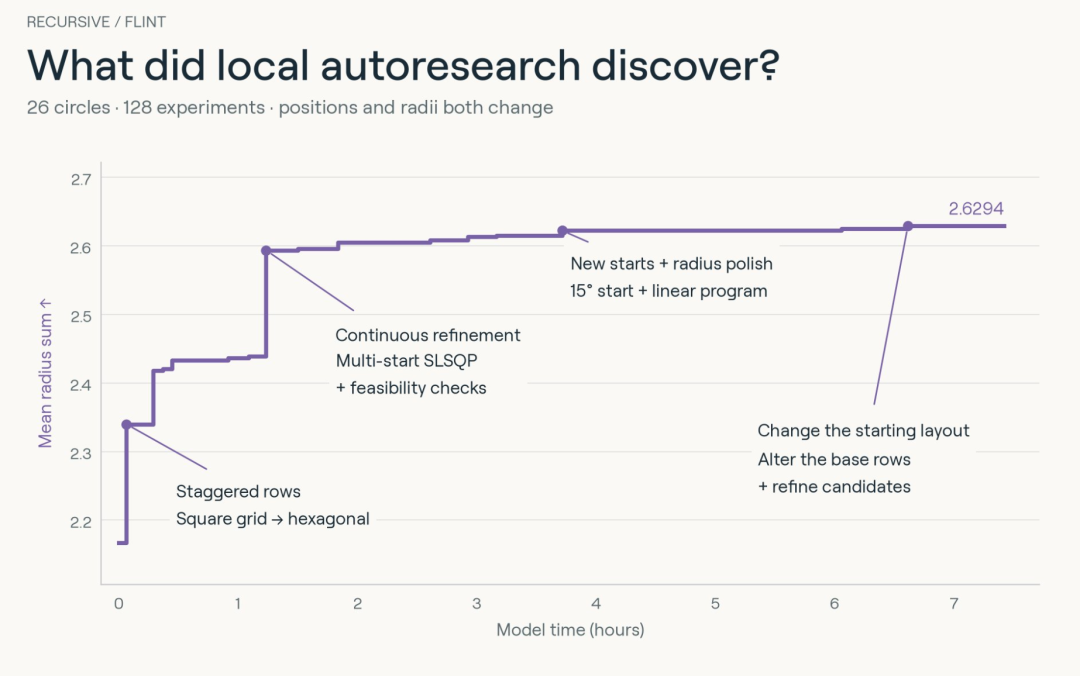
在圆形填充问题中,Flint 需要在正方形区域内安排圆的位置与大小,以尽可能优化布局。即使没有视觉输入,它也能通过代码调整圆的位置和半径,尝试不同的初始化方案,并根据得分继续优化。
在工厂调度任务中,Flint 尝试重新排列作业执行顺序,减少机器等待时间。最终,相比轮询调度(Round-robin)基线,任务整体完成时间提前了 26%。
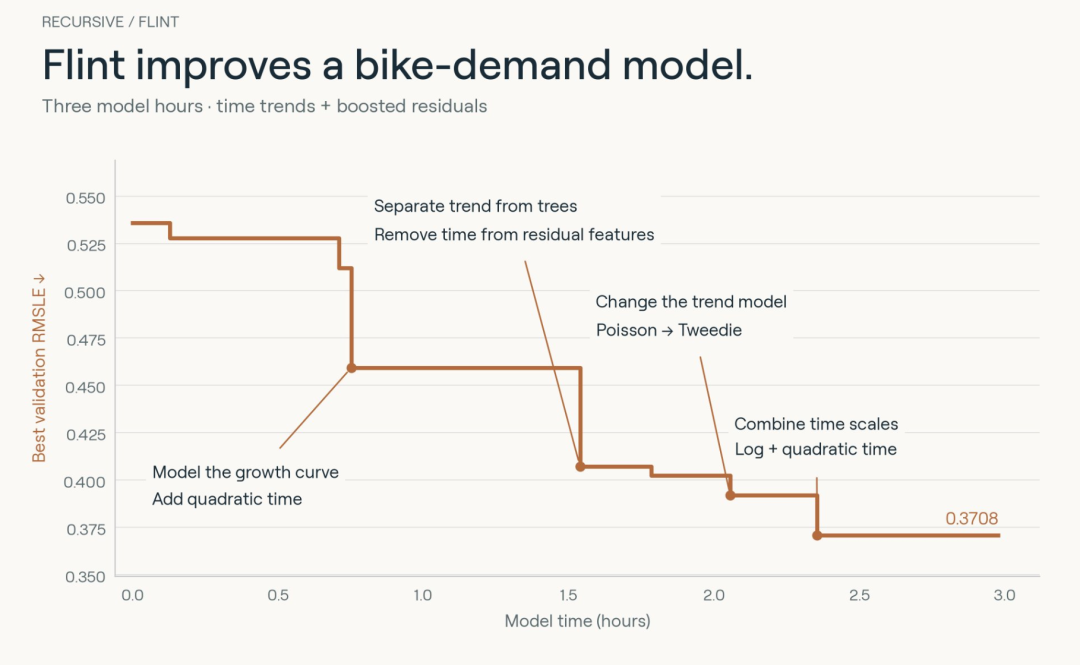
第三项实验是共享单车需求预测。研究者使用公开的 UCI Bike Sharing 数据集,让 Flint 根据天气、日期等信息预测租车需求。Flint 探索了结合对数与二次时间特征、残差树模型的方法,使验证集 RMSLE 降低 30.8%,留出测试集 RMSLE 降低 9.1%。
以前想做自动科研,通常需要调用大型闭源模型;现在 Flint 已经能够在笔记本电脑上完成提出假设、编写程序、验证结果和迭代改进的完整流程。
Eureka Machine 参与模型研发,Recursive 迈出 RSI 新一步
Flint 的另一层意义在于,它本身就是 AI 自动科研系统的研究成果。Recursive 的 Eureka Machine 深入参与了 Flint 的研发过程,覆盖模型架构探索、训练数据与优化方法、模型量化以及底层推理加速等多个环节。
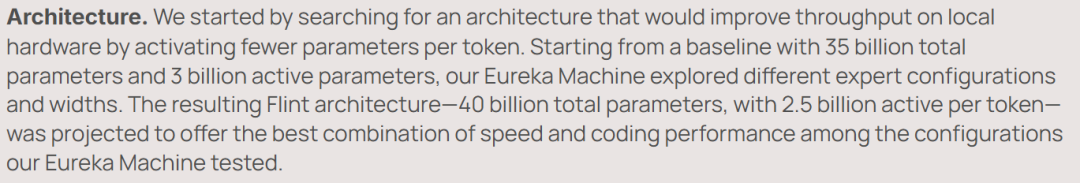
系统从 35B 总参数、3B 激活参数的基线出发,探索不同的专家配置,最终找到了 40B 总参数、2.5B 激活参数的方案。
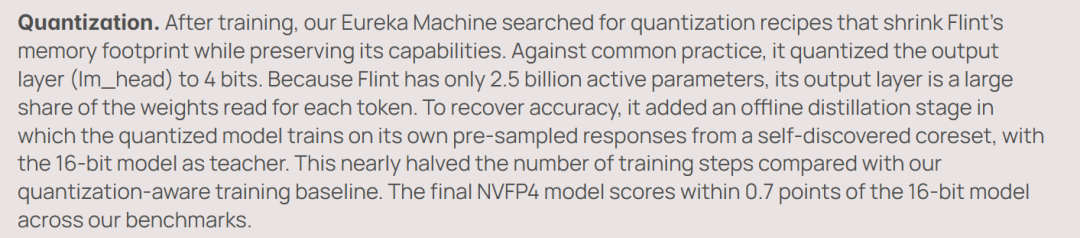
在量化阶段,系统还探索了将输出层压缩至 4-bit,并通过额外蒸馏恢复模型精度的方法。由于 Flint 每个 Token 仅激活 2.5B 参数,输出层在每次权重读取中占比较大,因此这一处理对缩小内存占用尤为关键。
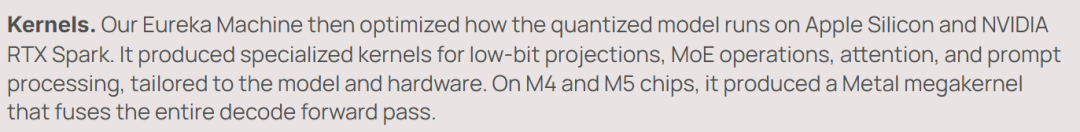
底层推理方面,Eureka Machine 针对 Apple Silicon 和 NVIDIA 硬件生成专用计算内核,在 M4 和 M5 芯片上还融合出了覆盖整个解码前向传递的 Metal megakernel,进一步提高了运行效率。
这也与 Recursive 长期探索的递归自我改进(RSI)方向相呼应:让 AI 参与改进 AI 研发过程,再借助更强的模型提升下一轮自动科研能力。
当然,Flint 并不意味着 AI 已经实现完全自主的递归自我改进,当前成果仍然是人类研究员与 AI 系统协作完成的模型研发实践。但从自动科研系统参与模型训练,到 Flint 能够在本地自主探索算法问题,Recursive 已经开始展示 AI 研发 AI 的不同环节。对这类开源模型动态感兴趣的开发者,也可以在云栈社区持续关注相关讨论与资源共享。 |  发表于 昨天 07:18
|
查看: 22|
回复: 0


