卷积神经网络(CNN)和大型语言模型(LLM)已经在商业人工智能领域占据了相当一段时间的主导地位。像 Meta 这类公司开发的专有推荐模型同样带来了显著的社会影响,只不过每种模型往往只有一家公司在使用。GPU 承担了这类模型的大部分繁重运算,但智能体人工智能的兴起正在改变这一格局——它需要更多的协调能力,而这恰恰是 CPU 的主场。
当人工智能的唯一任务是运行模型时,它通常会调用 GPU 或专用神经处理单元(NPU)。智能体依然会使用这些模型,但模型只是整个解决方案的一部分。智能体必须根据模型返回的结果做出决策,这背后是大量的 if-then-else 逻辑,而 CPU 擅长处理这类逻辑,GPU 在这方面则略逊一筹。据一些业内人士估计,智能体工作负载可能会将 CPU 与 GPU 的比例从 1:4 拉低到 1:1。
新型模型也在不断涌现,其中大多数仍然建立在 LLM 的基本原理之上。与智能体人工智能不同,推理模型、混合专家(MoE)模型和储层计算依然主要依赖 GPU,但这些模型同样可以用于智能体场景。
多年来,实用的商业人工智能主要指卷积神经网络和循环神经网络(RNN)。前者擅长分析摄像头输入,后者则精于处理声音和语言。LLM 中的第二个“L”代表“语言”,但如今 LLM 的功能早已超越了语言本身。其核心思想是将一段文本抽象成标记(token),而现在几乎任何内容都可以成为一个标记。
与 RNN 相比,LLM 的优势在于能够维护任意长的上下文,从而在文本解读和生成过程中更擅长选择合适的词语。RNN 虽然资源需求更低,但它的特点是能够立即分析传入的声音帧,无需等待建立上下文,因而在实时响应上更有优势。
早期语言模型的挑战在于,它们只有一个任务——预测序列中下一个最可能的词。这个词在句法上必须合理,但在语义上不一定可靠,而且模型本身当然不会去核查事实,因此经常出现“幻觉”。
改进方法之一是通过检索增强生成(RAG)。模型不再只是猜测某个词是否合适,而是可以访问包含真实事实的“词嵌入”,从而生成语法、语义和事实都正确的文本。
智能体人工智能,火热
智能体是一种全新的实体,它不会取代或修改 LLM 或其他任何模型,而是代表了更高层次的抽象,充当模型的协调者。它本身并不是模型,尽管它同样需要经过训练。
Delos Data 的首席执行官兼联合创始人 Ed Doe 表示:“一些新的研究表明,智能体推理将会远远超过之前所有技术加起来的影响。”
智能体的意义就在于它不仅仅是找到问题的答案,而是会利用这个答案采取行动。它的具体行动很可能取决于它目前为止收到的答案。换句话说,它可以向模型发送令牌,并在收到结果后决定下一步该做什么,由此启动一连串的决策和行动。
训练有素的员工应该能够在无需严格监督的情况下处理一系列任务。Cadence 公司数字和签核部门的产品管理总监 Rob Knoth 解释说:“如果你作为领导者必须事无巨细地指导团队完成每一步工作,那么你就会更加关注每个环节。但如果你说‘我需要你去那边完成这项工作’,那么你就可以专注于其他任务,偶尔查看一下确保一切进展顺利。”
这是一个全新的领域。Arm 公司全球云和人工智能基础设施芯片负责人 Satadal Bhattacharjee 指出:“自去年以来,智能代理人工智能迅速发展。现在你可以说‘我想去哥斯达黎加玩 10 天,我需要酒店、租车和这些公园的门票。这是我的预算,去预订所有这些。’你只需提供一个大致的行程安排,就像找旅行社一样,然后智能代理就会调用 API 来代表你执行操作。”
CPU 的新任务
智能体的决策通常涉及 if-then-else 分支,而这并非 GPU 的强项。CPU 在处理此类决策密集型代码方面表现更佳,因此它们在计算集群中扮演着越来越重要的角色。对于典型的 LLM 系统,CPU 主要充当主机,负责配置和通过 PCI 管理通信,例如横向扩展。相对较低的 CPU 负载使其能够同时为多个 GPU 处理主机任务。CPU 与 GPU 的比例因系统而异,但对于典型的 LLM 系统而言,这个比例约为 1:4。
有了智能体,CPU 将更多地用于实际工作,而不仅仅是为 GPU 提供支持。因此,尽管 GPU 长期以来一直备受瞩目,随着 CPU 与 GPU 的比例接近 1:1,CPU 的地位也重新得到重视。这将提高对 CPU 的需求,进而可能推高价格。
Synopsys 公司知识产权战略营销经理 Ron Lowman 表示:“过去我们面临的挑战是每个 CPU 能配备多少个 AI 加速器。随着智能 AI 的出现,CPU 负载需求更高,因此比例也发生了变化。”
Bhattacharjee 对此表示赞同:“对 CPU 的需求大幅增长,因为每个人都希望以更节能的方式获得更多的计算能力来运行这些代理。”
QCI 首席技术官苏永孟表示:“过去 18 个月里,大家都在热议智能体人工智能。这就是为什么 CPU 现在价格如此昂贵的原因。”
“CPU 已经恢复运行,但它的使用方式与数据中心其他部分的使用方式截然不同,”Doe 说道。代理查询的计算量也更大,因为向代理发送请求通常会导致代理在完成一系列任务时产生多个查询,而不是只发送一个查询。
更高级的智能体还必须理解序列,而这可以通过编程实现。“这其中也涉及到编程,”Bhattacharjee 说道,“你可以运行 JSON 脚本来调整和控制序列。智能体还有很多其他功能可以实现。”
展示你的计算过程。
早期模型面临的另一个挑战是人类无法理解它们。模型是一大堆数字,任何一个数字都无法真正与任何物理或事实联系起来。训练过程中获得的权重并非一成不变。训练从随机权重开始,经过多次迭代不断优化。如果从不同的随机权重开始,训练结果将演变成一个不同的——但仍然正确的——模型。
那么,即使你的解决方案只是众多可能正确模型之一,又该如何证明它的正确性呢?目前尚无确定性的方法可以追踪基本模型的计算过程,这使得认证那些必须确保安全性的系统变得十分困难。而且,随着前沿模型出现不良行为并逃出其沙箱等情况,安全性的概念也在不断扩展。
推理模型在生成查询答案之前会进行额外的推理,在某些情况下,它们还会解释如何得出答案。“推理过程会运用模型对主题的了解、之前与模型讨论的背景信息,以及你对提问者的了解,”Bhattacharjee 说道,“因此,推理过程是模型进行更高层次思考并得出更佳答案的过程。它更加全面,涵盖的范围更广,而不仅仅局限于回答当前提出的问题。”
推理模型也需要进行训练,因此如果推理过程中的某个步骤不正确,该反馈可以提高未来查询的性能。
推理环节涉及的计算更适合 GPU 而非 CPU。“推理通常是模型推理的一部分,主要在 GPU 或其他 AI 加速器上运行,”Bhattacharjee 说道,“思考过程涉及生成额外的标记和神经网络计算,这些最好由加速器来完成。”
推理模型已经商业化发布。“OpenAI 的 O 系列模型和 DeepSeek-R1 就是商业部署的推理模型的例子,”Bhattacharjee 补充道。
众包(或云包?)
LLM 模型非常庞大,对每个代币进行全模型测试会消耗大量资源。目前有两种方法试图控制这些模型的规模。
最简单的模型是小型语言模型(SLM)。它并不试图用一个模型囊括互联网和人类的所有知识,而是专注于某个特定领域,并针对该领域进行精细训练,除此之外不涉及其他任何领域。SLM 是一个自包含的模型,可以独立运行。
另一种日益流行的技术是将各个模型层的部分内容分离出来,作为混合专家(MoE)模型中的专家。在给定的层上,可以建立多个彼此独立的专家。每个专家都有自己的一组权重,使其更擅长处理某些类型的词元。
Bhattacharjee 解释说:“该模型的一些密集前馈网络(FFN)层被多个独立的 FFN 或‘专家’以及一个学习路由器所取代。”
Synopsys 接口 IP 产品管理总监 Priyank Shukla 解释说:“以前,大型语言模型的扩展性取决于参数数量,增加参数就能提升性能。而现在,通过混合专家模型,我们不仅拥有一个庞大的参数模型,还拥有多个专家模型,因此整个流程不再需要 10 万亿个参数。我们可以将其拆分,例如用 1 万亿个参数来处理法律相关的工作,用 1 万亿个参数来处理数学运算。前端模型会将查询传递给相应的专家模型。”
有一个通用模型会先“理解你提出的问题”,这被称为预填充阶段。“在这个阶段,它会解析你的提示,理解上下文,”Bhattacharjee 说,“然后它会与一系列专家合作。一旦它理解你的问题与医疗保健等相关,就会有一位受过医疗保健方面培训的专家来解答。”
对于给定的词元,门控函数或路由器会决定将其发送给哪位专家。理论上,它可以将词元发送给所有专家,但通常只有一到两位专家有机会处理。训练过程与常规训练相同,但路由器还会通过观察训练过程中哪些专家对不同词元的表现最佳来进行训练。这使得路由器能够在推理过程中正确地将词元分配给相应的专家。
推理过程中迄今为止发生的所有事件的上下文信息都存储在键值缓存(KV缓存)中。随着处理的进行,缓存会不断增大,并影响未来的决策。这些信息将被发送给选定的专家。
Synopsys 的 Shukla 表示:“我们必须从第一个模型传输 KV 缓存,该模型与相关的专家混合体进行交互。”
路由器也在加速器上执行。“路由或门控功能是模型本身的一部分,通常与模型一起在加速器上执行,”Bhattacharjee 指出。
最后,专家分组是在训练阶段进行的。“专家们接受联合训练,通常不会人为分配,”他说道。
当将 MoE 与其他专门化策略(如小型语言模型)直接比较时,这种区别就更加明显了。
SLM 与 MoE 的区别主要体现在两个方面。SLM 可以处理整个字符串,而一个专家模型只能处理字符串中的特定词元。SLM 模型体积更小,运行所需的资源也更少。MoE 模型则更大。一个普通的 LLM 模型只有一个专家(负责所有方面),而 MoE 模型则为同一任务提供多个专家,因此其体积比纯粹的 LLM 模型更大。但即便如此,MoE 模型的体积仍然可能比不上需要训练一个完全覆盖所有领域的专家模型。
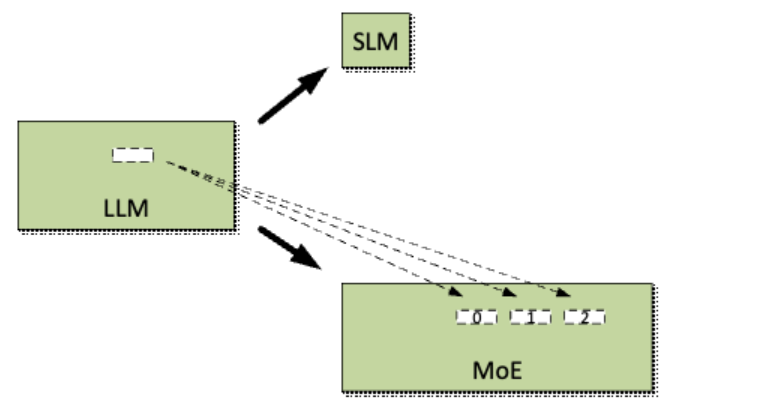
图 1:SLM 与 MoE。专用 LLM 可以简化为 SLM,而 MoE 模型针对模型的关键部分提供了多种选择,并由路由器决定哪些“专家”处理下一个令牌。来源:Bryon Moyer/半导体工程
此外,MoE 模型覆盖范围更广,其内部专家可以涵盖广泛的主题。而 SLM 模型覆盖范围较窄,因此其可消耗的材料也更为有限。
MoE 模型通常比常规的“密集”模型更大,因为一个关键的前馈层可能被多个专家层替代。这意味着参数总数可能超过标准模型,但由于任何给定时间只有少数专家层运行,因此并非所有参数都需要获取。
“由于 MoE 模型包含多个专家,因此其参数总数可能非常庞大,但每个词元只会激活其中的一部分专家,”Bhattacharjee 解释道,“这种稀疏激活是其关键优势。它允许模型在无需每个参数参与每次推理操作的情况下,提高其整体容量。”
MoE 模型的功耗影响尚不明确。“虽然 MoE 模型可能包含更多参数,但通常每个令牌只会激活其中的一部分专家,”Bhattacharjee 说道,“这意味着,与参数总数相当的密集模型相比,MoE 模型每个令牌所需的计算量可能更少。但缺点是,路由、内存访问和设备间通信会引入额外的开销,因此效率越来越取决于整个系统的设计,而不仅仅是参数数量。”
随机储层
一种较为冷门的模型类型被称为储层计算。由于其处理时间序列的能力有限,训练起来比传统模型容易得多,因为模型的大部分都是随机的。训练过程仅影响最后一层,该层接收随机比特产生的值并将其映射到正确的结果。
“这是一种专门针对动态时间输入的方法,尤其适用于低功耗、快速普及以及简单训练有价值的情况,”Bhattacharjee 说。
由于模型的大部分内容无关紧要,因此可以将其硬编码到芯片中,只需最后一层接受训练好的权重即可。此外,由于只需获取最后一层的权重,所需的能耗也大大降低。
虽然很少有人谈论这种人工智能,但它可用于语音或音频识别、处理传感器数据和控制机器人上的电机,以及对序列进行建模,包括对天气和金融市场等应用进行时间序列预测。
量子计算公司(QCI)正在准备推出光子版本的储层计算机。“储层计算可以用其他方法实现,但在所有方法中,光子学是最佳选择之一,因为它具有高带宽,”QCI 量子技术负责人 Prajnesh Kumar 表示。
光子学的一大优势在于,它最终可以利用波分复用(WDM)技术来提高生产效率。“假设你有 10 个波长,”Kumar 解释说,“你可以把 10 个不同的任务分配到这些波长上。如果你的内核对所有波长都相同,那么你就可以并行执行 10 个操作而不会相互干扰。”
这样一来,他们就能着手解决那些需要高性能和低功耗的特定任务。“未来某些应用,比如垂直起降飞行器,就需要进行轨迹规划,”Kumar 说,“你肯定不希望飞行器之间发生碰撞。我还和一位教授交流过,他一直在使用我们上一代产品分析脑信号,试图弄清楚我们是否能够根据脑部活动来区分癫痫和其他疾病。此外,还有其他一些应用,更多地集中在某些军事和国防领域。”
综合来看,这些专门化的方法拓宽了人工智能的格局,而不是指向单一的主导架构。
模型类型繁多,而且这种情况短期内不太可能改变。如今,卷积神经网络仍然占有一席之地,而 LLM 和智能体人工智能则是主流,MoE 也正在迅速发展。推理模型虽然不如其他模型普及,但也拥有其独特的应用领域,储层计算也是如此。
这些技术大多仍然依赖 GPU(或其他 NPU)来处理繁重的计算任务。但智能体人工智能是个例外,它非常依赖 CPU,但并没有减轻 GPU 的压力。
注意力机制和 Transformer 等新突破是否会定期出现还有待观察,但就目前而言,开发者们正在努力利用现有资源寻找更好的使用方法——而且看不到尽头。
(来源:编译自 semiengineering)
免责声明:本文由作者原创。文章内容系作者个人观点,半导体行业观察转载仅为了传达一种不同的观点,不代表半导体行业观察对该观点赞同或支持,如果有任何异议,欢迎联系半导体行业观察。
 发表于 8 小时前
|
查看: 2|
回复: 0


