10 月 20 日,DeepSeek 做了一件它一年半前明确说过“做不到”的事:把支撑自家线上服务的推理框架 DeepInfer 完整开源(开源项目 deepseek-ai/DeepInfer),采用 Apache 2.0 协议。同步放出的还有生产级 Token 编解码组件 deepseek-recipe(开源项目 deepseek-ai/deepseek-recipe,MIT 协议),后者负责把各家 API 协议的请求翻译成模型认识的 Token 序列,再把模型输出的 Token 翻译回标准响应格式,相当于官方 API 与模型之间的编解码层。
2025 年 4 月,DeepSeek 曾在 open-infra-index 仓库里发过一份 The Path to Open-Sourcing the DeepSeek Inference Engine(开源 DeepSeek 推理引擎的路径),当时列了三条困难:内部引擎基于 vLLM 早期分支魔改得太深、与内部集群管理工具耦合太紧、小团队没有维护大型开源项目的带宽。落点是“不开源引擎本体,改为抽取独立组件回馈社区”。此后一年半,FlashMLA、DeepGEMM、DeepEP、TileLang 这些“零件”陆续开出,直到这次,发动机本体终于完整交到了社区手上。
这套引擎的实战成绩包括但不限于:单一集群每天服务 155 万亿 Token,线上平均每个请求输入 77K Token,首字时延平均 400 毫秒,输入缓存命中率 96%,整体收入平均每卡每小时 38 美元(按谷价折算)。
硬件支持名单上,英伟达 SM100(Blackwell 数据中心 GPU)与华为昇腾 950 NPU 并列首发,Hopper 及更早架构缺席。DeepSeek 官方在知乎发布的 DeepSeek V4.1 Flash 大规模推理部署实践和 GitHub 上的 DeepInfer 项目的部署问答文档,把这套系统从架构设计到缓存粒度、调度算法、容错策略全部摊开。
下面把这两份一手材料连同仓库代码一起拆开讲。
关于 DeepInfer 的身世,还有一层值得交代的背景。DeepInfer 项目的 README 文档在致谢里写明:它最初主要基于 vLLM 构建,同时借鉴了 SGLang 和英伟达 TensorRT-LLM 的设计,源码文件头里保留着“Derived from vLLM”的标注——一年半前那份声明里“基于 vLLM 早期分支魔改”的说法,今天以开源的形式坐实了。vLLM 项目随后在 X 上公开致谢,表示会把 DeepInfer 中的一些设计吸收进自己对 V4.1-Flash 的支持;仓库上线当天下午,Star 数就过了 8000。
由此可以顺带回应一个注定会被反复提起的话题:拿 DeepInfer 和 vLLM、SGLang 跑分比高低。这个对比很难有公允答案。DeepInfer 只服务一个模型、只做离线推理,公布的曲线全部是自报数据;vLLM 和 SGLang 要照顾几十上百种模型与硬件组合的通用性。一个是在自家田里把一种作物种到极限,一个是开门服务所有农户的农机站,两边的产量数字摆进同一张表,说明不了谁高谁低。何况代码层面已经证明,两边的养分正在互相流动。
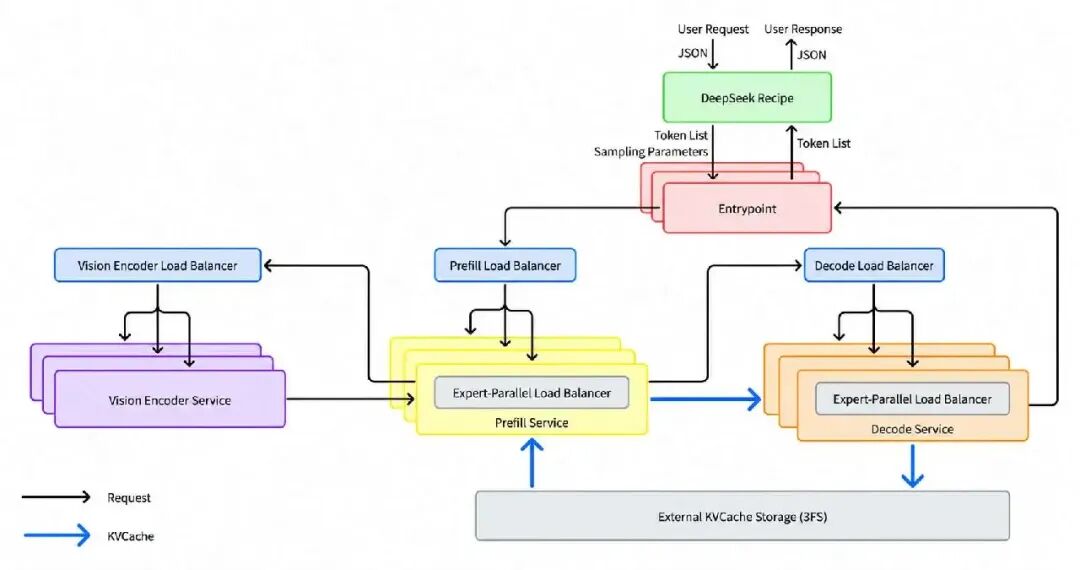
请求从最上方的 DeepSeek Recipe 进入,完成 API 协议转换与 Token 编码后到达 Entrypoint;随后兵分三路——带图的请求先去 Vision Encoder 服务(紫色),文本请求经 Prefill 负载均衡器进入 Prefill 集群(黄色),Prefill 算完的 KV 缓存经蓝色通道传给 Decode 集群(橙色)逐字生成答案。三个集群各自挂着专家并行负载均衡器(EPLB),底部灰色长条是外部的 3FS KV 缓存存储集群,Prefill 与 Decode 都能读写。黑色箭头是请求的完整生命周期,蓝色箭头是 KV 缓存的流向。整张图的核心信息是:计算按阶段拆成三种机器,缓存从计算节点剥离、集中存放,任何一个环节都可以独立扩缩容。
一、线上实测:输入缓存命中率 96%,首字时延 400 毫秒
DeepSeek 这次公布的数字全部来自生产环境的真实统计,汇总成一张表:
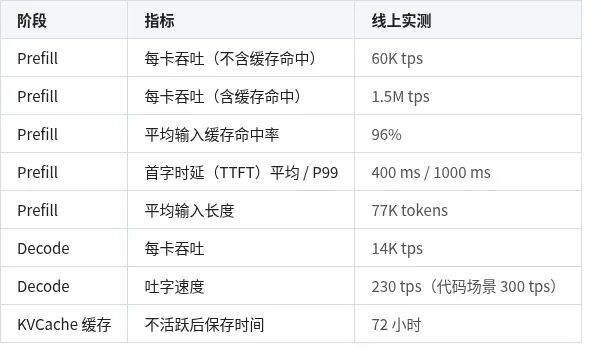
同一张卡,不算缓存命中每秒处理 6 万个 Token,算上缓存命中每秒 150 万个,差出 25 倍。这 25 倍就是 96% 命中率的含义——Agent 场景里每轮请求都要带上系统提示、工具说明和之前所有轮次的对话,这些内容上一轮已经算过,命中后直接从存储里读 KV 缓存,只有增量部分进 GPU。官方另注明机器预留了冗余应对流量波动,实际部署 Prefill 与 Decode 的卡数接近 1:1,整体收入按谷价折算为每卡每小时 38 美元。这套数字是 DeepSeek 自报的,尚无第三方复现,但它的价值在于给出了一个生产级推理系统的完整运营口径。
二、系统架构:E/P/D 分离部署,KV 缓存独立成集群
整个推理系统的设计目标只有两个词:更大吞吐、更低延迟。落到架构上是三个决定。
2.1 一个请求拆成三段,各用各的机器
模型处理一个请求分两步。Prefill 阶段把系统提示、聊天记录、文件和问题一口气读完,每个 Token 在每一层算出一组中间结果,即 KV 缓存;Decode 阶段一个 Token 一个 Token 地生成答案,每生成一个都要读前面所有的 KV 缓存。两步的资源特征完全相反:Prefill 一次处理几万 Token,拼算力;Decode 一次只生成一个 Token,时间主要花在从显存读参数和缓存上。
DeepSeek 的做法是把两个阶段拆到不同硬件上:Prefill 用常见的 8 卡机器,Decode 用 64 到 128 卡的超节点;带图片的请求再交给单独部署的 Vision Encoder 服务,单实例一张卡就够,官方还建议用更便宜的卡。
这就是 E/P/D(Vision Encoder / Prefill / Decode)分离部署,好处是各阶段的资源分配解耦,TTFT(首字时延)和 TBT(逐字间隔)可以独立控制、独立优化。实践中 P 和 D 的卡数比约 1:1,官方给出的最小高效部署单元是 64 卡 Prefill 加 64 卡 Decode——因为 Decode 推荐 EP64 起步,再小就不划算了。
2.2 并行策略:MoE 用 EP,Attention 用 DP
V4.1 Flash 是 MoE 模型,光路由专家就有 384 个。
系统在超节点内对 MoE 部分用专家并行(EP),把专家摊到多张卡上,增大 batch size、提高矩阵乘法效率;Attention 部分沿用 DeepSeek-V3 / R1 推理系统概览的做法用数据并行(DP),且 DP 数等于 EP 数。TP 和 CP 目前都不用。
Prefill 侧 EP 取 2 到 8,原则是“HBM 装得下就用最小的 EP”;Decode 侧反过来,EP 开到 64 甚至 128(Wide-EP),原则是“卡有多少就用多大的 EP”。原因在第三章展开。
2.3 KV 缓存保留 72 小时以上
第三个设计目标是把 KV 缓存保留超过 72 小时,给上下文复用留一个足够长的时间窗口。
长保留时间是有代价的,容量压力和管理开销被明确纳入了系统设计——缓存最终放进了独立的 3FS 存储集群,总规模约 100 PiB 固态硬盘,平均每张在线 GPU 对应约 14.4 TB 逻辑容量。
三、Prefill:三级 KV 缓存与 96% 命中率的实现
Prefill 侧最大的工程主题是“不算第二遍”。这套缓存体系能成立,底座是模型本身把 KV 缓存压得足够小——DeepSeek 在知乎的 SWA Bounded Replay 一节里引用了 DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression,报告里有一张图把这件事讲得很直观。
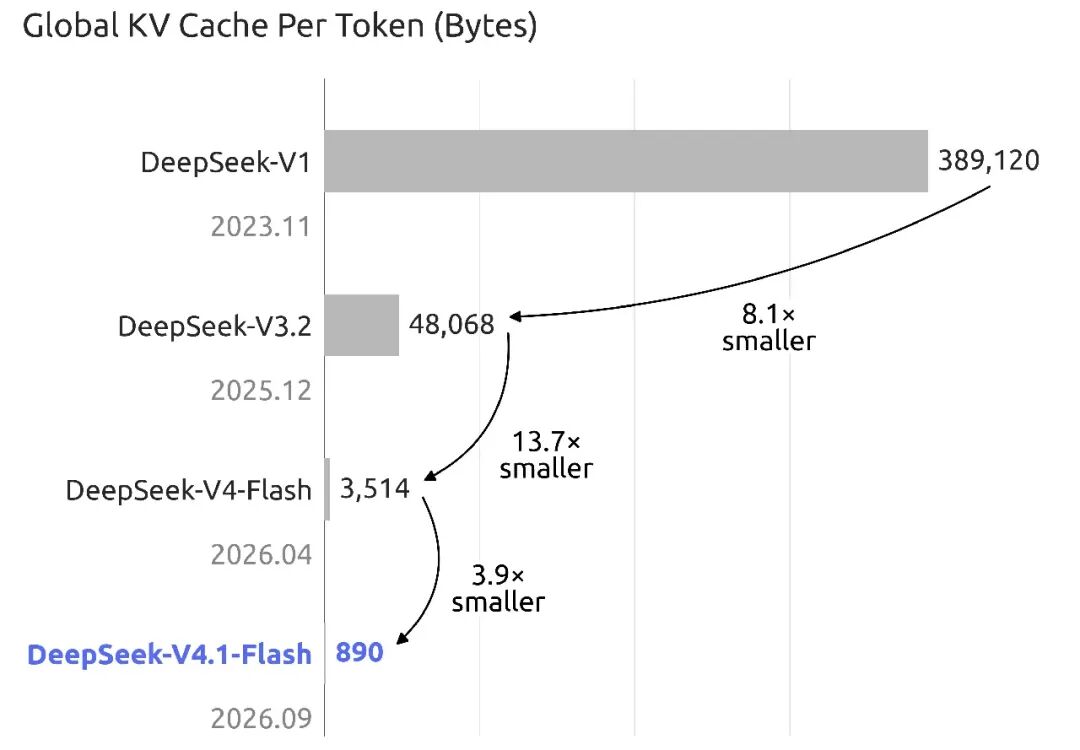
V1 高达 389,120 字节,V3.2 降到 48,068,V4-Flash 降到 3,514,V4.1-Flash 只有 890 字节——比 V4-Flash 小约 4 倍,比 V1 小 437 倍。压缩来自三层叠加:CSA2 注意力的跨层 KV 复用(Full / Reindex / Reuse 三种模式共享全局 KV 与 Top-K 索引)、FP4 精度的 KV 缓存、以及 SWA Bounded Replay 把 SWA 缓存从持久化存储里拿掉。
3.1 前缀命中:只有从第一个 Token 起完全一致才算数
Agent 每调一次工具,都要把系统提示、工具说明和之前每一轮的回复与工具结果整体重发给模型,其中绝大部分上一轮算过。DeepSeek 把算过的 KV 缓存存下来,下一轮只算新增的那一截。命中规则很严格:前缀必须从第一个 Token 起完全一致,中间重复的内容复用不了。
缓存分两类存放,官方在问答里给了一张明细表:
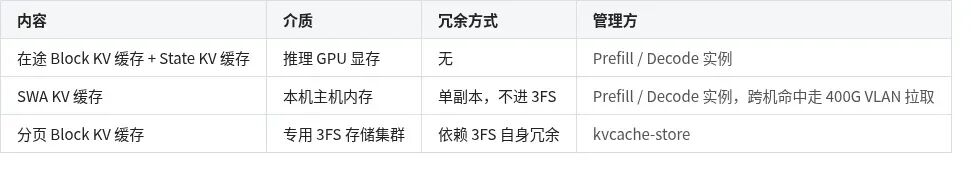
正在服务的请求,缓存放在 GPU 显存里;SWA(滑动窗口注意力)的缓存量小,留在本机内存,别的机器要用了通过 400G VLAN 现拉;大头是分页 Block KV 缓存,落进独立的 3FS 存储集群。把缓存从计算节点剥离有两个直接收益:任何一台 Prefill 机器都能命中任何一段前缀,调度时不用把用户绑死在上次那台机器上,前缀亲和与负载均衡不再打架;计算节点的故障率比存储节点高出一个数量级以上,机器挂了缓存还在。每条缓存的落盘体积也压得很小:20 层 × 134 个 Token × 528 字节(MXFP8 格式),一条序列约 1.35 MB。
3.2 3FS:100 PiB 固态硬盘上的缓存仓库
底层存储是 DeepSeek 自家的 3FS 分布式文件系统。
数据按 10+2 纠删码存放,每个 EC 组容忍两个节点同时故障;一次读请求同时发给组内 11 个存储节点,任意 10 个返回即可解码出数据。回收由 GC Worker 负责,每个存储节点部署一个实例,按 LRU 策略淘汰最久未用的缓存,把磁盘用量压在水位线以下。TTL 按流量类型区分:Agent 流量留 3 天,聊天流量留 7 天。聊天留得久是因为它的命中长尾很重——少量缓存会被反复读取很多次,丢了整体命中率掉得明显;按 DeepSeek 的经验,聊天流量只留 3 天命中率要掉 0.5% 到 1%。
缓存相关的开销被尽量藏了起来:命中匹配由 Entrypoint 对元数据做哈希链前缀匹配;取缓存是异步的,由独立进程把数据从 3FS 搬进主机共享内存;从共享内存进显存(swap-in)用 GDR 实现——RDMA 网卡直接打满 PCIe 带宽,不占用 GPU 的流处理器,逐层与正向计算重叠。
3.3 SWA Bounded Replay:缓存没命中?只补算 128 个 Token
这是 Prefill 侧最精巧的一个部件,值得展开。
V4.1 Flash 有一部分层用滑动窗口注意力(SWA),每个 Token 只看离自己最近的 128 个 Token。SWA Bounded Replay 的思路是:重算时只回放最近 128 个 Token,并把注意力窗口截断在回放段内——从位置 s 开始回放,位置 i 的 query 只对 max(s, i−127) 到 i 的 key 计算,得到一份近似的窗口缓存。重算成本从此变成一个常数,上下文多长、模型多少层都不影响。
这个机制用在两个地方。
- Encoder 侧:SWA 缓存缺失时,把命中前缀的最后 128 个 Token 重算一遍,和未命中部分一起前向,回放段只重建 SWA 缓存,Block KV 缓存原样复用。
- Decoder 侧更狠:V4.1 的 CED 架构里,Decoder 层的 Block KV 缓存由最后一层 Encoder 的隐状态投影而来,每次 Prefill 只需算 Decoder 的 SWA 缓存——精确重建要让 20 个 Decoder 层各跑最后 2560 个 Token,现在每层只重算最后 128 个,Prefill 总计算量因此少了近一半。命中策略也随之确定:命中长度由 Block KV 缓存决定,要不要退一块重算由 SWA 缓存决定——SWA 缺失就回退一个 128 Token 的块。
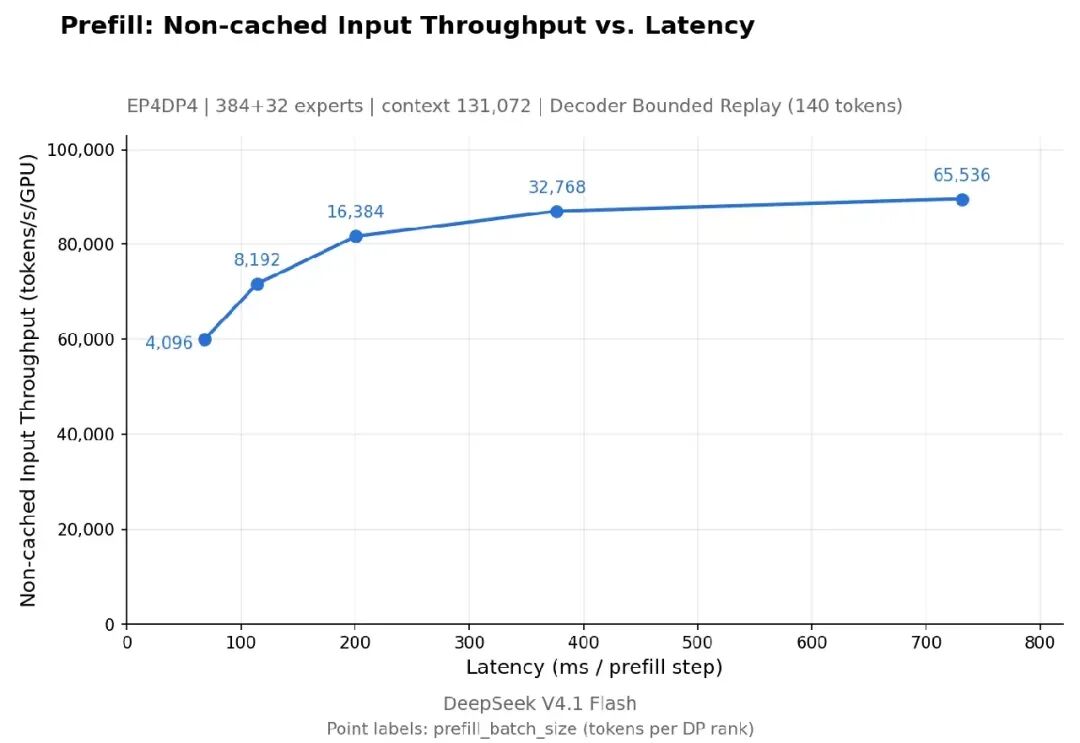
横轴是每步 Prefill 的时延(毫秒),纵轴是不含缓存命中的每卡输入吞吐。曲线上标注的数字是每个 DP rank 的 batch 大小:batch 从 4,096 提到 16,384 时,吞吐从 6 万涨到 8.2 万 Token/秒/卡,时延从约 70 毫秒涨到 200 毫秒,性价比最高的一段;继续加到 65,536,吞吐只爬到约 9 万,时延却冲到 730 毫秒。这条曲线的用法是选工作点:线上平均 TTFT 压在 400 毫秒,对应的就是曲线中段。测试在 4 张 SM100 GPU 上完成,仓库里的 run_sweep.sh 可以复现。
四、Decode:Wide-EP 摊薄显存读取,DSpark 变长验证省算力
4.1 Wide-EP:每张卡只放 6 个专家
Decode 阶段的核心矛盾是显存带宽:每生成一个 Token 都要把用到的参数从显存读一遍。V4.1 Flash 有 384 个路由专家,DeepSeek 把它们摊到 64 张卡上,每卡 6 个,再额外放 1 个热门专家的副本,共 7 个。每张卡上的专家越少,每步要读的参数越少,同样多的卡就能接住更多请求。
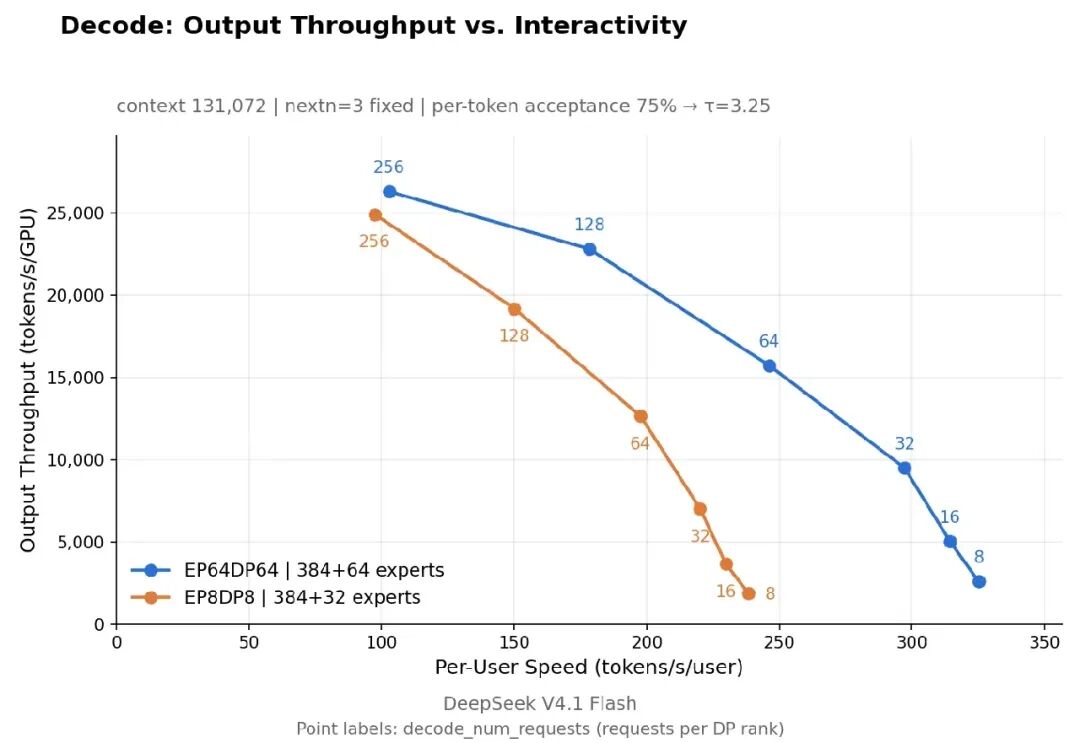
图中是 EP8 与 EP64 两种配置的 Decode 吞吐-交互速度对比,64 张卡的规模下,EP64 把 384 个专家摊到全部 64 卡(每卡约 6 个加副本),EP8 则每 8 卡就要装一整套专家。同样的每用户生成速度下,EP64 的每卡输出吞吐显著高于 EP8,差距来自每步 MoE 部分的显存读取量——专家摊得越开,单卡每步读的参数越少。这张图也是 Decode 侧“EP 能开多大开多大”这条原则的直接证据,配合 EPLB 把热门专家的负载摊匀,Wide-EP 的红利才能吃满。
热门专家的副本靠 EPLB(专家并行负载均衡器)动态调整:统计每个专家最近 N 步的负载,每隔 M 步把专家重新分配到各卡,专家权重通过 NVLink 的 symm_mem 在组内搬移。Prefill 侧每卡放 4 个冗余专家、100 步统计窗口、1000 步重排一次;Decode 侧每卡 1 个冗余专家、1000 步统计、10000 步重排。线上实测最忙的那张卡只比平均值高 9%(moe_lb = 1.090)。
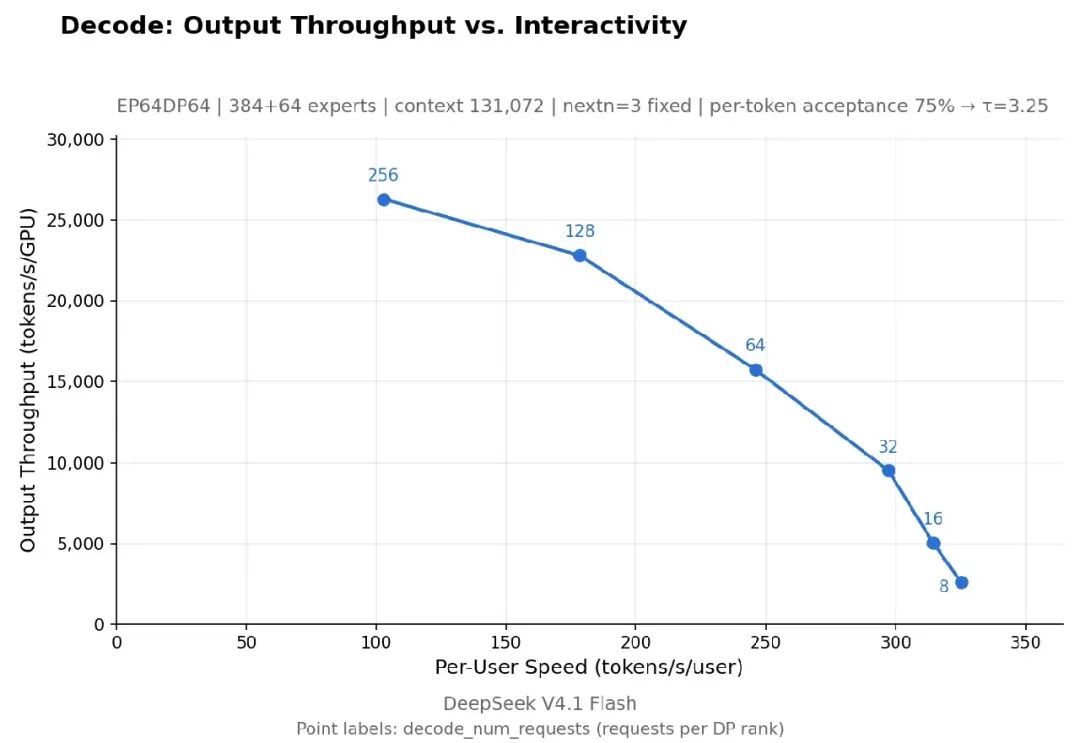
横轴是每个用户拿到的生成速度,纵轴是每卡输出吞吐,点上标注的是每个 DP rank 的并发请求数。并发 256 时每卡每秒能输出 2.6 万多个 Token,但每个用户只能拿到约 100 Token/秒;并发降到 8,单用户速度冲到 330 Token/秒,每卡吞吐只剩 2,600。运营方在这条曲线上选点:线上实测的 230 Token/秒(代码场景 300)对应的并发在 32 上下,是用吞吐换体验的取点。测试在 64 张 SM100 GPU 上完成。
算子层面还有一个细节:MoE 部分的计算由 Mega MoE 融合算子承担。按 DeepInfer 项目的部署问答文档的说法,它是 scale-up 域内的通用解——无论 EP 开多大、batch 多大,融合后的 Mega MoE 都明显快于未融合的 MoE 实现。想确认 DeepInfer 在自己的部署配置下调用了哪些 kernel,可以用仓库自带的 benchmark.py 脚本跑一遍 profile,生成的 trace 里带有完整的 kernel 使用信息。
4.2 DSpark:概率低的猜测,干脆不验
投机解码的常规做法是小模型先猜一批草稿 Token,大模型一次性验证,猜中的直接收下。DeepSeek 自研的 DSpark 往前走了一步:它用一个 Confidence Head 估计每个草稿 Token 被接受的概率,调度时把验证算力分配给期望回报最高的那批 Token,概率低的不验。
关键在于“变长”。草稿 Token 的接受率随请求、随位置波动,固定验 5 个会在低概率 Token 上浪费算力。DSpark 按硬件吞吐曲线和逐 Token 接受率排序,选出使有效吞吐最大的前缀子集去验证。官方给了完整的对比数据:
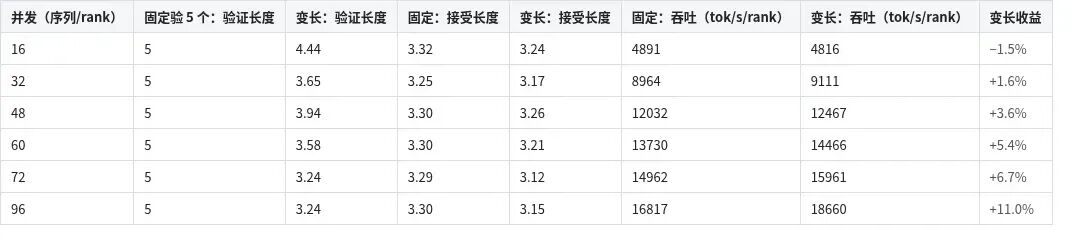
读法是看两列的关系:变长验证把每步验证的草稿数从 5.00 压到 3.2 到 4.4,砍掉约三成验证算力,平均接受长度几乎没掉(3.29 对 3.20)。收益随并发放大——并发 16 时反而略亏 1.5%,到线上工作点附近的并发 60 时赚 5.4%,并发 96 时赚 11%。原因很直觉:并发越高,省下的验证算力越能立刻被别的请求吃掉。另有一个实现细节:异步调度下,第 N 步的置信度还没回来就要排第 N+1 步,所以 CPU 只定总预算,逐请求的长度由一个 TileLang kernel 在 GPU 上重算(累积积、全局 top-k 排序加融合的 remap scatter),结果写回 pinned 内存。
DSpark 有完整论文可查:DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation,论文的主实验结果和线上部署数据可以和上面的表 3 对照着看。
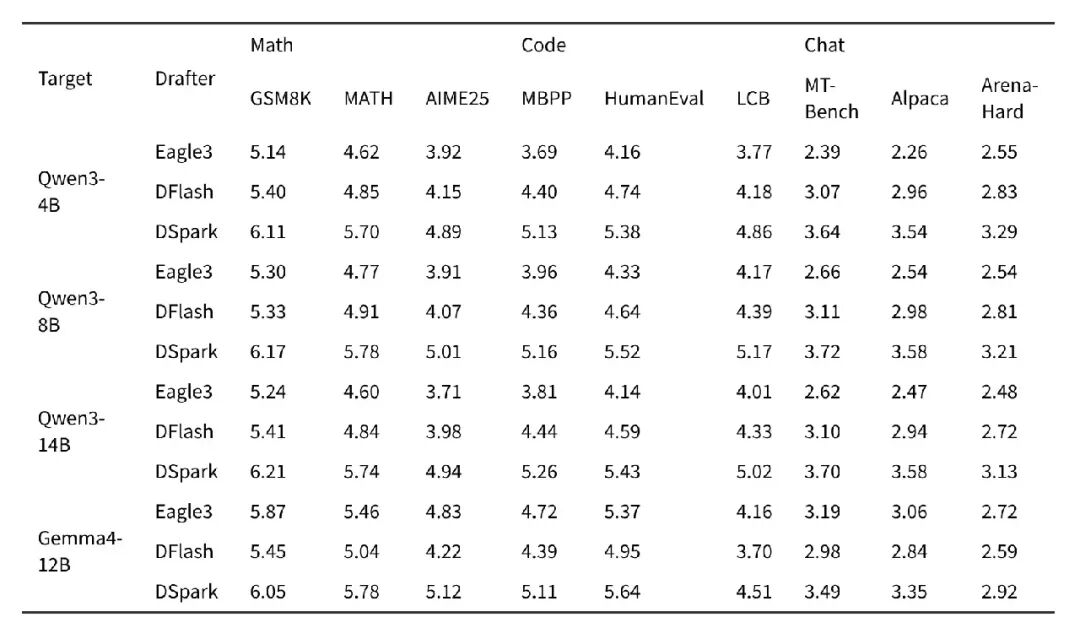
对比对象是 Eagle3 和 DeepSeek 上一代方案 DFlash,目标模型用 Qwen3-4B/8B/14B 和 Gemma4-12B 做通用性验证。DSpark 几乎全线领先,且任务越难领先越多:Qwen3-14B 上 GSM8K 从 DFlash 的 5.41 提到 6.21,AIME25 从 3.98 提到 4.94。接受长度高,意味着同样一次大模型验证能收下更多草稿 Token——这正是表 3 里“验证长度压到 3.2、接受长度几乎不掉”的算法底座。
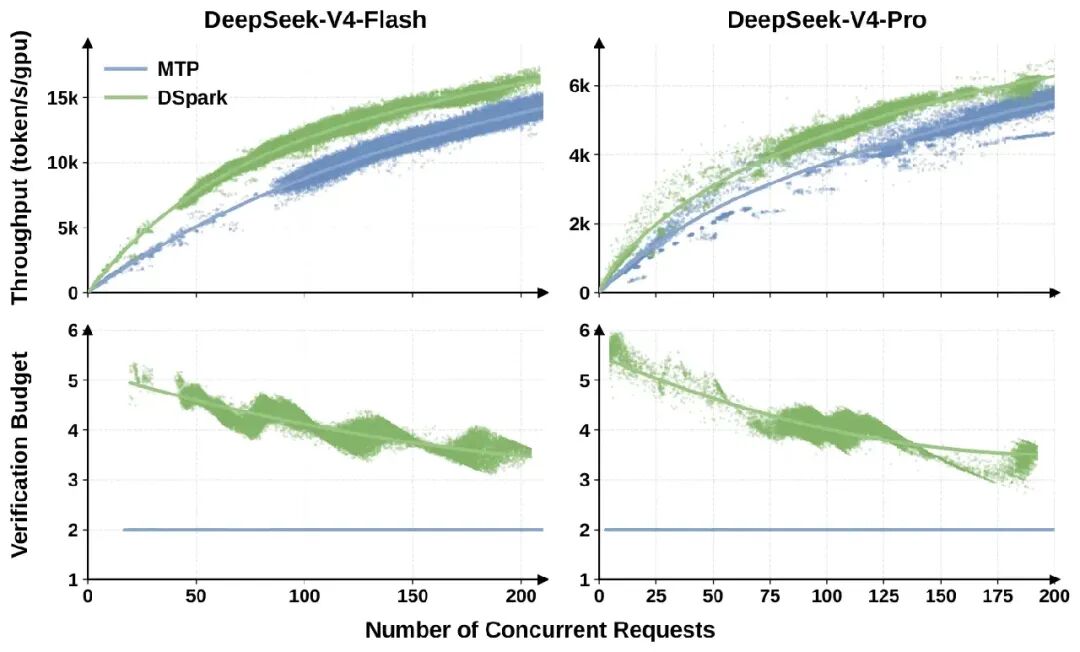
左右两列分别是 DeepSeek-V4-Flash 和 V4-Pro 两个生产模型,上排是聚合输出吞吐随并发请求数的变化,下排是每请求分配到的平均验证预算。绿色是 DSpark,蓝色是原来的 MTP 方案:同一并发下 DSpark 的吞吐稳定压过 MTP;并发从 0 涨到 200 时,动态调度器自动把每请求的验证预算从 6 个 Token 左右压到 3 个上下,防止验证算力互相挤占,而固定预算的 MTP 全程平成一条直线。这张图正好回答了变长验证“线上到底省不省”的问题:负载越高,预算收得越紧,离线表里并发越高收益越大的规律在线上同样成立。
4.3 异步调度:GPU 算第 N 步,CPU 排第 N+1 步
Decode 每步的流程是 schedule(N) → forward(N) → sample(N) → post-process(N),其中调度和后处理是纯 CPU 逻辑,后处理前还要等一次 GPU-CPU 同步拿采样结果。朴素实现里,CPU 干活的时候 GPU 只能干等。DeepInfer 的零开销调度器把流水线错开:GPU 跑 forward(N) 和 sample(N) 的同时,CPU 并行执行 schedule(N+1)、launch_forward(N+1)、post-process(N−1)、launch_sample(N+1),GPU 全程无空转。
这套做法沿用了 SGLang、NanoFlow 已有实现验证过的思路,DeepSeek 在知乎的异步调度一节里直接引用了这两篇论文(SGLang: Efficient Execution of Structured Language Model Programs(NeurIPS 2024);NanoFlow: Towards Optimal Large Language Model Serving Throughput(OSDI 2025))。NanoFlow 论文里有一张图把这种“GPU 干等”画得很清楚。
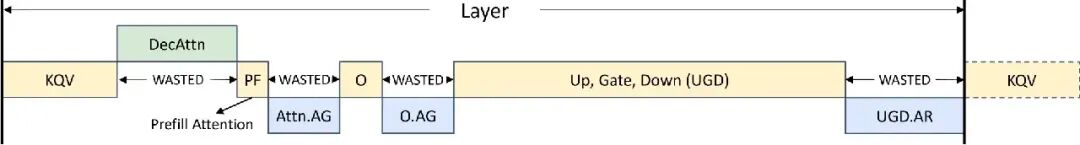
黄色是计算密集操作(KQV、FFN 投影),绿色是访存密集的注意力,蓝色是通信操作,三者在一层内串行执行,段与段之间标注“WASTED”的空白就是流水线气泡——算 FFN 时显存带宽闲着,做注意力时算力闲着,设备间同步时两者都闲着。NanoFlow 的结论是现有框架只达到理论最优吞吐的 22% 到 38%,它自己的解法是 nano-batch 把操作切碎重叠执行,拿下理论值的 68.5%。DeepInfer 的零开销调度器是同一条思路在 CPU-GPU 边界上的版本:让调度与后处理藏进 GPU 的执行时间里。
这套组合下来,线上 Decode 阶段每张卡每秒生成 1.4 万个 Token。
五、deepseek-recipe:官方 API 的编解码逻辑完整开源
请求进门后先过 deepseek-recipe。
它把三种主流 API 格式——OpenAI 的 Chat Completions 和 Responses、Anthropic 的 Messages——统一转成同一种对话格式(Conversation),再按模型版本渲染 prompt、编码成 Token;模型输出的 Token 也由它翻译回各家格式流式返回。
按 deepseek-recipe 项目的中文 README 文档的说法,它的目标是让第三方部署获得与官方 API 一致的行为;调用方需要自备模型推理、工具执行和 HTTP 传输,它只管编解码这一段。整套库用 Rust 实现、提供 Python 绑定(pip install deepseek-recipe 直接装),仓库拆成六个包:协议转换与输出解析、共享类型、prompt 渲染与 token 编码、图片拉取预处理、prompt! 宏、Python 绑定,另附一个能在浏览器里高亮 special token 的编解码 demo。
5.1 防注入与分段加速
有两个细节值得单独说。
- 第一是防注入:DeepSeek 的模型靠一批特殊 Token 标记对话结构,比如用户发言从哪开始、思考到哪结束、什么时候调工具。用户输入、工具结果里出现的
<|User|> 这类字符串会被编码成普通 Token 序列,拿不到控制权。输出侧同理:模型用普通 Token 拼出的 </think> 文本不会被误判成思考结束标记。
- 第二是分段加速:拼 prompt 时特殊 Token 的位置已知,中间的普通文本段可以跳过特殊 Token 匹配、并行编码再按序拼接,长上下文请求的编码时间明显缩短。流式解析用状态机加增量 KMP 匹配处理跨 chunk 的不完整 UTF-8 字符和 DSML 标签,工具参数边解析边以 JSON 片段流出,不用等整个参数对象构造完。
5.2 README 里的工程细节
README 里有几条写得很细、知乎长文里没展开的内容,真要接入的话,还是有参考价值:
生成参数的默认值有明确规则:未指定 max_tokens 时,非思考模式默认 8192,思考模式 65536,思考模式且 reasoning effort 拉满时 131072。
图片支持 base64 或外部 URL 传入,预处理基于 OpenCV,按 V4.1 的方式切 patch;V4 不接受图片,请求里的每张图会被替换为文本 [Unsupported Image]。README 还专门提醒了一个安全点:图片抓取组件默认不限制连接地址,如果服务会拉取用户请求里的 URL,应当安装 DestinationFilter 过滤目标——这是 SSRF(服务端请求伪造)防护的标准做法,官方把它写进了文档。
工具方面,V4.1 支持 Messages 协议的工具延迟加载和 Responses 的客户端工具搜索;结构化输出支持 Chat Completions 的 response_format(json_schema 与 regex)和 Responses 的 text.format,转换时会校验 JSON Schema 并写进 prompt,但是否由后端执行约束解码,由调用方决定。模型名解析默认接受 DeepSeek-V4-Pro 与 DeepSeek-V4.1-Flash,自定义名称(比如 deepseek-flash)可以注册别名。
这个组件采用 MIT 协议——比 DeepInfer 的 Apache 2.0 更宽松,商用几乎没有限制。
六、负载均衡、自动扩缩容与容错的工程细节
6.1 三层负载均衡
Prefill 负载均衡按输入长度把请求分成 4 档(<16K / 16–64K / 64–256K / ≥256K),每档分多少机器按上一轮的算力需求动态调整;DP 组间各引擎按剩余算力配额领活,因为任何引擎都能命中任何前缀,不需要前缀亲和路由。单卡内部,每个 Prefill 步分配一个时间预算,用一个拟合出的二次成本模型 cost(q, c) 预测耗时,反解出预算内能装下的最大 chunk。
Decode 负载均衡同时看两个维度:卡上的请求数(决定每步 batch size)和 KV 缓存总长度(决定注意力开销)。启发式规则是短请求发给并发少但缓存长的卡,长请求发给缓存短的卡。官方在问答里明确说,这套组内调度算法出自 DeepSeek 与清华、北大合作的 DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference(SIGCOMM 2026)。
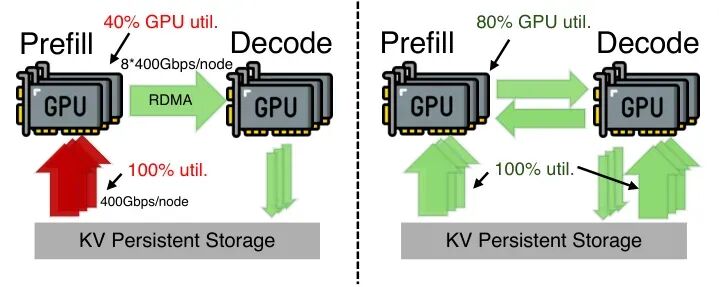
左半边是 PD 分离架构的既有瓶颈:KV 缓存全部从持久存储读进 Prefill 引擎,Prefill 侧的存储网卡被打满(红色箭头,利用率 100%),Decode 侧的网卡却在闲置,GPU 利用率只有 40%。右半边是 DualPath 的解法:新增一条“存储到 Decode”的路径,KV 缓存先读进 Decode 引擎,再经 RDMA 计算网络转给 Prefill,两个引擎的网卡聚合成一个全局带宽池,GPU 利用率拉到 80%。论文报告离线吞吐最高提升 1.87 倍、在线平均 1.96 倍。DeepSeek 线上系统 96% 的缓存命中率意味着瓶颈早已从计算转移到缓存搬运,这张图解释了他们为什么要为“读缓存”专门设计一套调度。
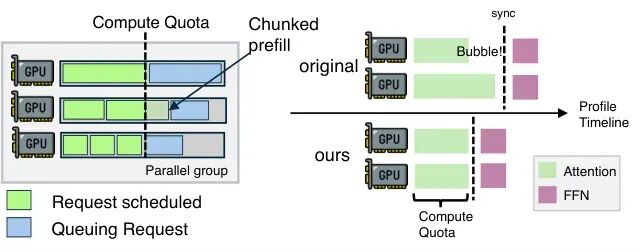
左图是按算力配额(Compute Quota)选 batch:绿条是已排入的请求,蓝条是排队请求,调度器在配额虚线内尽量装满。右图是 GPU 时间线对比:上方原始执行里,Prefill 分块之间的同步点留下气泡;下方应用算力配额后,注意力(绿)与 FFN(紫)交错排布,气泡被填掉。DeepInfer 部署问答里 Prefill 的 chunk 大小求解——每步给一个纳秒级时间预算,用二次成本模型反解能装下的最大 Token 数——就是这套配额思路的生产化版本,两者对照着看,论文里的机制设计和线上系统的工程参数能对上号。
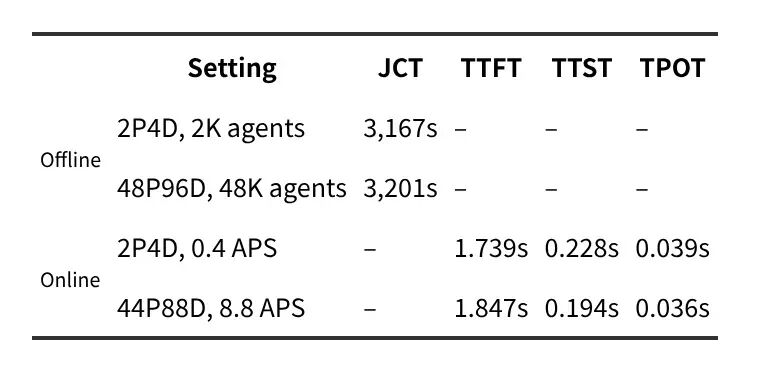
离线侧从 2 Prefill + 4 Decode(2 千个 Agent)扩到 48P96D(4.8 万个 Agent),任务量放大 24 倍,作业完成时间几乎不变(3167 秒对 3201 秒),接近线性扩展;在线侧 44P88D 把吞吐从 0.4 提到 8.8 APS(每秒处理的 Agent 请求数),扩了 22 倍,首字时延和逐字间隔基本原地不动。这张表回答的是“调度逻辑放到千卡规模会不会塌”——DeepInfer 线上单集群每天跑 155 万亿 Token,靠的就是这种扩展能力。
Vision Encoder 侧按图路由:图交给当前处理 patch 数最少的那张卡,patch 数直接由图片宽高算出来。一套调度下来,系统整体能跑到离线完全均衡状态的 80% 左右。
6.2 扩缩容与容错
Prefill 按未命中缓存的 Token 数决定需要多少机器,Decode 按在途请求数调整,调整有速率限制和上下界。
为应对大 EP 部署里长尾请求造成的浪费,Decode 引擎收到下线通知后有 1 分钟宽限期,没跑完的请求连同 KV 缓存一次性转发给别的引擎继续解码。冗余配额有两种形态:池子里常备未占用的机器作为扩容库存,配额利用率超过 0.8 时禁止缩容。单引擎重启是分钟级,容错靠配额冗余加请求级重路由。大 EP 部署里一张卡坏了整个实例不可用,重启时平台按当前健康卡数重新确定 EP 大小,让剩下的卡继续服役。
跨机房部署也给了答案:V4.1 Flash 大幅压缩了 KV 缓存,P 和 D 拆到不同机房技术上可行,每 8 张卡配约 400 Gbps 互联带宽就够,代价是可靠性——官方原话是跨机房的光纤容易被施工挖断。DeepSeek 自己的推理节点放在不同但相邻的机房里。
七、本次开源的范围与缺口
开源项目 deepseek-ai/DeepInfer 的 README 主动列了一张缺口清单,想直接替换现有部署的团队应该先看这里:KV 缓存系统、VE/Prefill/Decode 分离式部署(引擎功能大部分已实现)、跨 DP 副本的负载均衡,这三块不在本次开源范围内,因为它们和 DeepSeek 内部基础设施耦合太深。设计细节写进了知乎长文和部署问答,代码暂时没有。换句话说,DeepInfer 现在是一台强力发动机,KV 缓存与调度方案要自己备,或者等官方与社区后续拼装。
另外还有几条限制需要交代。
开源版本提供的是离线推理能力;当前只支持 DeepSeek-V4.1-Flash 一个模型;硬件只有 SM100 和昇腾 950 两档,CUDA 13 与 CANN 9.2 分别是门槛,Hopper 用户暂时用不上。
官方还坦诚交代了内部版与开源版的差距:DeepInfer 项目的部署问答文档里写明,开源项目 deepseek-ai/DeepGEMM、开源项目 deepseek-ai/FlashMLA这些算子库的内部版与开源版大体一致,索引器和 Mega 系列略有差异;FlashMLA 缺一项手工调优的 SASS 优化,解码 kernel 慢 5% 到 10%,端到端最多差 5%。
2025 年那份声明里“小团队维护精力有限”放在在今天依然如此,引擎级开源项目的长期维护承诺,是比性能数字更值得盯的指标。
八、评论区:玩梗之外,几条值得留意的声音
DeepSeek 这篇知乎长文下有 644 条评论(截稿时的数字,还在上涨),多数是玩梗——“这是真 OpenAI”“村民向你分享了核聚变技术.jpg”“天阶功法,人手一册”“什么,你把印钞机开源了”。梗之外,有几条评论带着真实的信息量,挑出来讲。
这次开源的深度和诚意,让不少网友觉得 DeepSeek 比名字里带 Open 的那家更配得上这个词。第三张“武装保卫开源社区”则是对 DeepSeek 持续开源的应援。梗图能在评论区刷屏,说明这次开源的出圈程度不限于技术圈。
8.1 一条换算:38 美元/卡时是什么概念
有网友做了个朴素换算:按 10 万张卡、每天约 6091 万元人民币的收入,折成大米约 2175 万斤生米、煮熟 5000 万斤米饭,够 20 多万人吃一年。换算法本身粗糙(10 万卡是他自己的假设,6091 万是由 38 美元/卡时反推),但它把“每卡每小时 38 美元”这个抽象数字翻译成了体感。
这套开源系统每天支撑的是一笔亿元量级的生意。另一条评论则盯住了官方问答里“整体收入按谷价折算”的表述,直接点破“毛利 80% 有点显眼”——这个数字最早出自 DeepSeek-V3/R1 时代的 DeepSeek-V3 / R1 推理系统概览,当时按 R1 定价算过一笔理论账,如今在 V4.1 上再次得到呼应。
8.2 一条担忧:竞争对手也能看到,但他们用不了
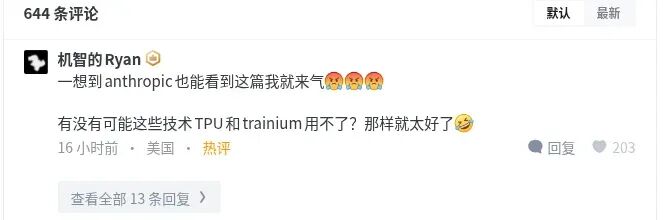
背后反映了一个真实问题:推理引擎的深度优化从来都与硬件绑定,DeepInfer 的 kernel 层依赖为特定架构手工调优的算子库,短期内移植到 TPU、Trainium 这类加速器上并不容易。
8.3 收尾
从 2025 年开源周放出 FlashMLA、DeepEP 这些零件,到 2026 年 10 月把每天跑 155 万亿 Token 的引擎本体连同 API 编解码组件一起交出,DeepSeek 用一年半的时间,把开源从模型权重一路铺进了生产栈的深处。
这套系统里的每一条经验——缓存分几级、专家怎么摊、调度如何藏进 GPU 的空隙里——都是真金白银的流量喂出来的,如今以代码和万字长文的形式交到了所有人手上。对部署 DeepSeek 系模型的团队来说,这是第一次不用对着论文和零件自行拼装,官方生产级引擎的骨架就在眼前;对国产算力栈来说,昇腾 950 与英伟达 SM100 并列首发,这份官方引擎背书的分量,超过任何一次社区适配。
悬念也留得很具体:缺的三块(KV 缓存系统、VE/Prefill/Decode 分离式部署(引擎功能大部分已实现)、跨 DP 副本的负载均衡)什么时候补上,新模型的 Day-0 同步能不能持续兑现。答案可能要等接下来的这半年。但有一点已经可以确定:开源世界里最有说服力的东西,从来都是正在线上跑着的系统本身。🐟
参考资料
[1] 开源项目 deepseek-ai/DeepInfer: https://github.com/deepseek-ai/DeepInfer
[2] 开源项目 deepseek-ai/deepseek-recipe: https://github.com/deepseek-ai/deepseek-recipe
[3] The Path to Open-Sourcing the DeepSeek Inference Engine(开源 DeepSeek 推理引擎的路径): https://github.com/deepseek-ai/open-infra-index/blob/main/OpenSourcing_DeepSeek_Inference_Engine/README.md
[4] DeepSeek V4.1 Flash 大规模推理部署实践: https://zhuanlan.zhihu.com/p/2095560295930508953
[5] DeepInfer 项目的部署问答文档: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md
[6] DeepInfer 项目的 README 文档: https://github.com/deepseek-ai/DeepInfer/blob/main/README.md
[7] 在 X 上公开致谢: https://x.com/vllm_project/status/2112480719952138301
[8] 开源项目 deepseek-ai/DeepInfer 中的图片文件: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/images/architecture_overview.png
[9] DeepSeek V4.1 Flash 大规模推理部署实践: https://zhuanlan.zhihu.com/p/2095560295930508953
[10] DeepSeek-V3 / R1 推理系统概览: https://zhuanlan.zhihu.com/p/27181462601
[11] DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression: https://arxiv.org/abs/2609.19969
[12] DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression: https://arxiv.org/abs/2609.19969
[13] DeepInfer 项目的部署问答文档: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md
[14] 开源项目 deepseek-ai/DeepInfer 中的图片文件: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/images/prefill_pareto.png
[15] 开源项目 deepseek-ai/DeepInfer 中的图片文件: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/images/wide_ep_decode_pareto.png
[16] 开源项目 deepseek-ai/DeepInfer 中的图片文件: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/images/decode_pareto.png
[17] DeepInfer 项目的部署问答文档: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md
[18] benchmark.py 脚本: https://github.com/deepseek-ai/DeepInfer/blob/main/examples/benchmark.py
[19] DeepInfer 项目的部署问答文档: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md
[20] DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation: https://arxiv.org/abs/2607.05147
[21] DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation: https://arxiv.org/abs/2607.05147
[22] DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation: https://arxiv.org/abs/2607.05147
[23] SGLang: Efficient Execution of Structured Language Model Programs: https://arxiv.org/abs/2312.07104
[24] NanoFlow: Towards Optimal Large Language Model Serving Throughput: https://arxiv.org/abs/2408.12757
[25] NanoFlow: Towards Optimal Large Language Model Serving Throughput: https://arxiv.org/abs/2408.12757
[26] deepseek-recipe 项目的中文 README 文档: https://github.com/deepseek-ai/deepseek-recipe/blob/main/README.zh.md
[27] DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference: https://arxiv.org/abs/2602.21548
[28] DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference: https://arxiv.org/abs/2602.21548
[29] DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference: https://arxiv.org/abs/2602.21548
[30] DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference: https://arxiv.org/abs/2602.21548
[31] 开源项目 deepseek-ai/DeepInfer: https://github.com/deepseek-ai/DeepInfer
[32] DeepInfer 项目的部署问答文档: https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md
[33] 开源项目 deepseek-ai/DeepGEMM: https://github.com/deepseek-ai/DeepGEMM
[34] 开源项目 deepseek-ai/FlashMLA: https://github.com/deepseek-ai/FlashMLA
[35] DeepSeek-V3 / R1 推理系统概览: https://zhuanlan.zhihu.com/p/27181462601
 发表于 前天 07:02
|
查看: 5|
回复: 0


