Unsloth 这周给 DeepSeek V4.1 Flash 放出了新一版量化。说明页开头写着 128G 以上内存能跑,64G 也能跑,只是慢一点;往下翻到它自己的配置表,最小的 1 比特版本,除了可以放进固态的那部分,至少还要 122.4G 内存加显存。
模型到底有多大
这次说的模型是 DeepSeek V4.1 Flash-1017,属于 V4.1 Flash 的更新版,支持 100 万上下文。模型主干有 5520 亿参数,另外挂了一张 1960 亿参数的 Engram 查找表,表里存的是最多四个词连在一起的组合,每生成一个新词只查其中几行。
这张表不用一直待在显存里,可以放在固态硬盘上,用到哪几行再读进系统缓存。Unsloth 敢写 64G 能跑,本质上就是把这张表挪出了内存。
配置表其实写着 128G 起步
Unsloth 的配置表按内存加显存计算,Mac 这类统一内存的机器按总内存算,前提都是查找表放在固态上。1 比特版本要 128G 到 145G,2 比特要 176G 到 205G,3 比特要 256G 到 290G,4 比特和 8 比特分别要 305G、315G。
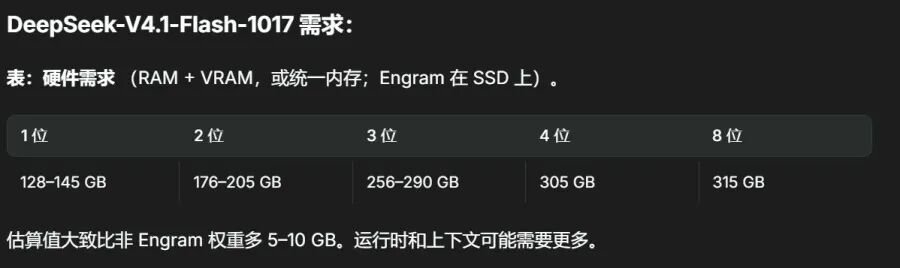
最小的 UD-IQ1_S 一共 233G,其中 110.6G 是查找表,剩下 122.4G 是其他权重。表格下面写得明白:这 122.4G 是绝对最低要放进内存或显存的量。64G 只够装下一半多一点,64G 那句话后面跟的其实是“更慢”两个字。
Unsloth 自己点名的 128G 机器,是 MacBook、DGX Spark、RTX Spark 这类统一内存设备;3 比特要 256G,举的例子是 Mac Studio。
光内存就要一万多
换成攒台式机的账,64G 的 DDR5-6000 内存,国内二手参考价 5400 元。凑到 1 比特版本起步的 128G,光内存就是 1.08 万元,固态上还得腾出 233G 放模型文件。
Unsloth 这一版的卖点其实在别处:它说在 AIME25、GPQA Diamond、LiveCodeBench 这些测试里,新算法大多比上一版和别家的量化成绩更好;配合它的桌面程序和 llama.cpp,推理速度比别的方案快 3 倍左右。Hugging Face 上这个模型仓库的下载量已经超过 29 万。
它也提醒,量化压得越狠,模型思考过程会拉得越长,小比特版本需要预留更多推理预算。
如果对本地部署和模型量化还有疑问,也可以在 云栈社区 继续交流。 |  发表于 5 小时前
|
查看: 6|
回复: 0
 /1


