传统多模态检索,往往要维护多套 embedding 模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
想实现用文字搜图片或用声音搜素材,还需要组合不同模型,再将各路检索结果合并排序。
但 Google 最近开源的 EmbeddingGemma 2(以下简称 EG2)提供了一个更便捷的方案:740M 参数,可以把文本、图片、视频和音频编码到同一个向量空间。
相比此前已有的统一多模态模型如 ImageBind,EG2 最大的特点在于它的模型规模和资源配置:完整模型只有 740M 参数,编码器可以按模态加载,默认的 768 维向量还可以裁剪到 256 维甚至 128 维。
这几个特点让 EG2 成为本地多模态检索的一个不错的最新选择。
但小模型覆盖更多模态,实际检索效果能否跟上?向量裁剪又能节省多少存储?
我们将 EG2 接入 Milvus,与 Nomic、qwen3.7-text-embedding-flash 和 Qwen3-VL-Embedding 进行了小规模横评,并比较 EG2 在不同向量维度下的检索效果。
以下是实验细节。
01 EG2 解读:740M 参数覆盖四种模态与维度
EG2 采用 Apache 2.0 协议,默认输出 768 维向量。
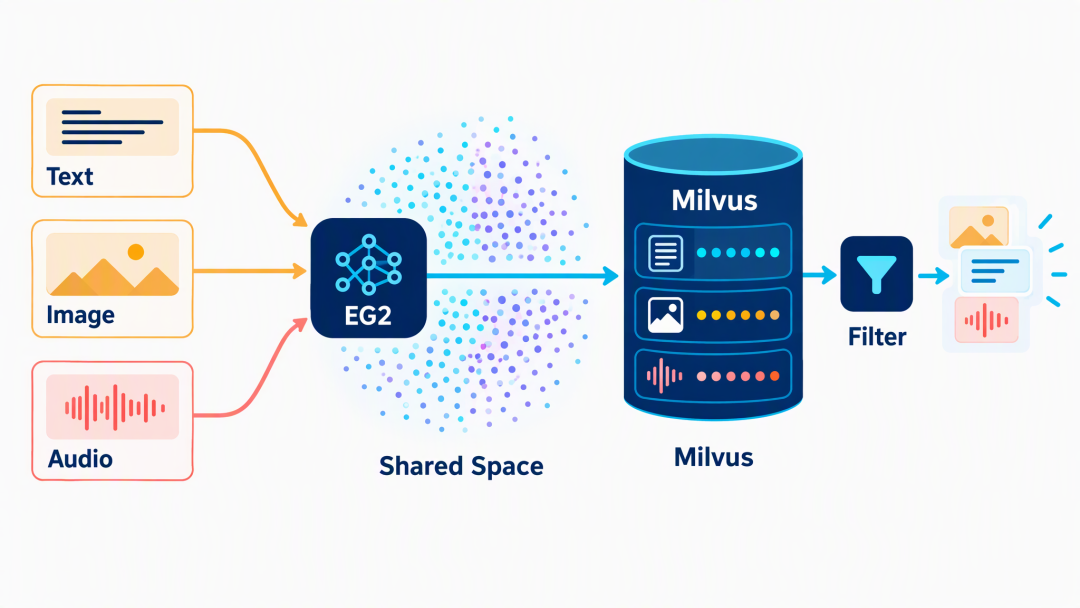
它可以单独编码文本、图片、视频和音频,也可以接收交错包含多种模态的输入,生成一条统一的 embedding。
例如,一张狗的照片、一段狗叫音频,以及“一只狗正在叫”的文字描述,都可以分别转换为向量,并在同一个空间内计算相似度。
在 Milvus 中,这些数据可以共用一个 collection 和一个 FLOAT_VECTOR 字段,再通过 modality 字段区分数据类型。
此外,EG2 还有两个与资源成本直接相关的特点。
第一,模型按需加载。
EG2 的视觉和音频编码器可以按需加载,对应的模型规模如下:
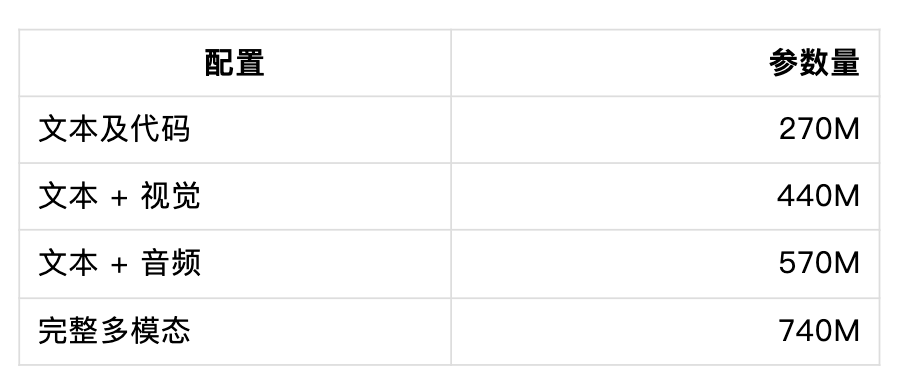
还可以在素材入库时使用完整的多模态模型,而面向文字搜索的线上查询服务则只加载 270M 的文本部分。270M 配置相比完整 740M 模型,参数数量减少约 63.5%。
第二,向量维度可裁剪。
EG2 支持 Matryoshka Representation Learning(MRL),可以使用 768、512、256 或 128 维向量。
向量维度越低,每条数据的存储量越小。对于拥有数百万甚至数千万条素材的数据库,维度变化会直接影响向量存储规模。
Google 官方模型卡给出了不同维度的表现:
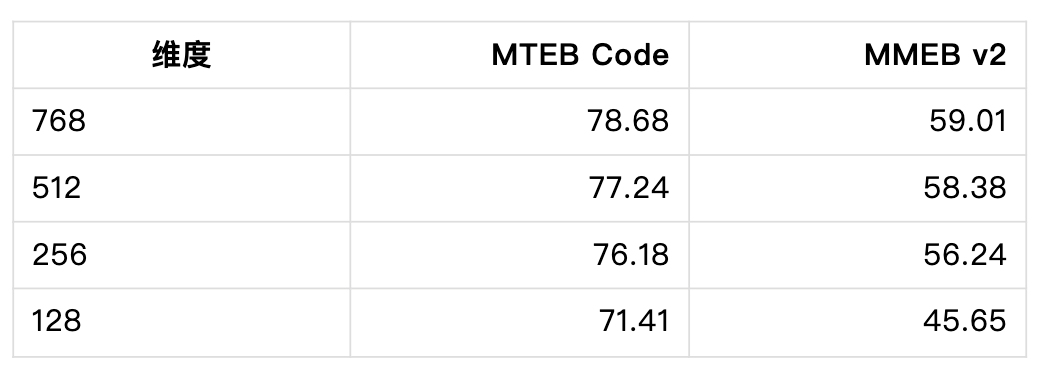
256 维的综合得分与 768 维相对接近,128 维的多模态指标则出现了更明显的下降。
因此,本轮实验重点比较 768 维和 256 维,观察实际检索任务中的精度与存储取舍。
更多官方测试结果如下:
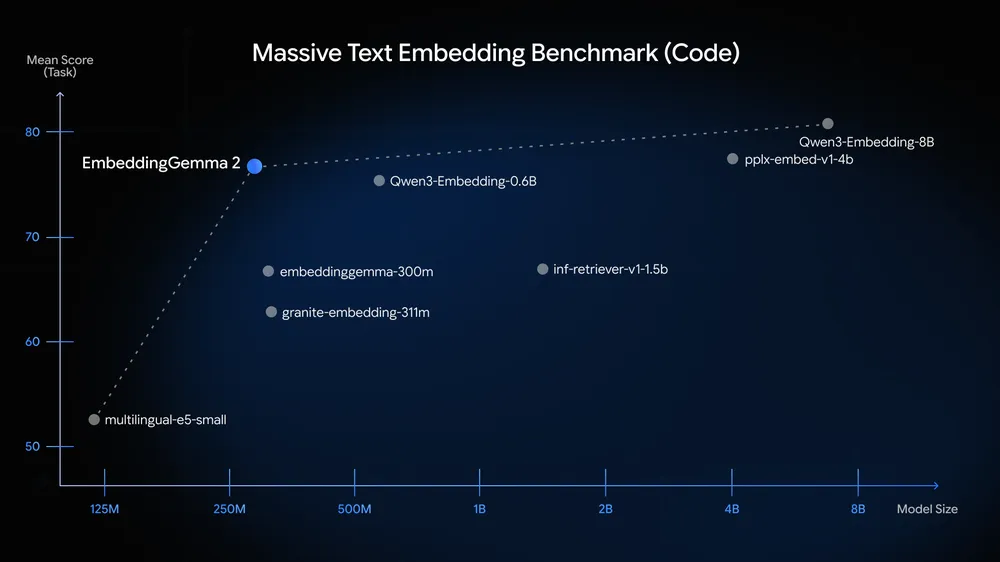
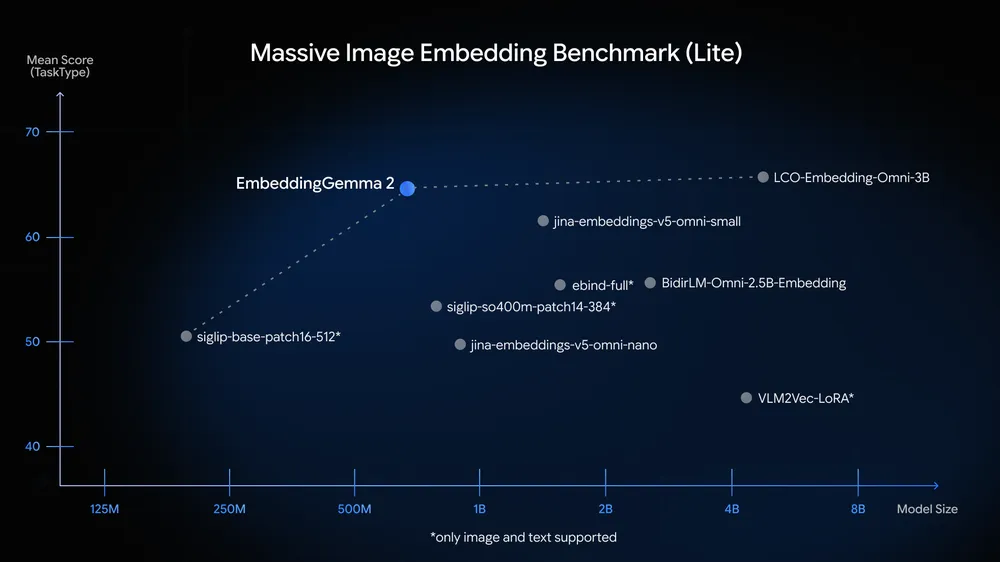
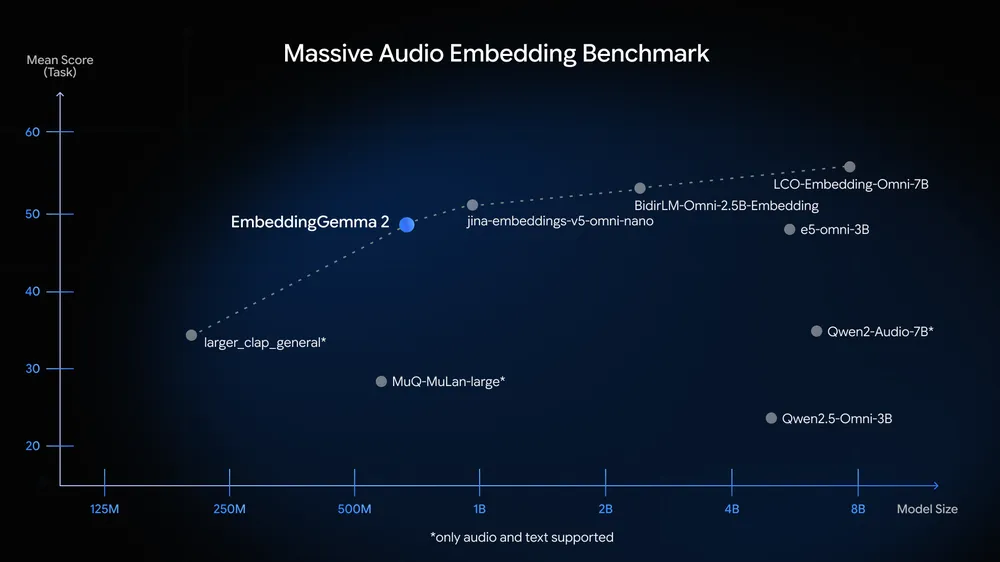
02 实验设计
为了评价 EG2 在小模型规模下的竞争力,我们选取了三款模型作为对照。
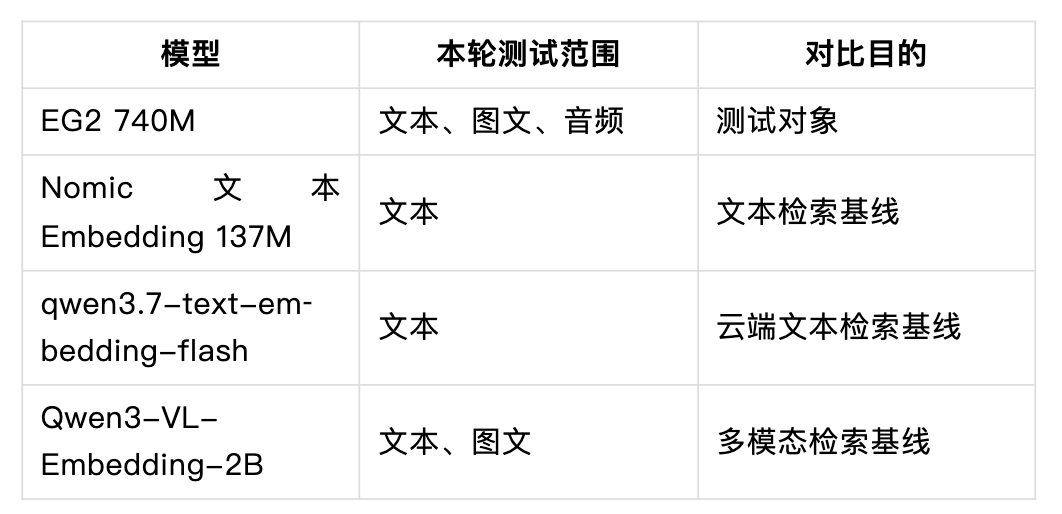
EG2 的对手有两类。
第一类是 Nomic 和 qwen3.7-text-embedding-flash 这样的文本模型。它们适合文本到文本的检索,但不能直接接收图片或音频。
第二类是 Qwen3-VL-Embedding 这样的多模态模型。它可以处理文本和图片,图文效果更强,但本轮使用的接口不接收音频。
其中,Qwen3-VL-Embedding-2B 的模型规模约为 EG2 的 2.7 倍,也支持多模态统一表示。通过这组对比,可以观察 EG2 在更小体量下的文本和图文检索表现。
本轮使用 Flickr8k 和 ESC-50 的部分数据进行测试。
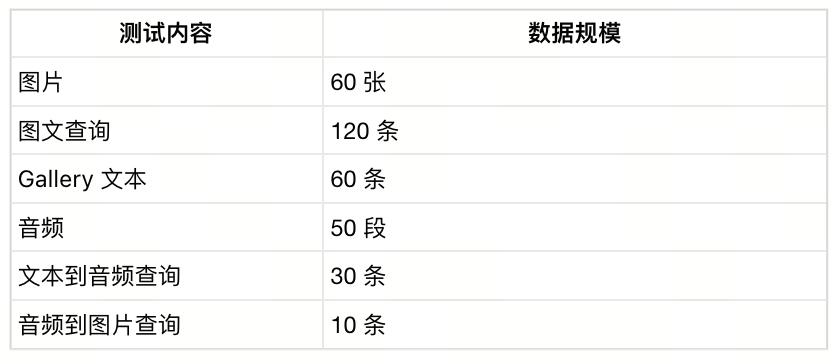
实验环境使用 Milvus 2.6.23、FLAT 索引和 COSINE 距离。
每个模型使用独立 collection,按照对应的向量维度建立字段。图文任务采用精确配对关系计算 Recall@K,音频任务采用类别关系计算 Hit@K。
例如,图文任务要求模型找到与查询对应的图片;音频任务中,查询“狗叫”,前 K 个结果只要包含属于狗叫类别的音频,即视为命中。
这些样本主要用于观察模型在具体检索任务中的表现和工程取舍。
03 实验教程:用 EG2 + Milvus 构建统一多模态检索
先看 EG2 如何接入 Milvus。
本次使用本地 Ollama 调用 embeddinggemma-2:740m,通过 PyMilvus 连接 Milvus 2.6.23。
接入演示中,文本、图片和音频都放进同一个 collection。每条数据保存模态、素材标识和向量。
schema = MilvusClient.create_schema(auto_id=True)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
)
schema.add_field(
    field_name="modality",
    datatype=DataType.VARCHAR,
    max_length=16,
)
schema.add_field(
    field_name="ref",
    datatype=DataType.VARCHAR,
    max_length=256,
)
schema.add_field(
    field_name="vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=768,
)
三种模态共用 vector 字段:
rows = [
    {
        "modality": "text",
        "ref": "dog",
        "vector": embed("一只狗在叫"),
    },
    {
        "modality": "image",
        "ref": "dog",
        "vector": embed({
            "image": image_base64,
        }),
    },
    {
        "modality": "audio",
        "ref": "dog",
        "vector": embed({
            "audio": audio_base64,
        }),
    },
]
用文字搜图片时,加上模态过滤:
hits = client.search(
    collection_name="eg2_mm",
    data=[embed("狗叫")],
    filter='modality == "image"',
    limit=5,
    output_fields=["ref", "modality"],
    consistency_level="Strong",
)
需要搜索音频时,将过滤条件改为:
filter='modality == "audio"'
去掉 modality 过滤条件,就可以让文本、图片和音频一起参与搜索和排序。
这意味着,应用可以用同一个 collection 支持多种搜索方式。用户可以输入文字,再根据需要获取图片、声音或混合结果。
将向量裁剪到 256 维
EG2 支持 MRL,因此可以直接截取 768 维向量的前 256 维,再做 L2 归一化。
import numpy as np

def truncate_256(vector):
    v = np.asarray(
        vector,
        dtype=np.float32,
    )[:256]
    norm = np.linalg.norm(v)
    if norm == 0:
        raise ValueError("Zero-length vector")
    return (v / norm).tolist()
调用方式:
full_vector = embed("一只狗在叫")
vector_256 = truncate_256(full_vector)
在 Milvus 中使用 256 维向量时,需要创建维度为 dim=256 的目标向量字段,并确保查询与入库向量使用相同维度。
如果已经保存了完整的 768 维向量,可以直接进行截取和归一化,无需重新编码原始素材。
至此,文本、图片和音频的统一入库、跨模态检索,以及向量裁剪都可以在 Milvus 中实现。
下面来看实际结果。
04 横向评测结果
文本检索:EG2 高于两款文本基线
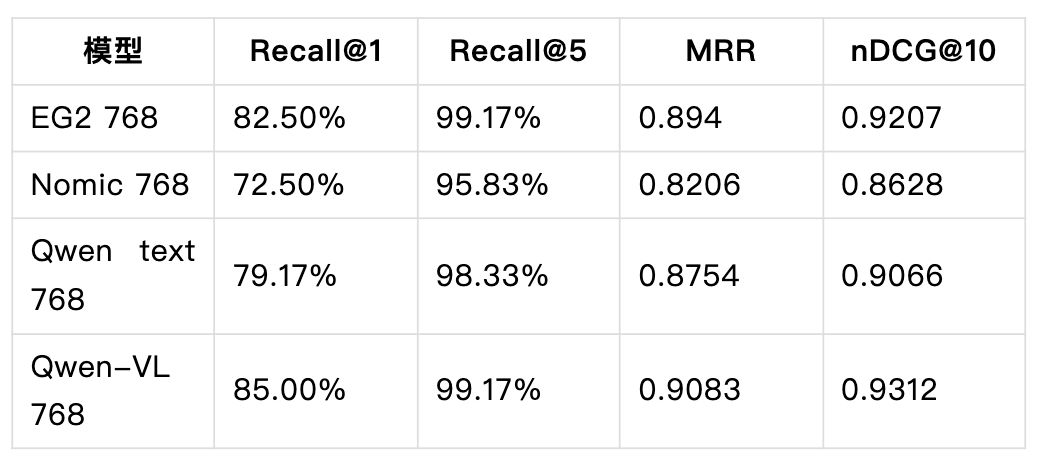
我们使用 Flickr8k 图片描述的改写与配对关系,测试模型能否通过一条描述找到对应文本。
最终 EG2 高于 Nomic 和 qwen3.7-text-embedding-flash,略低于 Qwen-VL。
也就是说,EG2 在覆盖视觉和音频能力的同时,仍然保持了良好的短文本语义匹配效果。
不过,这组任务主要使用 Flickr8k 的 caption,文本较短,语义相对具体。对于代码搜索、长文档 RAG 等任务,还需要使用对应的数据集判断模型效果。
图文检索:EG2 距离 Qwen-VL 仍有一段距离
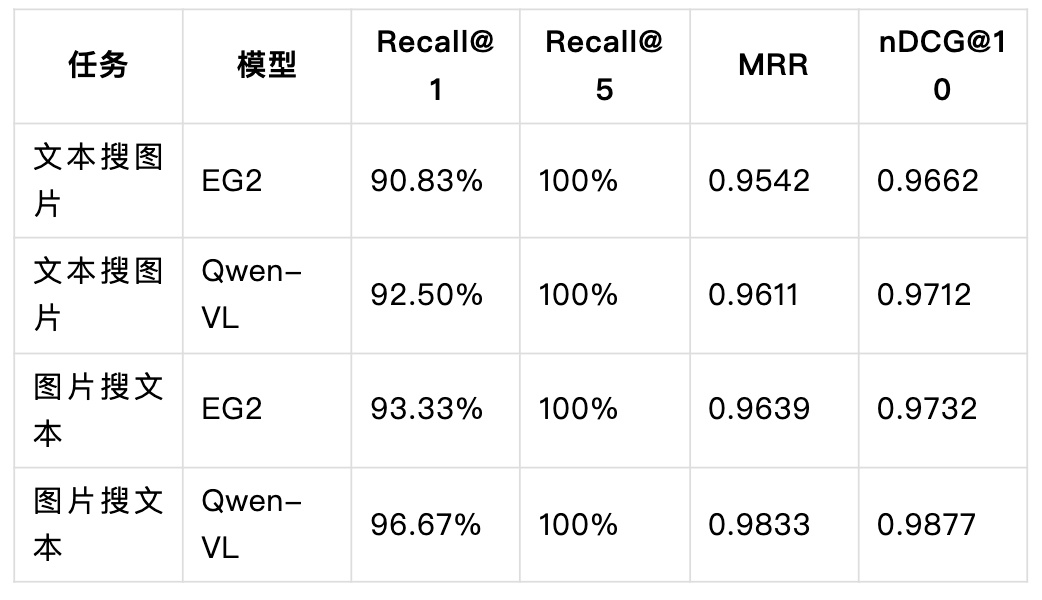
两项图文任务中,EG2 都略低于 Qwen-VL,但差距不大。
但两者的模型规模存在明显差异:
- EG2 完整模型:740M 参数
- Qwen3-VL-Embedding-2B:约 2B 参数
EG2 的参数量约为 Qwen-VL 的 37%,却在本轮图文任务中取得了相对接近的检索成绩。
音频检索
音频部分只测试 EG2。因为云端两款对照模型本轮接口不接收音频,无法做同条件比较。
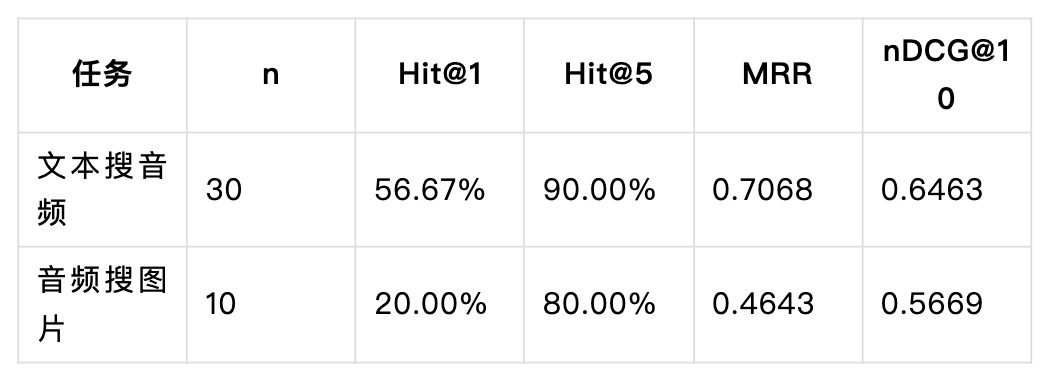
这里使用 Hit@K,表示前 K 个结果中是否至少命中一个同类别样本。
结果来说,音频链路可以跑通,但排序不稳定。此前的接入演示中,中文查询“狗叫”时,猫叫音频以 0.860 排在第一,狗叫音频为 0.853;换成英文 a dog barking 后,狗叫才回到第一。
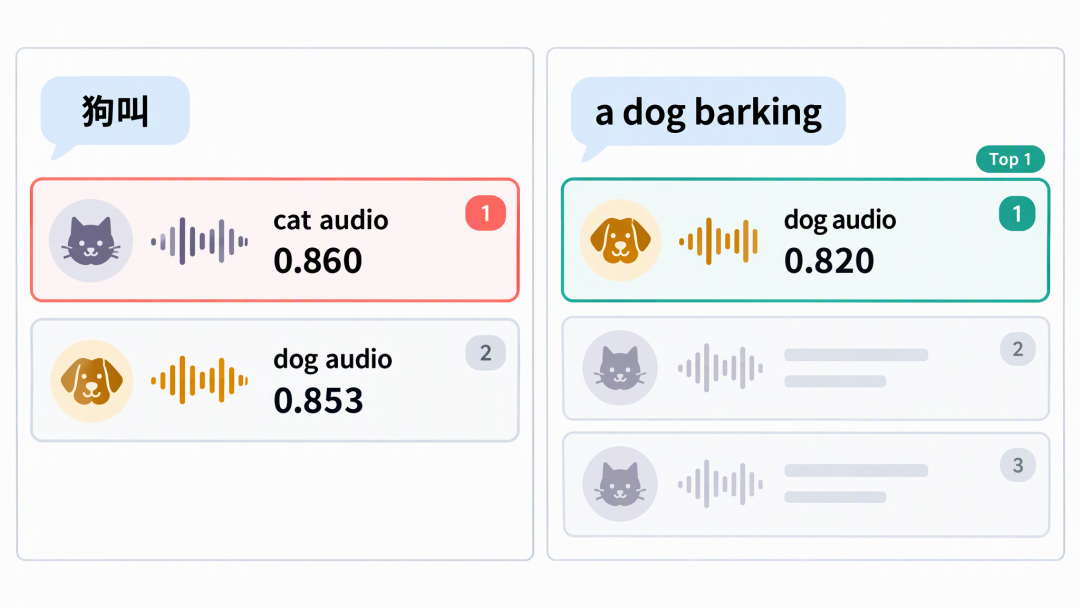
这组结果说明,EG2 能够直接建立文字与声音的语义关联,但实际排序质量会受到查询表达和模型语义对齐能力的影响。
另外,本轮演示使用的是原始文本查询,没有加入 Google 推荐的检索任务前缀。任务前缀也是后续优化音频检索效果时值得考虑的因素。
768 维和 256 维对比
EG2 支持 MRL 截维。本次直接截取 768 维向量的前 256 维,再做 L2 归一化,没有重新调用模型。
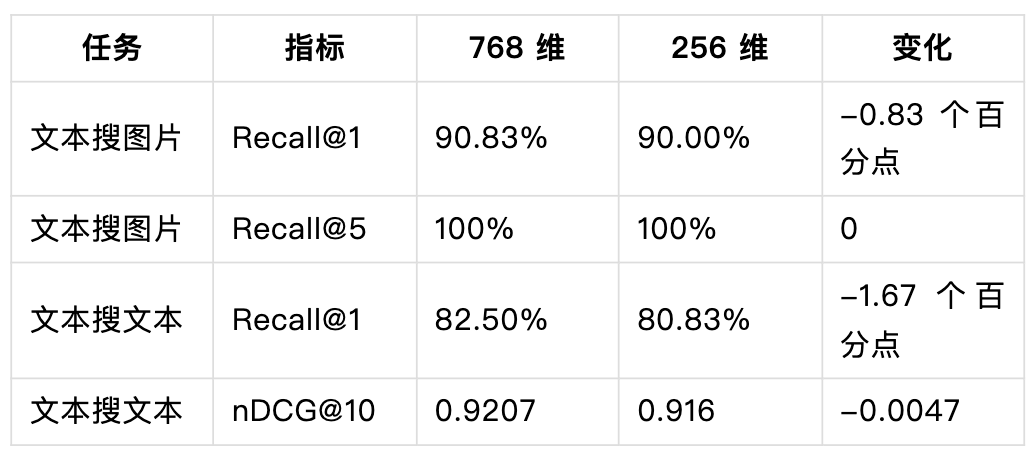
float32 下,768 维向量需要 3,072 字节,256 维向量需要 1,024 字节,原始向量存储减少 66.7%。
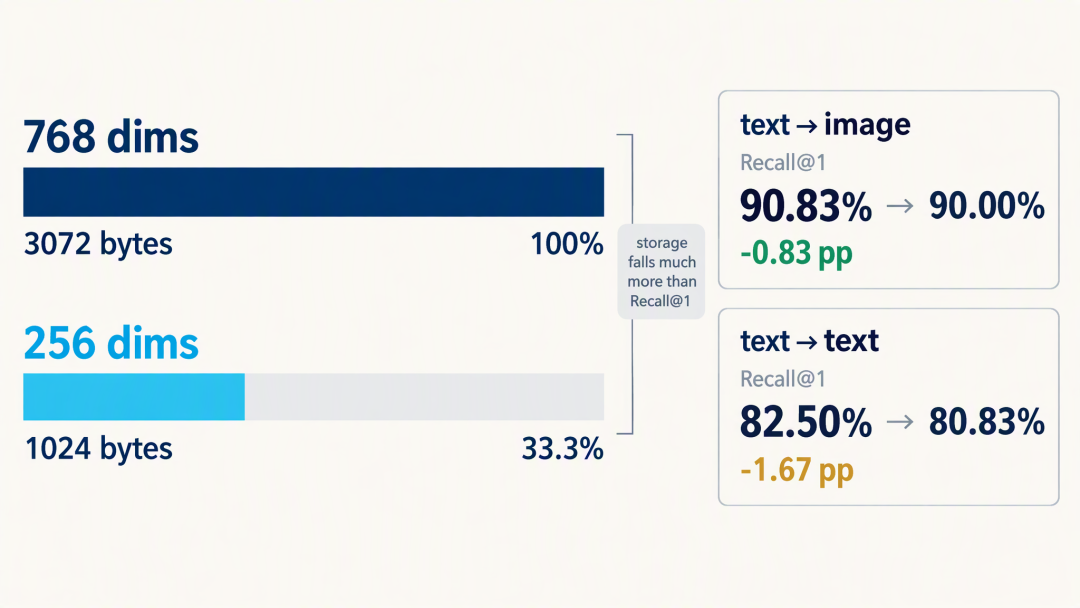
按一百万条向量计算,原始向量数据大约从 3.072GB 降到 1.024GB(这个数字不包含 Milvus 索引、标量字段、副本和其他运行开销),而这组数据上的 Recall@1 下降不到 2 个百分点。
从官方数据看,EG2 的 MMEB v2 总分在 768 维时为 59.01,256 维时为 56.24,下降 2.77 分。更低的 128 维则降至 45.65。
因此,实际落地中,256 维是一个值得关注的折中配置。
写在最后
如果只做文本检索,纯文本模型会更直接;如果只追求图文排序的最高分,Qwen-VL 在本轮测试中更高。EG2 更适合需要本地运行、同时处理多种模态,或者对向量存储容量敏感的场景。
尤其值得一提的是,256 维配置在存储开销大幅下降的同时,检索质量损失非常有限。对于中小规模的多模态素材库来说,这个配置的性价比相当高。如果你也正在做多模态检索或向量维度的选型实验,欢迎来云栈社区分享你的实测数据和踩坑经验。
 发表于 1 小时前
|
查看: 6|
回复: 0


