数据库的“用户画像”,正在被大模型改写。
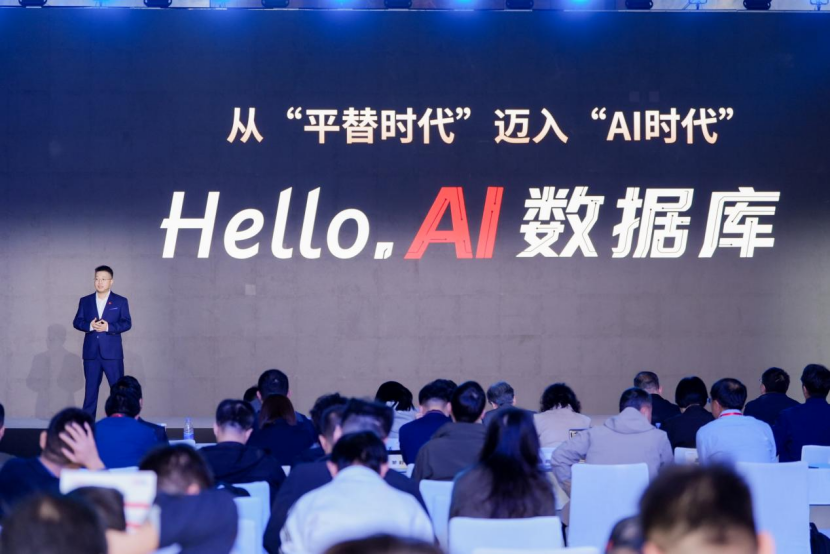
过去几十年,数据库的设计一直围绕人的使用而构建。但在 10 月 30 日电科金仓“Hello,AI 数据库”发布会上,电科金仓总裁杜胜谈及行业变化:面对 Agent(智能体)这个新用户,数据库的设计不能只满足“For Human(服务于人)”,还需要进化到“For AI(服务于人工智能)”。
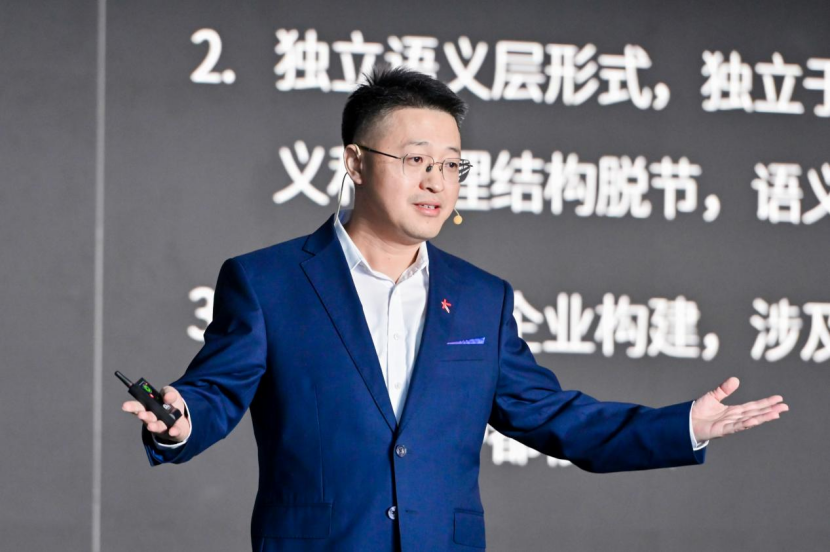
电科金仓总裁杜胜
如何理解这种转变?杜胜用了一个形象的比喻:大模型是“慢思考”,负责开放式理解和推理,善理解、能归纳、可创造;数据库是“快思考”,提供确定性的计算与检索,更高效、更精确、更低成本。数据库沉淀的准确业务数据,是大模型高质量推理的燃料,它们共同协作,基于业务场景完成任务与价值交付。
为了迎接这种底层逻辑的转变,电科金仓正式发布 KES AI 数据库。不同于行业传统的“把数据搬出库外、做库外语义构建”的思路,电科金仓选择了一条更难但更彻底的路径——将语义理解、多模检索与模型推理直接“长”在数据库内核里。这种“库内生长”的架构,正是为了源源不断地为大模型提供高质量、安全的燃料。
跨越“语义鸿沟”:语义构建从“自上而下”到“自下而上”
大模型在企业落地遇到的第一道坎,不是不会推理,而是“看不懂”数据。
正如 Gartner 最新研判指出的:“上下文正在成为新的关键基础设施。”据行业机构统计,全球 90% 以上的数据位于私域,其中 68% 从未被分析利用。以字段“客户”为例,它可能指代最终用户,也可能指代签约法人,机器无法自行判别。没有业务语义的支撑,大模型算出来的数值再对,也没人敢拿去直接用。
传统架构下,业务语义分散在应用界面、代码和业务人员的脑子里。但大模型不需要界面,它需要一张精准的“数据地图”。正如中国数据库学科带头人、中国人民大学教授王珊所言:“AI 时代,数据库既要保证数据存得准、算得对,也要为大模型理解业务提供依据。”
行业内已有残酷的预测:到 2028 年,60% 仅依赖外部 MCP(模型上下文)协议的智能体分析项目会因缺乏一致的语义层而失败;到 2030 年,超 10% 的企业将成为 AI-first 企业,凭智能体、语义与融合平台建立优势。
过去,企业构建语义层习惯于“自上而下”强推,往往力不从心。杜胜指出,外挂语义层最大的痛点是与底层物理结构脱节,“底层物理结构一旦变化,同步链路容易断裂,维护成本极高”。
电科金仓的解法是将语义构建的逻辑翻转为“自下而上”。通过在数据库内核中构建原生语义层,让每个底层业务库先具备“自解释”的能力,保证本地语义“新鲜可用”;再借助大模型汇聚成部门级语义。“数据库不能消除组织分工的割裂,先把每一个基础单元做好,企业级的效果水到渠成。”杜胜表示,这种自下而上的模式,正是大模型精准调用数据、释放企业数据价值的基石。
算力与多模的平衡:绝不让 AI 负载“搞崩”核心业务
过去,企业数据大多以二维表存在,而大模型更青睐向量(相似度检索)和图(关系推理)。靠传统关系表承载复杂关联,多层关系推理很慢;还有很多非结构化原始资料无法直接给大模型调用。在库内完成向量化和图化是迎合这一趋势的最优解,但这必然带来一个现实拷问:AI 带来的海量计算,会不会抢占核心交易系统的资源?
“一个核心原则是:不会为了做 AI,把业务搞崩或搞停。AI 是能力的增强,不是替代。”杜胜的回答异常坚定。
为了支撑库内计算,电科金仓在架构上采用了隔离部署模式。交易节点专注原有高频读写,向量与图推理等 AI 负载放在独立分析节点,通过日志异步同步,实现算力隔离。这种架构既保证了核心业务的绝对稳定,又将多模检索的性能推向了极致。依托这套隔离架构,电科金仓集成 ONNX 推理框架,直接把推理能力做进库内,完成向量化与多模态检索。
同时对于向量引擎,ANN(近似近邻计算)是一个核心指标。电科金仓通过自研基于磁盘的近似最近邻搜索索引算法 DiskANN,打破了传统向量索引(如 HNSW)对内存的极高依赖,在保证同等召回率条件下,实现更低成本、更低延迟、更高吞吐的大规模向量检索。公布的基准测试显示:在 1 亿条向量、98% 召回率的条件下,产品峰值内存占用较业界降低了 95.4%;查询延迟降低 80%,QPS 提升了 5 倍。这种“All-in-one”的多模融合,正在彻底终结“数据满天飞”的跨库搬运时代。
筑起“物理围栏”:让 AI 在安全边界内运行
如果说过往的 AI 项目多停留在“试点”阶段,那么合规与安全就是阻碍其进入核心生产环境的最后一道屏障。
企业接入大模型通常走“抽取数据—向量库或 RAG 框架—大模型”的链路。数据一旦出库,原有的行级、列级权限与字段级脱敏、审计策略即告中断。更隐蔽的致命伤在于“权限残留”:向量化与图谱构建产生的数据派生副本,虽带有源数据的敏感性,却不再继承原权限标签。员工调岗或权限回收时,散落在外的副本往往成了盲区。
“靠提示词约束大模型越权,就像管教孩子口头说教;数据库底层细粒度权限,才是实实在在的物理围栏。”杜胜的比喻一针见血。KES AI 数据库最大的底气在于“数据零搬移”,它利用数据库既有的身份认证、数据标签、SQL 防火墙等原生机制,对库内语义查询、向量检索实施统一管控。Agent 访问数据时,权限可精准穿透至具体使用者;同时,所有规则在数据库侧实现“一处修改、全域生效”。全流程库内留痕,彻底满足等保三级及行业监管要求。
战略定力:金仓的底色依然是“数据库厂商”
在 AI 热潮下,不少基础软件厂商都在努力向“AI 基础设施厂商”转型。面对纷繁的行业选择,电科金仓锚定主业、清晰取舍:“AI 化是下一代数据库的必答题,但金仓仍然是一家数据库产品厂商,而不是 AI 基础设施厂商。我们要做的是帮助千行百业在驶向未来的过程中,平滑过渡。”
这种定力也传递给了客户。本次升级属于能力扩展,原有业务数据不迁移,不绑定特定大模型,不因 AI 功能大幅涨价。对于已经采购独立向量库的客户,电科金仓提供成熟的迁移工具,支持平滑过渡与共存。
从“For Human”到“For AI”,从被动存储到主动为业务提供“燃料”,电科金仓 KES AI 数据库提供了一条兼具高性能与高安全的落地路径。在狂热的 AI 浪潮中,只有那些既能看懂大模型短板,又能耐住性子打磨底层内核的玩家,才能最终留在企业级市场的牌桌上。这也是云栈社区持续关注数据库与 AI 融合的方向。
 发表于 前天 21:28
|
查看: 16|
回复: 0
 /1


