一句话就能拿到答案,为什么还要打开 Dashboard?过去两年,AI 做数据分析的叙事一直很顺,于是有人判断 Tableau、Power BI 迟早会被 ChatGPT 式交互替代。
OpenAI 9 月 10 日发布的 Data agent 给出了相反答案。它把 ChatGPT 变成新的分析入口,却不绕开企业数据栈:连接 Snowflake、BigQuery、Databricks 等数据源,读取 Drive、SharePoint;借 dbt、GitHub、Snowflake Horizon 和 BI Dashboard 的上下文理解业务;分析后还能在 Power BI、Tableau、ThoughtSpot 等工具中创建或操作 Dashboard。它未必替代 BI,更像是企业数据栈之上的新入口。
本文主要围绕以下几个问题展开:
- OpenAI 没再做一个 SQL Agent,而是把分析链路收进 ChatGPT
- 模型会写 SQL,但它不知道你公司的 Revenue 是什么
- ChatGPT 抢走 Dashboard 入口,语义层反而被推到前面
- Snowflake、Databricks 已经开始争夺同一个 Context Layer
如果 OpenAI 只是想做一个更强的 NL2SQL,这套架构没必要。模型完全可以读 Schema、生成 SQL、执行查询、画图。但 OpenAI 做了两件事:一边把 ChatGPT 放到 Snowflake、Databricks、Power BI、Tableau 之上,收拢过去分散的分析入口;一边消费这些系统多年积累的指标定义、数据关系、权限和业务语义。
AI 会压缩 BI 作为操作界面的价值,但不会让 BI 背后的 Semantic Model 消失。自然语言入口越重要,模型越需要有人提前告诉它:Revenue 怎么算、哪张表可信、Customer 和 Order 怎么关联、哪些数据谁能看。这些过去藏在 BI、Semantic Layer、Metric Layer 和治理系统里,现在正变成 Data Agent 进入复杂企业环境的重要前提。
所以,「BI 反而成了必选项」的意思不是每家公司都要买 Tableau 或 Power BI。更准确地说:受治理的 Business Context,正在从辅助人分析数据的资产,变成生产级 Data Agent 的基础设施。
01 OpenAI 没再做一个 SQL Agent,而是把分析链路收进 ChatGPT
把 Data agent 理解成「ChatGPT 终于能查数据库」,低估了它。
按 OpenAI 官方描述,用户可以直接问「为什么销售额下降」「哪里成本突然增加」「哪些问题影响最大客户续约」。Data agent 会连接授权数据源调查,允许继续追问,展示结论背后的证据,再生成交互式 Dashboard。管理员控制哪些连接和角色可用,实际查询继承连接账户已有的 Table、Row、Column 级权限。分析结束后,它可以通过 Slack、Email 分享结果,或执行用户批准的后续操作。
过去一次企业分析横跨多个工具:业务人员先看 Dashboard,找不到答案再找分析师;分析师去 Snowflake 或 Databricks 找表、写 SQL、验证口径,再回 BI 更新图表,最后用 Slack 或邮件解释结论。OpenAI 想把这条链路压成一个 Agent Loop:理解问题、发现数据、生成并运行 Query、检查结果、继续调查、生成可视化,再送进下一个业务动作。它要重构的不是 SQL 编辑器,而是用户与企业数据栈的交互方式。
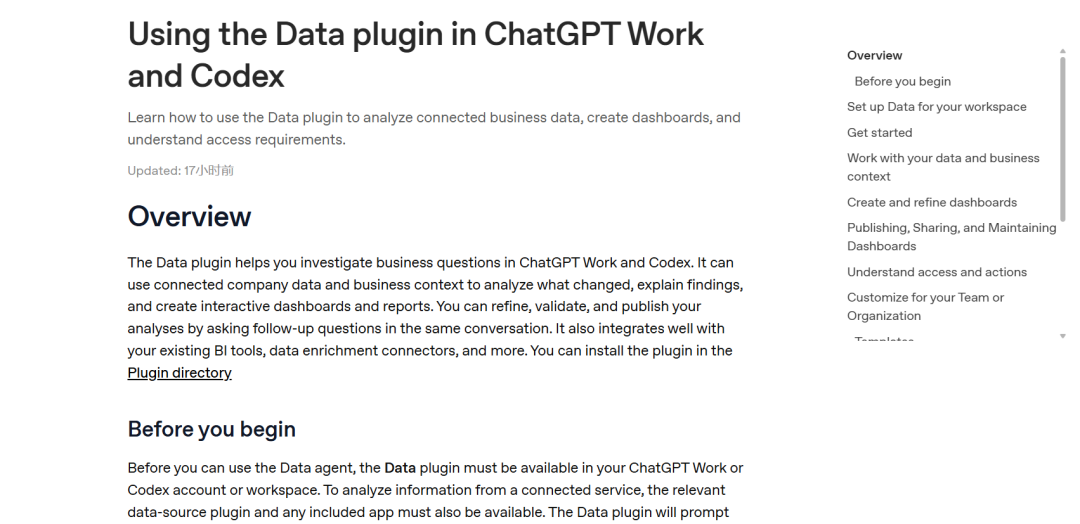
这也不是演示产品。OpenAI 称,几乎所有产品团队和超过三分之二的 GTM 组织,已经在 ChatGPT Work 中使用 data agents 分析公司数据。Alpha 客户中,micro1 的运营团队用自然语言在半小时内重建 Performance Tracking Dashboard,同时发现原 Dashboard 的错误;ServiceTitan 用 Data agent 构建 Dashboard,发现使用 Atlas AI Sidekick 的客户发起 Campaign 的比例约为非用户的三倍。
那问题来了:模型已经能写 SQL、画 Dashboard,OpenAI 为什么还要读 BI Dashboard、Semantic Layer 和 Ontology?因为企业数据分析最难的,本来就不只是 SQL。
02 模型会写 SQL,但它不知道你公司的 Revenue 是什么
OpenAI 内部 Data Agent 是个好例子。今年 1 月公布的架构里,它面对超过 600PB 数据、7 万个 Dataset,服务 3500 多名内部用户。很多表非常相似:有些包含未登录用户,有些不包含;字段大量重叠。分析师光判断该用哪张表,就要花不少时间。找对表后,many-to-many join、错误的 Filter Pushdown、Null 处理不当,也可能让结果悄悄出错。OpenAI 展示过一条真实 SQL,超过 180 行。
他们最后没有让模型单纯多学 SQL,而是围绕 Agent 建了六层 Context。Table Usage 提供 Schema、Lineage 和历史 Query;Human Annotations 由领域专家补充表和字段的业务含义;Codex Enrichment 直接读生成数据的代码和 Pipeline,判断一张表包含什么、怎么产生、多久刷新;Institutional Knowledge 从 Slack、Google Docs、Notion 中读取产品发布、事故、内部术语和指标定义;Memory 保存用户纠正过的 Filter、规则和约束;静态信息缺失或过期时,Runtime Context 会实时查询 Warehouse、Metadata Service、Airflow、Spark 重新验证。
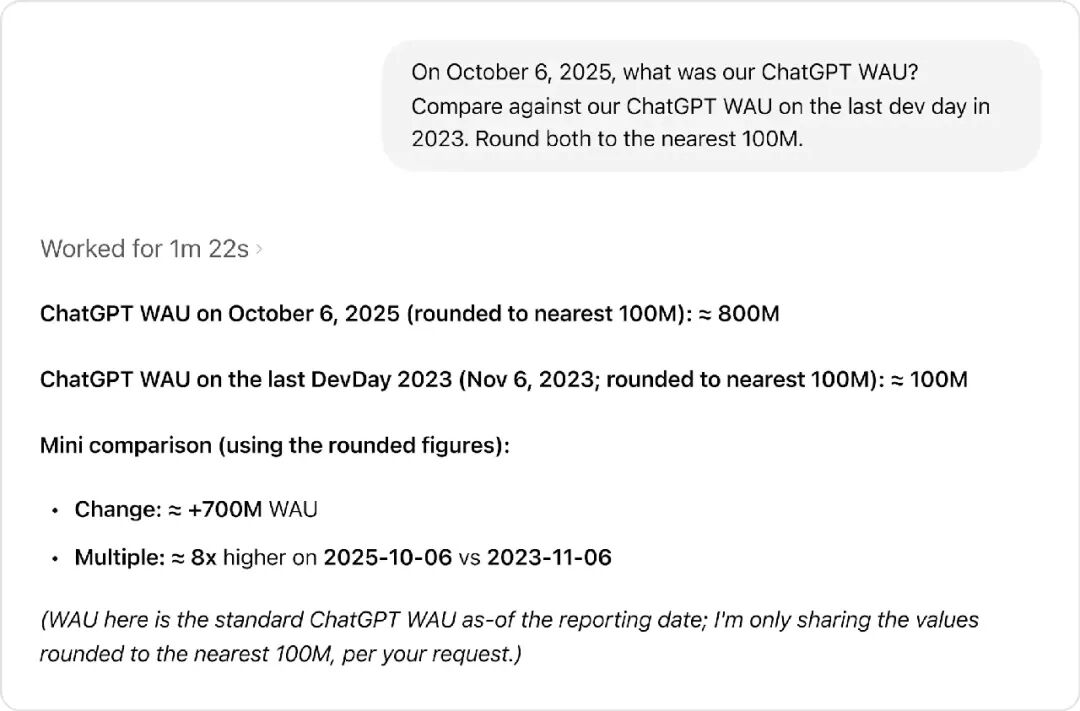
这些 Context 不是每次提问全塞给模型。OpenAI 每天跑离线 Pipeline,把 Table Usage、Human Annotations 和 Codex 从代码中抽取的知识整理成统一表示,再通过 Embeddings API 建立检索索引。问题到来时,Agent 用 RAG 召回最相关的 Context;信息不够或过期,再发实时查询。在几万张表的环境里,业务上下文本身已经是一套需要采集、标准化、Embedding、Retrieval 和实时校验的数据基础设施。
OpenAI 总结出的经验是:Meaning Lives in Code。Schema 告诉模型字段叫 revenue,历史 SQL 告诉它别人怎么用过,但决定含义的 Pipeline Logic、刷新机制、过滤规则和业务假设,常常藏在生成数据的代码里。LLM 写出 SUM(revenue) 很容易,判断它是不是公司认可的 Revenue 很难。收入按下单、支付还是财务确认时间算?退款扣不扣?Internal Account 要不要过滤?试用客户算不算?CFO 和销售各有一套数字时,哪个才是正式口径?
这些是 Semantic 问题,不是 SQL Syntax 问题。9 月公开的 Data agent 已经把 Context 放进产品架构:除了原始数据,它还会使用 Business Terms、Metric Definitions、Custom Calculations 和 Data Relationships,来源包括 Genie Ontology、dbt、Snowflake Horizon 和 BI Dashboard。
Data Agent 的技术瓶颈因此变了。过去比 Text-to-SQL Accuracy:用户提问,模型能不能找对表、写出可执行 SQL。现在更难的是:SQL 语法完全正确,模型理解的到底是不是企业真正想问的业务问题?
03 ChatGPT 抢走 Dashboard 入口,语义层反而被推到前面
OpenAI 一边推交互式 Dashboard,一边接 Power BI、Tableau、Sigma、ThoughtSpot,原因就在这里。
如果 BI 只是画图工具,生成式 AI 确实带来直接替代压力。用户以后可能不用打开十几个 Dashboard、调一堆 Filter,再自己找异常。但 BI 难复制的不是柱状图和折线图,而是背后的 Semantic Model:哪些表能连接、Metric 怎么定义、Measure 怎么计算、哪些字段给业务看、企业认可哪个版本的数字。
Microsoft 今年给 Power BI 增加了「Prep data for AI」,包括 AI Data Schema、Verified Answers 和 AI Instructions。AI Data Schema 让模型只看到分析相关字段,减少复杂 Schema 带来的歧义;Verified Answers 保存人工确认的问题和可视化结果;AI Instructions 允许数据团队写入业务术语和分析规则。Microsoft 也提醒,如果没有准备好 Data、Semantic Model 和用户环境,Copilot 可能给出低质量、不准确甚至误导性的答案。
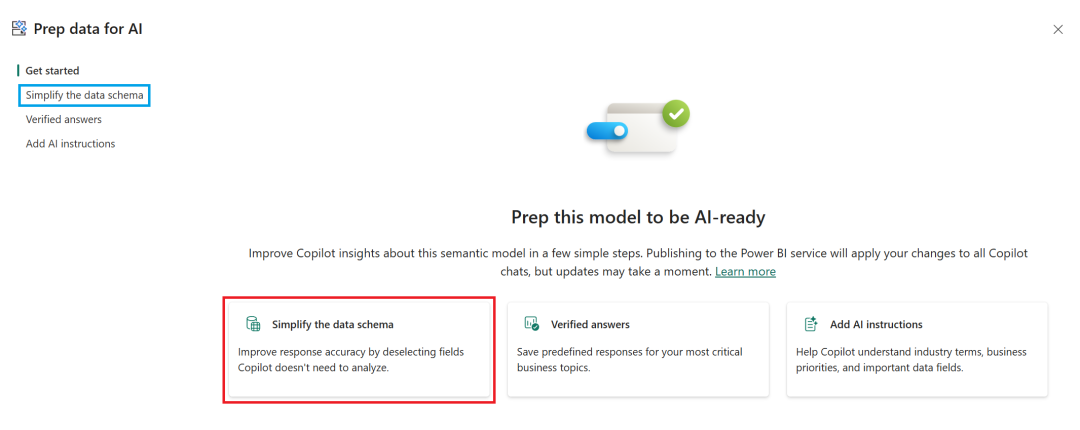
Semantic Model 的角色因此变了。以前它保证不同 Dashboard 对 Revenue、ARR、Conversion Rate 使用同一口径;现在还要保证不同 AI Agent 对这些指标形成同一种理解。过去数据建模做得好不好,影响报表质量;未来它还会直接影响 Agent 回答是否可信。
Tableau 更直接。今年推出的 MCP 集成把 Trusted Insights 和 Curated Semantic Models 带进 ChatGPT、Codex、Claude。Tableau 的说法是,把常用 AI Agent 变成进入 Tableau Data Estate 的「front door」。
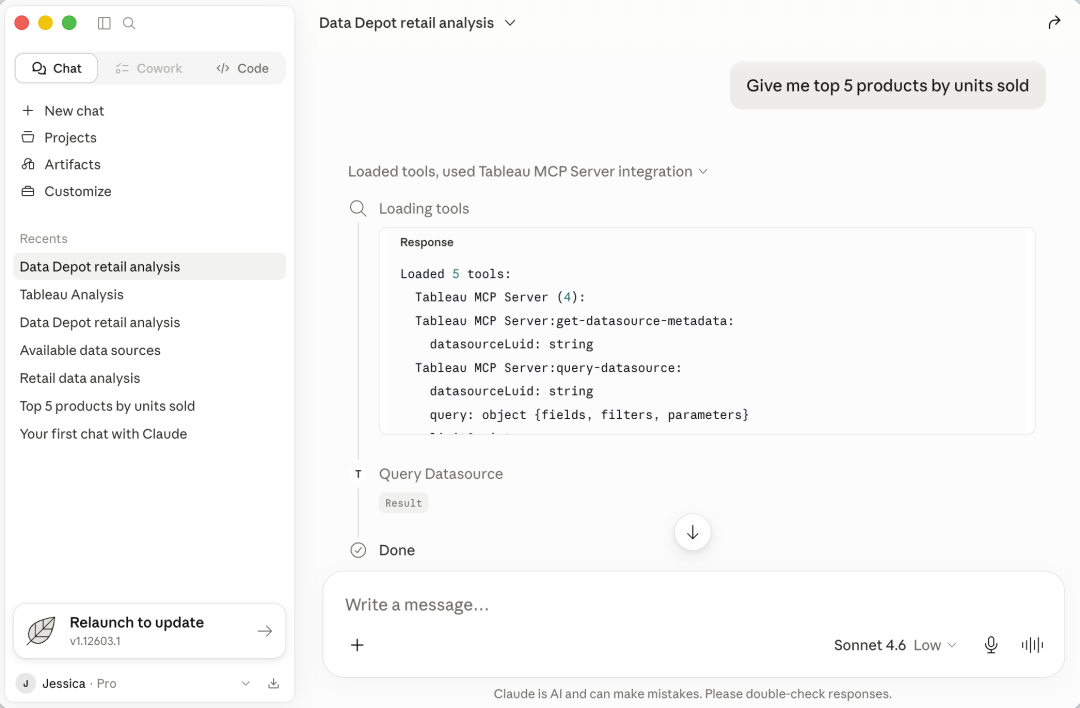
所以,与其说 AI 保住了 BI,不如说它压缩了 BI 的交互层,同时放大了背后的语义和治理资产。用户可能越来越少亲自打开 Dashboard,但当他问 ChatGPT「为什么美国西部续费率连续两周下降」,Agent 仍然要知道「续费率」是哪个正式 Measure、Region 怎么划分、Trial Account 是否过滤、哪个 Dataset 被认证、这个用户有没有权限看对应数据。
Dashboard 会越来越容易生成,Metric Definition、Semantic Model、Lineage、Permission 和 Certified Data 不会消失。
04 Snowflake、Databricks 已经开始争夺同一个 Context Layer
这不只是 OpenAI 的选择。Databricks、Snowflake、Microsoft、Tableau 最近都在回答同一个问题:Agent 要理解企业,谁提供可信的 Business Context?
Databricks 的 Genie Ontology 把自己定位为 Genie 系列 AI Experience 的统一 Context Layer。知识分两类:Unity Catalog Semantics 是企业主动定义、治理和认证的 Metric Views、Domains、Pages;Inferred Context 从已有 Metric Views、Dashboard、SQL Query 和 Genie Agent 中自动提取 Metric Definition、Business Rule 和 Authoritative Source。每条自动抽取的 snippet 都有 authority score,根据来源、使用频率、新鲜度判断可信度;Context 冲突时,Genie 会先排序并解决冲突,同时只使用当前用户有权限访问的来源。
这解决的是 Context 规模化后的新问题:财务 Dashboard、销售 SQL、半年前的 Notebook 给出不同 Revenue 定义时,Agent 信谁?过去数据治理解决「人看哪个数字」,现在还要解决「模型信哪条 Context」。
Snowflake 走的是另一条路:把已有 BI 里的语义抽出来。8 月 18 日,Power BI ingestion for Semantic View Autopilot 已经 GA。企业把 .pbit 或 .pbix 交给 Snowflake,系统按原 Data Model 自动创建 Semantic View,保留 Power BI 里定义好的 DAX Measures、Table Relationships 和 Column Descriptions,再提供给 Cortex Analyst。Tableau 也能通过 TWB、TWBX、TDS、TDSX 导入,Snowflake 会解析其中的 Tables、Columns、Relationships、Calculated Fields、Parameters、Filters 和 Custom SQL。
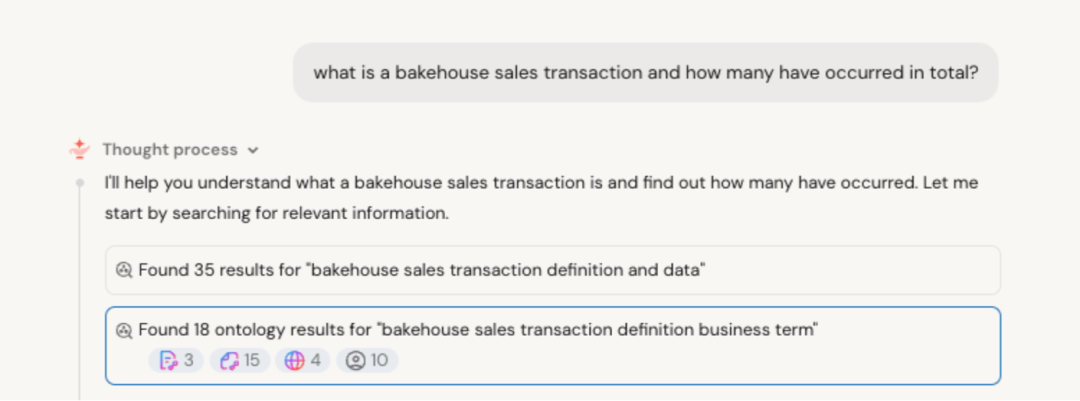
这个动作很有代表性。Snowflake 没有要求企业为了 AI 把多年积累的 Power BI、Tableau 模型推倒重建,而是把 BI 中已有的业务逻辑变成新的 AI Context。BI 过去积累的资产,可以脱离原来的 Dashboard,继续服务 Cortex Analyst、Agent 和更多 AI 应用。
新的数据栈因此出现分层:Warehouse 和 Lakehouse 保存事实数据;Semantic/Ontology Layer 维护指标、关系和业务规则;Agent 负责推理、查询和工具调用;ChatGPT 一类通用 AI 争夺用户最终提问和执行动作的入口。OpenAI 可以不拥有数据仓库,也可以不拥有 BI,但要成为企业数据的统一交互层,就必须理解这些系统里的 Context。
接下来要争的不是谁再做一个更漂亮的 Dashboard,而是企业最核心的 Business Context 由谁管理、由谁消费。
05 下一场 Data Agent 竞争,不再是谁的 SQL 写得最准
评价 Data Agent 的方式也变了。
SQL Generation 仍然重要,但越来越像底层能力。OpenAI 内部 Agent 拿到中间结果后不会立即结束。如果 Query 因为错误 Join 或 Filter 返回 0 行,它会判断问题、调整方法、重新执行。OpenAI 称之为 Closed-loop Process:过去分析师自己做的「查一下、不对、改 SQL、再查」,被转移到 Agent 内部。
生产级 Data Agent 至少比五件事。第一,Context Coverage:能否找到正确的表、Dashboard、代码、指标和文档。第二,Semantic Fidelity:Revenue、ARR、Active User 是否按企业正式口径理解。第三,Governance:用户原有数据权限能否完整传给 Agent。第四,Agent Loop:发现异常后能否重新找数据、修改 Query、自我验证,而不是生成一次 SQL 就结束。第五,Evaluation:模型、Prompt、工具或 Context 更新后,原来答对的问题有没有悄悄变错。
最后一点容易被忽视。OpenAI 内部 Data Agent 建了 Evals:用人工整理的问题和对应 Golden SQL 作参考,让 Agent 重新生成 Query、执行结果,再比较生成 SQL 与最终数据是否符合预期。这些 Eval 像持续运行的单元测试,用来发现升级后的质量回归。
这和 Coding Agent 的演化相似。最早比模型会不会写代码,后来竞争进入 Harness:Context 怎么组织、工具怎么调用、测试怎么反馈、长任务怎么继续。Data Agent 也从 NL2SQL 扩展到 Context + Semantics + Governance + Agent Loop + Evals。
不同在于,Coding Agent 的大量 Context 可以从代码仓库重新读取;企业数据里的 Business Context 很多已经沉淀数年甚至十几年,散落在 dbt、Power BI、Tableau、Snowflake、Databricks、数据字典、Pipeline、文档和分析师习惯里。一个 Revenue 为什么这么算、一张表为什么不能直接 Join、一个客户为什么属于 Enterprise 而不是 SMB,这些规则不会因为模型变强就自动出现。
ChatGPT 越来越像新的 BI 前端,但没有让企业原来的数据基础设施失去价值。相反,当写 SQL、做 Dashboard、生成报告变成 Agent 的标准能力,过去藏在报表背后的 Metric、Semantic Model、Permission、Lineage 和 Business Context,反而被推到数据系统更核心的位置。
过去,BI 最重要的工作之一是帮人理解数据。
现在它多了一项工作:帮 AI 理解企业。
当每个 Agent 都会写 SQL,下一场数据分析战争可能不再是谁的 SQL 写得最准,而是谁能给 AI 一套可信、最新、权限正确,并在整个企业里保持一致的「业务真相层」。
资料来源
- OpenAI|Now everyone can put data to work
- OpenAI|Inside OpenAI’s in-house data agent
- Microsoft Learn|Prepare your data for AI to improve Copilot results
- Databricks Docs|Genie Ontology
- Snowflake Docs|Power BI ingestion for Semantic View Autopilot
- Snowflake Docs|Overview of semantic views
 发表于 11 小时前
|
查看: 1|
回复: 0


