RDF、OWL、SPARQL、SHACL 经常一起出现,但它们解决的问题并不相同。看懂各自的职责,才能看懂一套语义层如何从底层数据走向业务应用。
如果你参与过企业 AI 项目,应该遇到过这样的情况。
模型的能力越来越强,RAG 能够检索企业文档,Agent 也能够调用 CRM、ERP 等业务系统。Demo 演示的时候,一切看起来都很顺利。
可一旦进入真实业务,问题就开始出现了。
销售系统里的客户编号是 C001,ERP 里可能使用另一套编码;业务人员口中的 VIP 客户,不一定对应数据库里的某个固定字段;订单状态虽然都叫“已完成”,不同系统的定义却可能完全不同。
更麻烦的是,Agent 即使查到了正确的数据,也未必知道这些数据之间的业务关系,更不知道某项操作是否符合企业的规则。
这时候,问题已经不只是“大模型够不够聪明”了。企业需要一套能够统一描述业务概念、明确对象关系、表达知识逻辑,并且让机器能够查询和验证的语义体系。
这正是本体(Ontology)和语义层(Semantic Layer)要解决的问题。
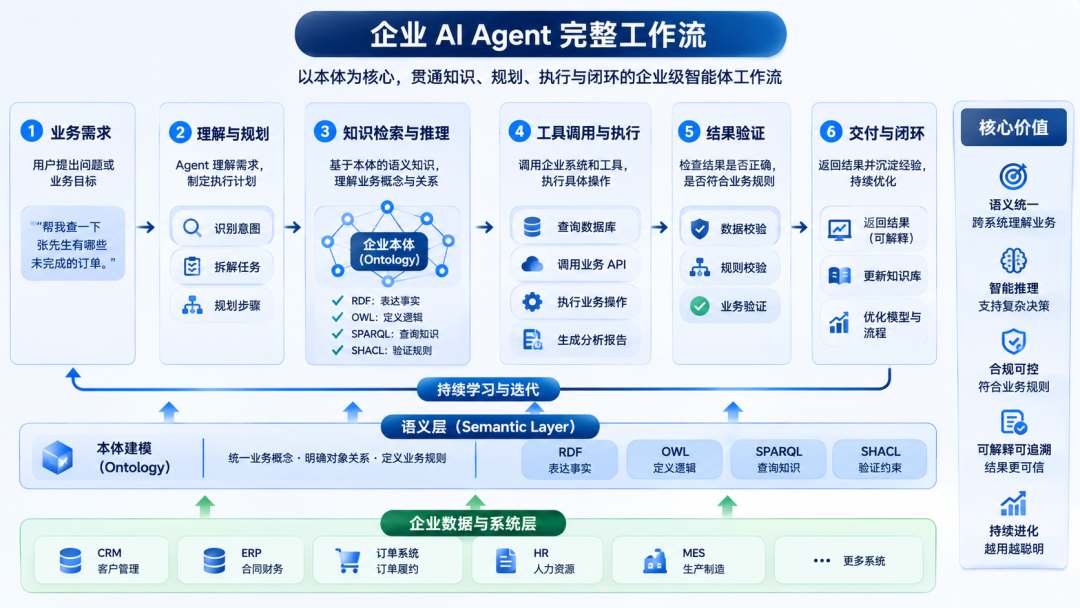
在这套技术体系里,有四项非常值得深入理解的技术:
| 技术 |
解决的问题 |
| RDF |
把业务事实和关系表达出来。 |
| OWL |
定义概念的含义以及它们之间的逻辑关系。 |
| SPARQL |
查询知识图中的对象和关系。 |
| SHACL |
检查数据是否满足预先定义的约束。 |
这四项技术经常一起出现,但各自的职责不同。
如果把它们混为一谈,很容易把语义层做成一个复杂的图数据库项目;如果真正理解各自的职责,就能看懂一套语义层究竟如何从底层数据走向业务应用。
下面用一个贯穿全文的企业客户管理案例,把这四项技术逐一拆开,再重新组合起来。
本文内容概览:
- 企业为什么需要本体
- 四项技术逐一拆解
- 语义层如何协同工作
先别急着学技术:企业为什么需要本体?
假设一家企业有三个业务系统:
- CRM 管理客户;
- ERP 管理合同和财务;
- 订单系统管理订单及履约情况。
在 CRM 中,有一条客户记录:
customer_id = C001
customer_name = 张先生
customer_level = VIP
订单系统中,有一条订单记录:
order_id = O1001
customer_code = C001
order_status = PROCESSING
从数据库的角度看,这些数据并不复杂。但当业务人员问 Agent:
“帮我查一下张先生有哪些未完成的订单。”
系统就必须解决一连串问题:
- 张先生对应哪个客户对象?
- 客户对象与订单对象之间是什么关系?
PROCESSING 在当前系统里究竟代表什么状态?- 如果 CRM 和订单系统使用不同的客户编码,应该如何关联?
- 查询结果能否追溯到真实的数据来源?
如果 Agent 每次都直接拼接 SQL、猜测字段含义,再调用不同的 API,这些逻辑很快就会散落在提示词、工具描述和业务代码中。模型换了,工具换了,业务规则调整了,原来的实现就可能需要重新修改。
问题的根源,是企业缺少一套被各个系统共同理解的业务语义。
我们需要明确:
- Customer 是什么;
- Order 是什么;
- Customer 与 Order 之间是什么关系;
- VIPCustomer 与普通 Customer 有什么区别;
- 不同系统中的客户记录如何对应同一个业务对象;
- 什么样的数据才符合企业约定的标准。
这就是本体建模的出发点。
本体并不是把数据库表重新命名一遍,而是围绕某个业务领域,对概念、对象、属性、关系和逻辑进行形式化描述。
语义层则进一步把这些定义与实际数据、查询服务及业务应用连接起来。理解这一点之后,再来看 RDF、OWL、SPARQL 和 SHACL,就容易得多了。
RDF:把企业数据变成一张有明确含义的关系图
1. RDF 到底是什么?
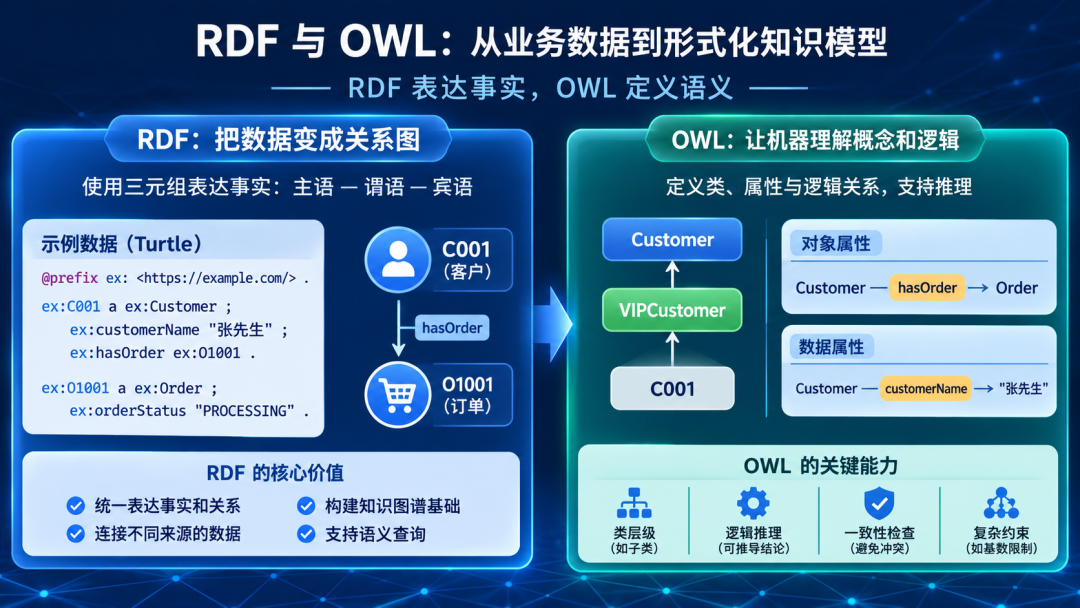
RDF 的全称是 Resource Description Framework,中文通常称为资源描述框架。它是 W3C 制定的一种用于表达资源及其关系的数据模型。
RDF 最核心的结构只有三个部分:
主语 Subject
    ↓
谓语 Predicate
    ↓
宾语 Object
也就是常说的三元组。例如:
- 张先生 —— 是一个 —— 客户
- 张先生 —— 拥有 —— 订单 O1001
- 订单 O1001 —— 状态为 —— 处理中
每一条语句都在描述一个明确的事实。把多条三元组连接起来,就形成了一张 RDF 图。
W3C 的 RDF 规范正是以这种主语、谓语、宾语组成的三元组作为基本表达结构。官方资料: https://www.w3.org/TR/rdf11-concepts/
2. 用 Turtle 表达一个真实的业务案例
RDF 可以采用不同的序列化格式表示。Turtle 比较适合阅读和手工编写。下面用它描述客户与订单。
@prefix ex: <https://example.com/> .
@prefix rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#> .

ex:C001 a ex:Customer ;
    ex:customerName "张先生" ;
    ex:customerLevel "VIP" ;
    ex:hasOrder ex:O1001 .

ex:O1001 a ex:Order ;
    ex:orderStatus "PROCESSING" .
如果你第一次接触 Turtle,可以先理解几个关键符号。
@prefix 用来声明前缀,避免反复书写完整的 IRI。例如 ex:C001 对应的完整标识符是 https://example.com/C001,它表示一个具体的业务资源。
a 是 rdf:type 的简写,用来声明某个资源属于什么类型:
ex:C001 a ex:Customer .
意思是:C001 是一个 Customer。接下来:
ex:C001 ex:customerName "张先生" .
表达客户名称。而:
ex:C001 ex:hasOrder ex:O1001 .
表达客户与订单之间的关系。注意,这里有一个非常重要的区别:
客户名称是一个字符串值,而订单是另一个具有独立标识符的资源。
这意味着,订单不只是客户记录里的一个文本字段,它还可以拥有自己的属性、状态以及与其他对象的关系。这正是 RDF 在复杂关系建模中很有价值的地方。
3. RDF 与关系型数据库有什么区别?
有人可能会问:这些信息放进 MySQL,用三张表不也能表示吗?当然可以。
RDF 并不是为了证明关系型数据库无法表达这些数据。事实上,对于很多交易型业务,关系型数据库仍然是更合适的选择。真正的区别在于数据模型和语义表达方式。
关系型数据库通常使用表、行、列和外键组织数据;RDF 则将信息组织为带有明确标识符的资源,以及资源之间的有向关系。
比如,关系型数据库可能通过以下方式关联客户与订单:
SELECT
    c.customer_name,
    o.order_id,
    o.order_status
FROM customers c
JOIN orders o
    ON c.customer_id = o.customer_code
WHERE c.customer_id = 'C001';
这段 SQL 没有任何问题。但当企业需要整合多个系统、统一业务概念,并让不同应用围绕这些概念开展查询时,就需要额外解决字段映射、实体对齐和关系定义等问题。RDF 为这些业务事实提供了一种统一的图式表达方式。
踩坑提示: RDF 不会自动解决客户编码不一致的问题。如果 CRM 中的 C001 和 ERP 中的 A-9001 指向同一个客户,仍然需要通过主数据、映射规则或实体解析机制建立可靠的关联。RDF 解决的是如何统一表达事实和关系,而不是自动完成企业数据治理。
4. RDF 在语义层中扮演什么角色?
可以把 RDF 理解成语义层的基础知识表达模型。它负责把企业里的各种信息组织起来:
Customer
  ├── customerName
  ├── customerLevel
  └── hasOrder
        ↓
      Order
        ├── orderStatus
        └── containsProduct
              ↓
            Product
当这些关系被统一表达后,上层应用就可以围绕 Customer、Order、Product 等业务对象进行查询,而不必每次都从头理解底层表结构。
但 RDF 还有一个局限:它可以告诉我们哪些事实存在,却不会仅凭这些事实,自动知道所有概念的逻辑关系。
例如,VIPCustomer 是否属于 Customer?某两个类是否等价?某种关系能否从其他关系推导出来?这些问题,就轮到 OWL 出场了。
OWL:让机器理解概念之间的逻辑关系
1. RDF 解决了表达问题,但还缺少什么?
继续使用客户管理的例子。我们已经定义 C001 是 VIPCustomer,也定义了 VIPCustomer 是一种 Customer。那么,能否得出 C001 是 Customer?
从业务人员的角度看,这个结论非常自然。但机器能否推导出来,取决于系统有没有明确表达相关的逻辑关系,以及有没有采用相应的推理机制。
如果只把 VIPCustomer 当作一个普通字符串,系统并不知道它与 Customer 存在什么关系。我们需要进一步告诉机器:VIPCustomer 是 Customer 的子类。这就是本体语言 OWL 的价值所在。
2. OWL 是什么?
OWL 的全称是 Web Ontology Language,即 Web 本体语言。OWL 2 是一种具有形式化语义的本体描述语言,可以用来定义概念、属性、个体以及它们之间的逻辑关系。
W3C 官方入门资料: https://www.w3.org/TR/owl2-primer/
OWL 中有几个关键概念:
- Class(类):用于描述一类对象,例如
Customer、VIPCustomer、Order、Product。
- Individual(个体):用于表示具体对象,例如
C001、O1001、P10001。
- Property(属性):用于表达对象之间的关系,或者对象与数据值之间的关系,例如
Customer —— hasOrder —— Order、Customer —— customerName —— 字符串。在 OWL 中,属性还可以进一步区分为对象属性和数据属性等类型。
- Axiom(公理):用于表达本体中的正式逻辑声明,例如 VIPCustomer 是 Customer 的子类,或者 Customer 与 Order 是不同领域的概念。
这些声明并不是简单的文本注释,而是可以参与形式化语义解释与推理的知识。
3. 用 Turtle 定义一个简单的 OWL 本体
继续扩展前面的例子:
@prefix ex: <https://example.com/> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:Customer a owl:Class .

ex:VIPCustomer a owl:Class ;
    rdfs:subClassOf ex:Customer .

ex:Order a owl:Class .

ex:hasOrder a owl:ObjectProperty ;
    rdfs:domain ex:Customer ;
    rdfs:range ex:Order .

ex:C001 a ex:VIPCustomer .
这段代码做了几件事:
- 声明 Customer、VIPCustomer 和 Order 都是类;
- 声明 VIPCustomer 是 Customer 的子类;
- 定义 hasOrder 是一个对象属性,并声明它的 domain 为 Customer、range 为 Order;
- 声明 C001 属于 VIPCustomer。
在适用的 OWL 语义和推理配置下,系统可以推导出:
- C001 是 VIPCustomer;
- C001 是 Customer(因为 VIPCustomer 是 Customer 的子类)。
这就是本体推理的一个简单例子。
踩坑提示: OWL 中的 domain 和 range 是逻辑声明,不等同于数据库字段的类型校验。例如,某个资源被声明为 hasOrder 的主语,可能导致推理系统推导它属于 Customer,而不是简单地因为它不是 Customer 就直接报错。这个区别在实际建模时非常重要。
4. OWL 不只是描述继承关系
OWL 的能力远不止类层级。它还可以描述:
- 类之间的等价关系;
- 属性的定义域和值域;
- 对象属性之间的逆关系;
- 属性的传递性、对称性等特征;
- 类的交集、并集和补集;
- 个体之间的相同或不同关系;
- 某些约束对象数量的逻辑条件。
例如,企业可以将 VIPCustomer 定义为 Customer 的一个子类,也可以通过形式化条件描述某类客户的业务特征。不过,建模越复杂,推理的计算成本和维护难度也可能越高。
OWL 2 还提供了不同的语言配置,例如 OWL 2 EL、OWL 2 QL 和 OWL 2 RL,以适应不同的表达能力与计算需求。企业建模时,不能只追求表达能力,还要考虑数据规模、推理性能和实际工具支持。
5. 为什么不能把所有业务规则都写进 OWL?
这是一个容易踩坑的地方。假设企业规定:VIP 客户必须满足特定消费条件,并且在某些情况下需要经过审批才能升级。
其中有些条件可以通过形式化知识模型表达,但实际业务通常还涉及实时数据、时间窗口、审批权限、操作顺序和事务执行。这些内容不适合全部依靠 OWL 解决。
OWL 的主要职责是描述形式化语义,并支持相应的逻辑推理与一致性分析。它不是通用的业务规则引擎,也不是工作流引擎。
例如“VIPCustomer 是 Customer 的子类”,这是本体语义;而“只有满足消费条件、具有操作权限并通过审批,才能将客户等级修改为 VIP”,则属于业务规则和执行控制问题。
两者相关,但不能混为一谈。OWL 让机器理解概念之间的逻辑关系,却不意味着机器已经获得执行业务操作的权限。
理解这一点之后,我们就可以进入下一步:既然已经建立了知识图,如何从中准确查询业务信息?
SPARQL:让应用能够查询图中的知识
1. 有了 RDF 和 OWL,如何找到需要的信息?
现在,企业已经有了 Customer、VIPCustomer、Order 等概念,也通过 RDF 保存了具体客户与订单之间的关系。接下来,业务人员提出一个问题:“查一下张先生有哪些订单。”系统要如何完成查询?
如果使用关系型数据库,可以编写 SQL;如果查询对象是 RDF 图,则可以使用 SPARQL。
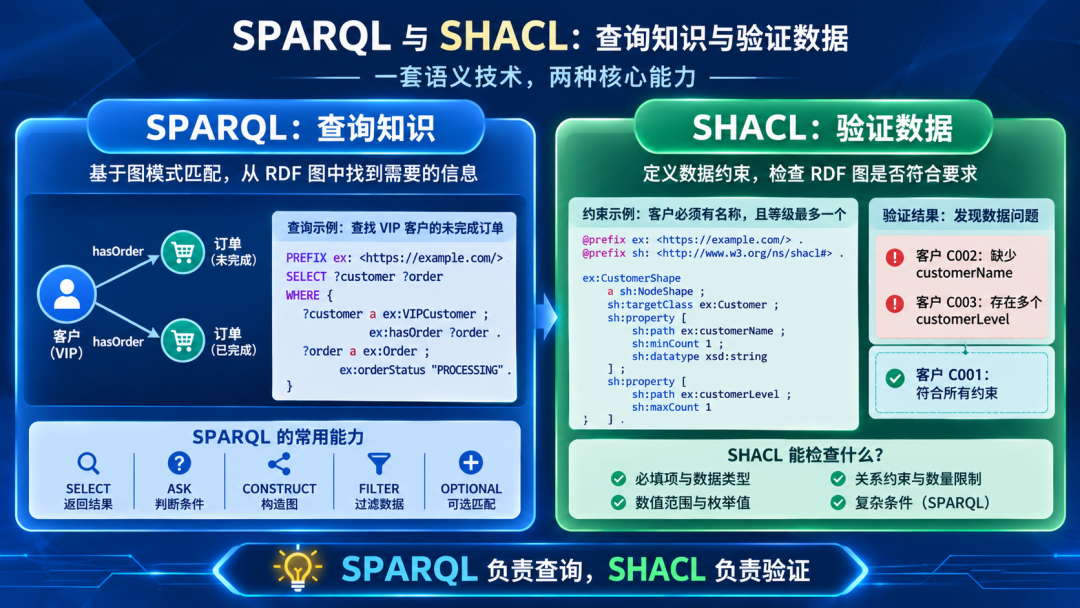
SPARQL 是 W3C 制定的 RDF 查询语言。它以图模式匹配为基础,支持查询必需关系、可选关系以及多种组合条件。
官方规范: https://www.w3.org/TR/sparql11-query/
2. 第一个例子:查询客户的订单
假设 RDF 图中包含前面定义的客户和订单数据:
@prefix ex: <https://example.com/> .

ex:C001 a ex:Customer ;
    ex:customerName "张先生" ;
    ex:hasOrder ex:O1001 .

ex:O1001 a ex:Order ;
    ex:orderStatus "PROCESSING" .
我们想查找张先生对应的订单,可以这样写:
PREFIX ex: <https://example.com/>

SELECT ?order
WHERE {
    ?customer a ex:Customer ;
              ex:customerName "张先生" ;
              ex:hasOrder ?order .
}
这段查询并不是按照固定的数据库表结构去执行 JOIN,而是在 RDF 图中寻找满足条件的图模式。逐行解释一下:
PREFIX 声明命名空间前缀;SELECT ?order 表示返回名为 order 的变量;WHERE 后面的内容描述需要匹配的图结构。
它要求找到一个资源,同时满足三个条件:它属于 Customer;它的客户名称是张先生;它通过 hasOrder 关系连接到某个订单。如果数据中只有一个符合条件的订单,查询结果就是:
order
------------------------
https://example.com/O1001
这里的变量 ?customer 和 ?order 不需要提前定义,它们由查询过程根据匹配到的图结构进行绑定。
3. 第二个例子:查询 VIP 客户的未完成订单
实际业务不会总是只查询一条关系。更常见的需求是:“查找所有 VIP 客户及其未完成订单。”对应的查询可以写成:
PREFIX ex: <https://example.com/>

SELECT ?customer ?name ?order
WHERE {
    ?customer a ex:VIPCustomer ;
              ex:customerName ?name ;
              ex:hasOrder ?order .

    ?order a ex:Order ;
           ex:orderStatus "PROCESSING" .
}
这段查询同时匹配 Customer、Order 以及它们之间的关联。
踩坑提示: 这里有一个前提:数据图中已经明确记录了客户属于 VIPCustomer,或者查询引擎在相应推理配置下能够使用相关推导结果。不能假定所有 SPARQL 引擎都会自动执行 OWL 推理。
如果系统只有 Customer 类型,而 VIP 身份保存在 customerLevel 属性里,查询条件也应当相应调整。例如:
PREFIX ex: <https://example.com/>

SELECT ?customer ?name ?order
WHERE {
    ?customer a ex:Customer ;
              ex:customerName ?name ;
              ex:customerLevel "VIP" ;
              ex:hasOrder ?order .

    ?order ex:orderStatus "PROCESSING" .
}
两种写法都可能合理,关键在于企业如何设计自己的语义模型。
4. SPARQL 不只有 SELECT
SPARQL 1.1 中还有几种很实用的查询形式:
SELECT:返回查询变量,适用于查询客户、订单、属性等信息;ASK:判断某个条件是否成立,返回的是布尔结果;CONSTRUCT:根据匹配结果构造新的 RDF 图,适合从已有知识中提取并组织新的关系图;FILTER:对匹配结果进行进一步过滤,例如对数字、日期或字符串进行条件判断。
例如,判断 C001 是否存在未完成订单:
PREFIX ex: <https://example.com/>

ASK {
    ex:C001 ex:hasOrder ?order .
    ?order ex:orderStatus "PROCESSING" .
}
此外,SPARQL 还支持 OPTIONAL、聚合、子查询和属性路径等能力。对于企业应用而言,这些能力可以用于复杂关系查询、知识提取和跨数据源信息整合。
5. SPARQL 和 SQL,究竟应该怎么选?
两者并不是竞争关系:
- 如果要完成高频交易、精确更新、复杂事务,关系型数据库和 SQL 往往更加合适;
- 如果需要围绕对象和语义关系开展查询,尤其是多个概念之间存在复杂关联时,SPARQL 就有自己的优势。
企业也可以同时使用两者:
- 交易数据保存在关系型数据库;
- 通过映射机制将相关数据呈现为 RDF 图;
- 使用 SPARQL 查询统一后的业务关系;
- 对需要修改的数据,通过经过授权的业务 API 或领域服务执行。
这也是语义层的一种常见设计思路。
但到这里,还有一个问题没有解决。我们可以表达知识,可以定义逻辑,也能够查询数据。如果某个客户缺少必填属性,或者某条订单关系根本不符合数据规范,系统能否主动发现?这就需要 SHACL。
SHACL:让语义数据有明确的质量标准
1. 为什么 RDF 图中的数据可能不符合要求?
RDF 的一个特点是表达结构比较灵活。你可以给 Customer 添加名称,也可以添加客户等级,还可以增加与订单的关系。但是,RDF 本身并不会要求每一个 Customer 都必须有客户名称。
假设企业规定:
- 每个客户必须有名称;
- 每个客户最多只能有一个当前等级;
- 每笔订单必须关联客户;
- 订单金额必须是合法的数值。
这些约束应当由什么技术来检查?答案是 SHACL。
SHACL 的全称是 Shapes Constraint Language,中文通常称为形状约束语言。它用于定义 RDF 图应满足的条件,并对数据图进行验证。验证结果可以形成结构化报告,指出哪些节点违反了哪些约束。
官方规范: https://www.w3.org/TR/shacl/
2. 先定义一份客户数据约束
下面使用 Turtle 编写一份简单的 SHACL 约束:
@prefix ex: <https://example.com/> .
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix xsd: <http://www.w3.org/2001/XMLSchema#> .

ex:CustomerShape
    a sh:NodeShape ;
    sh:targetClass ex:Customer ;
    sh:property [
        sh:path ex:customerName ;
        sh:minCount 1 ;
        sh:datatype xsd:string
    ] ;
    sh:property [
        sh:path ex:customerLevel ;
        sh:maxCount 1
    ] .
这段代码定义了 CustomerShape,用于检查属于 Customer 类的节点。其中:
sh:NodeShape 表示节点形状;sh:targetClass ex:Customer 表示将 Customer 类的实例作为目标节点;sh:path ex:customerName 指定要检查的属性路径;sh:minCount 1 表示该属性至少出现一次;sh:datatype xsd:string 表示属性值应当是字符串类型;sh:maxCount 1 表示客户等级最多只能有一个值。
例如,下面这条数据没有提供 customerName:
ex:C002 a ex:Customer .
对它进行 SHACL 验证时,就会发现它违反了客户名称必填的约束。而下面这条数据:
ex:C003 a ex:Customer ;
    ex:customerName "李女士" ;
    ex:customerLevel "VIP" ;
    ex:customerLevel "NORMAL" .
同时存在两个客户等级值,也会违反 sh:maxCount 1 的约束。
踩坑提示: SHACL 的验证行为取决于实际使用的验证器、数据图和约束图。验证器会根据所配置的目标与约束生成验证结果,并不意味着它一定会自动修复错误数据。
3. SHACL 能检查哪些问题?
除了必填项和属性数量,SHACL 还可以用于检查:
- 数据类型是否符合要求;
- 数值是否处于规定范围;
- 字符串长度是否符合规范;
- 属性值是否属于指定的枚举集合;
- 关联对象是否满足特定条件;
- 多个属性之间是否满足约束关系。
SHACL Core 提供了常见的约束组件,SHACL-SPARQL 则进一步支持通过 SPARQL 表达更复杂的验证逻辑。例如,企业可以规定订单金额不得小于零:
@prefix ex: <https://example.com/> .
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix xsd: <http://www.w3.org/2001/XMLSchema#> .

ex:OrderShape
    a sh:NodeShape ;
    sh:targetClass ex:Order ;
    sh:property [
        sh:path ex:orderAmount ;
        sh:minCount 1 ;
        sh:datatype xsd:decimal ;
        sh:minInclusive 0
    ] .
这段约束要求订单必须有 orderAmount 属性,属性值必须是十进制数值,并且不得小于零。如果订单金额为负数,验证器就可以报告相应的约束违反。
这让数据质量检查从散落在不同代码中的条件判断,转变为可以独立维护和重复执行的约束定义。
4. OWL 和 SHACL,最容易混淆的地方
两者都涉及规则、约束和逻辑,因此经常被混为一谈。但它们关注的重点并不相同:
| 技术 |
关注重点 |
| OWL |
主要描述概念和关系的形式化语义,可以用于推理与一致性分析。 |
| SHACL |
主要定义数据必须满足的形状条件,并对实际数据进行验证。 |
例如,OWL 说“VIPCustomer 是 Customer 的子类”,SHACL 说“每个 Customer 都必须有 customerName”。前者描述类之间的逻辑关系,后者规定数据应满足的结构要求。
再看一个更容易误解的例子。假设某个 Customer 缺少 customerName,SHACL 可以根据必填约束报告这个问题。但在 OWL 的开放世界语义下,缺少一条属性声明通常不等于该属性不存在,更不意味着自动违反了某个必填规则。
这也是为什么企业语义层经常同时采用 OWL 与 SHACL:一个负责语义建模,一个负责明确约束下的数据验证。
把四项技术放到一起,语义层究竟如何工作?
前面分别介绍了四项技术。现在,把它们放到同一个企业业务场景中。假设业务人员提出需求:
“找出所有 VIP 客户及其未完成订单,并确保返回的数据符合企业的数据规范。”
这条需求看似简单,背后实际上涉及一套完整的工作流程。
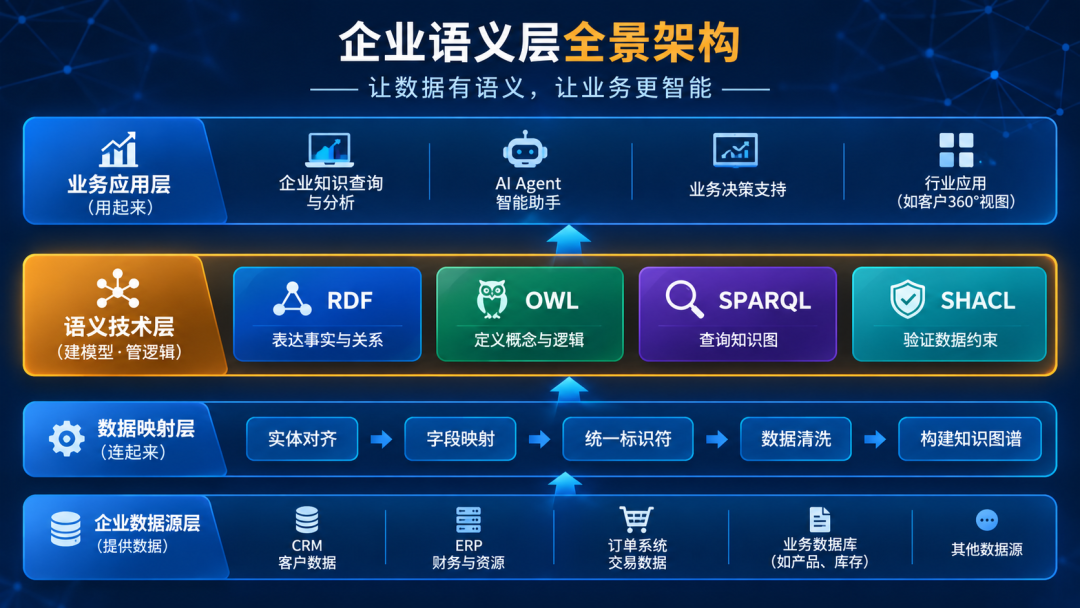
STEP 01:接入企业数据,建立统一映射
首先,从 CRM 获取客户信息,从订单系统获取订单及其状态。在这个过程中,系统要处理不同来源的数据格式、客户编码以及业务字段之间的映射。例如:
CRM.customer_id = C001
ERP.customer_code = A-9001
如果这两个编号代表同一个客户,就要通过主数据映射或实体解析建立对应关系。这里的关键工作是数据治理,而不是 RDF 自动完成了实体匹配。
STEP 02:使用 RDF 表达业务对象和关系
完成映射后,将客户、订单以及它们之间的关系表达为 RDF 图。例如:
@prefix ex: <https://example.com/> .

ex:C001 a ex:VIPCustomer ;
    ex:customerName "张先生" ;
    ex:hasOrder ex:O1001 .

ex:O1001 a ex:Order ;
    ex:orderStatus "PROCESSING" .
此时,系统已经有了统一的对象标识和关系表达。
STEP 03:使用 OWL 描述业务概念
在本体中定义:
- VIPCustomer 是 Customer 的子类;
- Customer 可以拥有 Order;
- Order 具有相应的业务属性。
如果系统配置了兼容的推理器,就可以根据这些逻辑声明推导出相关的隐含知识。比如,某个对象被声明为 VIPCustomer,推理器可以据此推导它也属于 Customer。
STEP 04:使用 SHACL 验证数据
在查询之前或数据入库时,对相关数据执行 SHACL 验证。例如:
- 客户是否有名称;
- 订单是否具有合法状态;
- 订单金额是否符合约束;
- 关键业务关系是否满足数据规范。
验证结果可以进入数据治理流程。需要强调的是,SHACL 只检查已定义的约束,不会自动证明整个业务数据完全正确,也不会替代业务审批。
STEP 05:使用 SPARQL 查询业务结果
当数据模型和查询条件准备好后,执行 SPARQL:
PREFIX ex: <https://example.com/>

SELECT ?customer ?name ?order
WHERE {
    ?customer a ex:VIPCustomer ;
              ex:customerName ?name ;
              ex:hasOrder ?order .

    ?order a ex:Order ;
           ex:orderStatus "PROCESSING" .
}
系统就可以返回符合条件的客户和订单。如果底层数据没有明确记录 VIPCustomer 类型,而只记录 customerLevel = "VIP",则应当相应调整查询或配置推理机制。
STEP 06:将结果提供给业务应用或 Agent
查询结果可以封装为统一的数据结构,再返回给前端、分析服务或者 AI Agent。例如:
{
  "customer_id": "C001",
  "customer_name": "张先生",
  "orders": [
    {
      "order_id": "O1001",
      "order_status": "PROCESSING"
    }
  ]
}
这只是一个示意性的返回结构,并不意味着 RDF 必须以 JSON 存储。至此,一条基本的语义查询链路就建立起来了。如果把整个过程概括成一句话:
RDF 组织事实,OWL 描述语义,SHACL 验证数据,SPARQL 查询知识。
踩坑提示: 四项技术并不需要严格按照 RDF、OWL、SHACL、SPARQL 的顺序依次执行。本体定义可以先于数据导入;SHACL 可以用于数据接入时的校验,也可以在查询之前运行;OWL 推理可以按需启用;SPARQL 查询则取决于应用的访问需求。它们是一组可以协同工作的技术,而不是固定不变的流水线。
从语义层到 AI Agent:为什么这件事值得企业关注?
如果只把 RDF、OWL、SPARQL、SHACL 当成知识图谱领域的四项技术,可能很难理解它们对企业 AI 的实际价值。真正值得关注的,是它们能否帮助 Agent 从理解业务问题,进一步走向可靠地访问企业数据。
1. 传统 Agent 面临的问题
假设用户提出:“查一下 C001 的未完成订单。”一个直接连接底层系统的 Agent,可能要自己处理客户编码、数据表关联、订单状态映射以及 API 参数。
当业务逻辑分散在多个系统时,这些细节很容易成为 Agent 的负担。如果每个 Agent 都重复实现一遍,系统的维护成本就会持续增加。
2. 语义层可以提供统一的业务入口
可以设计成这样一条链路:
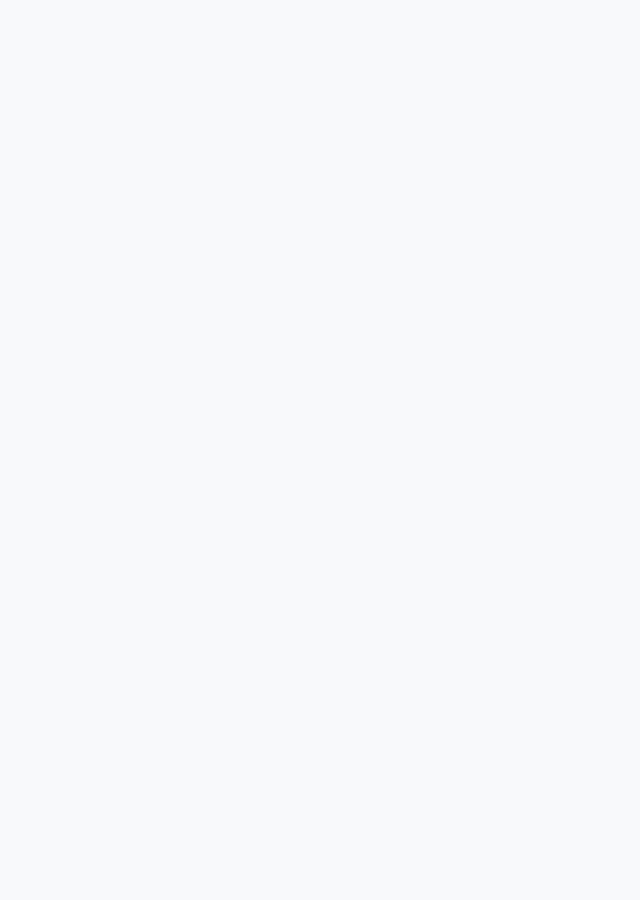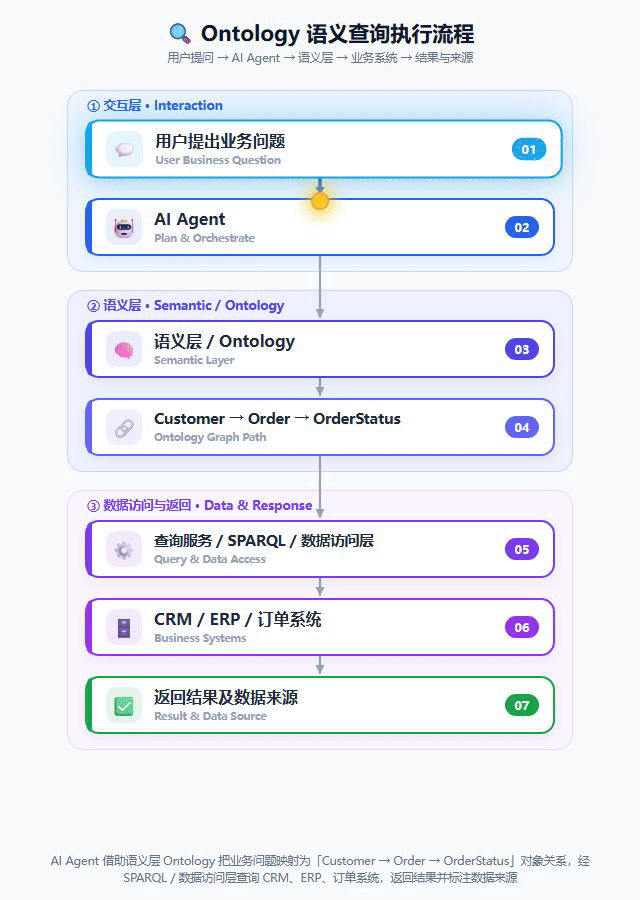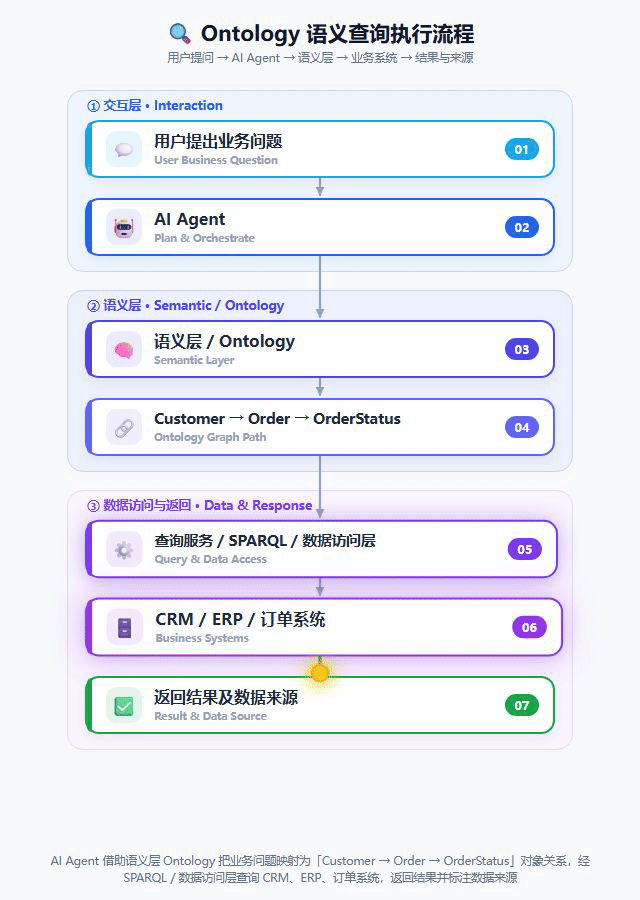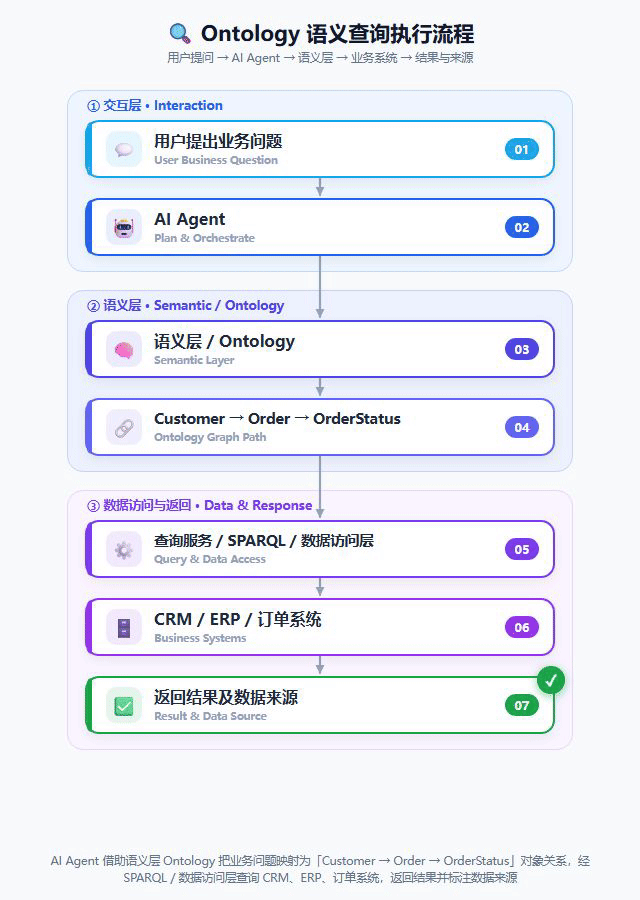
Agent 不必在每次任务中重新拼装所有底层数据关系,而是通过统一的业务概念访问数据。语义层则负责维护对象定义、关系映射、查询逻辑以及相关服务接口。
这里不要求所有企业数据都必须复制到 RDF 数据库中。对于已有的关系型数据库、数据仓库和业务 API,可以根据实际情况采用 RDF 存储、虚拟知识图谱、数据映射或联邦查询等方案。选择哪种方式,取决于数据规模、实时性要求、系统架构和运维成本。
3. 如果 Agent 要修改业务数据呢?
查询和执行,是两个完全不同的问题。例如,用户要求:“把 C001 升级为 VIP。”这不是简单地执行一条 SPARQL 查询就能完成的任务。更合理的架构是:
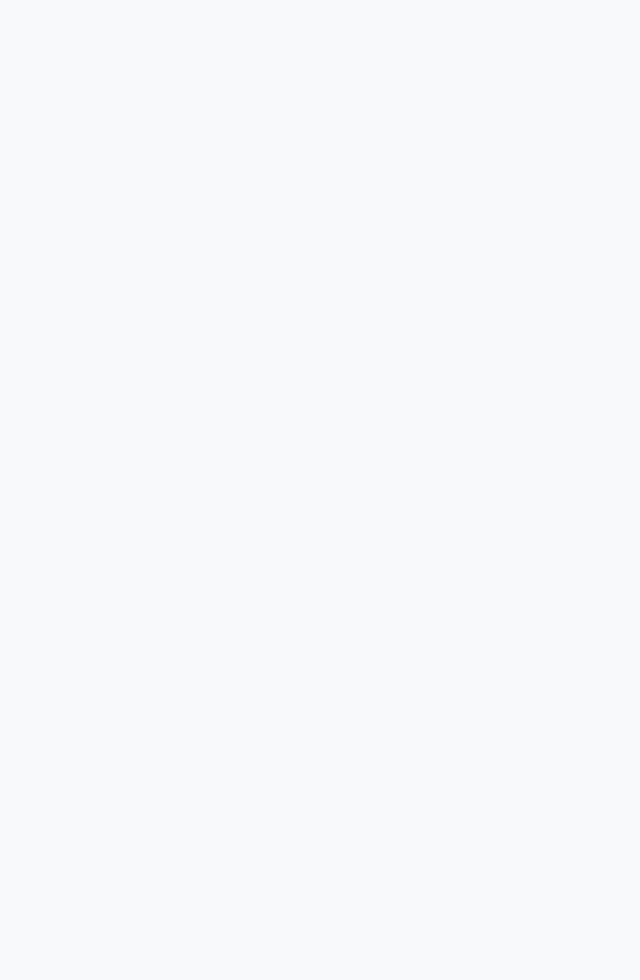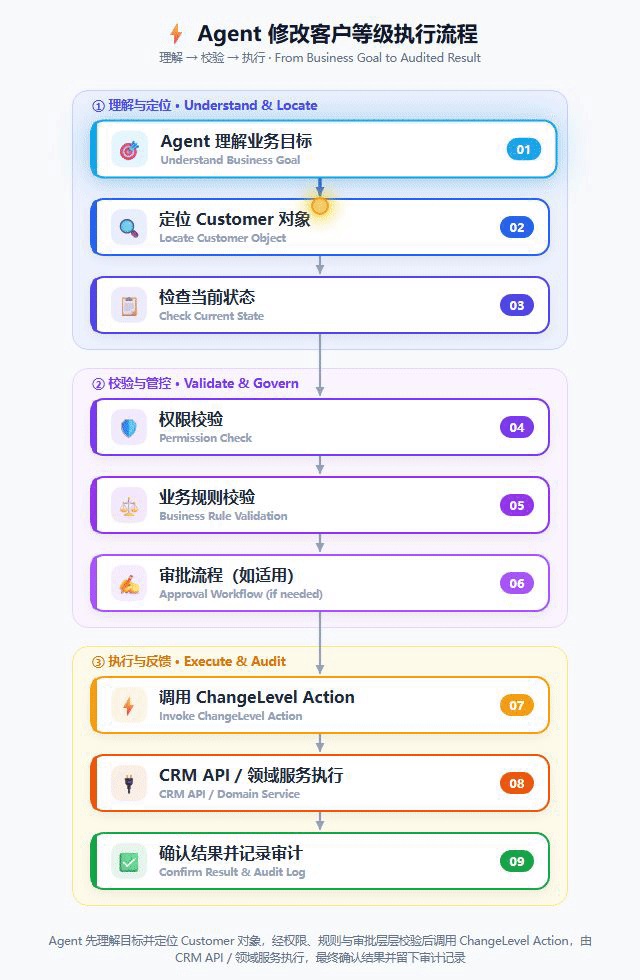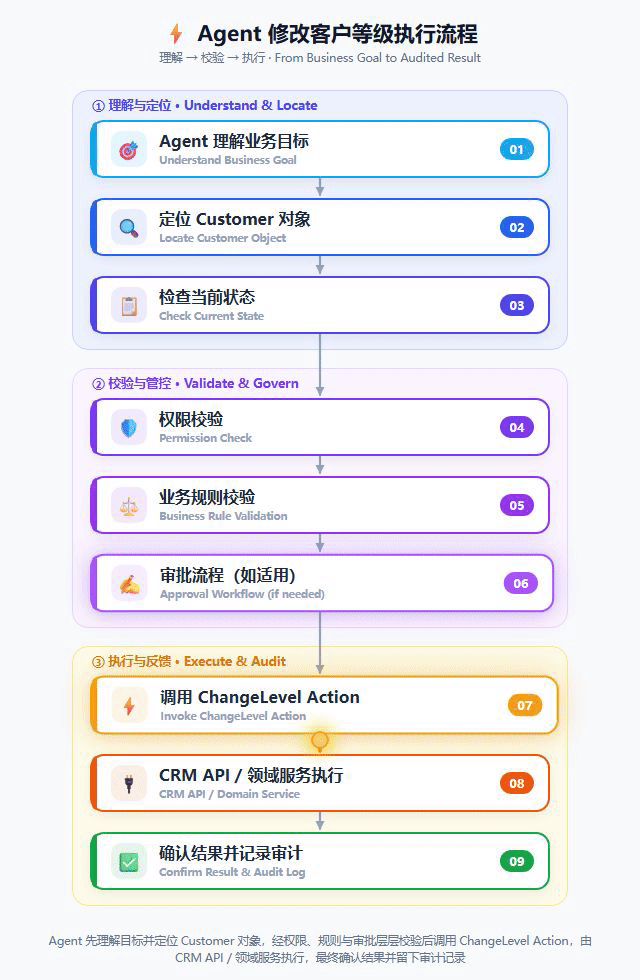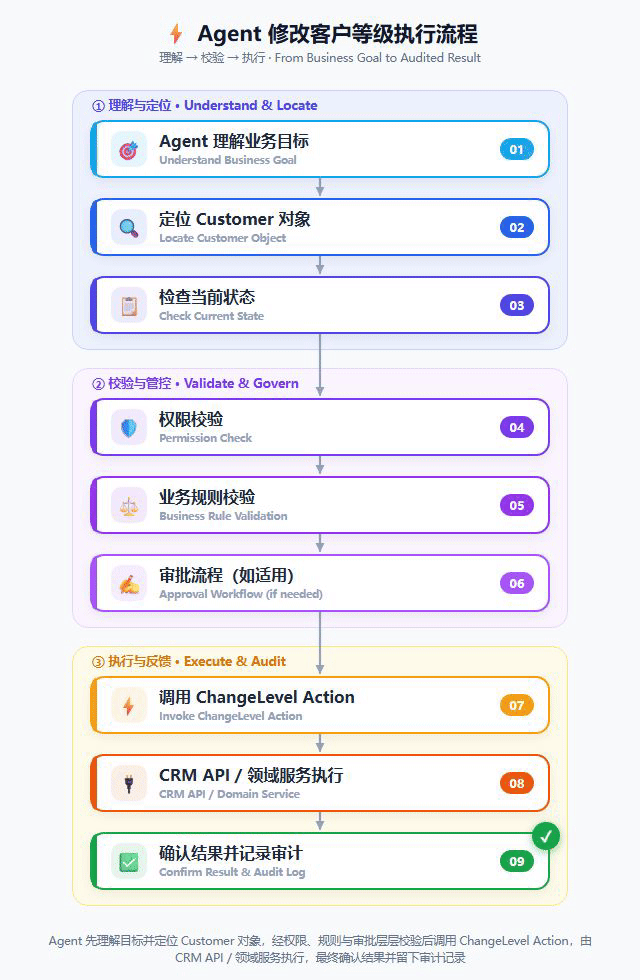
在这条链路中:RDF 可以描述 Customer 及其关系;OWL 可以描述客户类型及相关语义;SPARQL 可以查询客户当前状态和关联信息;SHACL 可以检查数据是否满足已定义的结构约束。
但真正执行修改的 Action、权限控制、审批、事务管理和审计,仍然需要由可信的业务执行层负责。
不能因为 Agent 理解了某个业务概念,就默认它有权修改数据;也不能因为 SHACL 验证通过,就认定某个业务操作已经获得授权。
这正是企业语义层与普通知识图谱应用的一个重要区别:它不仅要帮助系统理解数据,还要与实际业务系统形成可靠的连接。至于是否把业务 Action 也纳入 Ontology 管理,则取决于具体架构设计。RDF、OWL、SPARQL 和 SHACL 本身并不自动提供完整的企业业务执行框架。
从零开始,如何搭建一个最小可运行的语义层?
讲到这里,可以把理论落到一个小项目上。不必一开始就建设覆盖整个企业的本体。先选定一个边界清楚的业务场景,例如客户与订单查询。
STEP 01:定义业务对象
先确定三个核心对象:Customer、Order、Product。再定义关键属性和关系:
Customer.customerName
Customer.customerLevel
Customer.hasOrder

Order.orderStatus
Order.orderAmount
Order.containsProduct
在设计时,要明确哪些概念是类,哪些是具体实例,哪些是数据属性,哪些是对象之间的关系。
STEP 02:准备 RDF 数据
用 Turtle 创建几条客户、订单和产品记录。先确保每个业务对象都有稳定的标识符,再检查跨系统数据映射是否准确。
踩坑提示: 如果同一个客户在 CRM 和 ERP 中有不同编号,先解决实体对齐问题,不要直接假定编号相同就代表同一个客户。
STEP 03:定义 OWL 本体
定义 Customer、VIPCustomer、Order 等类,以及必要的属性和逻辑关系。先从简单的子类关系和对象属性开始,等业务需求明确后,再考虑更复杂的逻辑公理。对于大规模本体,还要评估推理器支持的 OWL 配置以及计算成本。
STEP 04:建立 SHACL 约束
从最重要的数据质量要求开始:
- 客户名称必填;
- 客户等级最多一个;
- 订单必须具有订单编号;
- 订单金额必须是合法数值;
- 关键关联关系必须满足约定的约束。
将约束作为独立的模型维护,并纳入自动化验证。
STEP 05:编写 SPARQL 查询
先实现三个常用查询:
- 查询所有客户及其等级;
- 查询指定客户的全部订单;
- 查询 VIP 客户的未完成订单。
然后将查询封装成应用服务,为前端或 Agent 提供统一的调用接口。
STEP 06:把验证与测试纳入开发流程
当客户等级、订单状态或业务关系发生变化时,重新执行数据验证和查询测试。例如:
- 新增一个订单状态后,检查已有查询是否仍能正确识别未完成订单;
- 如果客户模型发生变化,检查 SHACL 约束是否需要更新;
- 如果新增类层级或逻辑公理,检查推理结果是否符合预期。
这些工作看似琐碎,却决定了语义层能否长期维护。
工具怎么选?
如果采用开源技术栈,可以重点了解:
| 工具 |
用途 |
| Apache Jena |
提供 RDF、SPARQL 和相关语义技术能力。 |
| Eclipse RDF4J |
用于 RDF 数据处理、存储和查询。 |
| Protégé |
用于本体建模与 OWL 编辑。 |
| pySHACL |
用于在 Python 项目中执行 SHACL 验证。 |
实际选型时,还要考虑与现有数据库、服务框架、部署环境及监控体系的集成。
对刚开始实践的团队来说,先用小规模数据跑通“RDF 建模—OWL 定义—SHACL 验证—SPARQL 查询”这条链路,比直接引入一套复杂平台更有价值。
企业做语义层,最容易踩的五个坑
最后,再谈几个实践中值得提前规避的问题。
- 把 RDF 等同于图数据库。 RDF 是一种数据模型,图数据库是可能的存储和执行方案。采用 RDF 并不意味着所有业务数据都必须迁移到图数据库。
- 把 OWL 当成业务规则引擎。 OWL 适合描述形式化语义与逻辑关系,但不能替代复杂的业务审批、事务控制和权限管理。
- 把 SHACL 当成 OWL 推理的替代品。 SHACL 用于验证数据是否满足已定义的约束,OWL 用于表达概念及其逻辑语义。两者可以协作,但职责不同。
- 以为用了 SPARQL,就不需要关注查询性能。 复杂图查询、多跳关系、联邦查询和大规模数据访问,同样面临性能、缓存、索引与执行计划等工程问题。
- 只建模,不治理数据。 如果同一个客户在多个系统中没有可靠的映射关系,或者订单状态定义互相矛盾,再漂亮的本体也无法保证结果正确。
这往往是企业语义层项目最值得重视的地方。
语义模型不是脱离业务数据独立存在的知识装饰。它必须建立在清晰的业务定义、可靠的数据映射、明确的约束和持续的维护机制之上。
总结:真正重要的是让四项技术形成协作
回过头看,RDF、OWL、SPARQL、SHACL 解决的是四个不同的问题:
| 技术 |
解决的问题 |
| RDF |
如何表达业务事实和关系。 |
| OWL |
如何描述概念的语义,以及哪些结论能够根据形式化规则推导出来。 |
| SPARQL |
如何从知识图中查询符合条件的信息。 |
| SHACL |
数据是否满足预先定义的结构和质量约束。 |
它们共同构成了语义知识建模与处理的一组重要技术基础。但企业语义层并不止于此。
要真正服务企业 AI,还要把这些知识模型与实际数据源、统一标识、查询服务、权限体系、业务规则、Action、系统集成和审计机制连接起来。
只有这样,Agent 才能从“能够调用工具”,进一步走向“围绕统一业务语义理解数据、获取信息,并在受控条件下执行操作”。
对于正在推进企业 AI 的团队而言,比较务实的路线并不是一开始就建设覆盖所有系统的庞大本体。
可以从一个明确的业务场景开始:先统一概念和数据映射,再用 RDF 表达关系,用 OWL 描述必要的语义,用 SHACL 验证数据,用 SPARQL 完成查询。等这条链路跑通,再逐步连接业务服务、权限与执行机制。
语义层真正的价值,不在于使用了多少种标准,而在于不同系统中的数据能否围绕统一的业务概念被正确理解、查询、验证。
这才是 RDF、OWL、SPARQL、SHACL 在企业 AI 架构中值得关注的原因。
想继续了解知识图谱相关的架构设计与实践资料,也可以到云栈社区查阅。
 发表于 1 小时前
|
查看: 7|
回复: 0
 /1


