假设下班前,你让 Agent 盯一个 PR:“CI 失败就分析原因,修好后通知我,合并前等我确认。”
CI 十分钟后才结束,你可能明早才回复。中间没人再发消息,Agent 也得记得回来检查。
可要是它每隔一分钟都告诉你“还在等”,这助理用不了多久就得被静音。
Anthropic 在 11 月 13 日发布的《Building always-on agents》[1] 中,介绍了这类系统的设计思路。
它沿用 Agent 原有的工作循环,在外围补上事件收件箱、定时器、记忆、权限和发件箱。
有事再醒,没人催也能跟进
官方把一次被唤醒的工作叫作 run,消息和工具调用记录归在 session 里。完成一轮后,Agent 可以休眠;后续事件到来,再开始一轮工作。
对前面的 PR,CI 回调是一种唤醒方式。
另一个办法,是启动 CI 时登记一次“十分钟后检查”。到期由调度器生成事件,Agent 再去看结果,不用靠你回来追问。
一次性跟进和固定计划也要分开:这轮 CI 的结果处理完,本次跟进就可以结束。
如果用户要求每天早上汇总待审 PR,跑完还要安排下一次。下面是这个 PR 的流程示意:
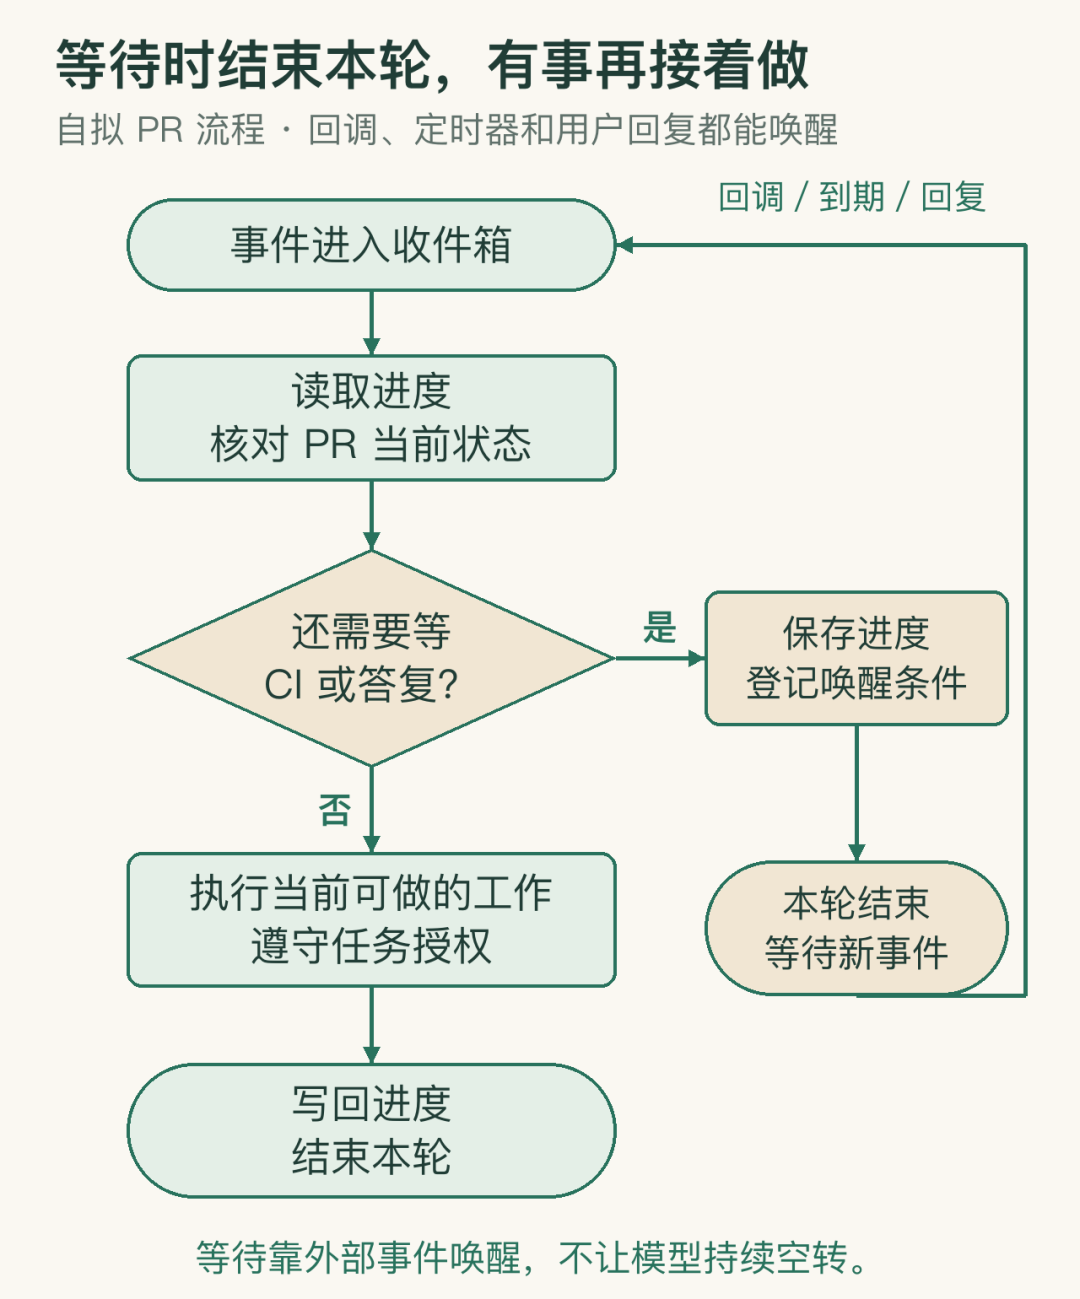
任务进入等待时,要留下能唤醒它的事件或期限。只在聊天里留一句“我会持续关注”,却没有后续事件来唤醒它,任务就停在这里了。
等 CI 时不用调用模型,也就不消耗推理 token。定时检查交给普通程序,服务和存储费用另算。
并发事件先进入收件箱
假设 CI 发来失败回调,你紧接着补了一句“先别改,等我推一个提交”。如果两个入口直接各启动一个 Agent,一个忙着修,一个忙着等,最后谁说了算?
官方建议先把事件收进持久化收件箱,同一个收件箱同时只让一个 worker 处理,还可以合并积压的消息。
新事件在运行中到达时,也要明确是留到下一轮、并入当前轮,还是中断重来。
对这个 PR 助手,我会让“先别改”暂停后续修改,并把任务记为等待新提交。等新代码推上来,再判断旧的 CI 报错还需不需要处理。
仅把这句话排到队尾,可能等前一个 Agent 改完代码才读到,就晚了。
接收接口只做校验、入库,别等模型分析完日志。GitHub 要求 webhook 在 10 秒内得到 2XX 响应,文档也建议把处理工作放到后台。[2]
同一个事件重新投递时,X-GitHub-Delivery 保持不变,可以把它作为入库去重的依据。
例如把投递 ID 设为 inbox 表的主键,再用下面这段自拟 SQL 入库:
INSERT INTO inbox (delivery_id, payload)
VALUES ($1, $2)
ON CONFLICT (delivery_id) DO NOTHING;
$1 是投递 ID,$2 是事件内容。相同 ID 再次到达时,DO NOTHING 会跳过插入;事务提交后再确认接收成功。
不过,定时检查和 webhook 可能对应同一轮 CI,却有不同的事件 ID。这个例子里,还得拿 PR、提交 SHA 和 CI run ID 核对,确认那轮构建是否已经处理。
事件存下来了,中途退出的任务也得有人接。比如 worker 分析日志时进程挂了,调度层要能回收它领取的任务,交给新的 worker。
接手后还得核对上次做到哪一步,免得把已经执行的操作再做一遍。
记住进度,每轮少读一点
这个 PR 修过两轮,留下了几份失败日志和一串讨论。现在只是回来检查 CI,没必要再把前面的排障过程读一遍。
每轮先读用户约定和任务进度,比如“合并前必须确认”。需要分析报错时,再按链接取 CI 日志。
比如用户已经说过“这个仓库的集成测试要连测试库”,这类纠正值得留下。
构建平台随时能查到的结果,则保留定位信息,需要时读取最新状态,免得把旧结论抄成长期记忆。
进度可以这样记。字段是自拟示意,不是 Claude 配置:
task: pr-42
head_sha: def456
ci_run_id: 987
phase: waiting_approval
approval_for_sha: def456
last_reported: "修复已提交,等待合并确认"
看到 waiting_approval,接手的 worker 就知道该等 def456 的审批结果。
last_reported 留下已告知用户的内容,下一轮也有依据判断要不要再发消息;实际送达状态仍需另外记录。
这些记录得放进持久化存储。Claude 的 memory tool 由模型请求文件操作,应用负责执行和存储。
如果只写进临时目录,容器换掉后,照样可能读不到。[3]
任务多了,可以先读一份索引,再按需打开对应记录。比如只处理 PR 42 的回复,就别把其他几十个 PR 的排障过程也带上。
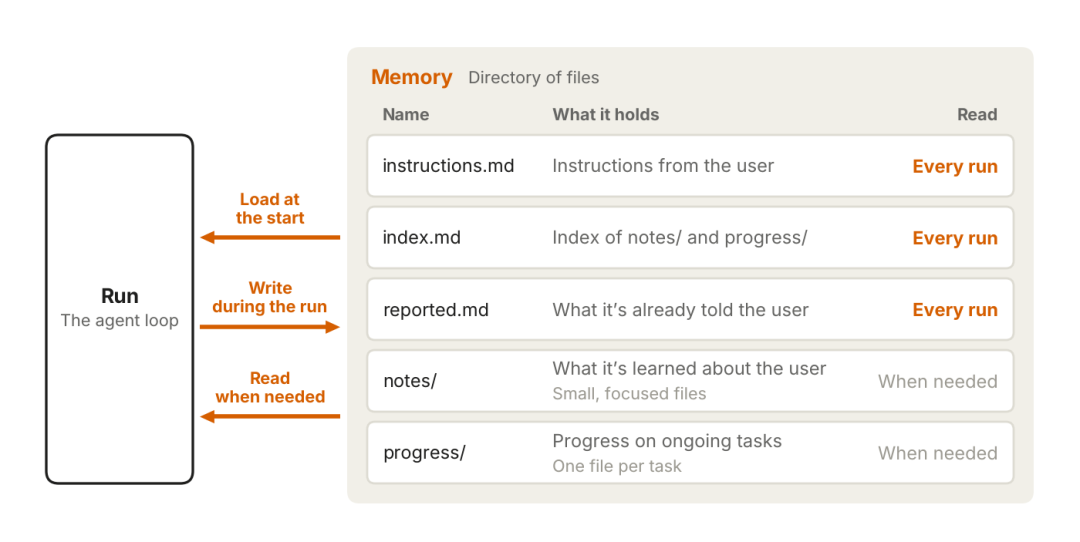
图中的 instructions.md、index.md、reported.md 每轮读取,notes/ 和 progress/ 按需打开。这是一种文件组织示例,文件名不必照搬。
把审批放进任务流程
回到最初那句要求:允许分析 CI、提交修复,合并前要确认。权限就该围绕这些具体动作划分。
能读仓库,不代表能合并;能执行测试,也不该顺带拿到生产发布权限。
CI 过了,Agent 把 diff、测试结果和待合并提交发给负责人。
你正在开会,半小时没回复,这一轮可以先停下来,保存等待中的动作。
Claude Code 支持延后工具调用。用 claude -p 非交互式运行,且该轮只有一个工具调用时,PreToolUse hook 可以返回 permissionDecision: "defer"。
工具暂不执行,本轮返回 tool_deferred。
调用方把问题展示给用户,拿到答复后恢复会话,hook 再处理那次调用。
交互会话或多个工具同时调用时,会忽略 defer。[4]
你批准的是 def456,等待期间别人又推了一个提交。这时不能拿着旧批准,直接合并新代码。
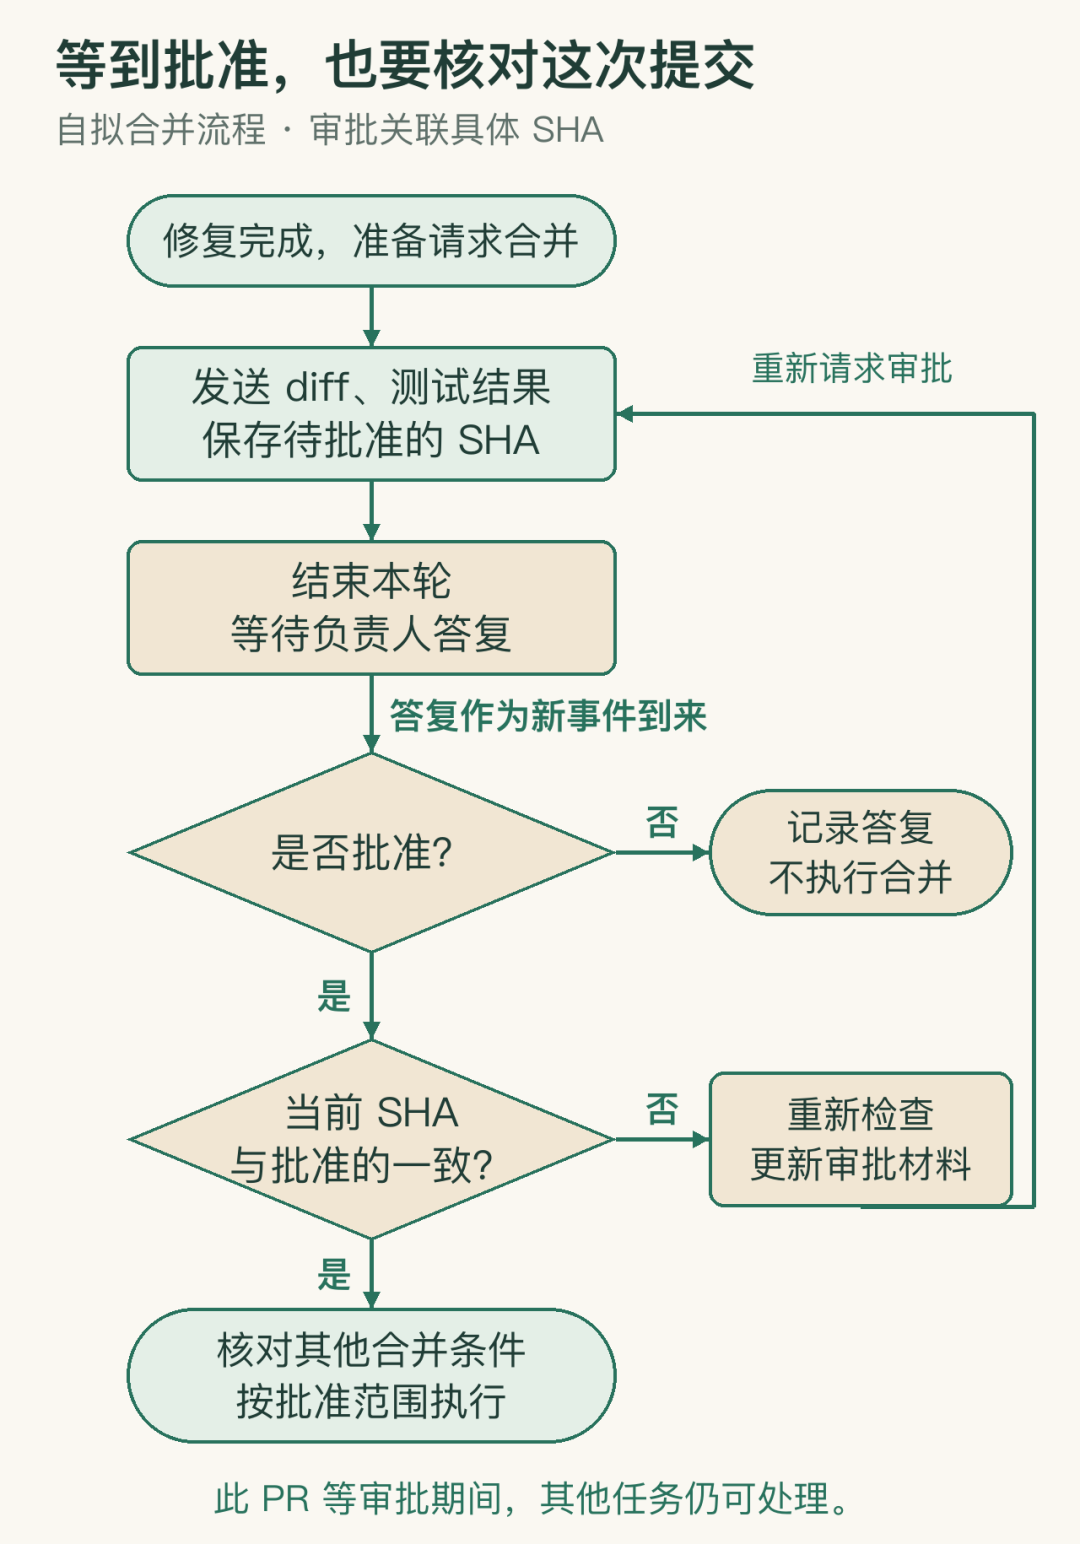
提交变了,就重新检查,把更新后的材料发给负责人。
等待答复时,其他任务照常处理;答复到来后,再接回原会话。
干了活,也可以不发消息
十分钟检查了一次,CI 还在跑,要不要告诉用户?
如果没有异常,也不需要他做决定,这次检查完全可以只更新进度,然后结束。
反过来,修复失败需要补充环境信息,或者代码已经可以合并,就值得通知。
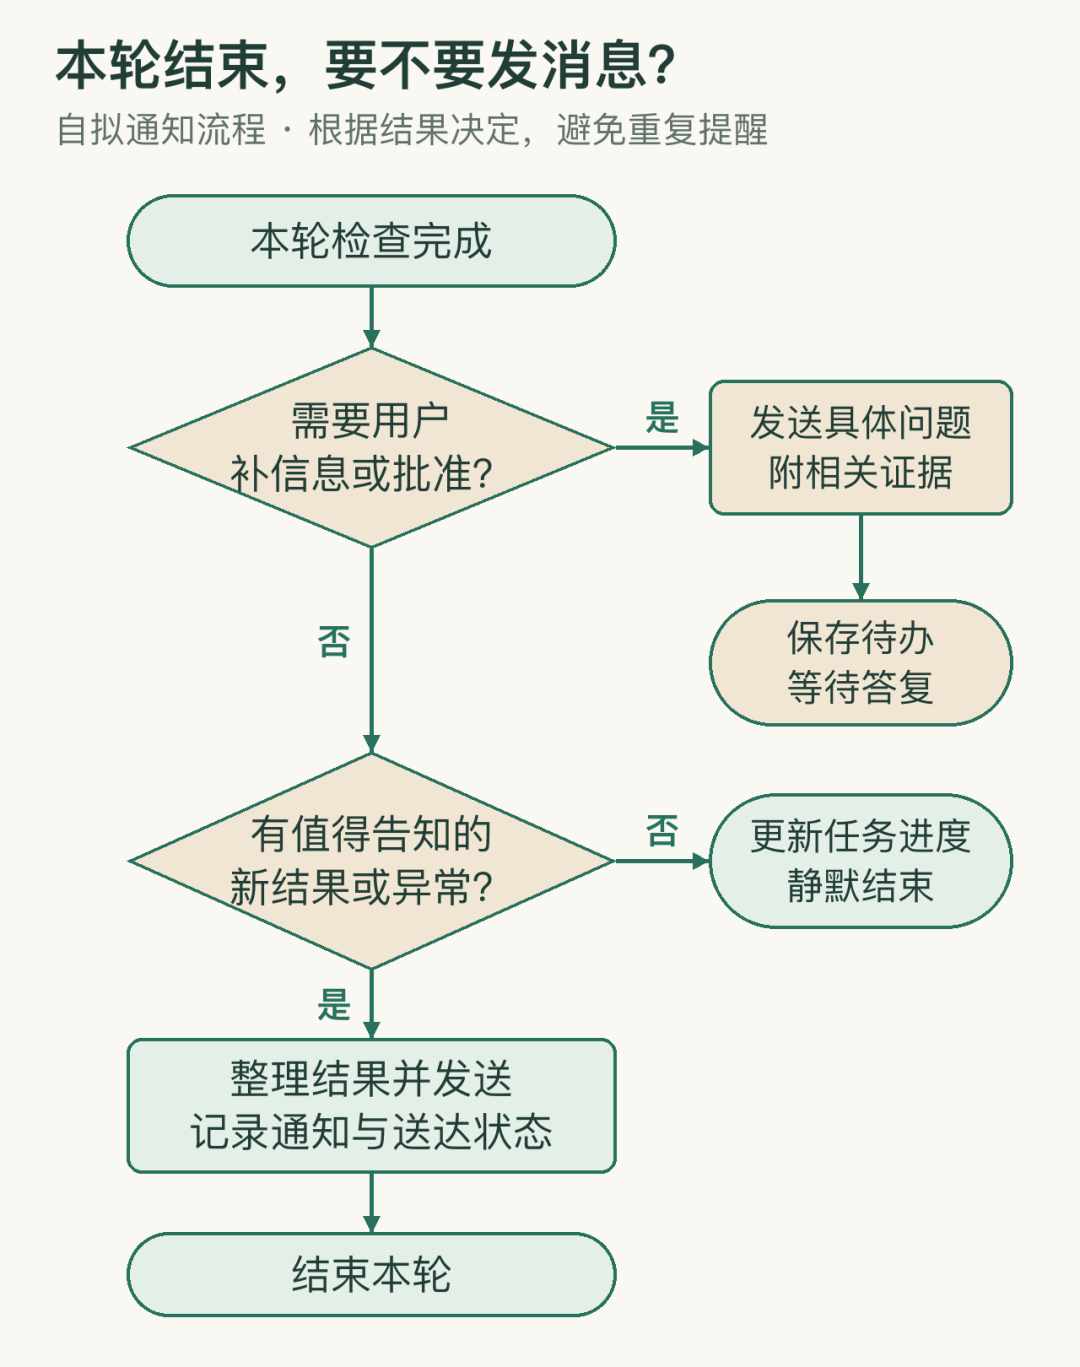
这里的发件箱还要管发送时机和节奏。官方建议从少打扰开始,用评估检查哪些消息值得发;简单场景可以直接发送,需要调度或恢复时再引入发件箱。[1]
发送可靠性也不能丢。事务发件箱能把任务状态和待发通知一起保存,但在“消息已发出、成功状态还没写入”时崩溃,重试仍可能重复。
需要下游幂等或回执核对,不能只靠模型记得“已经说过”。[5]
一次后台运行结束,不必对应一条用户通知。否则原本想省下的盯进度时间,很快就花在清理消息上了。
总结
验收时,可以把这个 PR 留给 Agent,先不主动追问。看它能不能按时回来检查,在 CI 没变化时安静等待,到需要合并时给出可审核的结果。
再补一次进程重启、一次提交变更,看它能不能接回任务,发现旧审批已经不适用。
否则后台挂了一整晚,第二天还是得你重新翻日志、补上下文。
来源与参考资料
作者:煎鱼。记忆目录示意图来自 Anthropic 原文。
- Building always-on agents
- GitHub webhook 文档
- Memory tool 文档
- 延后工具调用文档
- 事务发件箱的限制
 发表于 10 小时前
|
查看: 2|
回复: 0
 /1


