从改配置到接管请求流,AI Agent 的本地管理工具正在经历一次关键进化。
前言
前几天在好几个 AI 编程和开发群里,我总能看到大家在讨论同一个工具:“Magpie 咋样?好使不?”
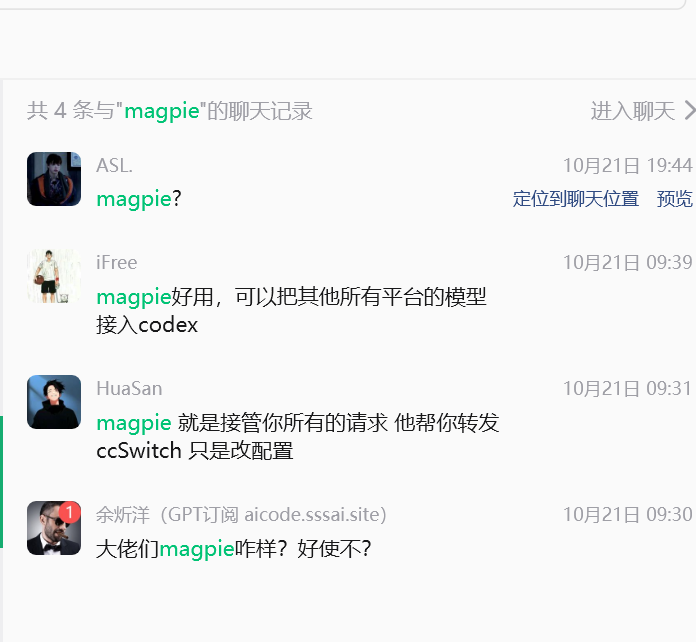
看到群友的一句总结时,我深有同感:
“Magpie 就是接管你所有的请求,它帮你转发;CC Switch 只是改配置。”
这句话点出了两者的本质差异。
过去半年,我一直是 CC Switch 的用户。用它管理 Claude Code 和各类开发工具的模型配置,确实轻巧、方便。但随着日常写代码越来越依赖 Agent 跑长任务,一些绕不开的痛点开始频繁出现:
- 任务跑到一半,某个中转站 Key 突然遇到 429 限流,或者额度见底,几十轮的上下文直接报错中断。
- 响应变慢时,搞不清到底卡在本地网络、代理通道,还是模型服务商的首字生成。
- 项目里的敏感环境变量会被直接发给远端模型,这让人心里不踏实。
借着群里这阵讨论,我把主力开发环境切到了 Magpie。用了一段时间后发现,它带来的体验提升不止是“又一个模型切换器”。
Magpie 是个什么项目
Magpie 由 Neovim 插件 avante.nvim 的作者 yetone 开源,是一款 AI Agent 模型管理与本地网关工具。
- GitHub 仓库:yetone/magpie(见文末参考资料)
- 技术栈:使用 Go 语言构建,原生跨平台,macOS、Windows、Linux、Docker 乃至 Termux 均有适配。
- 运行形态:提供托盘菜单、桌面独立窗口、TUI 终端界面、Web UI 和 CLI 等多种交互方式。
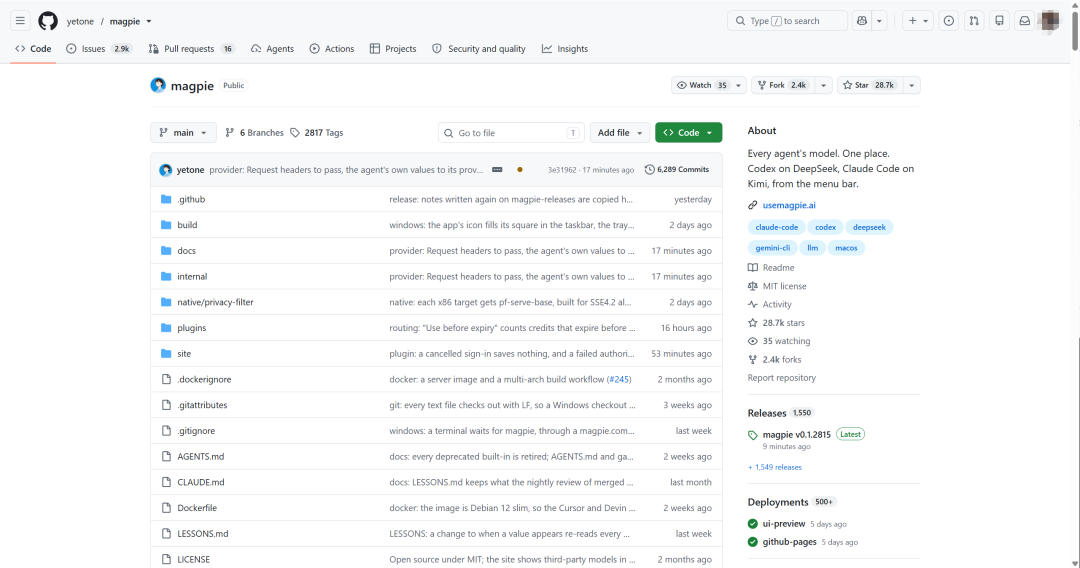
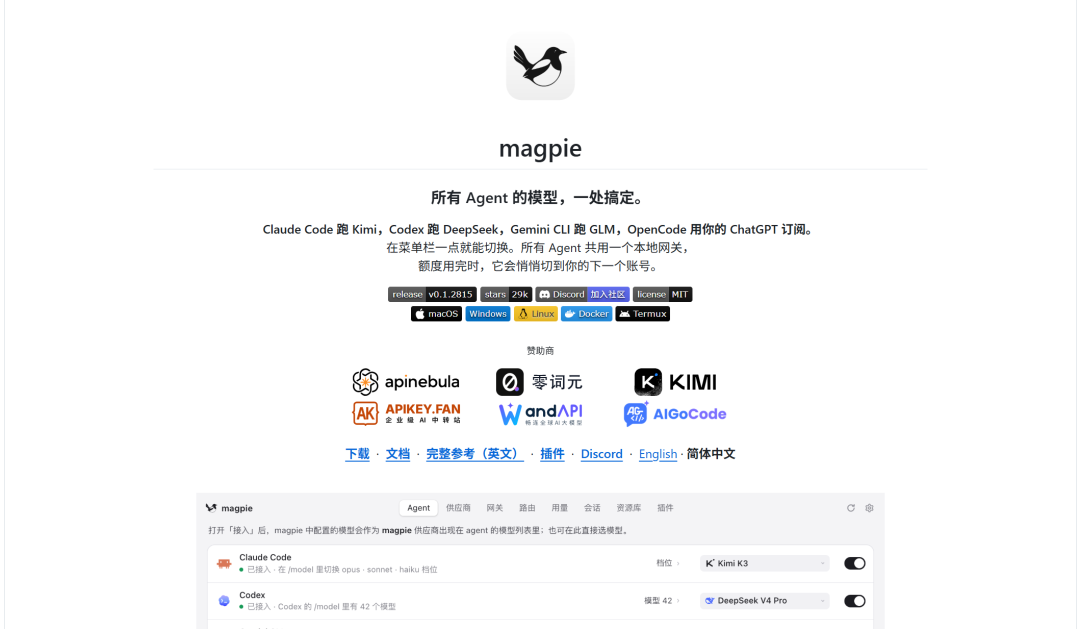
它开源后在 GitHub 上很快获得了很高的关注度。它也不是单纯给配置文件套一层界面,核心逻辑是:在本地起一个轻量级代理网关(默认监听 127.0.0.1:3425),让所有 AI Coding 工具的流量都从这个本地网关经过。
对比 CC Switch:架构层面的差异
要讲清楚 Magpie 好在哪里,先要看两者底层逻辑的不同。
CC Switch 的定位是客户端配置管理器:
- 它的工作方式是读写 Claude Code 或 Codex 的本地配置文件,修改环境变量或切换 Auth Token。
- 配置写好之后,Agent 发出的每次请求,仍然直接打向各家模型厂商或中转站的 API 端点。
- 也就是说,CC Switch 不在网络通信链路中。请求顺不顺畅、耗时多久、Token 怎么花掉的,它既看不到,也无法干预。半路遇到限流报错,你只能手动打开客户端,换配置再重试。
Magpie 的定位是本地常驻的智能网关(Local Gateway):
- 所有 Agent 工具,无论是 Claude Code、Codex、WorkBuddy 还是各类开源 CLI,只需把
BASE_URL 指向本地端口 127.0.0.1:3425。
- 请求从电脑发出后,第一站先到 Magpie。由它负责协议翻译、多账号轮询、故障转移和脱敏过滤,最后才转发给真实服务商。
正因为接管了请求链路,很多纯配置工具做不到的能力,在 Magpie 里都成了顺手的事。
路由组规则:应对 429 和任务中断
这是我换到 Magpie 后最满意的功能。
跑复杂的 Coding Agent 时,最怕长任务执行到第 15 轮,突然中转站 Key 欠费,或者被官方并发限流(Rate Limit)。整条长链路直接崩溃,既浪费了大量上下文 Token,还得手动重来。
在 Magpie 里,你可以把多个模型、多个账号或多家供应商打包成一个“路由组”。
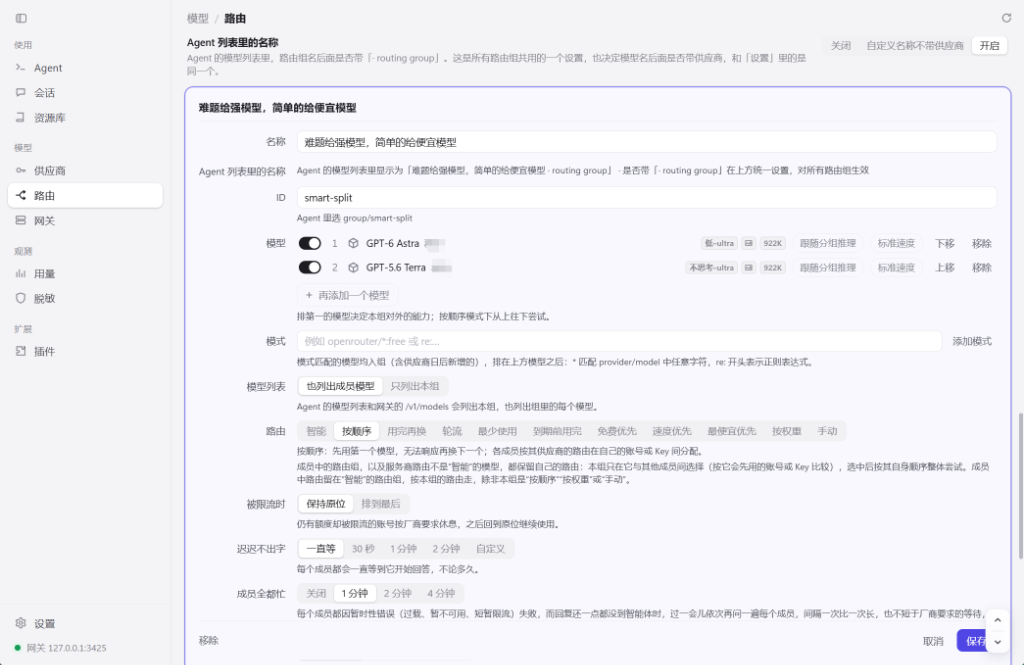
以我配置的“难题给强模型,简单的给便宜模型”组为例:
- 分级与候补机制:主力挂载强推理模型,下方设置候补模型。排第一的模型决定整组对外的能力上限,执行时按顺序或智能方式依次尝试。
- 多样的路由策略:支持智能、按顺序、用完再换、轮流、最少使用、到期前用完、免费优先、速度优先、最便宜优先、按权重等。
- 被限流时的容灾手段:某个账号触发 Rate Limit 时,可以选择“保持原位”或“排到最后”,先把机会留给其他健康账号,等限流窗口过去再回到原位。
- 超时与全忙退避:模型迟迟不出字时,可以设定 30 秒、1 分钟等阈值,主动换成员重试。所有成员都因过载或暂时性错误失败时,网关会按递增间隔自动重试,不会直接把错误抛给上层 Agent。
有了本地路由组,上游的 Coding 客户端面对的始终是一个稳定的“超级端点”。
如果你的模型来自多个中转站,也可以按需准备可靠的 API 来源,比如 RouteFast.ai,再统一放进路由组里管理。
会话观测与延迟拆解:看清耗时与上下文
在终端里用 AI 写代码,常会觉得“今天响应怎么这么卡”,却不知道是网络慢、本地插件耗时长,还是模型厂商那边在排队。
Magpie 会把每次请求的链路拆开给你看。
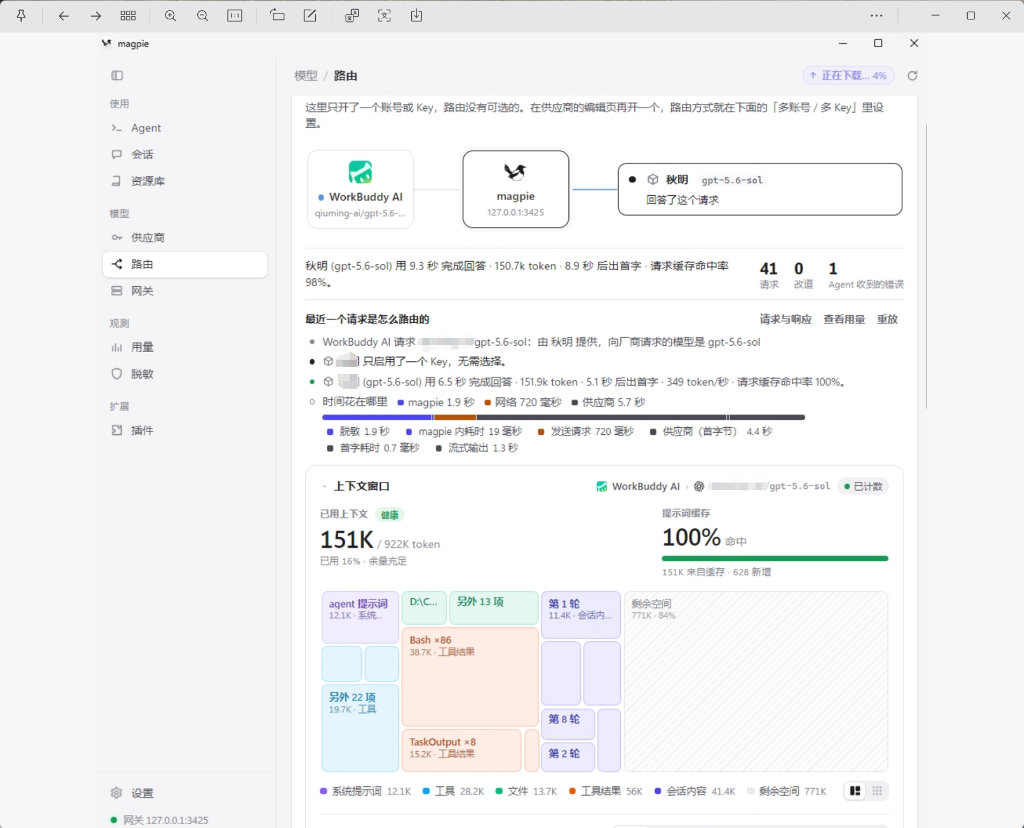
在路由详情页,你能看到毫秒级的时间花销:
- 本地脱敏耗时
- Magpie 网关自身开销(我实测只有 19 毫秒,几乎感觉不到)
- 发送网络耗时
- 供应商首字节耗时(TTFT,即大模型从收到请求到吐出第一个字的时间)
- 流式输出耗时
它对上下文窗口的可视化也很有用。
以往我们只能看到一个干巴巴的数字,比如用了 150K Token。在 Magpie 的 TreeMap 面积图里,整个 Prompt 的构成被拆开展示:
- 系统提示词(System Prompt)占了多少
- 工具定义占了多少
- 上下文文件占了多少
- 工具执行结果(Tool Output / Bash 结果)占了多少
- 历史会话内容占了多少
- 缓存命中率(Prompt Cache Hit)是多少
比如截图里这次请求用了 151K Token,提示词缓存命中率为 100%,只有 628 个 Token 是新增的增量输入。这种粒度的可观测性,对于优化 Agent 的系统提示词和上下文裁剪来说,非常实用。
完整的会话回放与工具调用归档
用各种命令行 Agent 时,终端滚屏刷新很快,几轮之前的操作细节很难回溯。
Magpie 的“使用 / 会话”面板会把经过网关的交互完整保留下来。
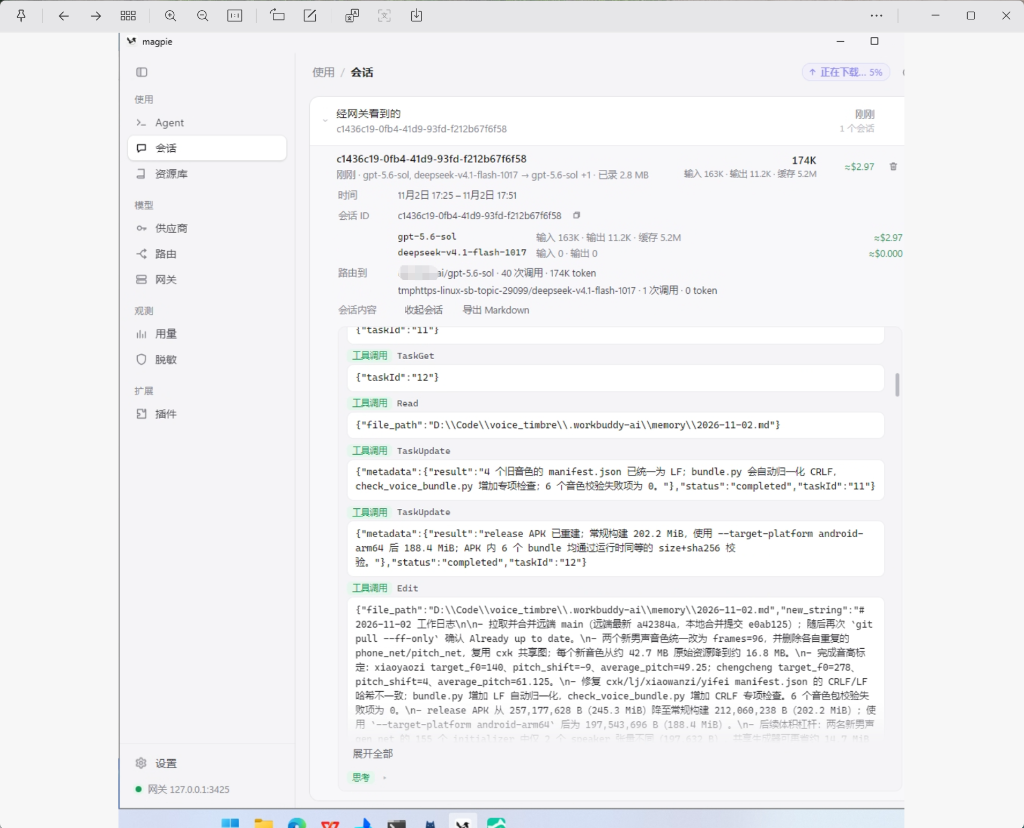
每次交互调用了哪个模型、输入输出 Token 有多少、折合多少美元,都一目了然。
更方便的是它对 Agent 工具调用的结构化还原:
- 展开后可以看到 Agent 在后台执行的每个动作:
TaskGet、Read 读取了哪个本地文件、TaskUpdate 更新了什么状态、Edit 替换了哪段内容。
- 遇到满意的多轮执行记录,可以点击右上角的“导出 Markdown”,直接沉淀为开发日志或复盘笔记。
几个实用细节:用量调优、隐私脱敏与 GitHub 同步
除了上面的核心特性,Magpie 还有几个很戳痛点的设计。
1. 用量与上下文调优评分
在“观测 / 用量”里,Magpie 会根据你日常运行 Agent 的历史数据做画像分析。
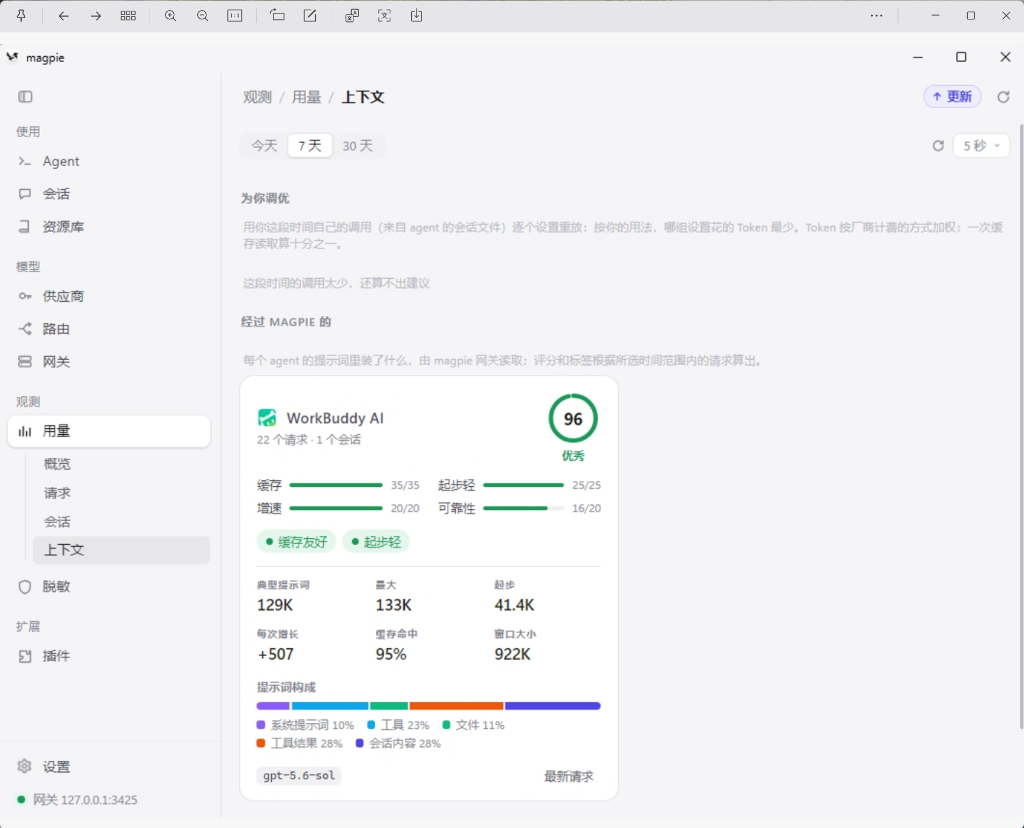
系统会从缓存利用率、起步开销、Token 增速和可靠性四个维度给 Agent 打分,并贴上“缓存友好”“起步轻”等标签。它还能利用本地会话文件做模拟重放,算出在你的使用习惯下,哪组参数配置最省 Token。
2. 本地隐私脱敏
很多人不敢放手让 Agent 读整个项目,就是担心代码里的 .env 密钥、公司内网域名或个人邮箱被发送到第三方服务。
Magpie 驻留在网络层,内置了隐私脱敏模块(在设置中开启)。请求离开本机之前,先经过本地正则过滤,把敏感信息替换掉。大模型的回复回到本机后,再把原文还原。这样既不影响代码逻辑的准确性,也能降低凭证外泄的风险。
3. 基于 GitHub 的加密多端同步
多台电脑工作的开发者,常要在台式机、笔记本和云服务器之间来回搬运 API Key、路由规则和代理配置,很烦。
Magpie 支持把配置加密备份到个人的私有 GitHub 仓库,也支持 WebDAV 和 S3 兼容存储。给它一个有权限的 GitHub Token,就能同步整套配置,换机成本很低。
总结:两款工具怎么选
说了这么多,并不是说 CC Switch 就没有价值了。
- 如果你的用法比较轻量,只是偶尔手动切换默认模型,或者希望工具越简单越好、不想在后台跑任何守护进程,CC Switch 仍然是门槛很低的轻量选择。
- 如果你和我一样重度依赖 AI 辅助编程,经常跑多轮深度的自动化 Coding 任务,受够了单点 API 突发限流导致的中断,又想了解 Agent 的耗时分布与上下文构成,那么 Magpie 代表的本地网关形态,是现阶段更成熟、体验更完整的进阶方案。
折腾工具的目的,是让自己写代码更专注,少踩一些坑。感兴趣的话可以去 GitHub 体验一下,看看它能不能解决你手头的那块绊脚石。想了解更多模型选择与技能方面的内容,也可以到云栈社区的模型与 Skill板块看看。
参考资料
- yetone/magpie GitHub 仓库:https://github.com/yetone/magpie
- Magpie 官方发布页面:https://github.com/yetone/magpie-releases
 发表于 7 小时前
|
查看: 2|
回复: 0
 /1


