引言
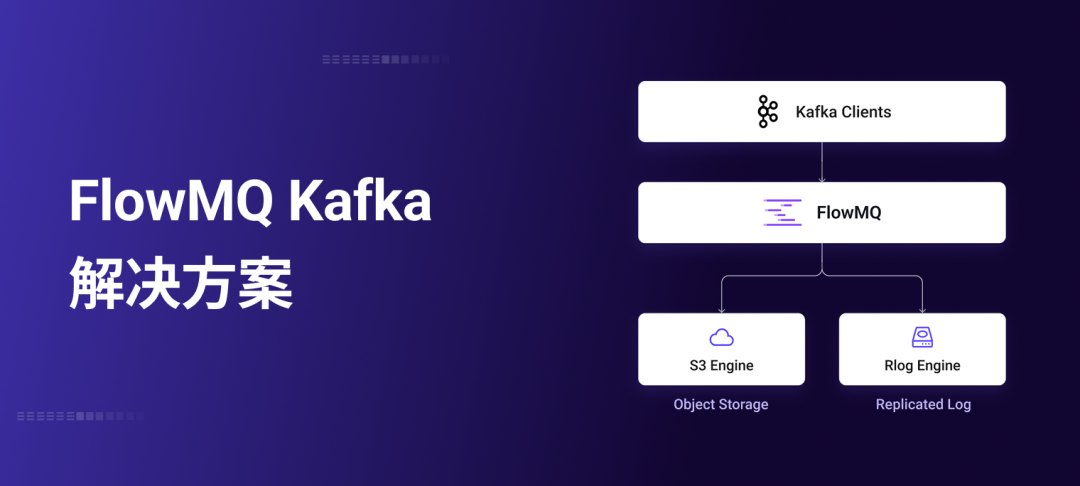
FlowMQ 是基于 C++ 从零构建的统一消息系统,面向发布/订阅、队列与流处理三种消息范式,支持 MQTT、Kafka、AMQP 和 NATS 等消息协议。
本文重点介绍 FlowMQ 的 Kafka 协议实现。FlowMQ 兼容标准 Kafka 协议,提供 S3 和 RLog 两种存储后端,分别面向云环境的低成本存储和本地场景的低延迟存储。
Apache Kafka 面临的问题
随着 Kafka 承载的数据量和业务吞吐持续增长,团队不仅需要应对容量与性能压力,还要控制存储和运维成本。在数据规模较大的场景下,传统存储架构在成本控制、集群扩容和资源利用方面逐渐显现出局限。
- 计算与存储紧密耦合:在 Apache Kafka 的本地日志架构中,Partition 是有序流数据的存储单元,其副本分布在指定的 Broker 上。Broker 既负责处理请求,也承担对应副本的日志存储,使计算资源、磁盘容量和数据副本位置紧密绑定。
- 存储与网络成本持续增长:Kafka 通过多副本保障数据可靠性,但每个副本都需要占用独立的块存储空间。在多 AZ 部署中,副本间的日志复制还会产生跨可用区网络流量。随着数据吞吐和保留时间增加,存储与网络成本也随之攀升。
- 扩容伴随数据迁移:新增 Broker 并不会自动分担已有 Partition 的数据负载。团队通常需要通过 Partition Reassignment,将现有副本迁移到新节点。迁移期间,数据复制会与在线读写争用磁盘和网络资源;数据规模越大,迁移耗时和对业务的潜在影响也越明显。
- 容量与负载难以均衡:每个副本受所在 Broker 的磁盘容量约束,大 Partition 容易造成节点间资源分布不均。即使集群整体仍有可用容量,个别节点也可能率先遭遇磁盘空间或网络带宽瓶颈,限制集群的实际承载能力。
因此,Kafka 扩容不仅意味着增加计算和存储资源,还涉及副本重新分配、数据迁移及持续的运维管理。随着业务规模扩大,数据搬迁和资源规划会反复发生,进一步增加系统扩展的复杂度与总体成本。
FlowMQ Kafka 解决方案
方案架构
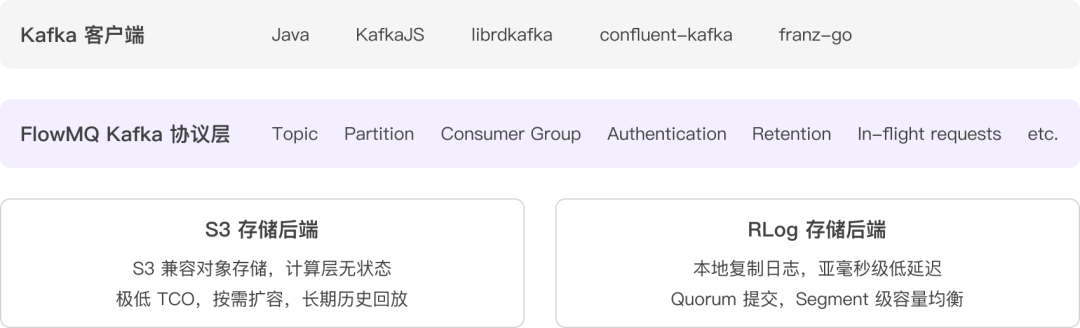
FlowMQ Kafka 采用计算存储分离的架构。Kafka 协议层支持标准 Kafka 协议,兼容 Kafka 客户端以及 Topic、Partition、Consumer Group、认证、保留策略等标准功能,以支持现有业务迁移。存储层由 S3 或 RLog 承载数据,计算层和存储层可按需各自扩容。
FlowMQ Kafka-S3:云上低成本部署
FlowMQ Kafka 的 S3 后端以 S3 兼容对象存储承载数据,其降低云上部署成本的关键因素包括:
- 在相同存储量下,对象存储服务相较于自部署的多副本 Kafka 存储有明显的价格优势。
- 对象存储服务按使用量计费,而自部署 Kafka 需要提前分配存储容量。
- 在跨 AZ 部署中,FlowMQ 直接读写对象存储服务,避免了副本间的跨 AZ 数据复制成本。
以 AWS、1 GB/s 吞吐、多 AZ 部署的月度基础设施成本为例,Apache Kafka 为 286,636 美元/月,FlowMQ S3 为 18,138 美元/月。实际成本取决于存储量、吞吐量、部署方式和云服务定价,读者可根据目标需求在不同云提供商上进行比较。
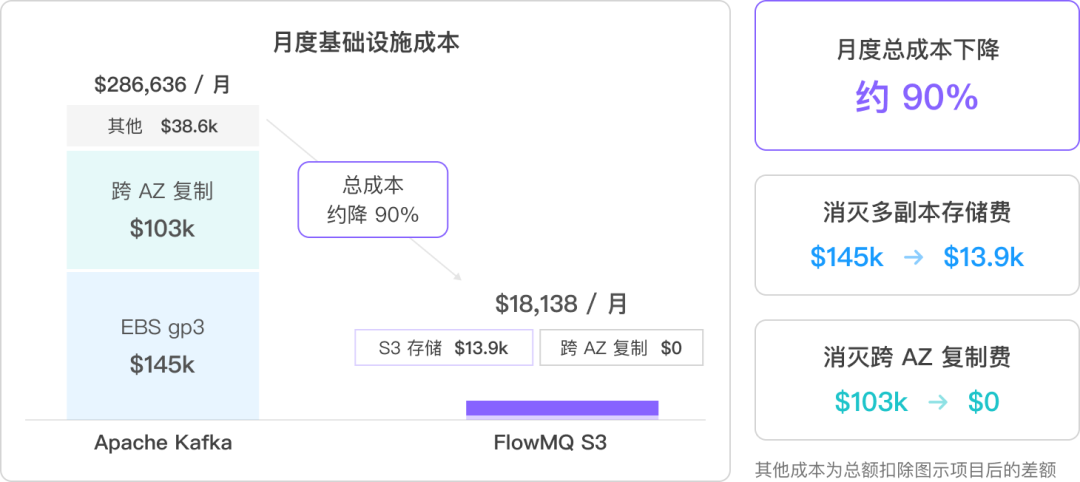
与此同时,FlowMQ Kafka S3 的计算层完全无状态。扩容或缩容时,只需加入或减少计算节点,即可按业务需求调整计算资源,而不需要像自部署 Apache Kafka 集群一样提前计算和分配高规格计算存储节点。
FlowMQ Kafka-RLog:低延迟本地存储
对于需要本地私有化部署或对数据访问延迟有更高要求的场景,FlowMQ 提供 RLog 存储后端。
RLog 是 FlowMQ 自主研发的分布式 Log 存储引擎,其设计基于流数据的两个特点:
- 数据写入方向始终向后。
- 历史数据一旦写入便不再修改。
因此,RLog 将一个 Partition 的日志按序划分为多个 Segment,包括零个或多个已封存的只读 Segment 和一个活跃 Segment,并以每个 Segment 为粒度配置复制组。这样,历史数据副本可以更细粒度地分散到不同节点,容量均衡不必始终围绕整个 Partition 副本进行。
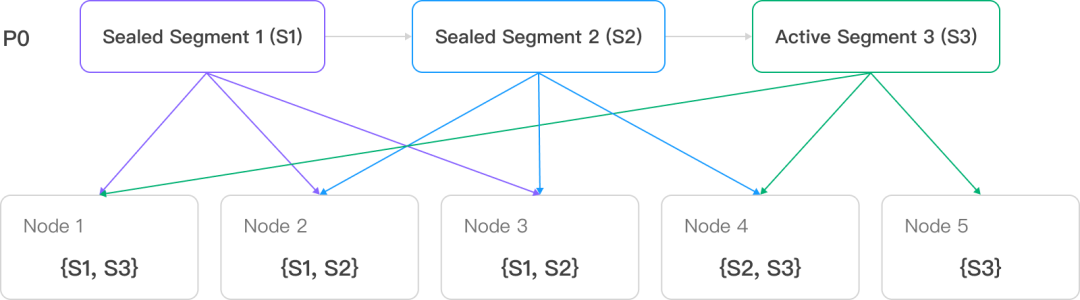
上图中,S3 为活跃 Segment,每个 Segment 均有三个副本:S1 存储于 Node 1、2、3,S2 位于 Node 2、3、4,S3 位于 Node 1、4、5。
相比 Apache Kafka,这种设计具有以下优势:
- 复制组存储粒度更小,可以更均匀地分配在不同节点上。
- 工作负载可以动态调整,而不是总聚集在固定节点上。
- 新节点加入集群时,新 Segment 可自动分配到新节点,无需手动执行 Reassignment 和复制已有数据。
- 故障发生时,封存当前活跃 Segment 并切换到新 Segment,简化复制协议,加快故障恢复。
Flexible Quorum:灵活的副本配置与故障恢复
RLog 复制协议采用 Flexible Quorum [1]。设副本总数为 $N$、最小写入副本数为 $W$、最小恢复副本数为 $R$,当复制组满足 $W + R > N$ 时,可通过写入集合与恢复集合的交集保障强一致性,而不要求两者均为多数派。
以跨两个 AZ 部署为例,可以对比 Apache Kafka(ISR)、Redpanda(Raft)和 FlowMQ Kafka-RLog 的部署与故障恢复能力:
- Apache Kafka(ISR):在四副本、每个 AZ 两个副本的部署中,配置
acks=all、min.insync.replicas=3 时,可以容忍一个节点故障。当整个 AZ 故障,只剩两个副本时,便无法满足写入门槛。如果故障 AZ 无法及时恢复,且不降低门槛,通常需要运维或自动化平台补充节点、调整副本分配。新副本必须追赶历史日志并加入 ISR,才能补齐写入条件;历史数据量大时,这一步可能涉及大量数据拷贝,恢复耗时较长。[2]
- Redpanda(Raft):Redpanda 使用 Raft 进行 Partition 数据复制,写入提交和选主都依赖多数派。采用奇数副本时,在两个 AZ 之间无法平均分布;副本较多的 AZ 故障后,剩余副本无法形成多数派,受影响分区无法正常提交写入或选主。采用四副本、每个 AZ 两副本的部署时,多数派需要三个副本,失去一个 AZ 后仅剩两个,同样无法形成多数派,强一致读写服务及正常选主、成员变更恢复无法继续。单纯启用空白备用节点,也不能绕过原复制组的多数派要求。Apache Kafka 的 Controller 在 KRaft 模式下也使用 Raft,因此其元数据仲裁组同样受多数派要求约束。[3]
- FlowMQ Kafka(RLog):FlowMQ Kafka-RLog 采用 4-3-2 配置,即四副本、写入需三个副本确认、恢复只需两个副本参与。单 AZ 故障后,两个存活副本仍满足 $R=2$,故障切换后的读取与日志恢复逻辑可以运行。剩余两个副本不足 $W=3$,暂时无法写入;启用备用节点或备用 AZ 后,可通过自动化为新数据选择新的复制组,恢复写入,而不必等待大规模历史数据搬迁。写入中断时间主要取决于故障切换及备用节点或备用 AZ 的启用过程。
典型应用场景
FlowMQ Kafka 的 S3 和 RLog 两种存储后端面向不同的数据存储需求,可根据业务的数据规模、访问模式、部署环境和延迟要求选择。
FlowMQ Kafka-S3:大规模写入与长期留存
适用于日志留存、用户行为埋点、IoT 设备数据上报、审计流水和监控指标等场景。这类业务通常具有持续写入、数据量大、保留周期长等特点,对单位存储成本、跨 AZ 流量成本和弹性扩缩容能力更为敏感。FlowMQ Kafka-S3 可通过对象存储降低长期数据保存成本,并支持计算节点按业务峰谷独立伸缩。
FlowMQ Kafka-RLog:低延迟与高可用业务
适用于金融交易、在线风控、实时订单、游戏消息、工业控制及私有化消息中台等场景。这类业务通常对读写延迟、服务可用性和故障恢复速度有更高要求,同时可能需要满足本地化部署需求。FlowMQ Kafka-RLog 通过细粒度 Segment 分布和 Flexible Quorum 复制机制,提升数据分布灵活性与故障恢复效率。
总结
随着业务规模和数据需求不断增长,消息系统需要在性能、成本与扩展性之间取得平衡。FlowMQ Kafka 提供 S3 和 RLog 两种存储方案,为不同规模、延迟要求和部署环境下的 Kafka 业务提供了技术选择。
参考资料
- Heidi Howard, Dahlia Malkhi, Alexander Spiegelman. Flexible Paxos: Quorum Intersection Revisited. OPODIS 2016, LIPIcs 70, 25:1–25:14, 2017. DOI: 10.4230/LIPIcs.OPODIS.2016.25. https://drops.dagstuhl.de/entities/document/10.4230/LIPIcs.OPODIS.2016.25
- Apache Kafka: Replication 与 Availability and Durability Guarantees. https://kafka.apache.org/40/design/design/#replication
- Redpanda: How Redpanda Works — Raft consensus algorithm. https://docs.redpanda.com/streaming/current/get-started/architecture/
 发表于 7 小时前
|
查看: 3|
回复: 0
 /1


