Embedding 模型是搜索引擎、推荐系统和 RAG 的幕后基石。生成式 AI 中,GPT-4o、Gemini 等已实现文本、音频、图像、视频的统一输入输出,但表征学习仍处于各模态各自为政的孤岛状态。
对此,来自蚂蚁、上交大、同济等机构联合发布了一篇重磅综述与立场论文,成为业内首篇跨越所有主流模态(文本、代码、图像、视频、音频、图、表格、时间序列),以全局视角系统性梳理全模态 Embedding 演进脉络、统一框架与未来路线图的综述报告。
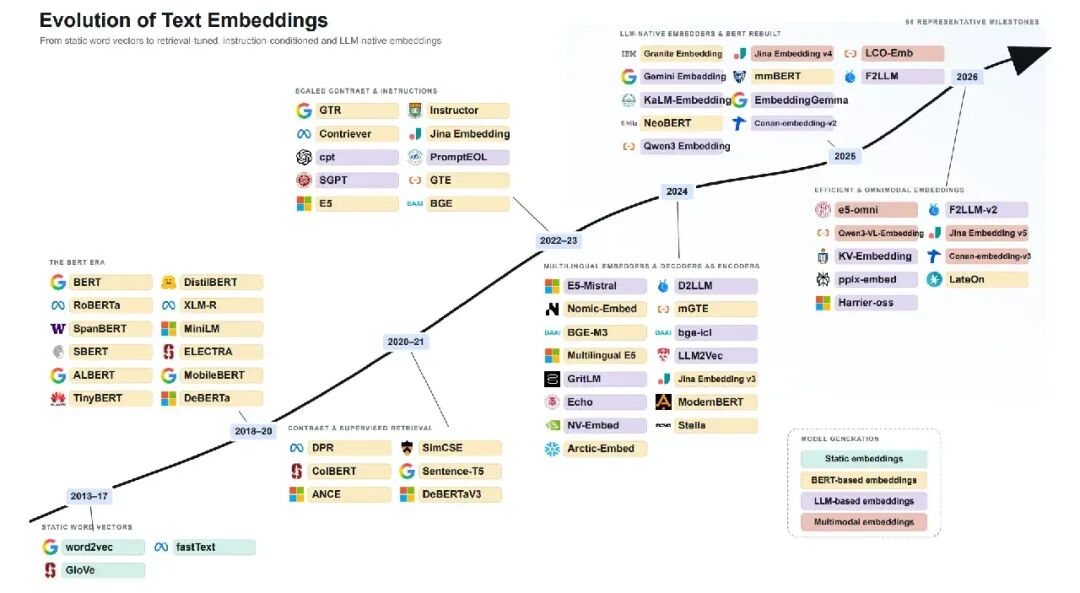
Text Embedding 进化历史
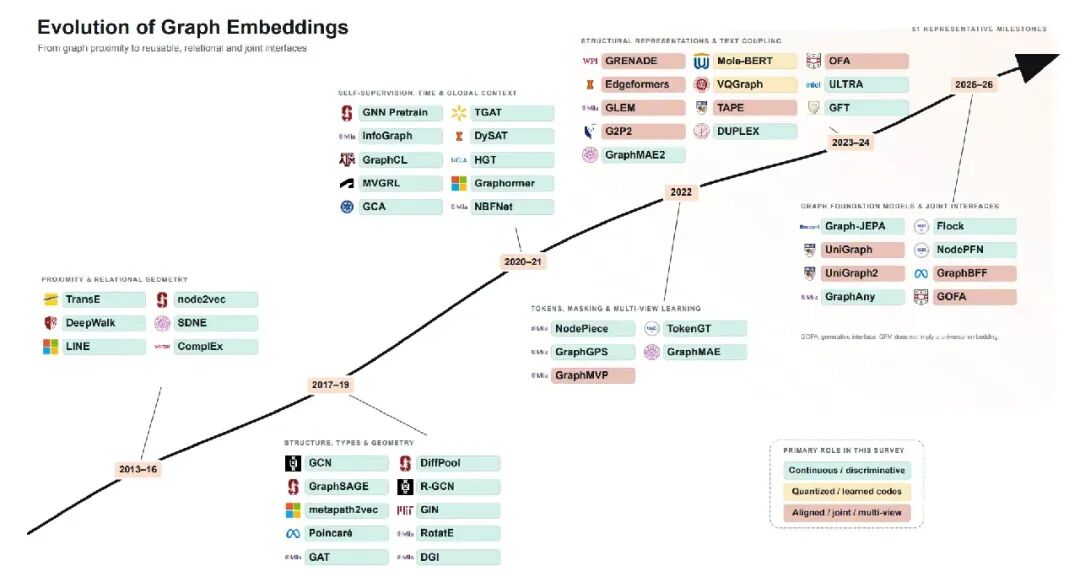
Graph Embedding 进化历史
一、大一统,先统一问题
Embedding 的本质,是把复杂数据映射成向量,让语义关系变成可计算的距离。搜索、推荐、检索增强生成,都建立在这层表示基础设施之上。
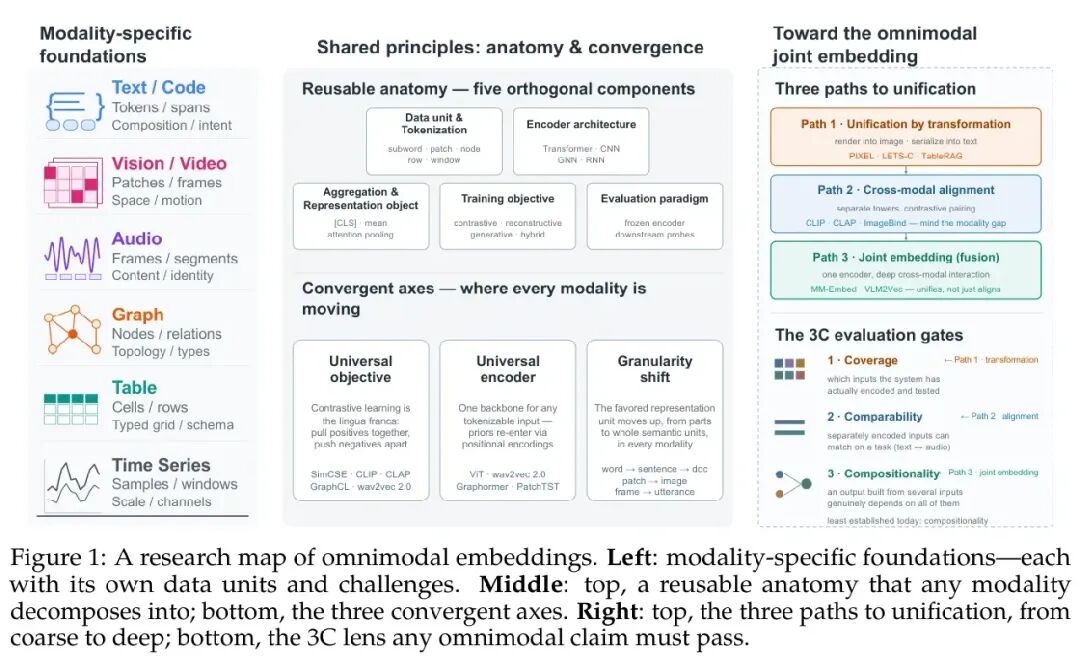
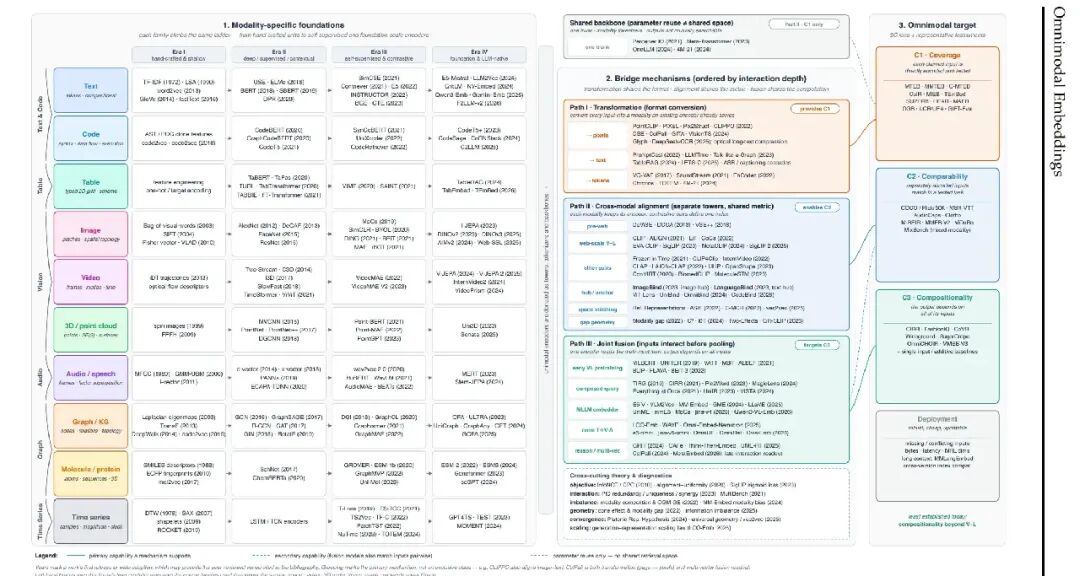
Figure 1|从模态专属基础、共同原则到联合嵌入的研究全景。
问题在于,文本、视觉、音频、图、表格和时间序列长期各有社区、方法与榜单。论文对 1352 篇正式发表论文及十年预印本的统计显示,明确跨越模态边界的工作占比不足 5%,同一种思路常常在不同领域被重复发明。
Code Embedding 进化
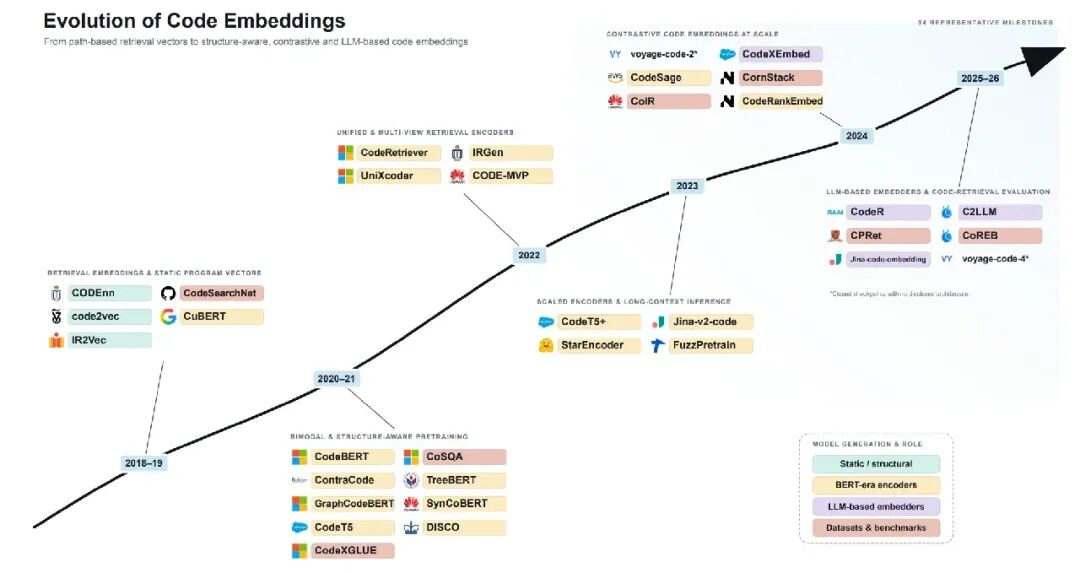
分裂之下,趋同已经发生:对比学习成为共同目标,Transformer 成为通用编码器,预训练后微调成为共同流程,表示粒度则从词元、像素等局部单元上移到完整语义单元。
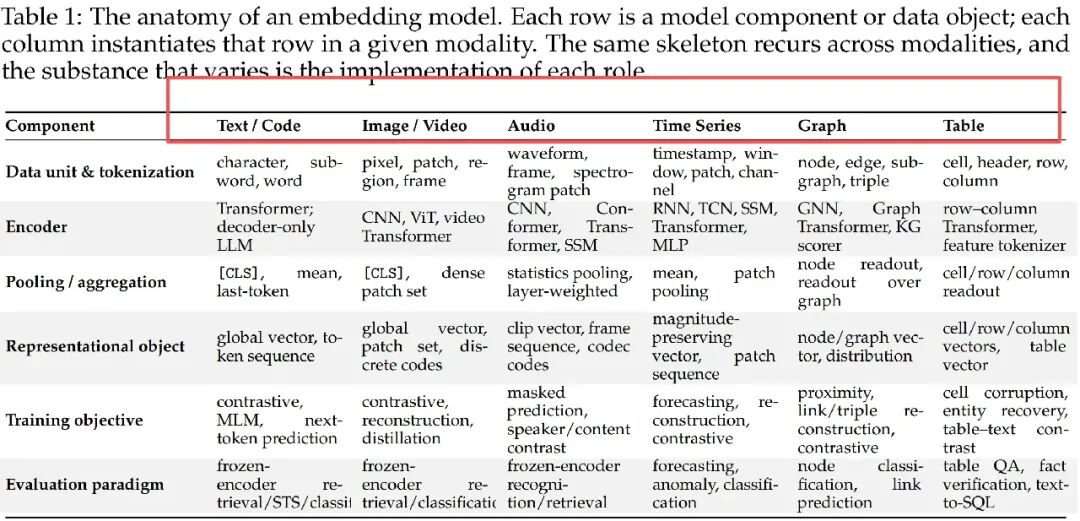
所以,统一不是抹平模态差异,而是先找到可以复用的共同骨架。
Table Embedding 进化
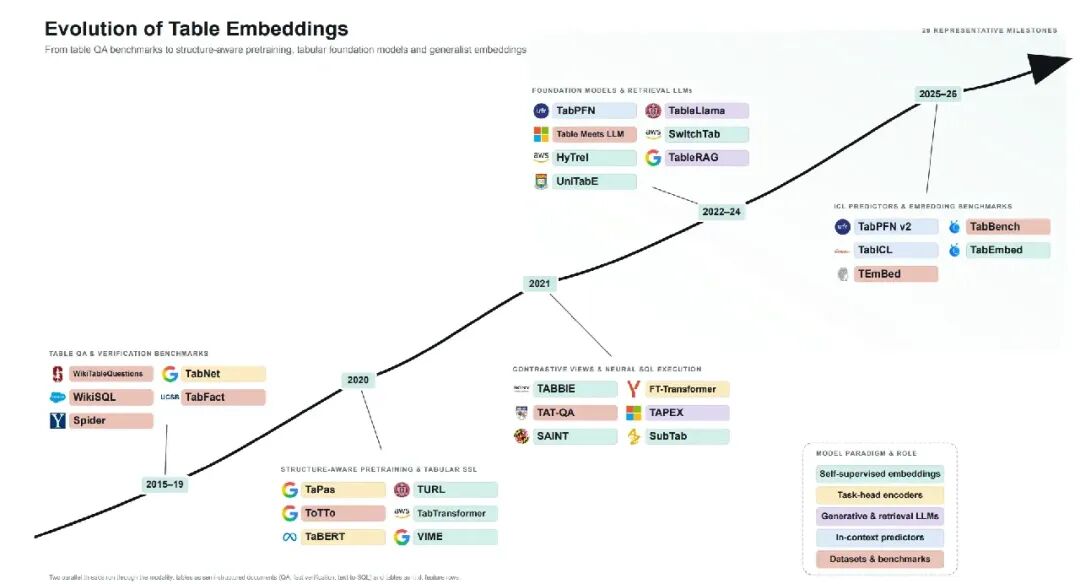
二、同一个骨架,五种关键决策
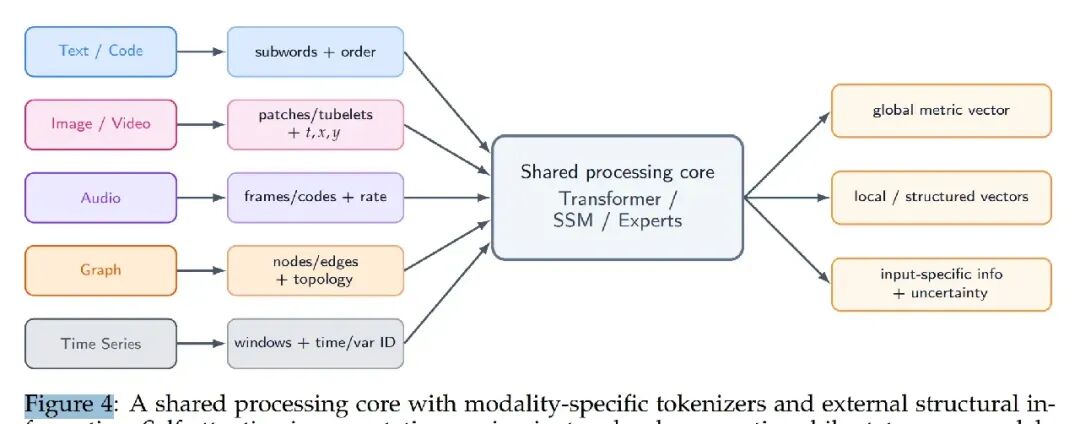
论文首先拆解 Embedding 模型:数据如何切分、编码器如何处理、结果如何聚合、目标如何塑造空间、评测如何定义好坏。输入端与输出端又被明确区分,避免把数据单位与最终表示对象混为一谈。
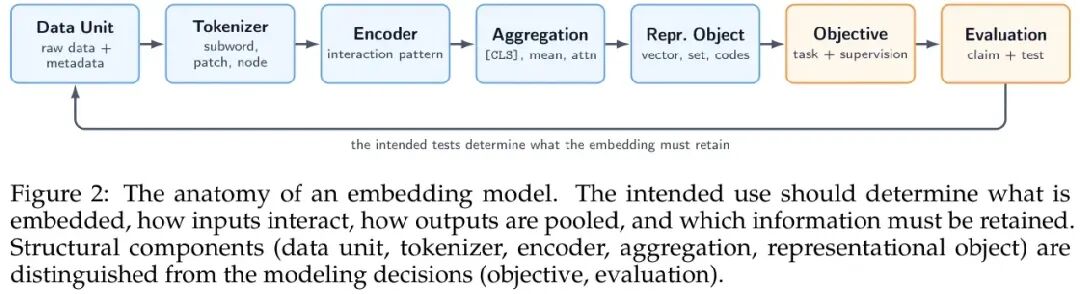
Figure 2|数据单元、切分器、编码器、聚合、表示对象,以及目标和评测之间的关系。
同一个编码器,可以输出一个全局向量,也可以输出局部向量序列或离散编码。前者便于索引,后者保留位置与对应关系。真正决定 Embedding 能做什么的,不只是骨干网络,还有接口最终保留了哪些信息。
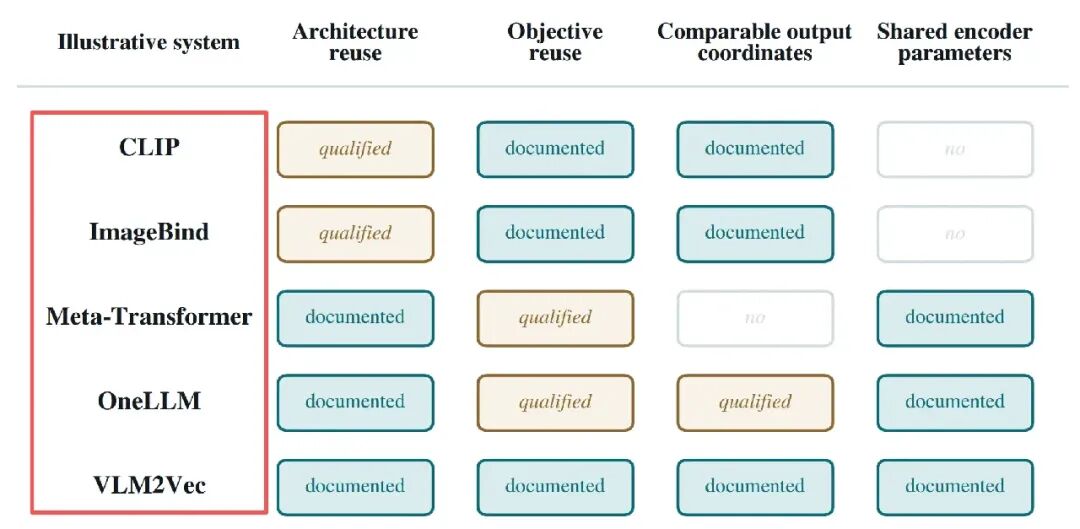
这也解释了为什么统一不能只看参数量。共享编码器不等于向量已经可比,跨模态可比也不要求共享编码器。架构复用、目标复用、坐标对齐和参数共享,是四件不同的事。
三、三条路径,不是三种并列选项
有了共同骨架,论文把通向全模态的方法整理成交互不断加深的三级台阶。
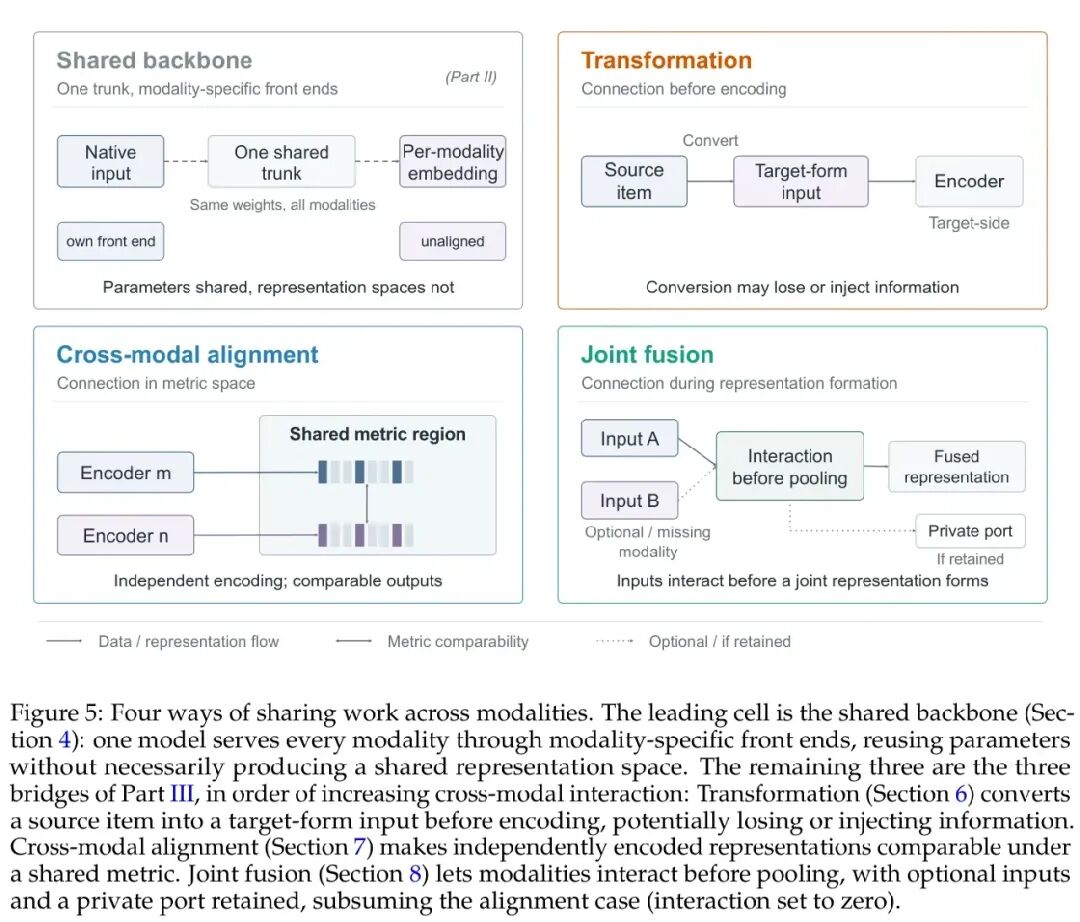
Figure 5|转换、对齐、联合融合,以及作为参数复用基线的共享骨干。
第一步是转换。 把图渲染成图片、把表格序列化成文本、把连续信号离散成词元,直接借用成熟编码器。它迅速扩大输入覆盖,却可能丢掉图的拓扑、表格的行列结构和时间序列的幅度。
第二步是对齐。 各模态保留独立编码器,再用对比学习让向量可以互相检索,CLIP、CLAP、ImageBind 都属于这条成熟路线,但输入没有在模型内部共同计算,模态间隙也仍可能存在。
第三步是联合嵌入。 不同模态在池化前通过共享注意力或交叉注意力交互,表示的对象不再只是两个向量的接近程度,而是多个输入共同表达的语义。
进一步指出,双塔对齐可以看作跨模态交互为零的联合模型。因此,联合不是废除对齐,而是把它纳入更一般的框架:需要独立建索引时分别编码,需要理解组合关系时深度交互。
四、真正的分水岭是组合性
为了阻止宽泛的全模态宣传,论文提出 3C 标尺,并要求三项能力分别举证。
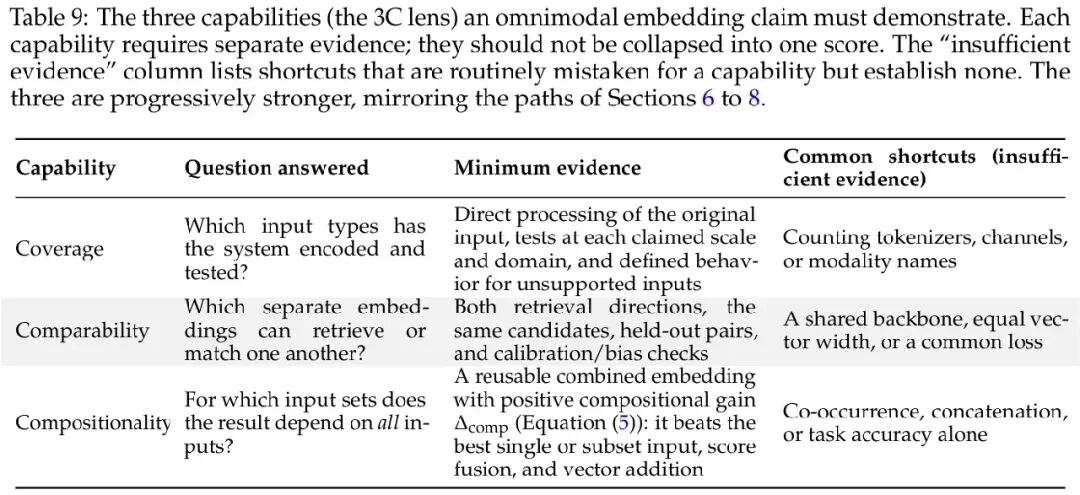
Table 9|覆盖、可比、组合三类能力,以及不足以证明能力的常见捷径。
- 覆盖 Coverage: 系统实际编码并测试了哪些输入。
- 可比 Comparability: 分别编码的输入能否按任务互相匹配,例如用文字检索音频。
- 组合 Compositionality: 多个输入共同形成查询时,输出是否真正依赖每一个输入。
共享骨干只证明参数复用,向量同维只说明形状一致,拼接输入也不等于完成融合。以图片加修改指令为例,模型必须理解两者的组合,而不是只靠图片或文字走捷径。
论文因此把组合收益设为关键判据:联合表示应超过最强单模态输入,也应超过分数融合和向量相加。否则,联合架构未必带来了新的语义能力。
这也是作者将联合嵌入视为终点的原因,同时他们把计算开销、模态竞争和单模态性能退化列为工程边界。正确方向不是让所有模态变得一样,而是保留专用切分与处理能力,再为组合而融合。
五、下一步,需要共同尺度与交叉授粉
路线图的后半段落在一个现实问题上:没有统一测量,就无法判断统一是否发生。
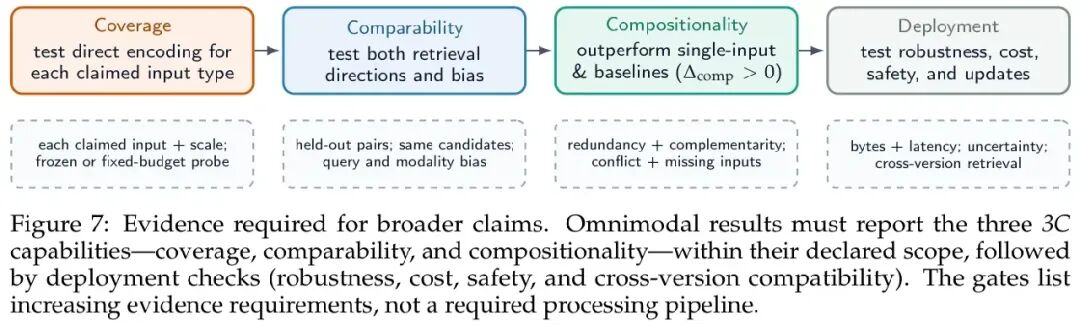
Figure 7|覆盖、可比、组合之后,还要接受部署层面的鲁棒性、成本与安全检验。
现有榜单大多能证明覆盖和两两可比,组合性仍是证据最薄弱的一环。论文主张用统一、冻结编码器、弱任务头的协议,把单模态、跨模态和多输入任务放在一起,并单独报告组合收益。
与此同时,各社区不必重复造轮子。文本的指令调优可以迁移到音频和时间序列,时间序列的连续时间建模可以反哺视频与动态图。统一骨架保留模态特性,成熟方法跨领域复用,才是这篇综述给出的建设路径。
它画出的不是一个已经完成的全模态模型,而是一套可检验的共同语言:接收什么、比较什么、如何组合。三层问题被逐一回答,Embedding 才能从输入齐全走向语义真正统一。
https://arxiv.org/abs/2611.00172
https://github.com/codefuse-ai/Awesome-Omnimodal-Embeddings

From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
值得一提的是,这套全模态 Embedding 思路在落地时,如何把编码统一与工程部署衔接好,不同模态的切分策略与检索成本如何平衡,仍是后续不可回避的硬问题。对这块感兴趣的读者,也可以通过云栈社区的技术讨论继续深入交流。
 发表于 昨天 19:19
|
查看: 1|
回复: 0
 /1


