一、为什么需要运维 Agent?
运维的本质矛盾从未改变:系统复杂度持续增长,而人的处理能力是恒定的。
平均每名值班工程师每周收到约 50 条告警,其中仅 2-5% 真正需要人为干预。70% 的 SRE 团队将告警疲劳列为前三运营问题。(数据来源:PagerDuty)
以最常见的“用户反馈支付卡顿”为例,运维的排查流程是固定的:

这个流程里每一步都是确定性操作——查指标、查链路、查日志、对比基准值。人类运维做的是“串联工具 + 模式匹配”,这正是 Agent 的强项。
二、全网谁在生产跑?
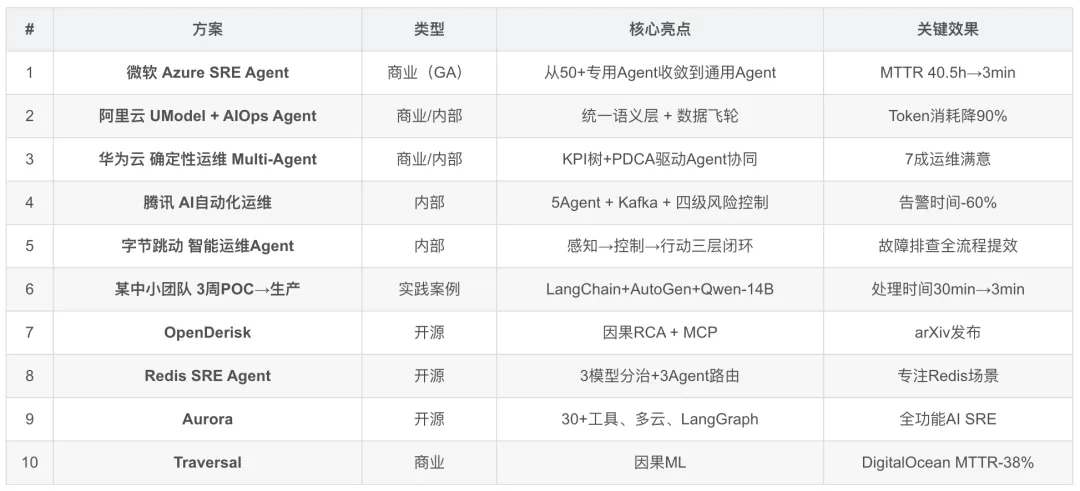
经过对 2024-2026 年公开资料的全面梳理,已确认 10 个方案处于生产验证状态:
行业共识:10 条铁律
从这些案例中提炼出的共同原则:
- Prompt 负责理解,代码负责执行 — LLM 不直接操作生产系统
- 所有写操作必须幂等 — 用幂等键防重复执行
- 分级安全控制 — 读自动 / 可逆写自动 / 不可逆需确认 / 关键需审批
- 从 1 个场景开始 — 别想一步到位做全能 Agent
- 能力边界要明确 — 超边界优雅转人工
- 全链路监控 — 每个工具调用必须可审计
- 工具层隔离 — LLM 请求工具 → Agent 安全执行
- 向量知识库 — 历史案例 RAG 检索
- 长期 Agent 通用化 — 微软从 50+ 专用收敛到通用验证了这点
- 数据飞轮 — 采集 Trace 反哺模型进化
三、两大架构路线深度对比
3.1 MCP 直连方案
LLM (Claude/GPT/Qwen)
   │  Function Calling 决定调哪个工具
   ├── MCP: Prometheus (PromQL查询)
   ├── MCP: SkyWalking (GraphQL查询)
   ├── MCP: SLS (日志检索)
   └── MCP: GitLab (代码搜索)
   │
   ▼ LLM直接消费原始返回数据,逐步推理
特点:每个 MCP Server 独立封装一个运维系统的 API。LLM 通过 Function Calling 决定调用哪个、传什么参数,拿到原始结果后自行推理。
3.2 UModel 语义层方案
LLM (Claude/GPT/Qwen)
   │ 语义查询(自然语言 or 结构化查询)
   ▼
UModel 统一语义层 (Node+Link有向图)
   │ 算子下推:聚合/异常检测在数据端执行
   ├── Prometheus
   ├── SkyWalking
   ├── SLS
   └── 变更系统
   │
   ▼
LLM拿到结构化摘要,直接推理
特点:UModel 是所有运维数据的统一建模层。Agent 不需要逐个系统查询——UModel 内部已经做了预聚合和跨系统关联,LLM 只需要问一次就能拿到结论。
3.3 核心差异
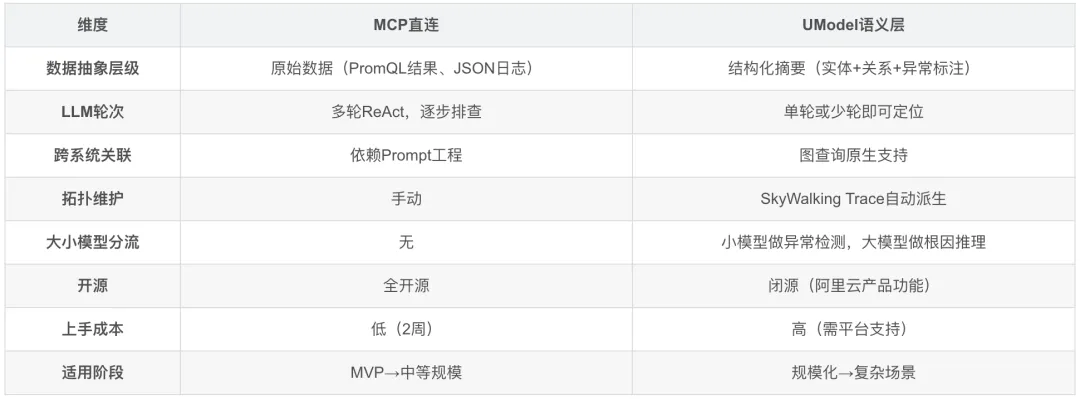
为什么会有 UModel?不是 MCP 方案做不到,而是当系统规模变大后(50+ 服务,10+ 运维系统),MCP 直连的 Token 消耗和多轮推理成本会急剧上升。UModel 通过“数据预聚合 + 大小模型分流”把综合成本压到原来的 10%。
四、ReAct 的正确用法:诊断用循环,执行有边界
运维场景里,ReAct 不能到处用。调查阶段可以用循环,执行阶段只能走一次且必须人工审批。
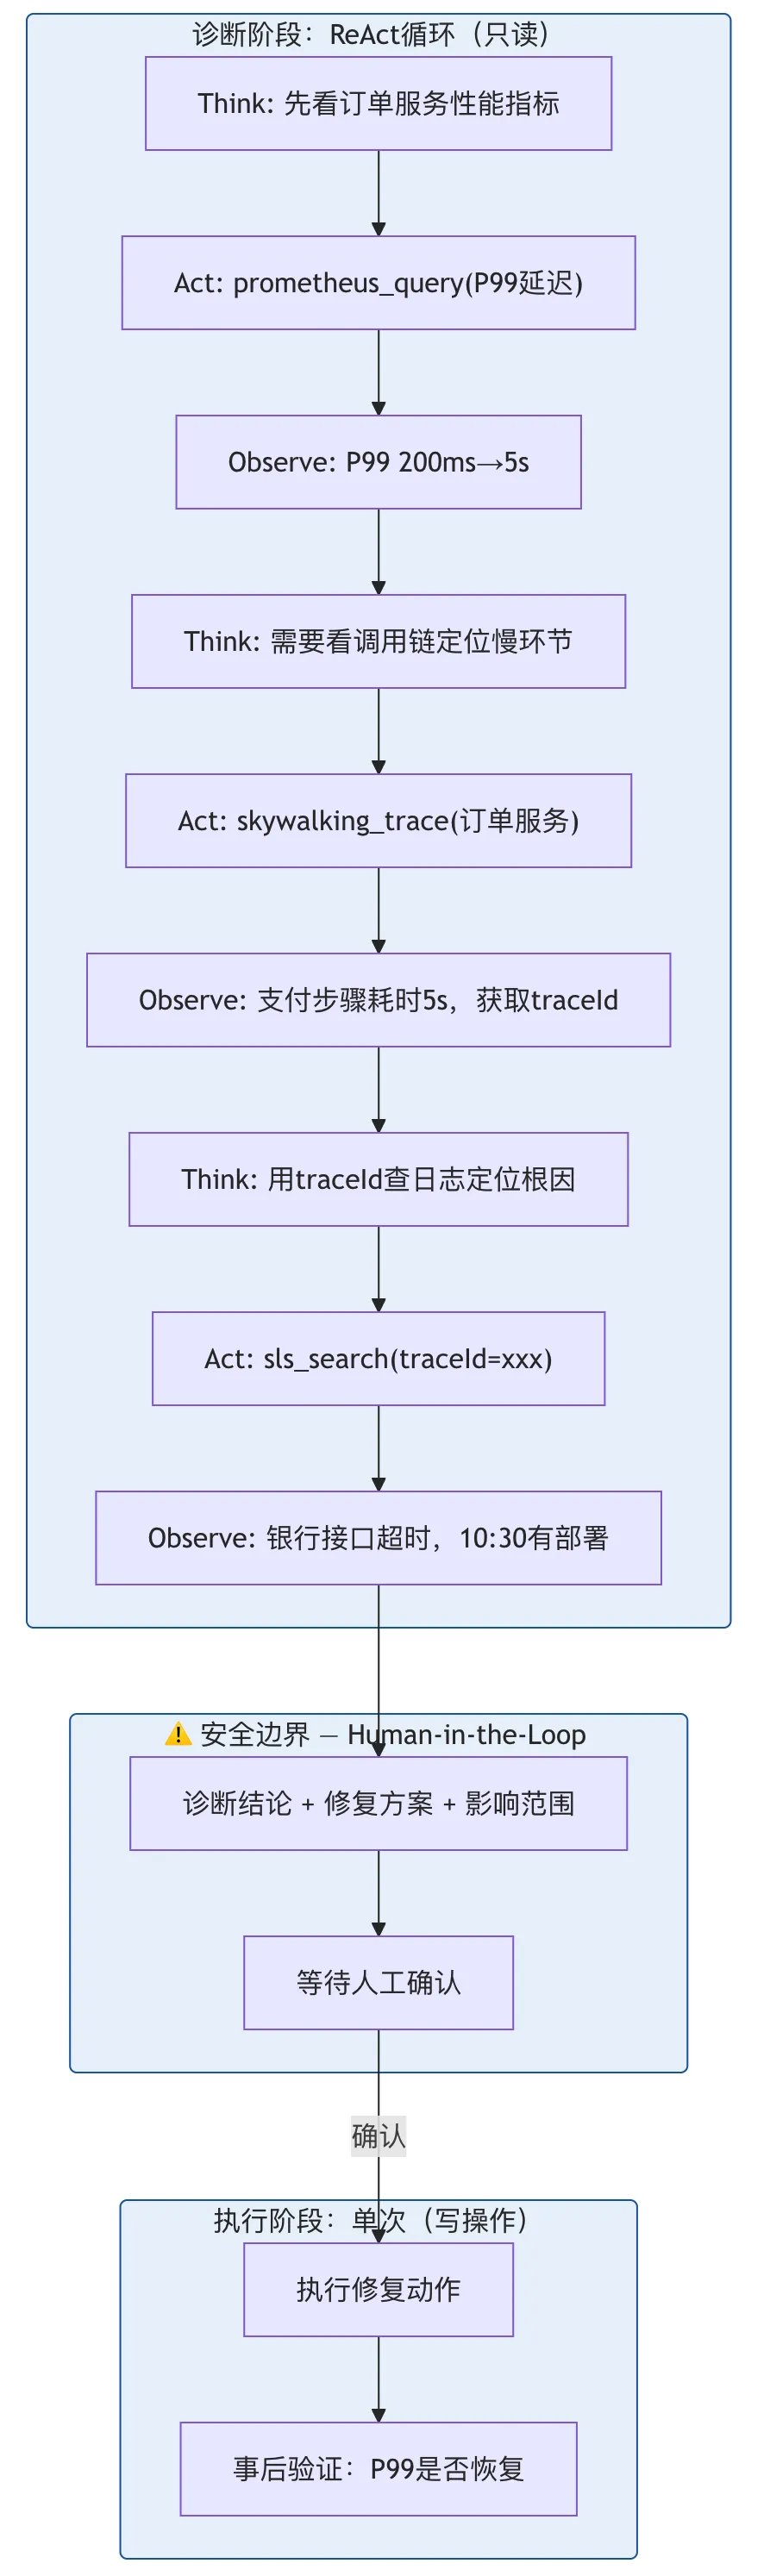
不存在“执行完再去看指标不对再调整”,那是生产事故的配方。ReAct 循环只发生在调查阶段,一到执行写操作就必须人工卡点。
workflow = StateGraph(InvestigationState)

# 调查节点内部跑 ReAct,所有工具调用只读
workflow.add_node("investigate", investigate)

# 人工审批节点:LangGraph中断点,等人工确认
workflow.add_node("human_approval", human_approval)

# 执行节点:只有人工确认后才走到这里
workflow.add_conditional_edges(
    "human_approval",
    lambda s: "execute" if s["human_approved"] else END
)
五、记忆管理:Markdown vs 向量数据库,不是二选一
5.1 Claude Code 的启示
Claude Code 的记忆系统完全基于 Markdown 文件:
~/.claude/projects/<project>/memory/
├── MEMORY.md          # 索引,每次会话加载前200行
├── debugging.md       # 主题文件,按需读取
└── api-conventions.md

项目目录:
├── CLAUDE.md          # 项目指令,每次会话完整加载
└── .claude/skills/    # Skill文件夹
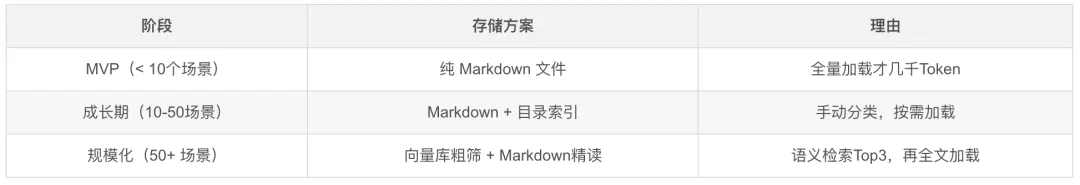
为什么不用向量数据库?因为它面向代码项目,知识规模可控(几十个文件)。全量加载索引也就几千 Token。
那运维场景能用吗?初期也能用。场景少的时候,Markdown 文件简单直接、人类可维护、不需要额外基础设施。
5.2 运维 Agent 的三层记忆架构
随着场景增多,推荐混合方案:
┌────────────────────────────────────────────┐
│  L1: 短期记忆 (Working Memory)              │
│  当前诊断会话内的上下文                        │
│  存储:LangGraph State / 内存               │
├────────────────────────────────────────────┤
│  L2: 长期记忆 (Episodic Memory)             │
│  历史诊断案例:当时怎么解决的?                 │
│  存储:向量数据库(语义检索Top3相似案例)        │
├────────────────────────────────────────────┤
│  L3: 知识库 (Semantic Memory / Runbook)     │
│  标准化排查流程:支付超时怎么办?              │
│  存储:Markdown文件(结构化、可读、可维护)    │
└────────────────────────────────────────────┘
5.3 演进路径
5.4 标准化流程即 Skill
参考 Claude Code 的 Skill 机制,运维 Agent 的排查流程完全可以按同样方式组织:
knowledge/runbooks/
  ├── payment-timeout.md      # 支付超时排查手册
  ├── oom-kill.md             # OOM Kill排查手册
  ├── deploy-rollback.md      # 部署回滚流程
  └── ...

每个Runbook的结构:
   1. YAML元数据(触发条件、适用服务、风险等级)
   2. Markdown正文(分步骤,每步关联具体Tool Call)
LLM 先看到所有 Runbook 的元数据(触发条件 + 描述),语义匹配最合适的那个,再加载完整文件指导工具调用——与 Claude Code Skill 的运作方式完全一致。
六、算子下推:计算在数据端,LLM 只拿结论
“算子下推”这个概念来自数据库领域,在 UModel 中借用到可观测场景。
不下推的做法
Agent需要判断"订单服务是否异常"
   → 查Prometheus,返回过去1小时所有订单服务的10000条指标
   → 传到Agent本地
   → Agent用Python计算P99聚合
   → LLM判断是否超过阈值
本质:把计算推到数据所在的地方执行,只传结果回来。
用采矿类比:
不下推:把10吨矿石运到冶炼厂 → 冶炼 → 得到1克金
下推:  在矿场就地冶炼 → 只运1克金到冶炼厂
UModel 中的三层分流
这才是“Token 消耗降 90%”的真正来源——不是单次上下文变短了,而是综合轮次减少 + 确定性任务由小模型处理 + LLM 只做复杂推理。
七、从零落地的技术选型
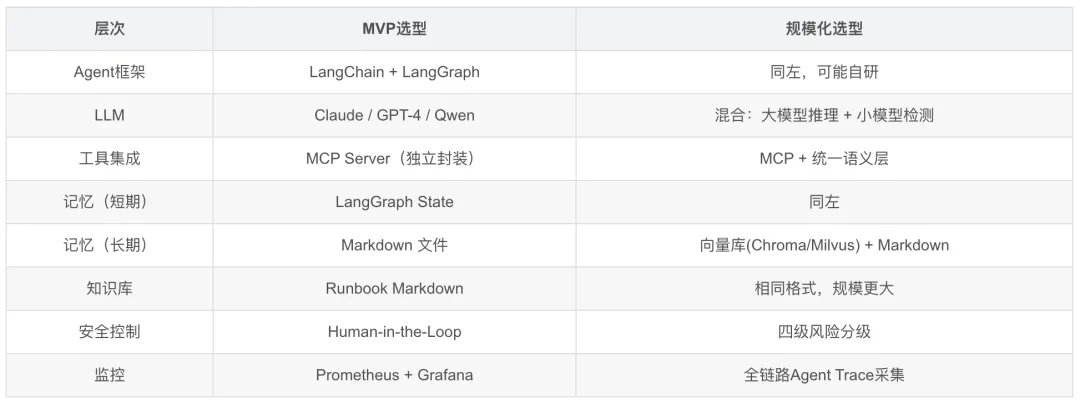
7.1 推荐技术栈
7.2 MCP Server 封装示例
# mcp-server-prometheus/server.py
from mcp.server import Server
from mcp.types import Tool

server = Server("prometheus-mcp")

@server.list_tools()
async def list_tools():
    return [
        Tool(
            name="prometheus_query",
            description="执行PromQL即时查询。用于获取服务当前性能指标如P99延迟、QPS、错误率等",
            inputSchema={
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "PromQL查询语句"}
                }
            }
        ),
        Tool(
            name="prometheus_range_query",
            description="执行PromQL范围查询。用于获取过去一段时间内的时序数据,帮助判断异常何时开始",
            inputSchema={
                "type": "object",
                "properties": {
                    "query": {"type": "string"},
                    "start": {"type": "string"},
                    "end": {"type": "string"},
                    "step": {"type": "string"}
                }
            }
        )
    ]

@server.call_tool()
async def call_tool(name: str, arguments: dict):
    if name == "prometheus_query":
        response = requests.get(
            f"{PROMETHEUS_URL}/api/v1/query",
            params={"query": arguments["query"]}
        )
        return response.json()
7.3 Runbook Markdown 示例
---
trigger: "用户报事支付卡顿"
services: ["order-service", "payment-service"]
risk_level: "MEDIUM"
tools: ["prometheus_query", "skywalking_trace", "sls_search"]
---
# 支付超时排查手册

## Step 1: 确认异常范围
**工具**: `prometheus_query`
**查询**: `histogram_quantile(0.99, rate(http_request_duration_seconds_bucket{service="order-service"}[5m]))`
**判断标准**: P99 > 2s → 继续 Step 2

## Step 2: 定位慢调用环节
**工具**: `skywalking_trace`
**操作**: 获取 order-service 的慢调用 Trace
**判断标准**: 哪个 span 耗时 > 2s → 记录其 traceId → 继续 Step 3

## Step 3: 深入排查日志
**工具**: `sls_search`
**查询**: `traceId: {上一步获取} AND level: ERROR`
**判断标准**:
- 发现超时日志 → 下游服务问题 → 查下游服务最近部署
- 无超时日志 → 检查代码逻辑 → 继续 Step 4

## 常见根因速查
| 根因 | 出现频率 | 修复动作 | 预计恢复 |
|------|---------|---------|---------|
| 银行接口超时 | 40% | 启用熔断 + 通知对方 | 10min |
| 数据库慢查询 | 30% | 索引优化 | 30min |
| 网关超时配置 | 15% | 调整参数 | 5min |
 发表于 7 小时前
|
查看: 2|
回复: 0
 /1


