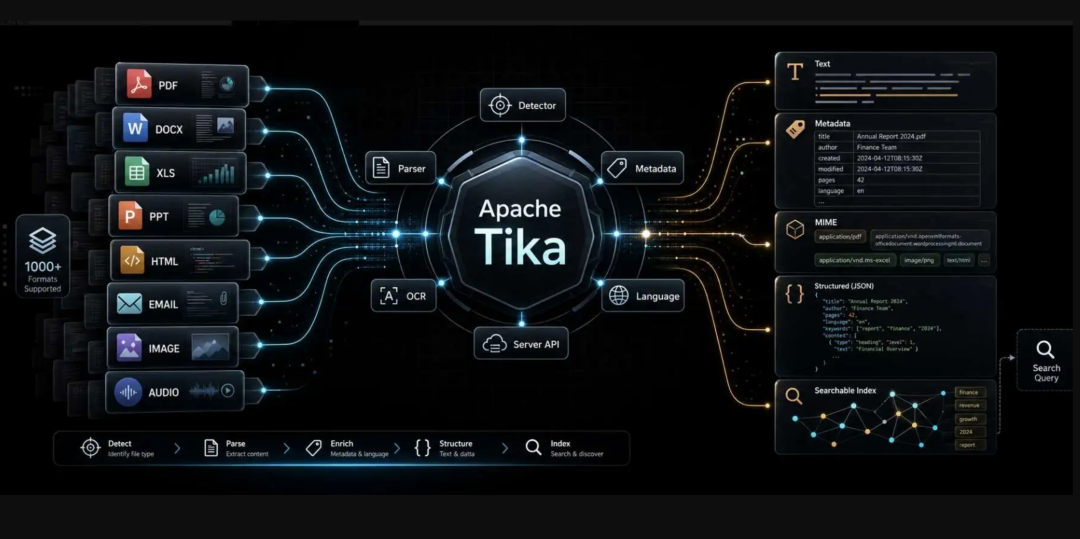
这两年做企业知识库、全文检索和 RAG,最常碰到的脏活不是算法,而是读取文件。PDF 用 PDFBox,Word 和 Excel 用 POI,邮件换另一套解析器,再叠加压缩包、旧版 Office、EPUB、PST,依赖列表很快就堆成一副麻将。Apache Tika 要解决的正是这件事:给不同文件格式提供一个统一入口。
Tika 到底是什么
Tika 是 Apache 基金会旗下的文档检测与内容提取工具,能识别上千种文件类型,并提取 PDF、Office、邮件、网页、图片、音视频等文件中的正文和元数据。它的项目仓库和格式清单都可以在官方页面找到。
不过 Tika 并没有自己重写所有解析器,它更像一个调度层:
- PDF 交给 PDFBox;
- Office 文件交给 Apache POI;
- HTML 交给 Jsoup;
- 压缩文件交给 Commons Compress;
- 图片 OCR 可以调用 Tesseract。
开发者不用先判断文件类型再手动选择解析库。把文件交给 Tika,它会检测 MIME 类型,然后调用合适的 Parser。官方格式清单也特别提醒:能识别的格式,比能完整提取正文的格式更多。
一份文件是怎么被处理的
Tika 的核心链路并不复杂:
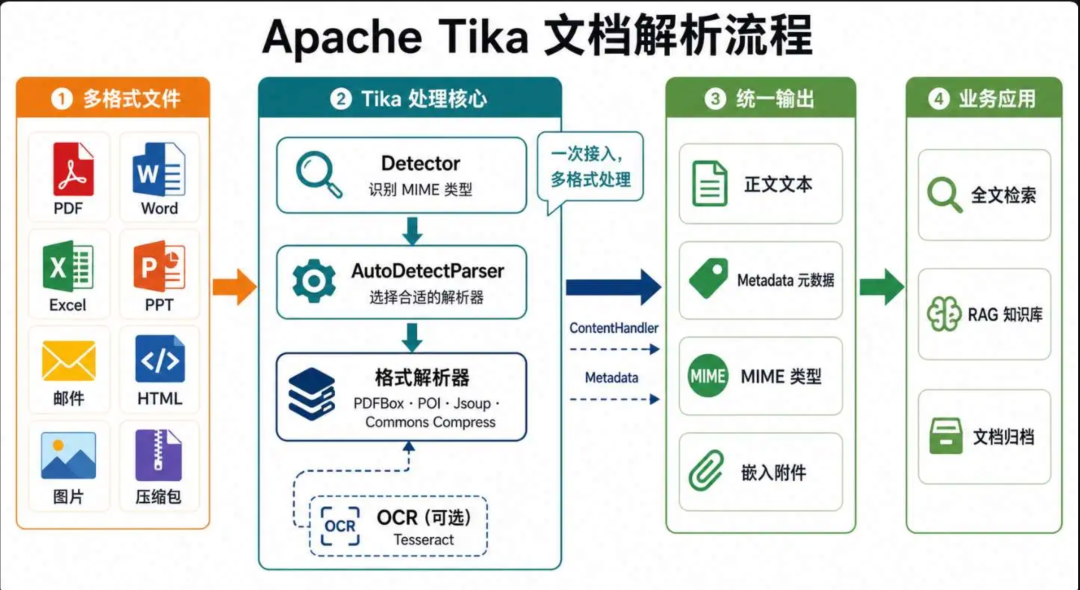
- 文件或输入流
- Detector 识别 MIME 类型
- AutoDetectParser 选择解析器
- PDFBox / POI / Jsoup 等组件解析
- ContentHandler 接收正文
- Metadata 保存标题、作者、类型等信息
真正好用的是 AutoDetectParser。上传文件没有扩展名,或者有人把 exe 改成 pdf,它不会只相信文件名,而是结合内容特征和元数据判断格式。
不过 MIME 检测不能当安全检查使用。伪造文件、多格式混合文件仍然可能绕过简单判断。
Java 项目接入示例
目前官方稳定版是 3.3.2,生产项目建议先用稳定线,不要直接追 4.x 预览版。依赖可以从官方下载页获取。
Maven 添加依赖:
<dependency>
  <groupId>org.apache.tika</groupId>
  <artifactId>tika-core</artifactId>
  <version>3.3.2</version>
</dependency>

<dependency>
  <groupId>org.apache.tika</groupId>
  <artifactId>tika-parsers-standard-package</artifactId>
  <version>3.3.2</version>
</dependency>
下面这段代码可以识别文件类型,同时提取标题和正文:
import java.nio.file.Path;

import org.apache.tika.exception.WriteLimitReachedException;
import org.apache.tika.io.TikaInputStream;
import org.apache.tika.metadata.Metadata;
import org.apache.tika.metadata.TikaCoreProperties;
import org.apache.tika.parser.AutoDetectParser;
import org.apache.tika.parser.ParseContext;
import org.apache.tika.sax.BodyContentHandler;
import org.xml.sax.SAXException;

public class TikaDemo {

    public static void main(String[] args) throws Exception {
        Path file = Path.of(args[0]);

        AutoDetectParser parser = new AutoDetectParser();
        Metadata metadata = new Metadata();

        // 最多提取 20 万字符,避免大文件撑爆内存
        BodyContentHandler handler = new BodyContentHandler(200_000);

        try (TikaInputStream input = TikaInputStream.get(file, metadata)) {
            try {
                parser.parse(input, handler, metadata, new ParseContext());
            } catch (SAXException e) {
                if (!WriteLimitReachedException.isWriteLimitReached(e)) {
                    throw e;
                }
            }
        }

        System.out.println("文件类型:" + metadata.get("Content-Type"));
        System.out.println("标题:" + metadata.get(TikaCoreProperties.TITLE));
        System.out.println("正文:\n" + handler);
    }
}
运行时传入文件路径:
java TikaDemo.java contract.pdf
同一段代码换成 DOCX、PPTX 或 HTML 仍然可以工作,不需要在业务代码里写一串 if-else。
它为什么又被关注起来
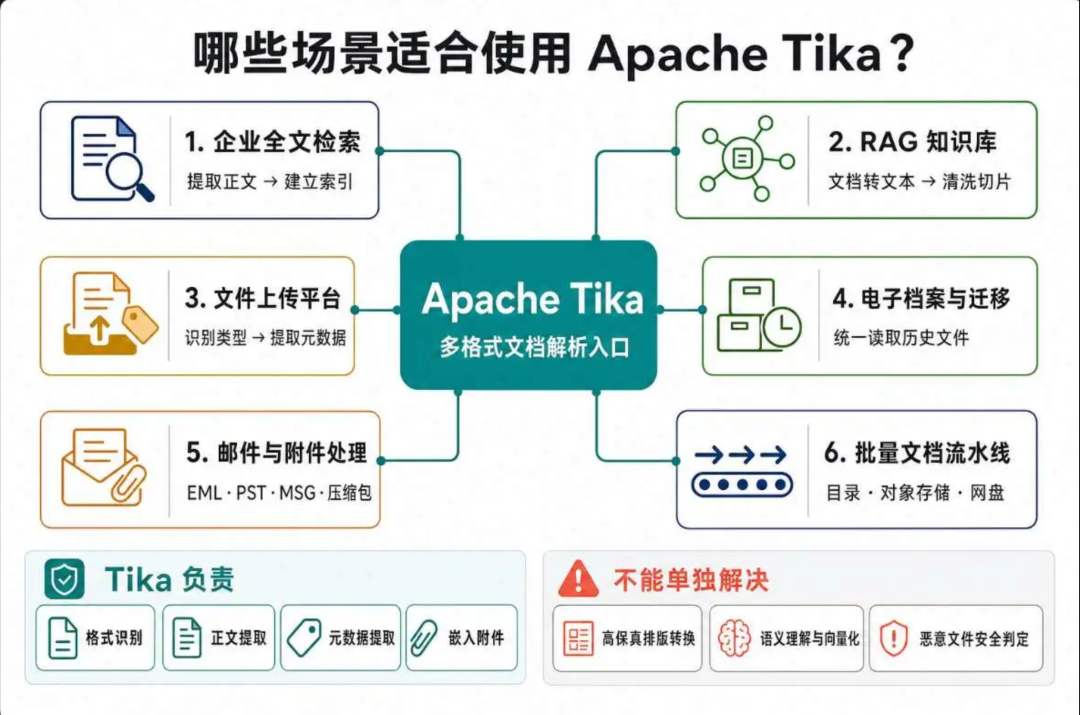
Tika 并不是新项目,但现在很多场景重新需要它:
企业搜索
文件先经过 Tika 提取正文和元数据,再写入 Elasticsearch、OpenSearch 或 Solr。搜索系统不必分别理解 PDF 和 Office 格式。
RAG 知识库
在 RAG 知识库 场景中,大模型不能直接读取原始二进制文件。通常要先提取文字、清洗内容、分段,再生成向量。Tika 适合做最前面的文件解析入口,但后面的表格恢复、切片和语义处理仍要自己完成。
文件上传平台
上传后识别真实类型,提取标题、作者、页数等信息,用于归档和检索。
历史资料迁移
老系统里可能混着 DOC、PST、RTF、压缩包和各种旧格式。Tika 的价值不是某一种格式解析得最精细,而是能先把大部分文件统一接进处理流水线。
如果系统不是 Java,也可以把 tika-server 单独部署,通过 REST 接口调用。官方当前甚至更推荐把 Tika 作为独立服务运行,让解析进程与主业务隔离。Java API 指南可参考官方文档。
上生产前要注意什么
首先,tika-parsers-standard-package 会引入不少传递依赖。老项目接入前最好执行一次 mvn dependency:tree,重点检查 POI、PDFBox、Jackson 等组件有没有版本冲突。
其次,解析陌生文件本身就有风险。恶意文件可能造成死循环、内存耗尽,甚至利用底层解析库的漏洞。官方明确表示 Tika 不是安全边界,建议使用独立进程、超时、内存限制和最低权限运行;tika-server 也不应该直接暴露在公网。安全模型详见官方说明。
还有几个现实问题:
- 扫描版 PDF 没有文字,需要额外配置 OCR;
- 表格提取结果未必能保持原始布局;
- 超大文件必须限制大小、页数和输出字符数;
- 加密文件需要密码或相应配置;
- Tika 适合提取内容,不适合做高保真格式转换。
4.x 要不要升级
截至 2026 年 8 月,3.3.2 是稳定版,4.0.0-beta-1 仍是预览版,官方不建议用于生产。
4.x 要求 Java 17,并调整了模块组织;默认输出由 XHTML/XML 改成 Markdown,配置也从 XML 转向 JSON。老项目升级不能只改版本号,需要重新检查输出格式、依赖和配置文件。具体迁移说明可参考官方文档。
Tika 最适合充当“文件内容入口”。它不负责搜索、不负责向量化,也不负责理解文档语义,但它能把一堆乱七八糟的文件,先变成相对统一的正文和元数据。对于知识库、文档平台和文件检索系统,这一步往往比后面的算法更基础,也更容易被低估。
 发表于 6 小时前
|
查看: 2|
回复: 0
 /1


