快递面单、门票、商品价签,还有登录页上的二维码,背后经常是同一套技术库。Java 生态里用得最多的是 ZXing,全称 Zebra Crossing,也就是“斑马线”。它出自 Google,采用 Apache 2.0 协议,至今仍是很多服务端生成和识别二维码、条码的常见方案。这次就来聊聊 ZXing 3.5 这个版本。
目录
- ZXing 拿到手里是什么样
- 日常能碰到的码,它基本都覆盖
- 一张图是怎么被读出来的
- 3.5.4 这次到底改了什么
- 先把依赖接上
- 案例:生成一张门票二维码
- 案例:把图里的内容读回来
ZXing 拿到手里是什么样
平时真正要引入的是两个包。
core 只负责码本身:把文字编成矩阵,或者把一块黑白图解析成字符串。它不认识 JPG、PNG,也不依赖 AWT。javase 则负责对接 BufferedImage,命令行小工具也在这个包里。如果你只是在内存里摆矩阵、自己负责画图,第二个包完全可以不引入。
所以 ZXing 的典型工作分成两头。一头是输入一段文字,输出二维码或条码;另一头是你已经有一张图,它告诉你图里写了什么、属于哪种码、码在哪个位置。批量打印门票、对账时读快递面单、测试时先编码再解码做闭环,都属于这类路子。
手机镜头实时扫码,系统相机扫码和 ML Kit 通常更省事,因为对焦、旋转、帧率都需要额外处理。ZXing 的 Java 版更适合“图已经在手里”的场景。官方这些年也淡化了 Android 示例的持续集成,服务端和普通 Java 程序才是 3.5 的主场。
日常能碰到的码,它基本都覆盖
大家提到 ZXing,第一反应通常是二维码,但它能处理的码制其实宽得多。
方块和层叠类有 QR Code、Aztec、Data Matrix、PDF417、MaxiCode。商品包装上常见 EAN-8、EAN-13、UPC-A、UPC-E。物流和工业场景里还有 Code 39、Code 93、Code 128、ITF(交叉二五码)、Codabar,以及 RSS-14、RSS Expanded。
3.5.0 于 2022 年 5 月发布,Aztec、PDF417、Data Matrix 的解码都修过一轮,还加入了更省容量的 minimal 编码模式。后续 3.5.1 到 3.5.3 继续补边界:二维码在两类极端图片上不再长时间空转、Code 128 去掉了过严的长度限制、GS1 应用标识按 2023 年规范更新、RSS Expanded 减少了部分误识别。3.5.4 则是这条线的最新版本,整体方向仍是把旧坑填平。
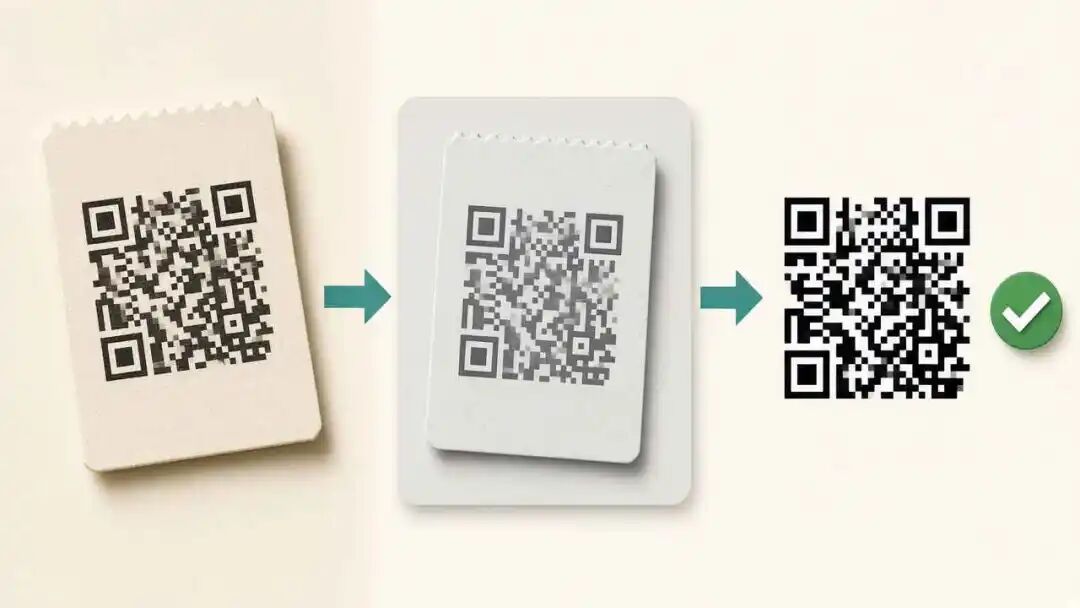
上图只是帮你留下形状印象。真正的码以库实际绘制结果为准,静区、模块大小和纠错等级都会影响能否被读回。
一张图是怎么被读出来的
业务代码里基本就是四步。记住流程后,排错也有明确方向。
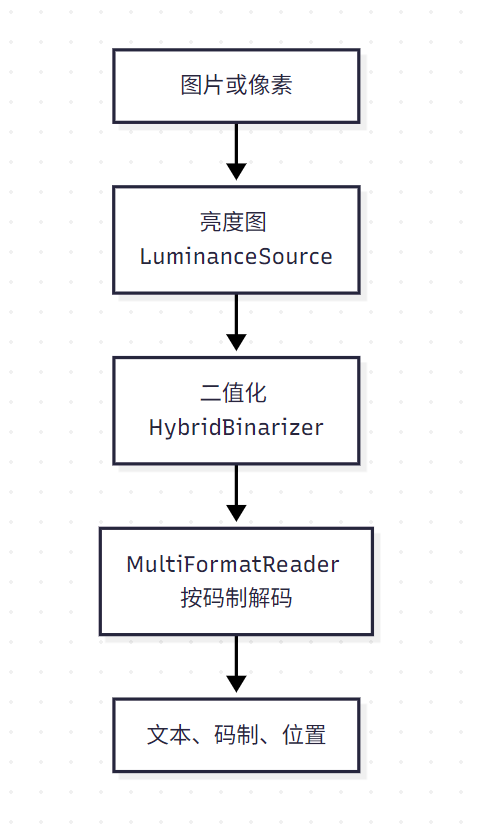
亮度图会把彩色或灰度图收成 0 到 255 的亮度值,0 是黑,255 是白。二值化再决定每个点最终算黑还是算白。照片类图片用 HybridBinarizer 比较稳;如果图片特别干净、几乎就是一张纯码,可以尝试 GlobalHistogramBinarizer,有时会更快。
最后一步不要什么码都试。面单场景里大概率是 Code 128 和 QR,用 POSSIBLE_FORMATS 收窄后,识别速度和误判率都会改善。TRY_HARDER 会花更多时间寻找难图,适合模糊、偏转的照片;干净的电子码不必每次都打开。
3.5.4 这次到底改了什么
相对 3.5.3,它没有新增码制。发布说明看着琐碎,实际都是“以前会踩、现在少踩”的修改。
灰度图可以直接送进去。 新增 GrayscaleLuminanceSource,构造方法是 GrayscaleLuminanceSource(width, height, pixels),像素按行排列。如果图片本来就是灰度,就不必再包一层 RGB。RGBLuminanceSource 改为它的子类,并补上了逆时针旋转 90 度。手机横拍的图可以在亮度图上旋转,少写一遍图像旋转逻辑。彩色像素还会先校验数组长度是否等于宽乘高,对不上就尽早失败,避免后面抛数组越界。
一张图里有多个二维码时,结果更完整。 QRCodeMultiReader 以前会丢掉符号标识 SYMBOLOGY_IDENTIFIER,与单个 QRCodeReader 的结果对不上。3.5.4 把这份元数据留了下来。对接 GS1,或者需要区分同一张图里不同码的标识时,这个字段会很有用。
PDF417 少了两个闷坑。 文本压缩模式 Compaction.TEXT 只接受码点 0 到 127 的字符,超出会抛出明确异常。这在以前可能生成一张看起来正常、内容却不对的码。另一个问题是,指定行列范围时内容明明放得下,却报 Unable to fit message in columns。issue 1831 中那种“把最小列数调大就突然能画”的情况,尺寸推算已经修正。
几种条码的识别更稳一点。 RSS Expanded 的读取去掉了一处低效的容器操作,批量扫码时少做无用功。ITF 放宽了 3 倍模块宽度的误差上限,印刷略歪的交叉二五码更容易读出来。二维码估算模块数时,合法边长必须是“除以 4 余 1”。以前只自动修正差 1 的结果,差 2 就放弃;3.5.4 会向下减 2,拉回合法尺寸。三个定位角点构成等腰直角三角形时,畸变计算也做了修正。
邮箱解析更严。 结果被当作邮箱时,格式检查收紧了,怪字符串不再轻易被判定为邮件地址。
这些改动都不是首页功能。常年跑批的人会在意:少一次越界,少一次 PDF417 死活画不出来,多个二维码时元数据还在。
先把依赖接上
<dependency>
    <groupId>com.google.zxing</groupId>
    <artifactId>core</artifactId>
    <version>3.5.4</version>
</dependency>
<dependency>
    <groupId>com.google.zxing</groupId>
    <artifactId>javase</artifactId>
    <version>3.5.4</version>
</dependency>
这一代按 Java 8 来用就行。几个包的版本号保持一致,避免 core 和 javase 各写各的。
案例:生成一张门票二维码
下面这段代码会输出 ticket-qr.png。纠错等级用 M,即使票面脏一点、有褶皱,也还有机会读回来。边距留 1 个模块,打印和展示都更稳妥。字符集指定 UTF-8,中文不会在生成阶段乱掉。
import com.google.zxing.BarcodeFormat;
import com.google.zxing.EncodeHintType;
import com.google.zxing.WriterException;
import com.google.zxing.client.j2se.MatrixToImageWriter;
import com.google.zxing.common.BitMatrix;
import com.google.zxing.qrcode.decoder.ErrorCorrectionLevel;
import com.google.zxing.MultiFormatWriter;

import java.io.IOException;
import java.nio.file.Path;
import java.util.HashMap;
import java.util.Map;

/**
 * 门票二维码生成示例。
 */
public class TicketQrWriter {

    /**
     * 把门票信息写成一张 QR 图。
     *
     * @param file 输出的 PNG 路径
     */
    public static void write(Path file) throws WriterException, IOException {
        Map<EncodeHintType, Object> hints = new HashMap<>();
        hints.put(EncodeHintType.CHARACTER_SET, "UTF-8");
        hints.put(EncodeHintType.ERROR_CORRECTION, ErrorCorrectionLevel.M);
        hints.put(EncodeHintType.MARGIN, 1);

        String content = "门票:A-1024,入场:2026-11-02 17:25:17";
        BitMatrix matrix = new MultiFormatWriter().encode(
                content,
                BarcodeFormat.QR_CODE,
                360,
                360,
                hints);
        MatrixToImageWriter.writeToPath(matrix, "PNG", file);
    }
}
如果把 BarcodeFormat.QR_CODE 换成 BarcodeFormat.CODE_128,宽高改成细长条,就是物流单上常见的一维码。PDF417 则使用 BarcodeFormat.PDF_417。如果明确指定了 Compaction.TEXT,而内容里出现中文或其他非 ASCII 字符,3.5.4 会直接提示不可用。这种情况应改用自动或字节压缩,或先确认内容是否纯英文和数字。
边距不要为了“图小一点”就设成 0。码四周那圈空白叫静区,裁掉后即便生成成功,识别也经常失败。
案例:把图里的内容读回来
识别时我习惯把码制写死。全码制来回试也能工作,但业务里码的种类通常是已知的。
import com.google.zxing.BarcodeFormat;
import com.google.zxing.BinaryBitmap;
import com.google.zxing.DecodeHintType;
import com.google.zxing.GrayscaleLuminanceSource;
import com.google.zxing.LuminanceSource;
import com.google.zxing.MultiFormatReader;
import com.google.zxing.ReaderException;
import com.google.zxing.Result;
import com.google.zxing.client.j2se.BufferedImageLuminanceSource;
import com.google.zxing.common.HybridBinarizer;

import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.IOException;
import java.nio.file.Path;
import java.util.Collections;
import java.util.EnumMap;
import java.util.Map;

/**
 * 从图片中读取二维码。
 */
public class TicketQrReader {

    /**
     * 读取 PNG 里的二维码文本。读不到时返回 null。
     *
     * @param file 待识别的图片
     * @return 码内文本;图糊、静区被裁掉或码制不对时返回 null
     */
    public static String read(Path file) throws IOException {
        BufferedImage image = ImageIO.read(file.toFile());
        LuminanceSource source = new BufferedImageLuminanceSource(image);
        BinaryBitmap bitmap = new BinaryBitmap(new HybridBinarizer(source));

        Map<DecodeHintType, Object> hints = new EnumMap<>(DecodeHintType.class);
        hints.put(DecodeHintType.CHARACTER_SET, "UTF-8");
        hints.put(DecodeHintType.POSSIBLE_FORMATS,
                Collections.singletonList(BarcodeFormat.QR_CODE));
        hints.put(DecodeHintType.TRY_HARDER, Boolean.TRUE);

        try {
            Result result = new MultiFormatReader().decode(bitmap, hints);
            return result.getText();
        } catch (ReaderException ex) {
            // 没找到、校验失败、格式不对,都算这张图没有读出来
            return null;
        }
    }
}
二维码通常自带编码信息,CHARACTER_SET 对一维码更关键。多个二维码要一次拿全,可以改用 QRCodeMultiReader,在 3.5.4 中每个结果的 SYMBOLOGY_IDENTIFIER 会保留在 result.getResultMetadata() 中。
如果图片已经是灰度字节,走新类即可。数组长度必须等于宽乘高。
/**
 * 用灰度像素解码,横拍时先逆时针转 90 度。
 */
public class GrayTicketDecoder {

    /**
     * @param pixels 按行排列的灰度值,0 为黑,255 为白
     * @param rotate 为 true 时逆时针旋转 90 度后再识别
     */
    public static LuminanceSource toSource(byte[] pixels, int width, int height, boolean rotate) {
        LuminanceSource source = new GrayscaleLuminanceSource(width, height, pixels);
        if (rotate) {
            source = source.rotateCounterClockwise();
        }
        return source;
    }
}
读失败在业务里单独分支就好,多半是图糊、反光、码制没配对,或者静区没了。把它记成系统异常,后面会很难查。
 发表于 6 小时前
|
查看: 1|
回复: 0
 /1


