Java 团队做 Agent,不缺模型接入方案,缺的是让 Agent 稳定跑在生产里的运行时能力。记忆漂移、大报文击穿上下文、推理不可复盘、工具变更要发版——这些问题现有框架不兜底。Spring-Ai-Trip 在 Spring AI 上叠加了一层 Harness,用渐进压缩、Spill 溢出保护、认知可观测等机制,填平 Demo 到生产之间的鸿沟。如果你也在 Java 侧做 Agent,也在被这些“Demo 跑通了,上线就翻车”的问题反复折磨,这篇文章或许能帮你少踩几个坑。
一、Java 侧做 Agent,我们到底缺什么
过去两年,Agent 生态的语言分布很偏——Python、TS 那边百花齐放,Java 这边一直不温不火。LangChain4j 和 Spring AI 把接入大模型这件事做得挺到位,后来的 Spring AI Alibaba、AgentScope Java 又在编排和多 Agent 协作方向补上了部分能力。但真正在生产里做过 Java 侧 Agent 的团队,大概率都踩过下面这三个问题:
- 技术栈错配:国内后端团队的技术栈基本以 Java 为主,用 Python 独立搭建服务会带来跨语言 RPC 调用,同时需要维护两套可观测体系、两套配置中心,让整队人转去写 Python 也不现实。他们要的不是能用 Python 跑的 Agent,而是“能用 Java 写、能长在现有业务代码旁边”的 Agent。
- 企业级治理断层:多数开源框架只做到能跑起来:调通模型、跑通工具。至于链路追踪、配置中心、限流熔断、审计合规、灰度发布——大多要业务方自己接。
- 运行时空白:即便选了 Java 方案,现有框架也基本只做到能调通大模型。而生产化真正的难点在运行时:短期记忆怎么管、单次工具返回的 5 万字报文怎么处理、错误结论的推理过程怎么回溯、工具怎么在不重启的情况下加减、并发工具调用怎么保证一致性——这些几乎没有框架给你兜。
会调大模型,只是拿到了入场券;让 Agent 稳定、可控、可解释地跑在生产里,才是真正难的部分。
现有 Java 方案审视
Spring AI 把接入大模型这件事做得很轻,统一的模型抽象、Advisor 拦截链、Tool Calling 注解对 Java 工程师很友好。但也就到接入这一步:ChatMemory 只有滑动窗口这类基础实现,工具返回值直接进上下文、没有溢出保护,Observation 只覆盖到“调用发生了”这一层,工具注册是启动期静态的,会话生命周期没有作用域概念。
Spring AI 是模型抽象层,不是 Agent 运行时。它给你一辆能开的车,但生产化需要的变速箱、ABS、行车电脑,得自己造。
Spring AI Alibaba 走得更远,Graph 编排、Nacos 集成、DashScope 生态、Studio 工具链。我们没选它:一来我们已经在用 QConfig、CAT、内部 MCP 网关,换 Nacos 这套等于把现有基建全部替掉;二来它的重点在编排,我们头疼的是单个 Agent 内部怎么更稳定地运行。
AgentScope Java 出现得晚,但布局铺得比较全:不可变消息、@Tool 注解、A2A / MCP 双协议、Reactor 非阻塞,适合新起项目。它和我们的场景不一样:它是一站式开发平台,我们是往已有 Spring Boot 服务里嵌的一层。后文会把它拿来做对照。
Spring AI 之外这块空白,大到值得单独做一层。我们将该中间层叫做 Spring-Ai-Trip,作为挂载在 Spring AI 与业务 Agent 之间的 Harness。
二、设计哲学:我们如何看待 Agent 运行时
在讲机制之前,先把心法交代清楚,后面所有具体设计,都是这四条原则的推论。
2.1 叠加,而不是替代(Additive over Replacement)
不重造 Spring AI 的轮子,所有能力以 Advisor / ToolCallback / Observation 的方式挂到它上面。业务方随时可以只用 Spring AI 原生能力,也随时可以按需开启我们的能力项。
2.2 读写分离,把复杂度推后(Lazy Compaction)
写入路径永远简单快速——毫秒级落库,零加工。所有 Agent 决策(压缩、预算判断、锚定、修复)都推迟到注入模型的那一刻再做。原始数据永远完整保留在库里,复盘、审计、回放随时可查。
2.3 信息不丢弃,只降级(Progressive Degradation)
面对上下文压力,信息从高精度原文渐进降级到高密度摘要,而不是断崖式截断,也不是被打散成检索碎片。我们要的是斜坡,即保留连续的、可读的、只是密度不同的一份历史。
2.4 默认安全,业务无感(Safe by Default)
异常路径的清理、并发下的一致性、工具下线的安全窗口、进程重启后的会话续接,这些脏活都由框架在业务背后处理干净。
三、系统架构:Spring-Ai-Trip 的全景视图
3.1 整体架构图
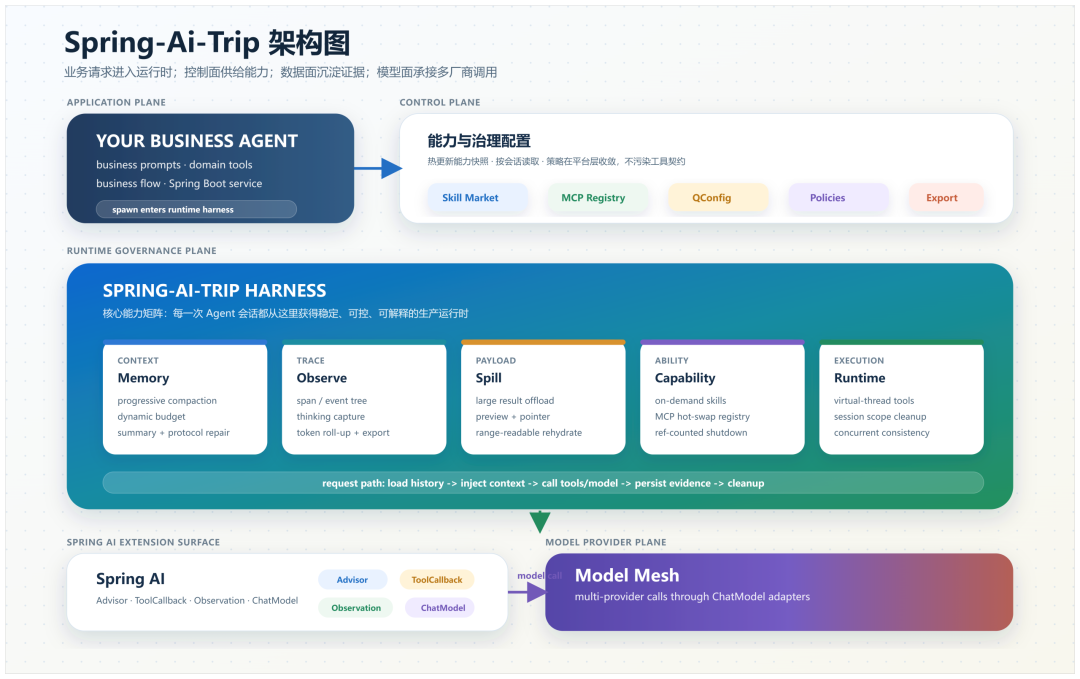
3.2 核心数据流
一次 agent 调用穿过 Harness 的完整路径,大致是这样:
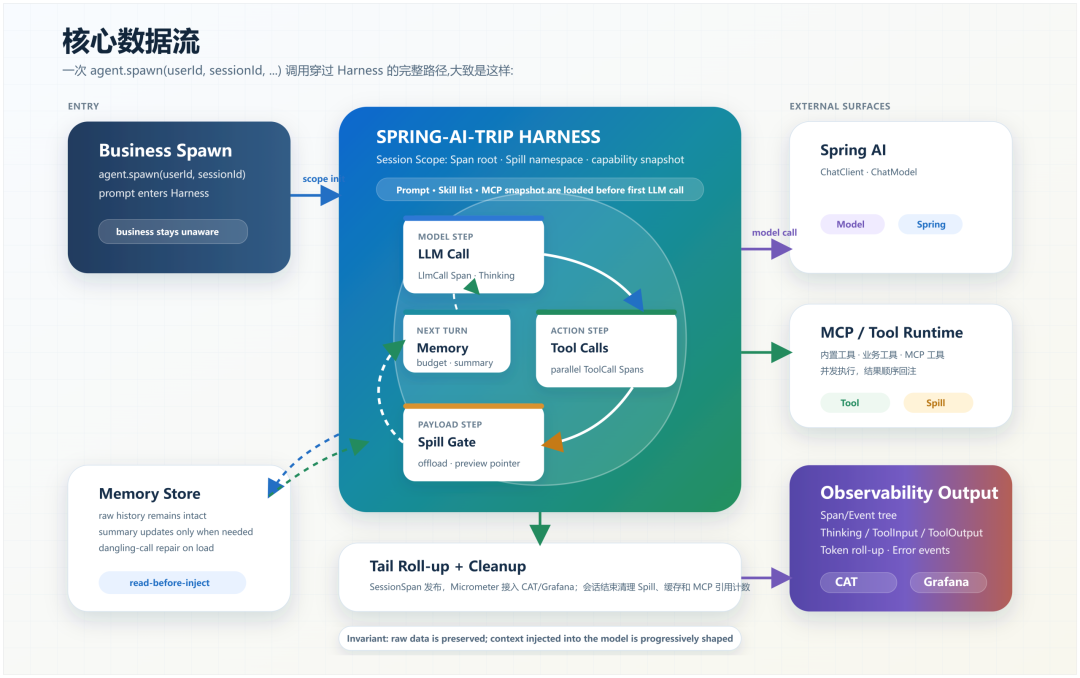
四、短期记忆:渐进式压缩
Agent 的短期记忆决定了它是能连续作战的助手,还是每轮从零开始的无状态函数。没有记忆的 Agent 本质上是 f(当前输入) → 输出,会在三个层面断裂:
- 对话连续性断裂:第 1 轮说“处理订单 ORD-2024-001”,第 5 轮问“进展怎样了”——Agent 已经不记得订单号。
- 决策链断裂:中间环节丢失,无法基于已有结论继续推进。
- 行动链断裂:早期工具返回消失,可能重复调用或跳过步骤。
记忆不是 Agent 的附加功能,而是 Agent 区别于 API wrapper 的本质特征。
4.1 通行做法的结构性缺陷
上下文窗口是固定的,对话越长越满,必须淘汰一些内容。核心问题是淘汰标准:按什么规则丢、丢完之后关键信息还在不在。
滑动窗口——Spring AI 的 MessageWindowChatMemory、LangChain 的 ConversationBufferWindowMemory 都是这个路子:保留最近 N 条消息,超出从队头丢。它用位置作为唯一淘汰标准,可信息的价值根本不由时间决定——用户第 1 轮说的“帮我处理订单 ORD-2024-001 的退款”,可能比第 19 轮那句“嗯”重要一万倍。到第 21 轮,窗口一滑,最初的目标被无声丢弃,于是 Agent 开始目标漂移:越聊越偏,或者每一轮都在重新猜用户到底想要啥。
RAG 检索——把历史向量化,用时再捞。它擅长跨文档知识检索,但用作会话记忆有个硬伤:它按语义相似度捞相关片段,却感知不到时序,也拼不出对话的整体画像——Agent 知道自己某次查过订单,却不知道整个任务进展到哪一步了。
看清了这些,我们的设计哲学其实就一句话:
永远不丢弃任何信息;注入模型时,按信息价值的衰减曲线,渐进地压缩。
“渐进”是关键词。 信息不是在某个边界突然消失,也不是被打散成碎片,而是连续、分级地从高精度原文过渡到高密度摘要。
在思考这套渐进压缩具体怎么做时,Claude Code 的四层上下文管理机制给了我们很大启发——我们借鉴了其中三条核心思想:信息不应被断崖式截断、摘要应该结构化而不是“总结一下”、压缩之后需要显式恢复。但不能直接照搬:Claude Code 是单机 CLI,单进程持有会话状态、SM 文件写本地磁盘;我们是分布式服务端,多实例无粘性会话、要跨实例续接、要接多家模型厂商——这些差异决定了我们最终落地的形态和它不同。
4.2 三层防御体系
第一层:完整持久化。 所有消息逐条落库,只追加、不删除。
这一层还带来一个容易被忽视、却极其关键的设计——读写分离。写入永远只是简单的一次落库,毫秒级,零压缩开销;所有压缩都只发生在读取、注入模型的那一刻。原始数据一条都不少地躺在库里,复盘、审计、回放随时可查。这一步还顺带解决了服务端才需要面对的跨实例会话续接:任何实例接过 sessionId,都能从库里拿到完整历史 + 摘要,不依赖任何本地状态。
第二层:工具结果微压缩。 这是一个纯内存计算、完全不调用大模型的轻量回收。它的核心洞察是:一次工具调用的返回值,价值衰减得极快。一个 3000 token 的订单查询结果,在 Agent 已经据此告诉用户“订单已发货”之后,那 3000 token 的原始 JSON 就不再需要了——留下“我查过了,已发货”这个事实就够了。
压缩前(约 3000 tokens):
  [工具] query_order → {"status":200,"body":{"orderId":"...","items":[...大量数据...]}}

压缩后(约 10 tokens):
  [工具] query_order → "[旧工具结果已清理,可按 evidence-id=e7f3a 回查]"
一些打磨得比较细的点:以完结轮次为原子单位——工具调用链可能横跨好几条消息,只有当整轮真正结束了其中的结果才有资格被回收,绝不切断正在进行的调用链;按工具分策略——不同工具挂不同压缩规则,关键操作永不压缩、查询结果过期即清。
替换文本带证据指针——清理后的占位符里带一个指向持久化层的 evidence-id,排障时需要还原当时看到了什么,直接按指针回查即可,和后面讲的可观测性打通。原始工具返回并没有真的消失,只是从注入模型的上下文里退场。一次 20 轮工具调用的对话,光微压缩就能释放约 5 万 token。
第三层:LLM 结构化摘要。 当微压缩之后仍然超预算,才动用大模型,把早期对话折叠成一份结构化摘要。注意,这不是让模型随便总结一下,而是按一个固定的九段式模板来写,并且给每一段排了优先级:
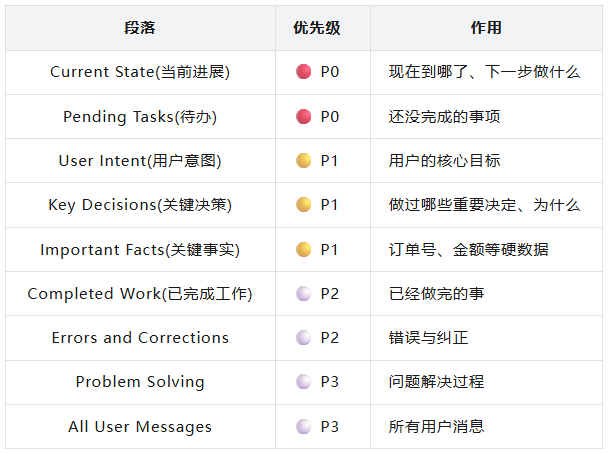
这个设计直接命中前面说的目标漂移:User Intent 和 Current State 被显式地、结构化地锚定在摘要里,无论压缩多少轮,Agent 始终清楚“用户要什么”和“我做到哪了”。token 实在不够时,先从 P3 往下砍,P0 段落死保。摘要以 <system-reminder> 标签包住、作为一条历史消息注入,插在近期原文之前,既压缩了信息量,又最大限度保住了会话连贯。
对话再长呢?摘要之上还能再做摘要。当已有一份摘要、又积累了一批新对话,框架会以合并更新的方式做增量摘要——在旧摘要基础上更新各段,而不是从头重写。于是摘要的质量随对话深度线性提升,而不是反复推倒重来。
顺带对照一下 AgentScope Java 的思路:它的短期记忆走标准的消息容器(InMemoryMemory),长期记忆则通过 LongTermMemory 接口委托给 ReMe / Mem0 / 阿里百炼等外部服务——重心是“记忆服务的对接”。回到“单会话内不忘事”这个问题上,它的重心不在这里;我们更像在做“记忆的注入形态”。两种取向没有对错,解决的是不同层次的问题,甚至可以叠加。
4.3 悬空调用修复:服务端才会踩到的坑
还有一个真实生产才会踩到的坑:服务中断。假如一轮工具调用刚发出、结果还没回来,进程就重启了,库里就留下了一个悬空的工具调用——这违反了大模型 API 的消息协议,下次直接报错。框架在加载历史时会自动检测并修复这种残缺,把违规的悬空消息剔除干净,让会话能安全地接着跑。这类“脏活”,正是分布式 Harness 该替业务扛下来的。
4.4 动态预算:为什么固定配额会翻车
那么,超不超预算这条线,到底谁来划?
给历史消息分配固定配额(比如窗口的 80% 留给历史)这个想法,建立在一个错误假设上——prompt 里除历史之外的部分是稳定的。它一点都不稳定:系统提示词(从几十到三千多 token)、工具 Schema(20 个工具轻松过万)、当前用户输入(一句“好”是 1 token,粘贴一份日志是几千 token)——固定比例要么太保守、要么一遇工具增多就溢出。
正确的算法不是“取窗口的某个比例”,而是“窗口减去所有已知固定开销之后,剩下多少给历史”:
有效窗口   = 上下文窗口 − 预留输出(默认 8000) − 安全缓冲(默认 3000)
固定开销   = 系统提示词 + 工具 Schema + 当前输入
历史预算   = 有效窗口 − 固定开销
预估总量   = 固定开销 + 摘要 tokens + 历史 tokens
触发压缩   ⇔  预估总量 > 有效窗口 × 阈值(默认 0.90)
关键在“先扣后算”:不可压缩的输出预留和安全余量先扣掉,固定开销再扣掉,剩下的才是历史的真实空间;判断是否压缩时,摘要本身也占地方,必须算进去。所有 token 数由一个本地近似估算器算出——英文约 4 字符 1 token、中文约 2 字符 1 token、JSON 上浮 15%——不调用远程 tokenizer,靠 10% 的阈值余量兜住估算误差。
五、可观测性:Span + Event 树
Agent 的故障模式和传统服务根本不同:没有异常堆栈,没有错误码,服务运行一切正常——只是推理方向偏了。传统 APM 能覆盖调用链路和耗时分布,但覆盖不到推理层:模型在哪一步、基于什么证据、做出了什么判断,这些信息在现有监控体系里是缺失的。
5.1 一个真实的排障案例
用户问:“帮我看看为什么昨天下午订单转化率跌了。” Agent 调了几个工具,最后回答:“经查,是支付网关超时率上升导致的转化率下跌,建议排查支付链路。”
结论有零有整,业务方信了,排查支付链路一整天,结果发现支付一切正常。
问题到底出在哪?如果没有可观测性,你只能靠猜。而当你能把这次会话完整回放出来,真相一目了然:
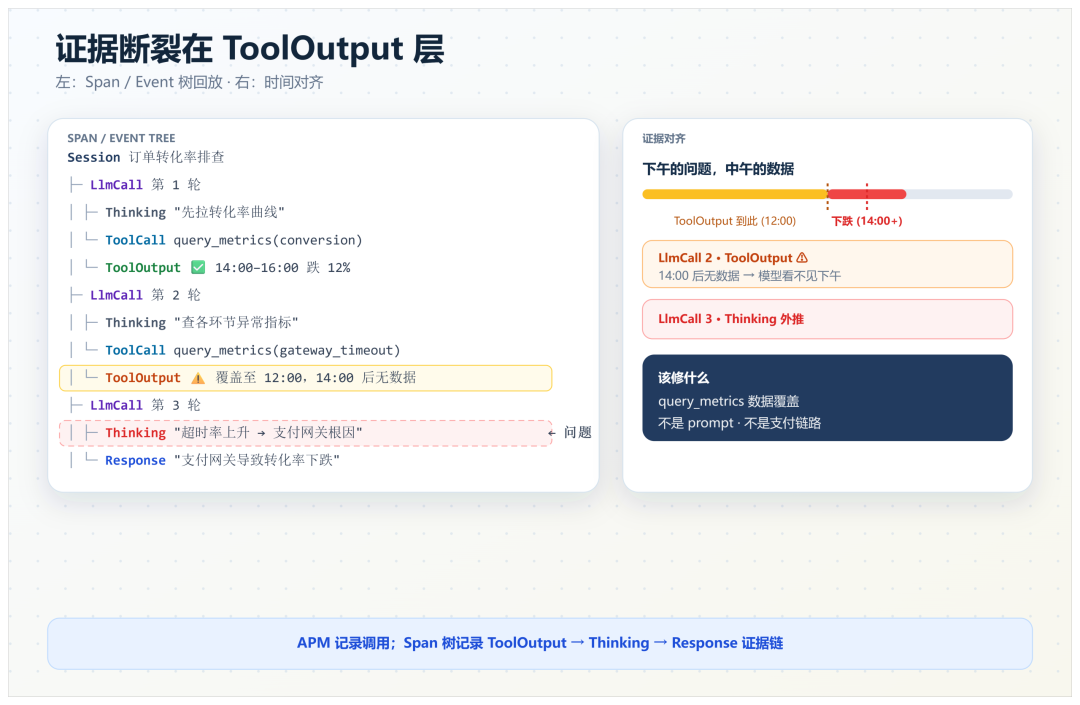
真相浮出水面:那个查超时率的工具,数据只覆盖到中午 12 点,而下跌发生在下午两点后。模型拿到的是一份残缺数据,却把“上午的上升趋势”错误外推成了“下午的根因”。
错误不在模型笨,而在于它拿到的证据本身有问题,且没人能看见这个断裂。有了完整的 Span + Event 回放,你一眼就能锁定:不是模型的锅,是那个工具的数据覆盖范围有问题,去修工具,而不是去调提示词。
5.2 认知可观测 vs 传统监控
这就是认知可观测性和传统监控的根本区别:它记录的不只是调用发生了,而是模型基于什么证据、做出了什么推理、得到了什么结论。
我们把一次 Agent 执行,建模成一棵由 Span 和 Event 组成的树:
- Span 是有始有终、可嵌套的执行区间:一次会话套着多轮对话,每轮里有模型调用和工具调用。它天然还原了 Agent“思考—行动—再思考”的递归结构。
- Event 是 Span 内部的关键瞬间:模型的思维链、最终回复、工具的入参与出参、以及错误。
尤其是 Thinking 事件——模型的思维链被显式捕获下来。上面那个例子里,正是第 3 轮那句“有上升趋势 → 大概率是它导致的”,暴露了模型的推理跳跃。没有它,你永远只能对着一个错误结论干瞪眼。
5.3 可观测性后台
那么,如何让这些认知层的可观测事件——思维链、证据链、工具入参出参、token 消耗、错误现场——被开发者直观地感受到呢?一个好用的可视化后台同样必不可少。为此,我们把整棵 Span + Event 树做成了一个专门服务于 Agent 开发的可视化平台。
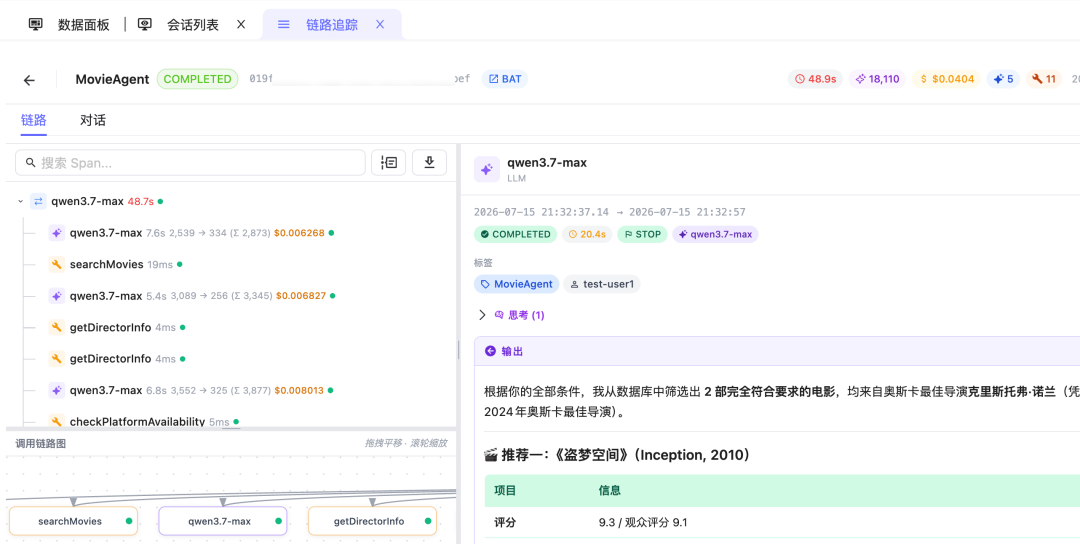
通过它,开发者可以按会话回放 Agent 的每一次执行,把模型看到的“有效上下文”“每一步的思维链”“工具的入参与出参”“token 与耗时的分布”“异常事件的现场”一并摊在同一个视图里。最终答案只是结果,Trace 才是调优入口——写完一版提示词、加了一个工具、换了一个模型之后,改动到底让 Agent 变好了还是变差了,不再靠肉眼比对输出去猜,而是能落到一条条可对照的证据上。
六、Spill:大结果的溢出保护
短期记忆管的是随时间累积的膨胀,但还有一类膨胀是瞬间的——单次工具调用就能返回 5 万字。我们踩过这个坑:一个 BAT 生态的 MCP 工具,某次调用甩回将近 5 万字的报文。这份报文一旦原样进入上下文,三件事同时发生:
预算瞬间击穿——单条消息就吃掉大半个窗口,其它历史被迫大规模压缩甚至丢弃;
注意力被稀释——模型淹没在海量它根本不关心的字段里,真正该看的那几行反而被忽略,输出质量肉眼可见地下滑;
成本被引爆——这份报文会跟着后续每一轮对话反复重新发送,token 一次次翻倍计费。
而模型绝大多数时候只需要其中某个字段,或者只需要知道这个接口调通了、数据拿到了。
6.1 思路:类比操作系统的内存交换
我们的应对,叫 Spill(溢出保护)。思路和操作系统的内存交换如出一辙:内存(上下文)放不下的大块数据,落到磁盘去,在内存里只留一个指针。
具体来说,任何工具的返回值,一旦超过阈值(默认 32000 字符),框架会自动接管:
- 把完整原文落盘持久化,一个字节都不丢;
- 给模型的上下文里,只留一段预览(默认前 2048 字符)+ 一句明确的说明 + 一个可回读的路径。
模型看到的,从一堵 5 万字的墙变成了这样:
[工具结果过大,已溢出到磁盘]
预览(前 2048 字符):
{"code":0,"data":{"list":[{"id":"...","name":"..."} ...
完整内容已保存至:spill://order-assistant/conv-abc/tool-7f3a.json
如需完整数据,可使用读取工具按该路径获取。
这个设计的巧妙之处在于,它把要不要看全文的决策权,交还给了模型自己。绝大多数情况下,预览里的信息已经足够它继续推理;万一真需要全文里的某个细节,它可以主动拿着路径去回读——甚至只读其中一段。
信息一点没少,但它从“强行灌进大脑”变成了“需要时再查阅的档案”。
6.2 几个我们打磨过的细节
按 tool 粒度可配置。哪些工具触发、阈值多少、预览多长、要不要落盘,都能挂到策略上按工具定制。有些工具的输出天然结构化(比如 JSON List),可以在预览时智能截取前若干项 + 计数摘要;有些工具的输出是纯文本报告,直接截前 N 个字符就够了。
回读工具支持范围读取。回读接口不是要么给你全文、要么什么都没有,而是允许按字节区间、按 JSON path、按分页游标读取——避免回读又把上下文爆一次。模型看到一个 5 万字的 spill 文件路径时,它可以只回读第 3 到第 5 条 list 项,而不是被迫拿全文。
命名空间和会话生命周期绑定。Spill 文件按 agentName/sessionId/toolId 组织,天然属于一次会话的资源。会话结束(无论成功、失败、取消、超时),这批文件跟着会话作用域一起被清理,不会在磁盘上留下孤儿。
并发一致性。多个工具在同一轮里并发返回、并发触发 Spill 时,文件命名要不冲突、回注消息要顺序对齐、可观测 Span 要各挂各的——这些一致性细节在虚拟线程环境下都经过了针对性测试。
“大工具返回值该往哪放”这个问题,不是我们独家看到的坑。Spring AI 目前还没有这一层的原生抽象,工具返回值直接进上下文;LangChain 一侧靠调用方手动 truncate——信息就直接丢了。有意思的对照来自 AgentScope Java,它的 ToolResultEvictionMiddleware 思路和我们的 Spill 几乎撞在一起:超过阈值自动接管、原文落盘、上下文里换成预览占位符、模型按需回读。它甚至在设计文档里明确区分了两件事——eviction 解决“上下文的宽度”(单条消息太大)、compaction 解决“上下文的深度”(消息太多),和我们把 Spill 与短期记忆压缩分成两层的思路完全一致。不同团队独立收敛到相近的方案,这本身就说明“大工具返回值该落盘 + 预留回读入口”是这类问题现阶段的合理解。 差异更多在细节和归属——阈值、预览方式、挂载层次、命名空间——来自各自场景的具体约束,而不是设计思路的分歧。
七、能力供给:填平 Skill 的空白 + MCP 热插拔
Agent 的能力边界,由它手里的工具决定。这里有一对天生的矛盾:
- 工具给少了——Agent 啥也干不成;
- 工具给多了——每个工具的名字、描述、参数 Schema 都要塞进上下文,20 个工具轻松吃掉上万 token,不但烧钱,还稀释模型注意力。
更别提工具还会变:今天上线一个新数据源,明天下线一个旧接口。难道每次都要改代码、发版?
7.1 拆解一:填平 Spring AI 在 Skill 上的空白
Skill 按需加载的思路早已是业界共识:上下文里只放技能清单(name + description),模型判断需要时,再调工具捞正文。这一层机制本身不新——新的是 Spring AI 在这件事上是一片空白,业务方要么自己拼加载器,要么把指令全塞进 system prompt。
我们把 Skill 作为一等公民补齐,做了两个来源的实现:
- 内置 Skill(classpath 加载):团队沉淀的通用能力——日志排查、大工具输出处理、ClickHouse 查询等——以 jar 内置形式随框架下发,引依赖即得。
- DB 动态 Skill(后台可配):每次
spawn() 拉取当前 (appId, agentName) 绑定的技能清单,后台上架、编辑、绑定,下一次 spawn 即生效——不改代码、不发版。
同名 DB Skill 覆盖内置 Skill。平台方提供默认能力池,业务方按需扩展或覆盖。
7.2 拆解二:让工具能“热插拔”——MCP 动态工具注册
这套 MCP 动态工具注册 机制由配置中心(如 QConfig)驱动、运行时热更新:改一份配置即时生效,全程不重启、不发版。
热更新的难点在“安全”:更新的瞬间,可能正有请求在用旧工具。两个机制兜底:
- 差量刷新:只动真正变化的部分,避免“配置一变就全量重连”的雪崩。
- 引用计数 + 延迟关闭:要下线的工具连接,等它身上所有在途调用都结束才真正释放——绝不会在请求执行到一半时把连接抽走。
7.3 内置原子工具
框架还内置了一批开箱即用的原子工具:文件读写、命令执行、任务清单、HTTP 调用等——都是我们在多个业务场景里反复用到、抽象出来的最小可复用能力集。
八、并行工具调用:能同时做的事,别排队
还有一个体感极强的痛点:慢。
模型常常一次性决定调好几个相互独立的工具——查订单、查物流、查用户等级。串行执行意味着耗时累加,但这几个调用之间根本没有依赖,没必要排队。
8.1 虚拟线程:契合“大部分时间在等网络”的场景
框架的做法很直接:当模型在一轮里请求了多个独立的工具调用,用Java 虚拟线程把它们并发执行——总耗时从各段相加变成取最长的那段。虚拟线程极其轻量,成百上千个并发的 IO 等待也扛得住,契合工具调用这种“大部分时间在等网络”的场景。
8.2 并发了,但不能乱
- 结果顺序对齐:并发返回的工具结果回注 Prompt 时,要和模型请求顺序严格对齐——不能因为查物流比查订单快 200ms 就颠倒。
- 观测 Span 不串味:每个工具调用挂在自己那条 Span 子树上,Thinking / ToolInput / ToolOutput 归属不错乱。
- Spill 和微压缩在并发下照常工作:多工具并发触发 Spill 时文件命名不冲突;微压缩“完结轮次”的判定依然正确。
这些一致性细节,框架都在底层处理干净——业务侧感知不到并发的复杂,只感知到变快了。
九、端到端实战:一次排障会话,把所有机制串起来
单看每个机制,都像一个独立的补丁。但它们真正的威力,在于协同。我们用一个贯穿始终的场景,把它们串成一条线。
用户:“帮我排查下为什么订单 ORD-2024-0117 一直卡在‘支付中’。”
第 1 步——技能与工具就位。 收到问题,Agent 扫一眼上下文里的技能清单,判断这是支付排障,用内置工具把“支付状态机排查”这份技能的正文加载进来。同时,配置中心早已把这个环境该有的查询工具热插拔就绪。
第 2 步——并行取证。 模型一次性决定:查订单主表、查支付流水、查网关回调日志。三个调用互不依赖,框架用虚拟线程并发执行,耗时取最长的一段,而不是三段相加。
第 3 步——大报文不炸场。 网关回调日志甩回来一份 4 万字的报文。它没有污染上下文——超过阈值的部分被自动落盘,模型只拿到预览和一个回读路径。模型瞄一眼预览,发现关键信息不在里头,于是拿着路径只回读了它需要的那一段。上面这几步,都发生在响应这同一个问题的过程里,即模型内部“思考—取证—再思考”地递归推进,整个过程被记录成一棵 Span/Event 树。
聊到后面几轮——记忆不漂移。 排障很少一问一答就结束:给出初步结论后,用户往往接着追问——“那网关重试过没有”“换昨天同一时段再看看”。这样一来一回,就成了多轮对话。压缩正是在这里发挥作用:它不发生在某一轮的内部推理中,而是当新一轮对话到来、框架把历史加载进来准备注入模型的那一刻才触发。 此时,前几轮里那些完整的工具返回值,被微压缩成“查过了、结果如何”的事实条目;更早的几轮被折叠成结构化摘要,而“用户要排查 ORD-2024-0117 的支付卡单”这个目标,始终被稳稳锚定在摘要的 P0 段落里——哪怕聊到第 20 轮,Agent 依然清楚自己在查什么。
结论给出后——一切可回放。 整个过程被完整记录成一棵 Span + Event 树。万一结论有问题,你能一眼看到模型在哪一步、基于哪份证据、想岔了。
会话结束——干净收场。 无论这次是顺利结案还是中途被取消,会话谢幕的那一刻,spill 文件、内存缓存、临时工具连接被成套释放,不留一点残渣。
而这一整套协同,业务方几乎一行都不用写。你只管把对话喂进去,把业务工具接上去;压缩、预算、锚定、修复、观测、清理,全在后台悄悄运转。业务代码里,剩下的就是那件你本该专注的事:把这个领域的问题解决好。
十、Roadmap:我们还在往哪走
Spring-Ai-Trip 解决的,是“让 Agent 稳稳跑在生产里”这一层的问题。往前看,还有更大的图景:
- 更强的 Agentic Loop:让 Agent 的自主规划、反思、纠错能力更成熟,并支持 Plan Mode、Sub Agent,从“能完成任务”走向“能把任务完成得更好”。
- 长期记忆:短期记忆解决一次会话内不忘事,长期记忆要解决跨会话地积累经验、认识用户。
- 自愈与容错:把“悬空调用修复”这类点状能力,扩展成一套系统化的故障自恢复机制。
- 提示词治理:让提示词像代码一样,可版本化、可评测、可灰度。
写在最后
回头看,Spring-Ai-Trip 做的所有事情,其实都围绕一句话:
把“会调大模型”和“能在生产里跑好一个 Agent”之间那道鸿沟,用一层 Harness 填掉。
它不替代 Spring AI,而是叠在上面;它也不去和 Spring AI Alibaba、AgentScope 抢编排层的位置,而是专心把单个 Agent 内部怎么活下去 这件事做好——记忆、Spill、可观测、能力供给、并行工具调用,每一层都是我们在业务里被问题绊过一次之后,补上的一块。它们对业务方大多只是一行配置,但每一行背后,都是从 Demo 到生产之间必须过的一道坎。
如果你也在 Java 这边做 Agent,也在被这些问题反复折磨,希望文章里的思路对你有用。
 发表于 8 小时前
|
查看: 1|
回复: 0
 /1


