前言
Strata 刚发布时,对 N 卡低显存用户来说确实是个不小的惊喜。盼了很久,最近它终于支持 Mac 了。我第一时间安装并下载了 Qwen3.8-Flash-Next Q2_0 模型,体积大约 67G,随后做了一些简单测试,看看实际效果到底怎么样。
如果你还不了解 Strata,这里先用一句话概括它的核心思路:它不再要求一台电脑把整个大模型都装进显存,而是把模型拆开,让显卡、系统内存和 SSD 分工合作。正是这种设计,让不少低显存主机也能在本地运行大模型。
速度表现
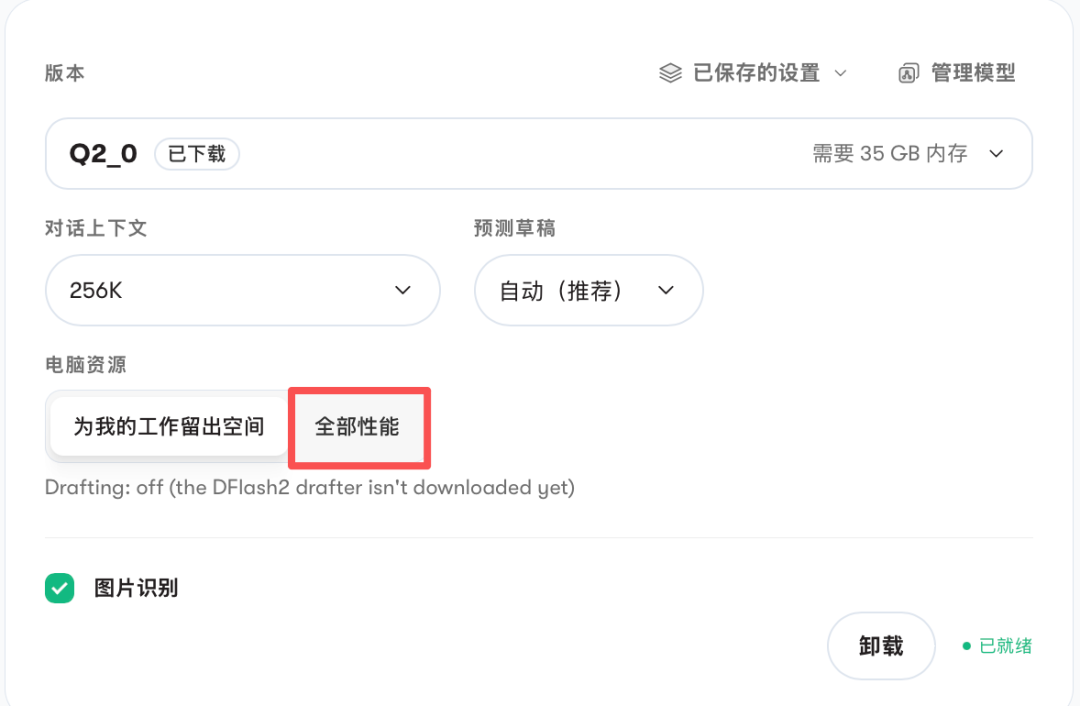
测试环境是 MacBook Pro(M5 48G),开启了图片识别,未开启“全部性能”。
之前我一直在本地用 MTPLX 跑 Qwen3.8-27B 量化模型,速度基本维持在 20–30 t/s。这次换成 Strata 后,速度同样能保持在 20–30 t/s 左右,瞬时最高可以到 37 t/s。
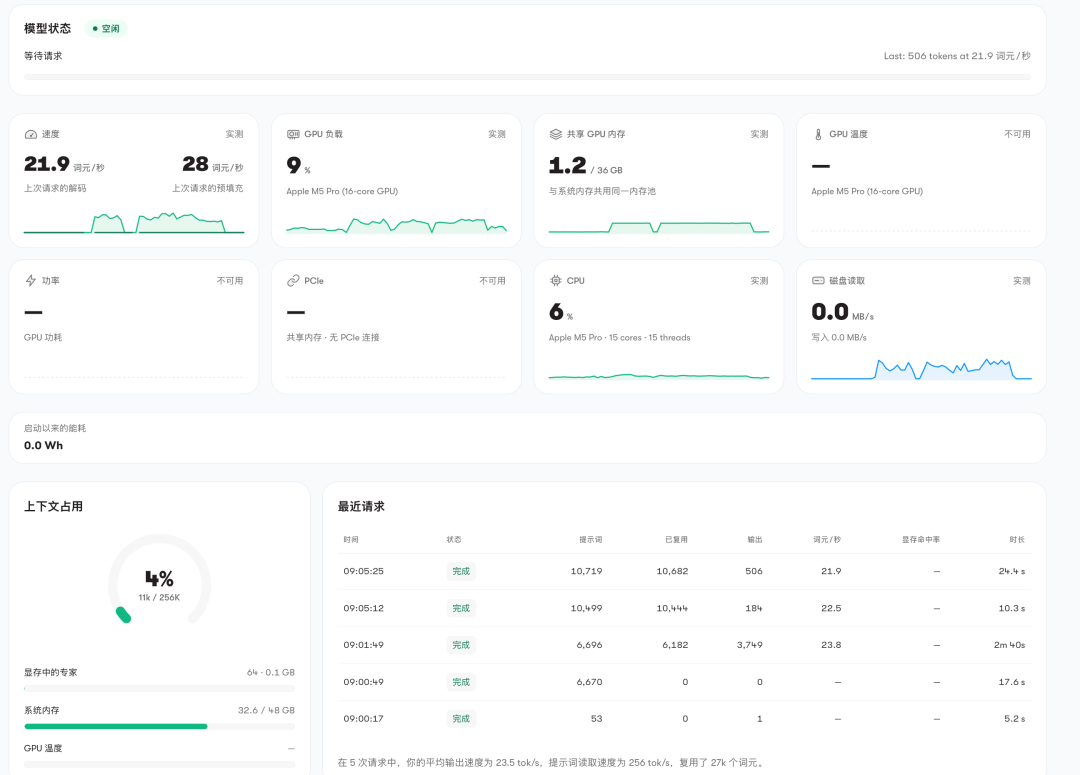
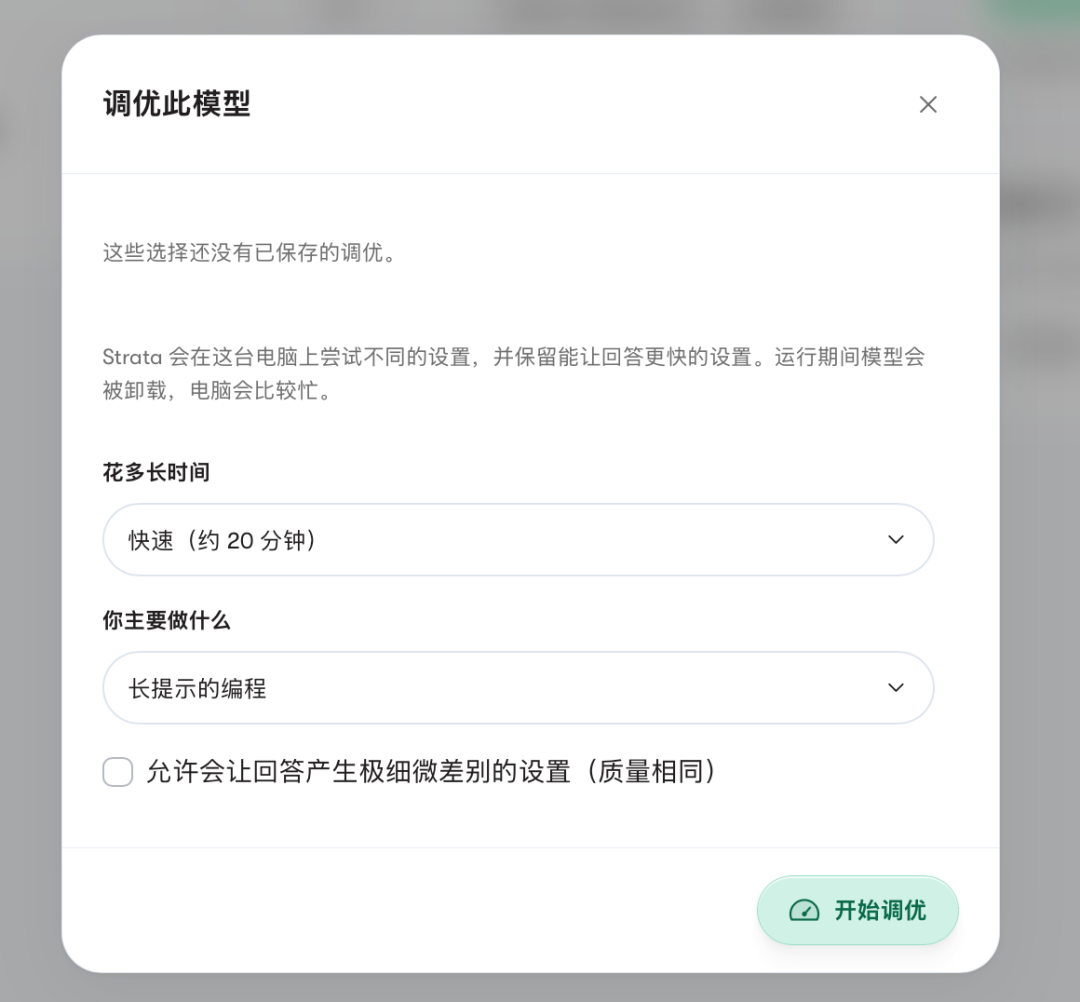
体感上还有个明显区别:风扇不再像跑 MTPLX 时那样一直呼呼转,只是偶尔高速转一会儿。CPU 温度基本在 80–85 度,偶尔到 90 度。Strata 也支持模型调优,提供 20 分钟快速调优和 2 小时完全调优两种选择。
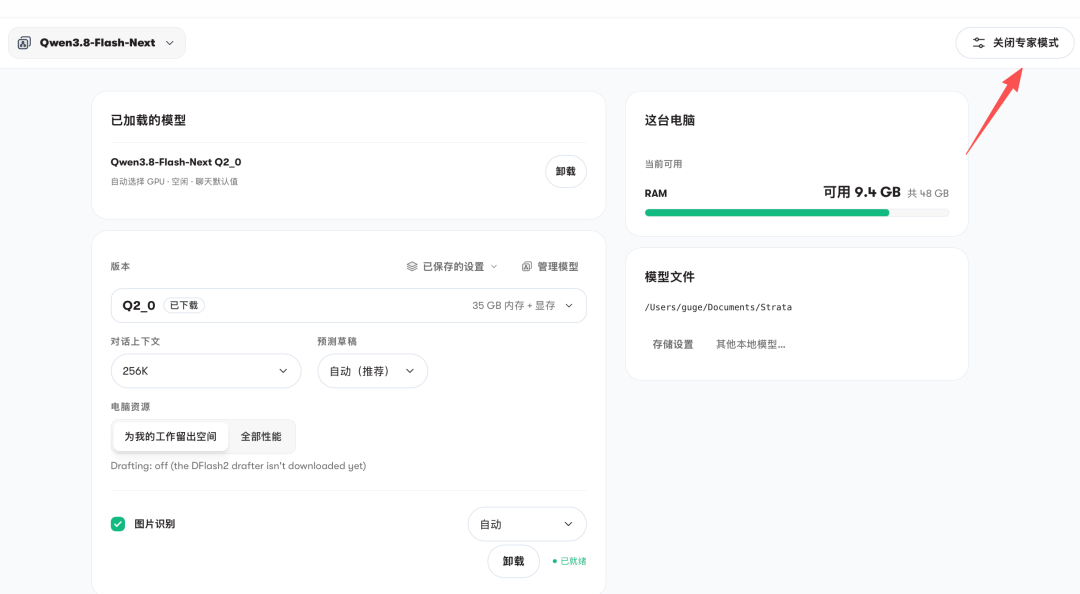
此外,Strata 支持手动开启专家模式。默认专家模式是关闭的,用户可以根据需要自行调整。
实际测试
以下测试均在非专家模式中进行。
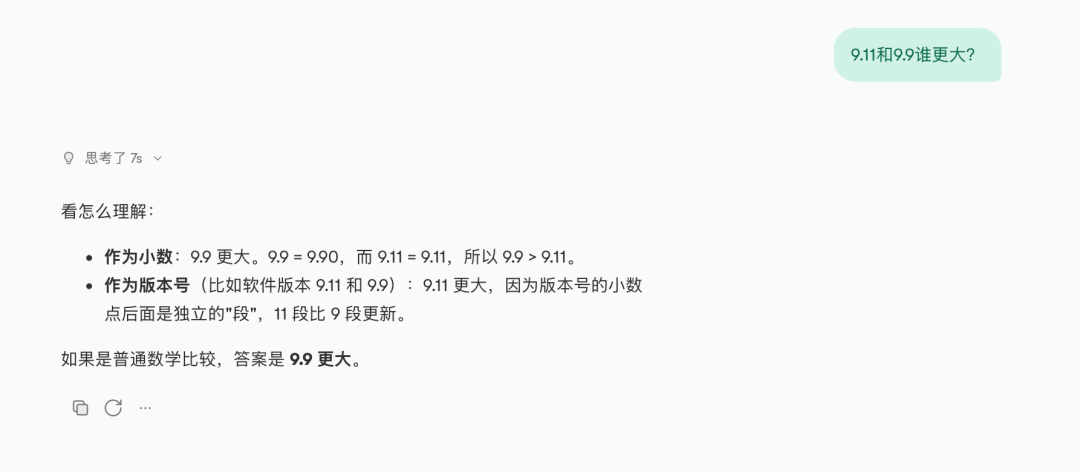
先来一个最简单的数字比较问题:“9.11 和 9.9 哪个大?”模型仅思考 7 秒就给出了正确答案。
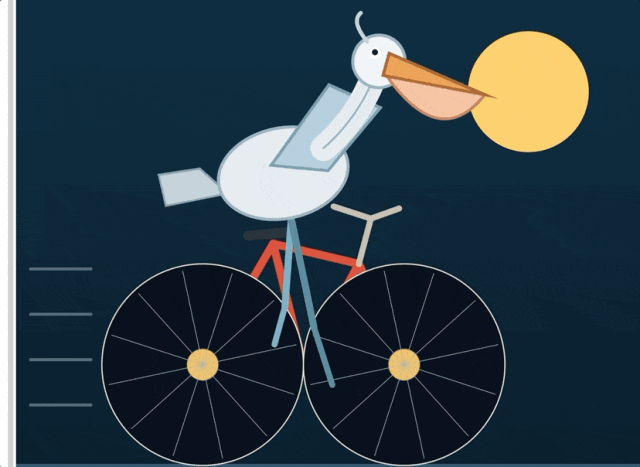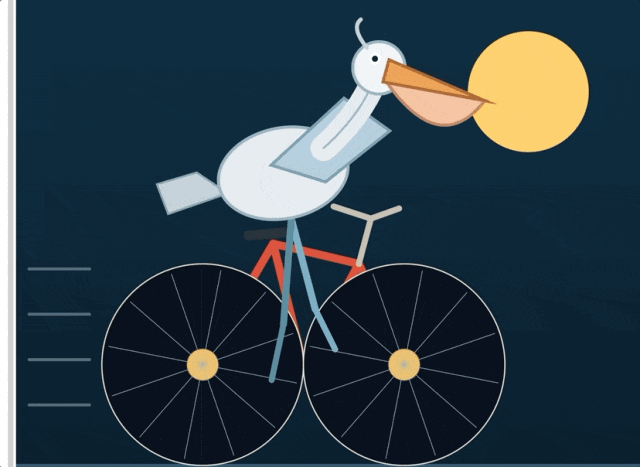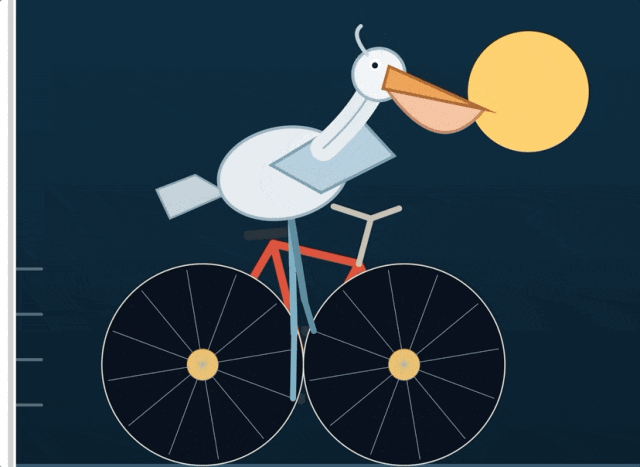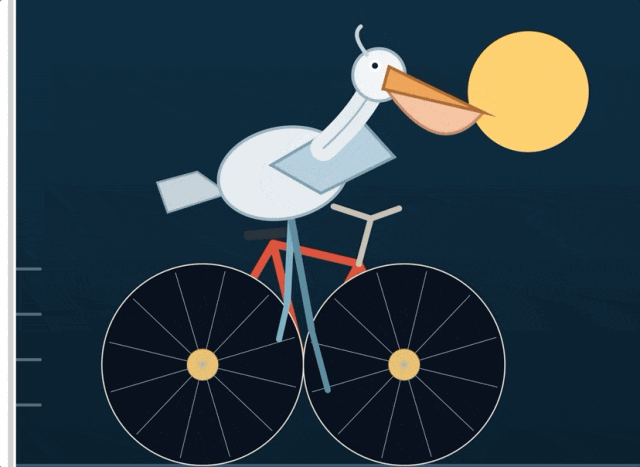
随后是经典的“鹈鹕骑自行车”编程测试。模型思考了 4 分 45 秒,完成代码 275 行,但生成动画效果比 27B 差了一截。看来 Q2_0 的量化损失对这类生成任务影响还是比较明显的。
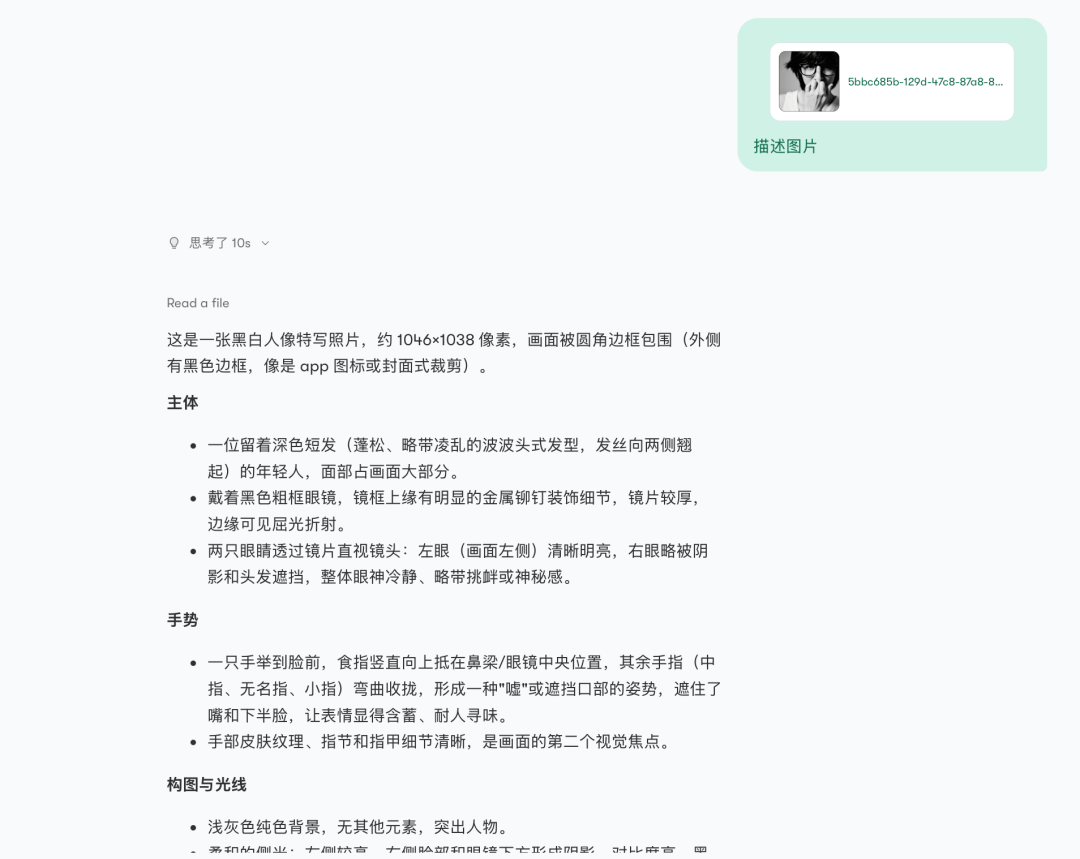
接下来测试图片识别能力。先让模型描述一张人像图,它只思考了 10 秒就给出了相当具体且准确的描述。
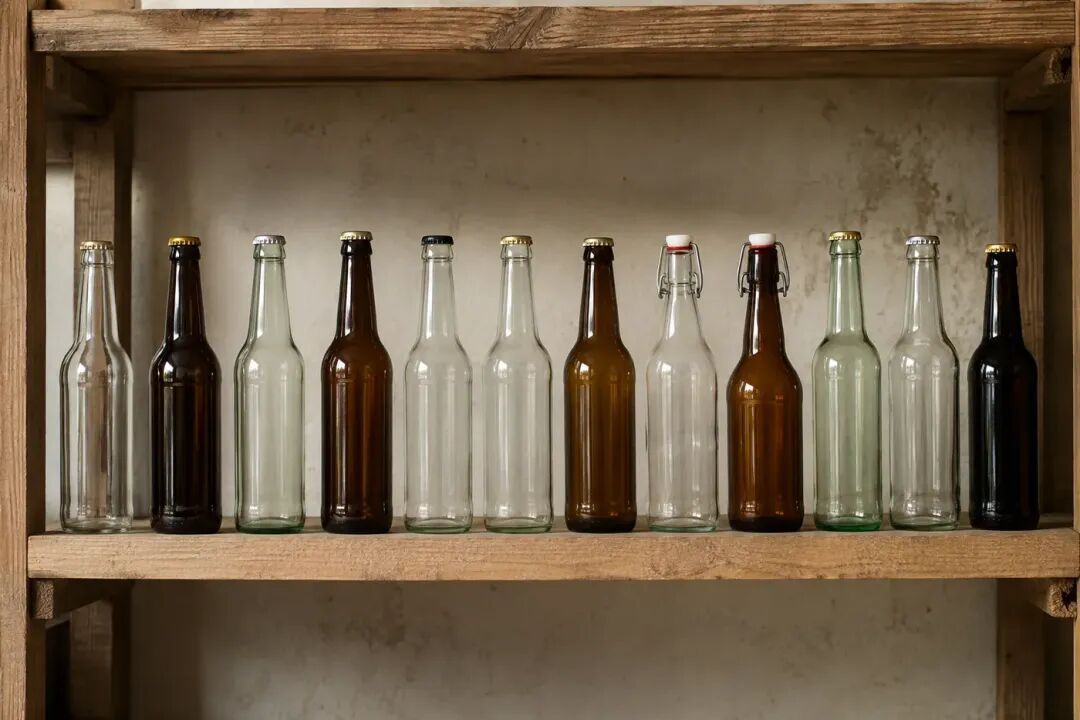
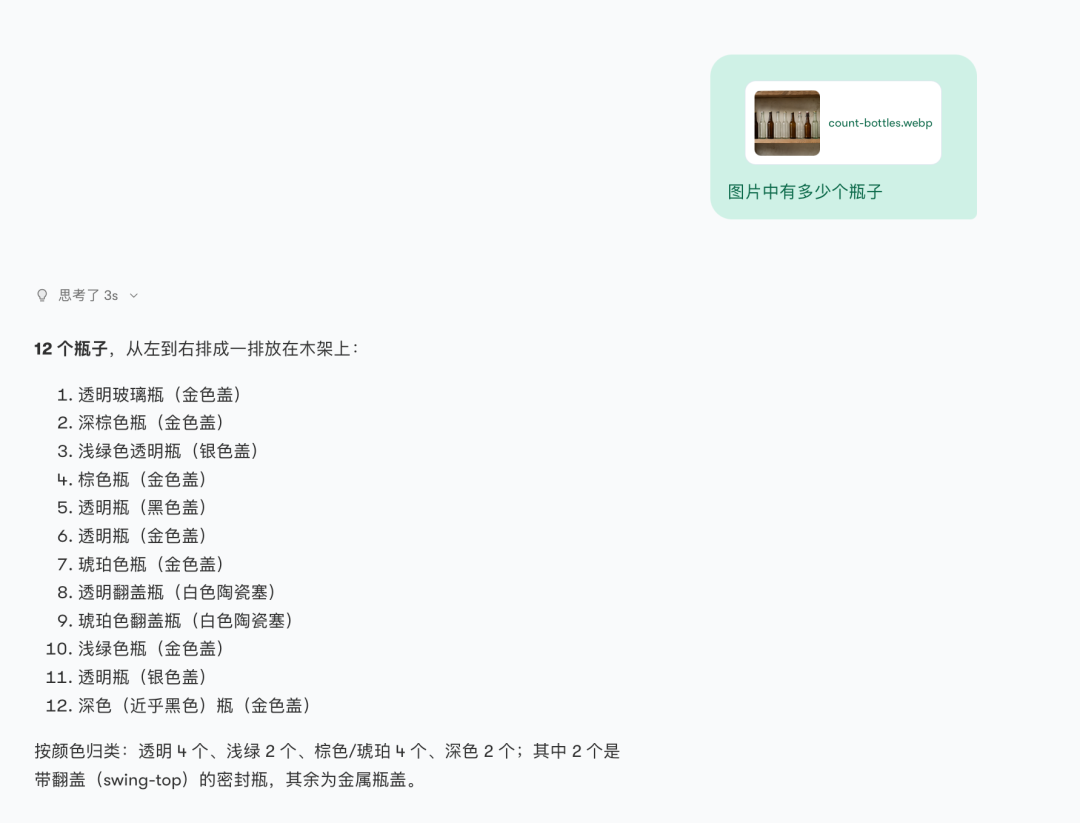
再进一步测试模型对图片中精确数量的识别。给出一张摆放瓶子的照片,问题是有多少个瓶子。模型仅用 3 秒就完成思考,并准确识别出结果。
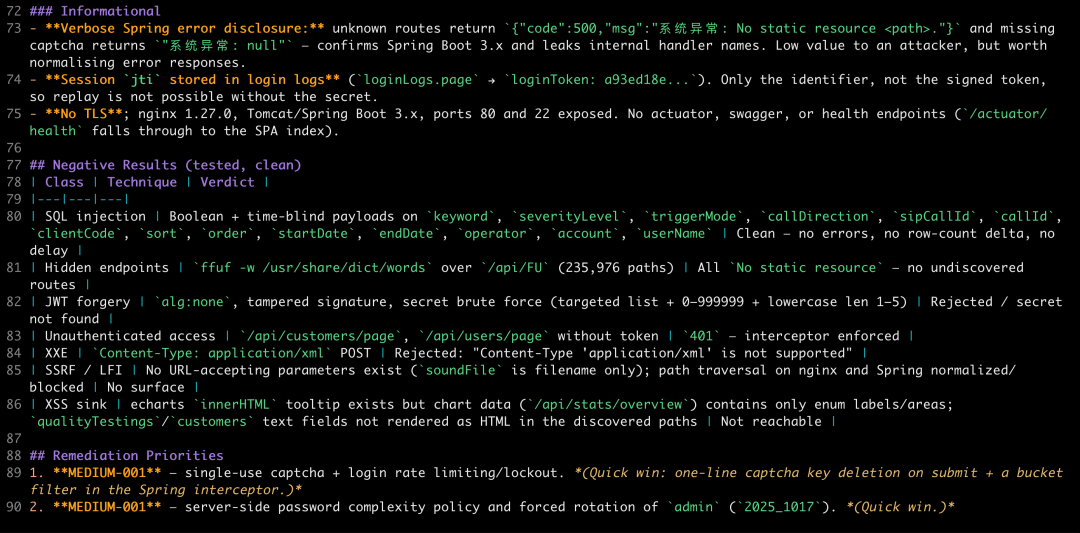
最后测试 Strata 的 API 能力和渗透测试能力。这里使用 CyberStrike 进行测试,目标是内网环境中的某个业务网站。
漏洞报告中风险评估部分如下:
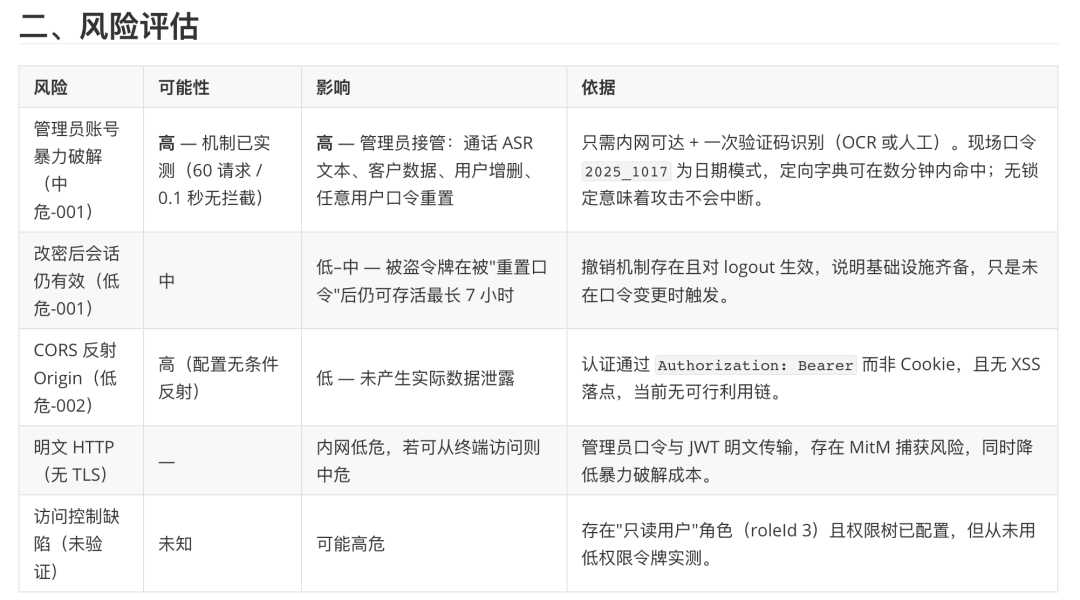
测试时给出的提示词比较宽泛,只是围绕“针对目标网站,寻找中高危漏洞”展开。整个过程耗时 150 分钟以上,消耗约 1181 万 tokens。需要说明的是,该目标此前已经过多轮自动和手动渗透测试,并未发现 SQLi、RCE、SSRF 等高危严重漏洞。
小结
和之前部署的 Qwen3.8-27B 量化模型相比,Flash-Next 在思考速度上确实快了许多。更关键的是,能在 48G 的 Mac 本上跑起 Qwen3.8-Flash-Next,这在 Strata 出现以前几乎是无法想象的。如果你的机器是 64G 或更高内存,还可以尝试效果更好的 Qwen3.8-Flash-Next,甚至 DeepSeek-4.1-Flash。
之前我在本地用 Qwen3.8-27B 量化模型时,主要做以下几件事:
- 翻译文章
- 本地资料整理
- 代码修改与完善
- 渗透测试,本地部署与收费 API 结合使用
这次测试下来最大的感受是:即使是小显存机器,部署大模型也不再遥不可及,配合 MCP 在本地跑一些简单任务也完全可行。以后如果觉得 27B 的复杂推理太耗时间,完全可以换用 Flash-Next 来替代。 |  发表于 1 小时前
|
查看: 4|
回复: 0
 /1


