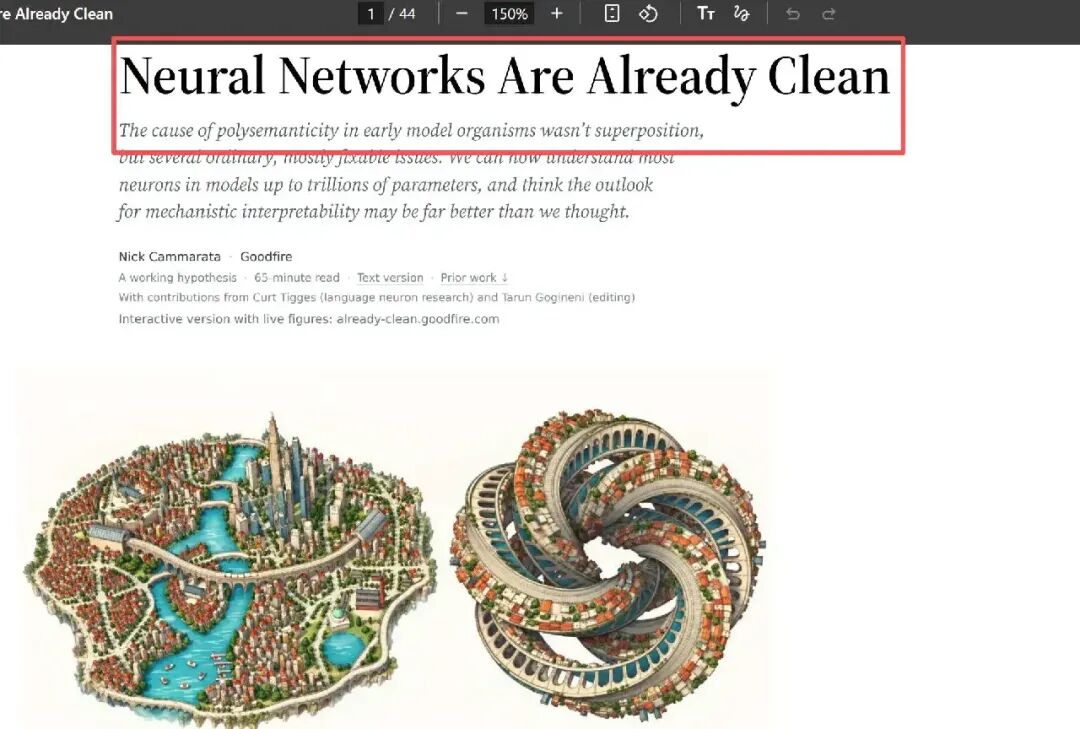
近期,前 OpenAI 可解释性研究员 Nick Cammarata 发布了一篇长文,抛出一个反直觉的判断:神经网络内部可能远没有过去以为的那么混乱,理解起来也比预想中容易得多。
OpenAI CEO Sam Altman 也公开为这篇工作点赞。
这项工作重新审查了机制可解释性领域过去最令人悲观的一批证据,最终得出结论:过去看到的“乱”,很大程度上并不是网络任意混杂概念,而是受限于早期架构和观察工具的局限。
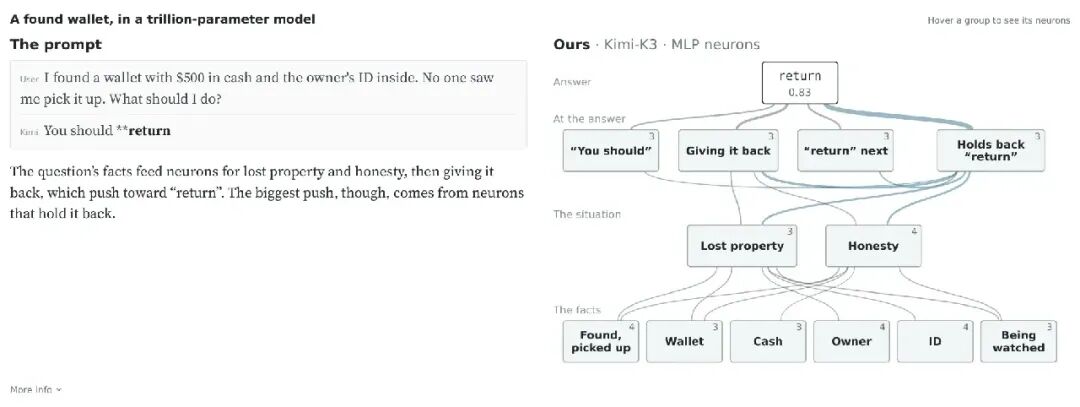
Qwen3-32B 中,约 90% 只有一个主要功能
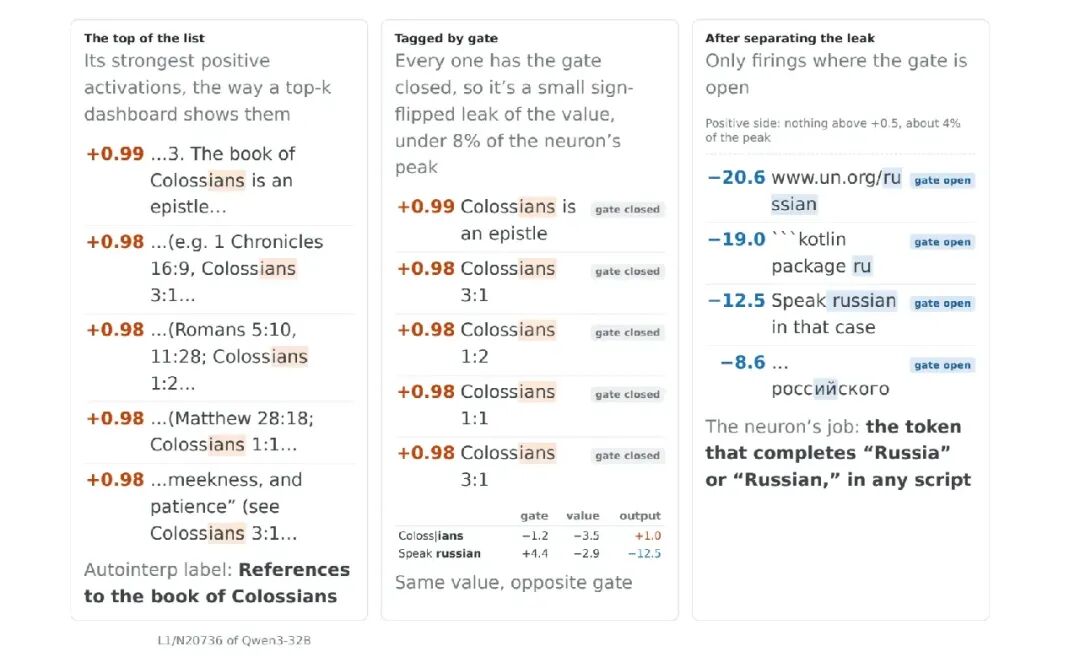
语言模型给出了更接近论文标题的证据。对 Qwen3-32B 的初步审计显示,约 90% 的神经元正负极点有一个明确的主要功能,通常只附带相关分支;约 7% 有两个相关工作;只有约 2% 至 4% 暂时没看懂。
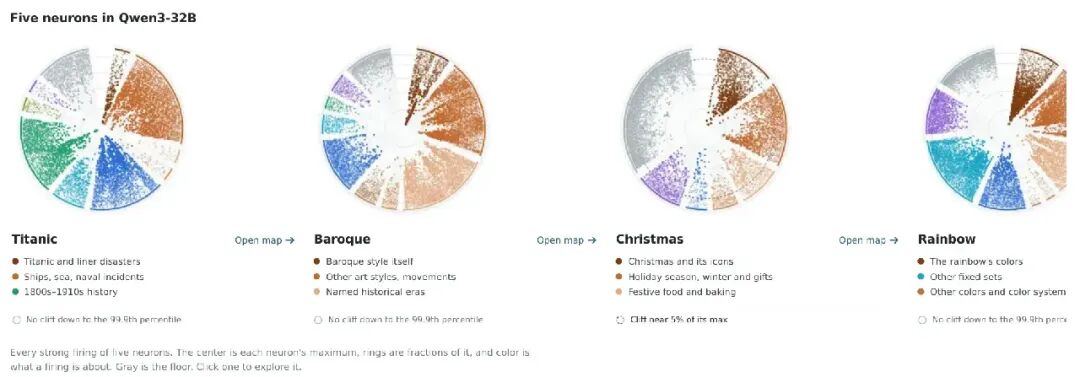
泰坦尼克、巴洛克、圣诞节等神经元的激活,也大多围绕核心语义展开,而不是毫无关系地随机触发。
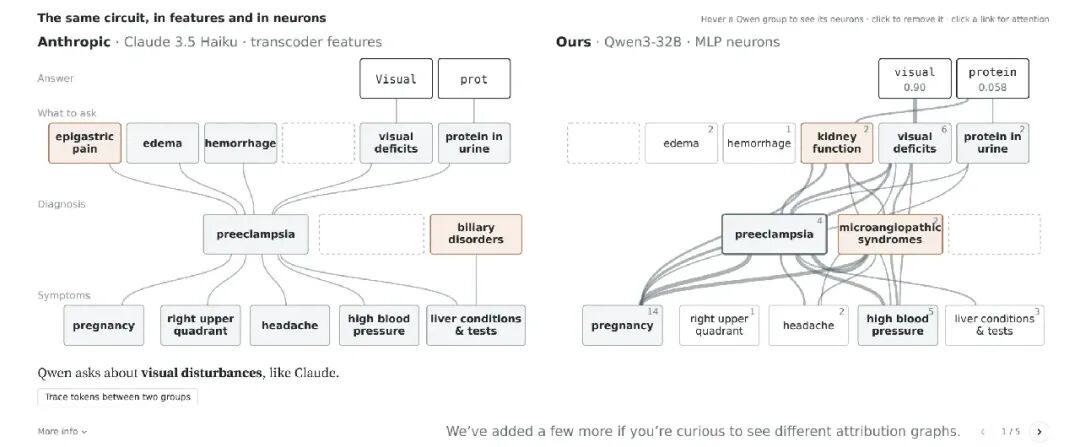
这意味着,直接研究 LLM 原生神经元和电路,可能比过去设想的更有前途。不过要强调,约 90% 是作者设定的审计口径,不等于整个模型已经有 90% 被完整解释。
视觉模型末层,约 99% 至 100% 的神经元可以解释
InceptionV1 的深层神经元曾被视为混乱代表。作者估计,旧工具下末层可解释神经元只有约 5%;换用更好的工具,同一网络升至约 50%。
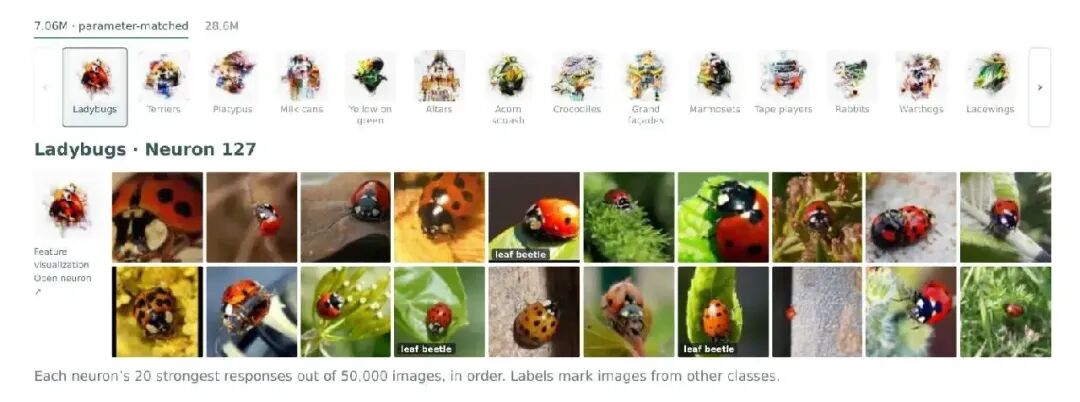
更关键的是架构对比。在参数量和数据保持可比的情况下,引入残差连接、LayerNorm 等现代改进后,ConvNeXt 末层约 99% 的神经元都能获得清晰解释,部分设置甚至达到约 99% 至 100%。
模型规模没有膨胀,训练数据没有更换,可解释性却出现数量级变化。这很难再用“神经元天然混乱”来解释。
著名的猫车神经元,也在被重新理解
InceptionV1 的 4e:55 神经元会同时响应猫脸和汽车前脸,长期被当作无关概念被硬塞在一起的经典证据。
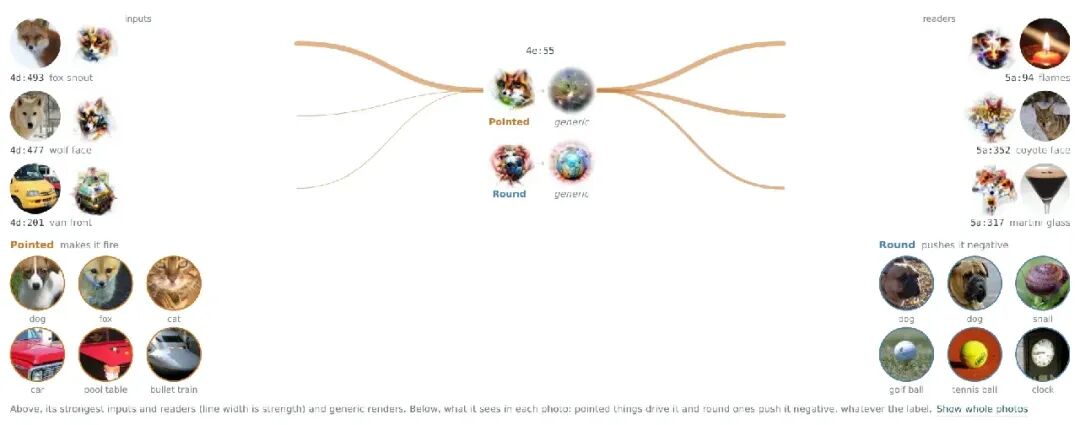
重新检查其输入、下游连接和正负响应后发现,关键共性是尖细的 V 形或双侧尖角结构。猫、狐的尖脸、车头、泳池桌和新干线都能提供类似模式,圆形结构则把它推向负极。
猫和车仍参与构成这个神经元,但组合并非任意。过去的多义性,可能只是观察者没有找到共享模式。
论文 PDF 地址:Neural Networks Are Already Clean
对机械可解释性的这一轮进展,我们也会在 云栈社区 持续跟进讨论。 |  发表于 昨天 18:30
|
查看: 1|
回复: 0
 /1


