随着 LLM 迈向通用 Agent,动态交互与自主决策日益重要。从失败中提炼可迁移经验,经训练内化出 主动反思与自我修正 的进化能力,是提升其长程交互可靠性的关键。
中国人民大学与新加坡国立大学提出的 Agent-Reflex 将反思建模为可学习的元技能;美团提出的 ReflectPO 则用强化学习把自主纠错变成能力。
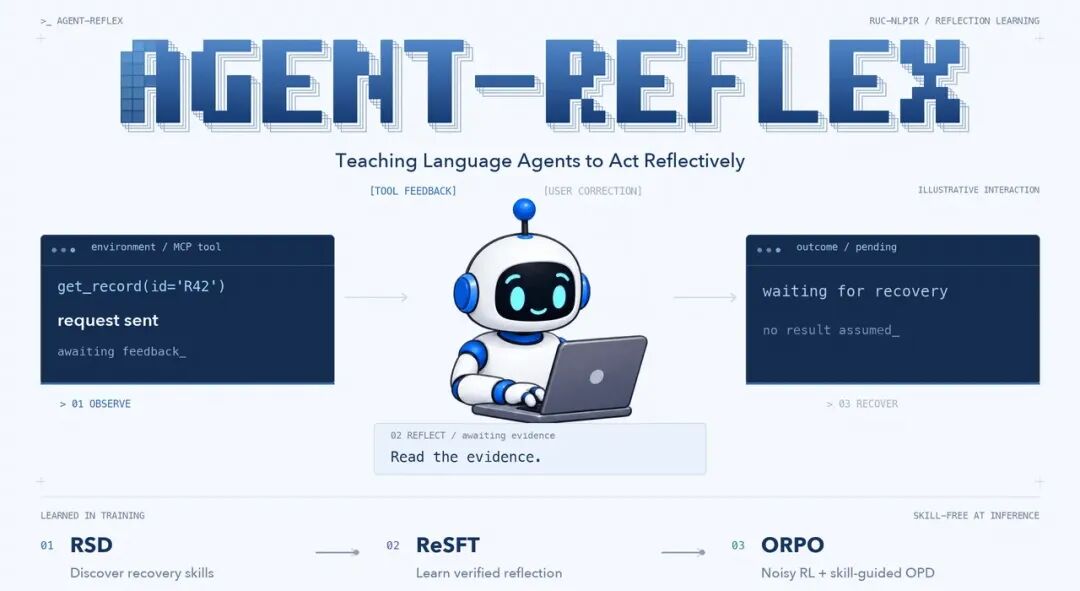
两篇论文指向同一个核心:让 Agent 在执行过程中自己发现错误、自己从错误中恢复,并持续进化。
一、Agent-Reflex:将反思建模为可学习的元技能
Agent-Reflex 由三个核心模块构成:环境反思技能发现(RSD) 在可执行环境中注入源于真实工具错误的扰动,从多模型的成功—失败轨迹对中提炼反思技能;反思监督微调(ReSFT) 围绕局部修复、全局恢复与用户纠偏构建可验证的训练数据,将技能融入模型参数;同策略反思策略优化(ORPO) 结合噪声环境 强化学习 与技能引导的同策略蒸馏,进一步强化智能体的主动反思行为。
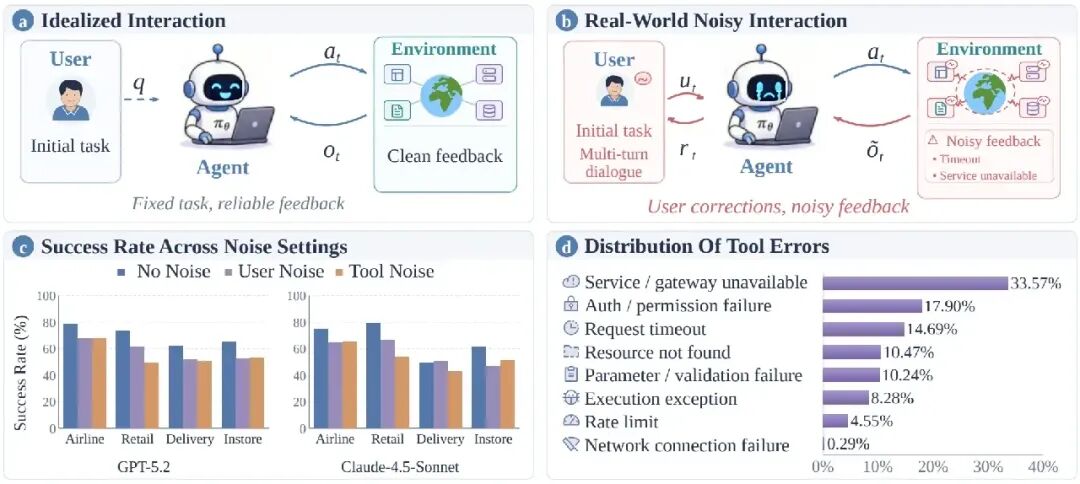
最终,Agent-Reflex 在 557 个环境 中提炼出 1,170 项反思元技能,构建约 5.4 万条监督训练轨迹。基于 Qwen3-8B,模型在五项长程工具使用基准上的 Overall 达到 58.6,在 AgentNoiseBench 上达到 29.1。
代码、模型与数据集均已开源: https://github.com/RUC-NLPIR/Agent-Reflex
从执行失败中提炼可复用经验
Agent-Reflex 从真实工具错误出发,构建包含交互扰动的可执行环境,并通过成功与失败轨迹的对照,将执行经验提炼为可复用的反思元技能。
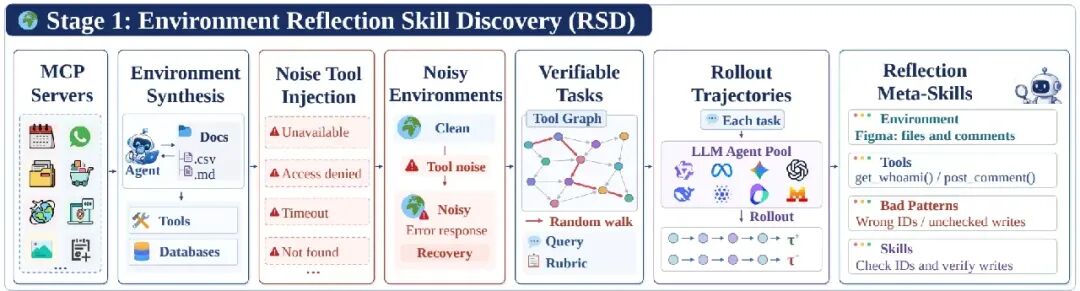
研究团队从公开智能体基准的交互中收集 177,700 条工具返回,其中包含 24,510 条错误返回,并归纳为八类典型故障。系统将与当前工具兼容的错误注入反馈,保留能够验证任务完成与失败恢复的样本,使训练覆盖真实交互中的不确定性。
系统使用来自五个模型家族的九个模型采样轨迹,在同一任务内匹配成功和失败轨迹,识别反复出现的错误模式,并总结对应的诊断依据与恢复动作。一次执行中的教训,由此转化为可复用的操作规则。
ReSFT 与 ORPO:把恢复经验融入策略
获得反思技能库后,Agent-Reflex 通过三类可验证的恢复轨迹,将显式经验转化为模型能够自主执行的反思行为。
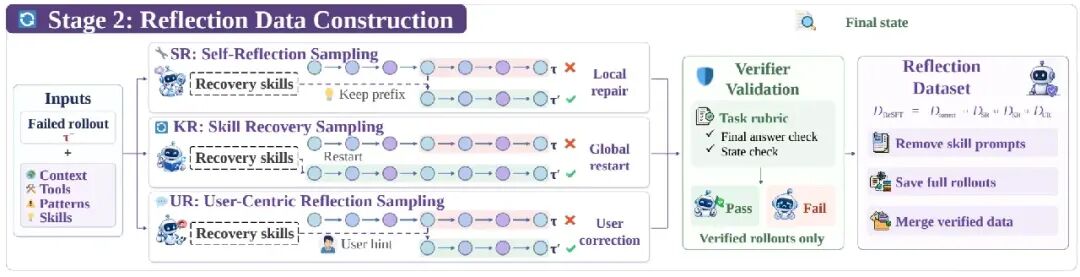
自我反思采样(SR) 定位失败轨迹中的首个错误回合,从错误动作执行前的状态继续执行;技能恢复采样(KR) 将环境重置到初始状态,让模型结合反思技能重新生成完整轨迹;用户中心反思采样(UR) 将反思技能转写为自然语言纠正消息,引导模型完成后续任务。三类策略分别对应局部修复、全局重规划与用户纠偏。
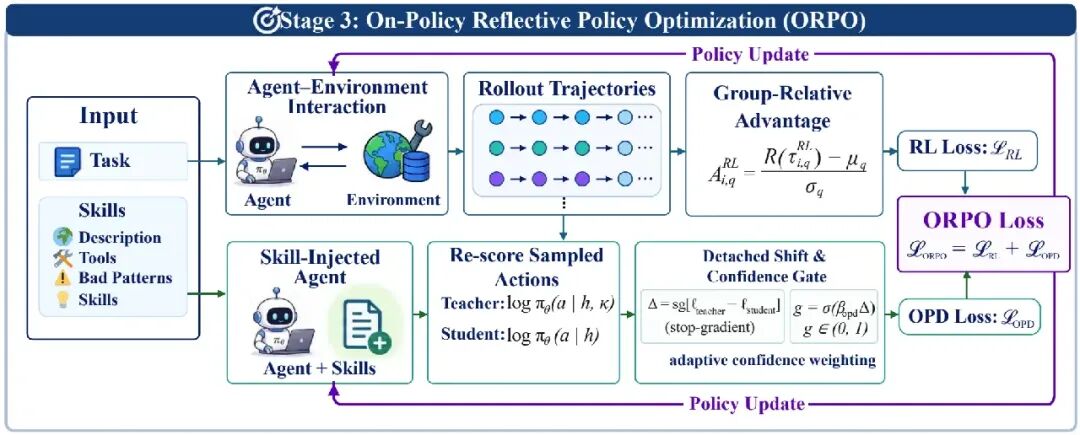
在 ReSFT 建立初始能力后,ORPO 进一步结合噪声环境强化学习与技能引导的同策略蒸馏。最终,轨迹级任务奖励 与词元级反思监督共同优化模型,使其在自身交互中持续学习恢复与纠错。
六套基准检验长程工具使用与噪声交互能力
Agent-Reflex 以 Qwen3-8B 为基础模型,在 VitaBench、τ²-Bench、BFCL V4、ACEBench、ToolSandbox 与 AgentNoiseBench 上评估。
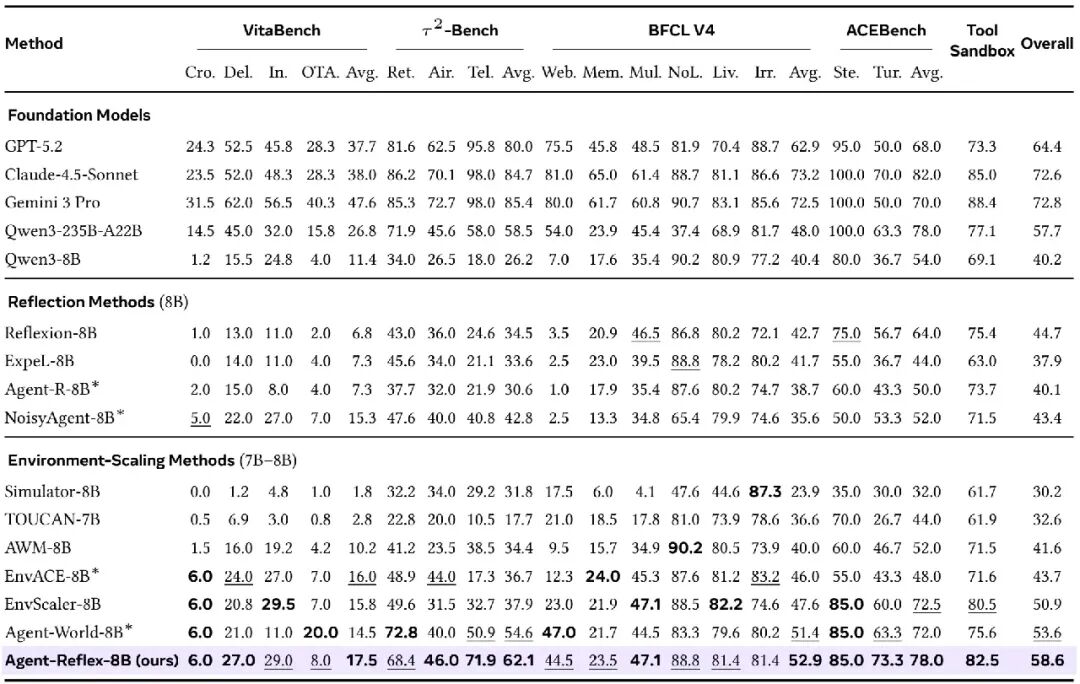
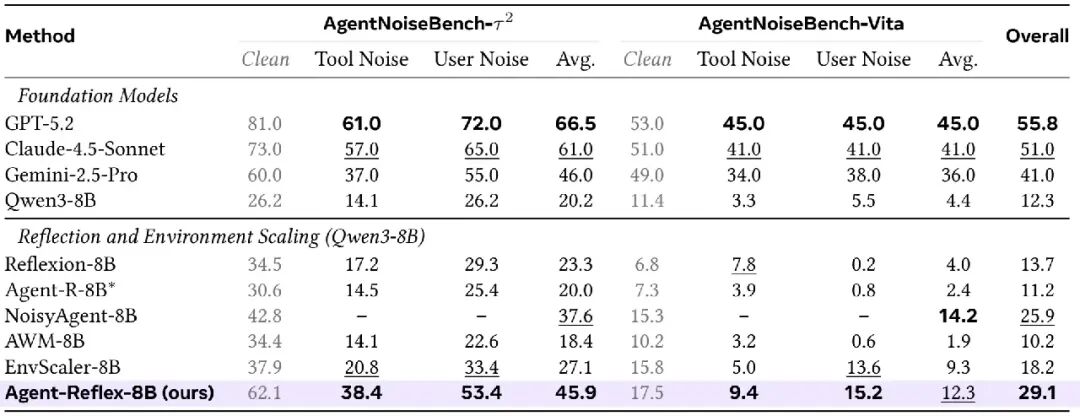
Agent-Reflex-8B 的 Overall 达到 58.6,较 Qwen3-8B 的 40.2 提升 18.4 分,较 EnvScaler-8B 提升 7.7 分,较 Agent-World-8B 提升 5.0 分。面对工具与用户两侧的扰动,Agent-Reflex 的 Overall 达到 29.1,在表中比较的 8B 方法中取得最高整体得分。
二、ReflectPO:先找到该反思的位置,再从那里重新出发
长时程任务的困难不只是步骤多。每一步工具调用都会返回观测、改写环境状态,错误因此具有放大效应。自然产生的交互轨迹里其实已经藏着反思信号:不同轨迹的分支差异说明局部行为值得复核,单条轨迹的重复访问则说明模型陷入了循环。
ReflectPO 先把交互过程切成交互节点,在末尾保存环境快照,以便从该位置继续执行。对比式采样把同一任务的多条轨迹组织成前缀树,选一条走得最差的目标轨迹和一条更好的参考轨迹,生成反思提示;循环式采样把单条轨迹组织成有向图,在节点被再次访问时总结重复行为、给出替代方案。
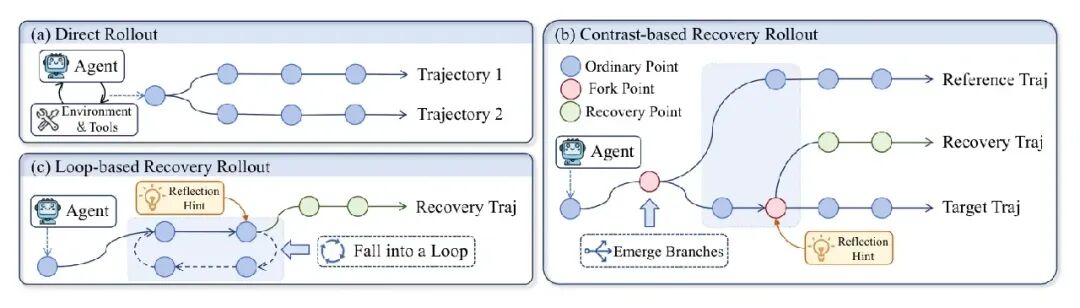
两种策略都是先定位值得复核的位置,再生成反思提示,最后由策略从环境快照继续执行。反思提示只在训练阶段使用,部署时不需要额外提示。
树结构信用分配:让纠错动作获得准确信号
树结构信用分配把原始轨迹按前缀组织成一棵树、把恢复轨迹与它要修正的目标轨迹一一配对,再分别计算两类动作的优势。
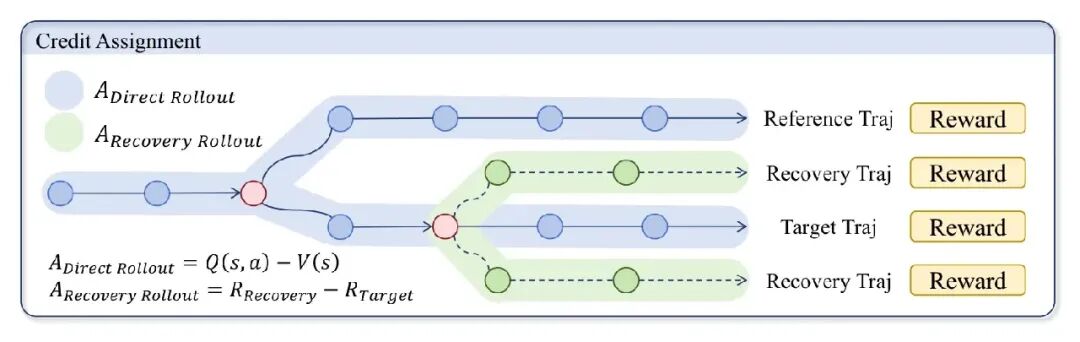
原始轨迹上的动作在分叉点比较不同子分支的平均最终奖励;恢复轨迹上的动作用两条轨迹最终奖励之差衡量这次纠错带来的增量。两类信号一起参与策略更新,纠错行为因此能被稳定地强化。
在 BFCL-v3 Multi-Turn 与 τ²-Bench 上,Qwen3-4B 的总体成绩从 33.2 提升到 36.6,Qwen3-8B 从 39.6 提升到 45.4。相比只做结果级优化的 Reinforce++,ReflectPO 把步骤恢复率和完全恢复率分别提升了 2.49 和 2.70 个百分点,说明它是真的把错误改回来,而不只是少犯错。
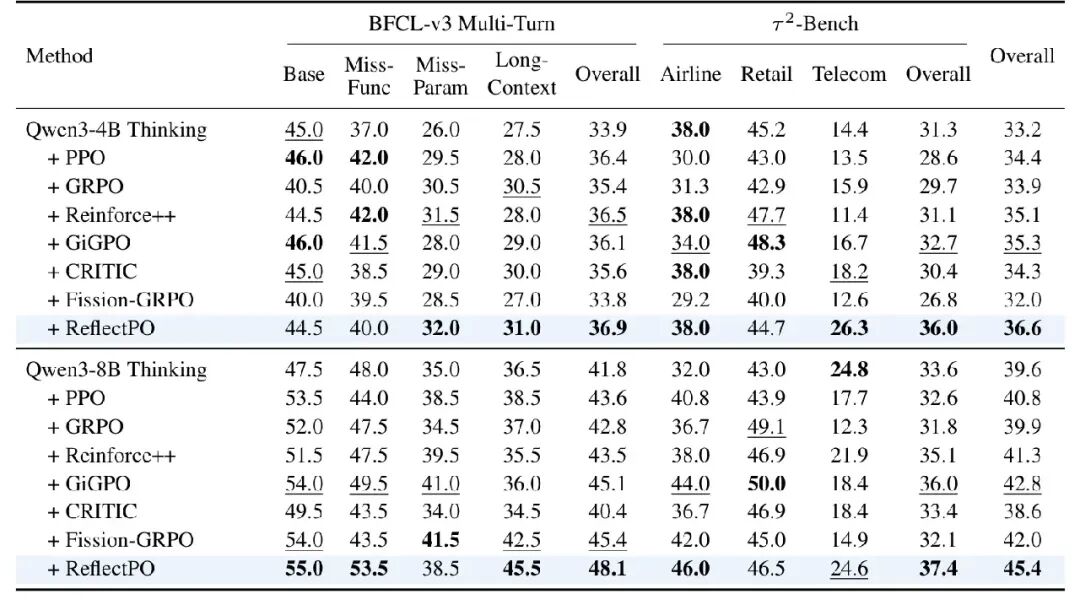
Agent-Reflex 建立了工具错误挖掘、反思技能提炼、可验证恢复训练、同策略反思优化的训练流程;ReflectPO 则让纠错从推理阶段的附加环节变成训练过程的一部分。对长时程智能体而言,出错之后能否发现并修正,是开放环境中长期可靠执行的前提。类似的前沿工作,云栈社区 上也有开发者在跟进讨论。
Agent-Reflex: https://arxiv.org/abs/2610.17953
ReflectPO: https://arxiv.org/abs/2610.30933
 发表于 昨天 18:25
|
查看: 1|
回复: 0
 /1


