AI看着自己的脑子改写自己,这一天还是来了!
7630 亿参数的 DeepSeek-V4.1-Flash,直接读取了自己做数学题时最深 7 层的内部激活状态。摸清「快要算偏」的信号规律后,它在不改半个权重的前提下,亲手写了一段 Python 代码塞进推理流程「读脑自救」——只要发现思路跑偏就当场回滚重算,在 AIME 与 HMMT 2026 数学竞赛上,准确率原地暴涨 7 个百分点。
而这,还只是今天刷屏 AI 圈的 DoubleAI 重磅研究里的一个切面。
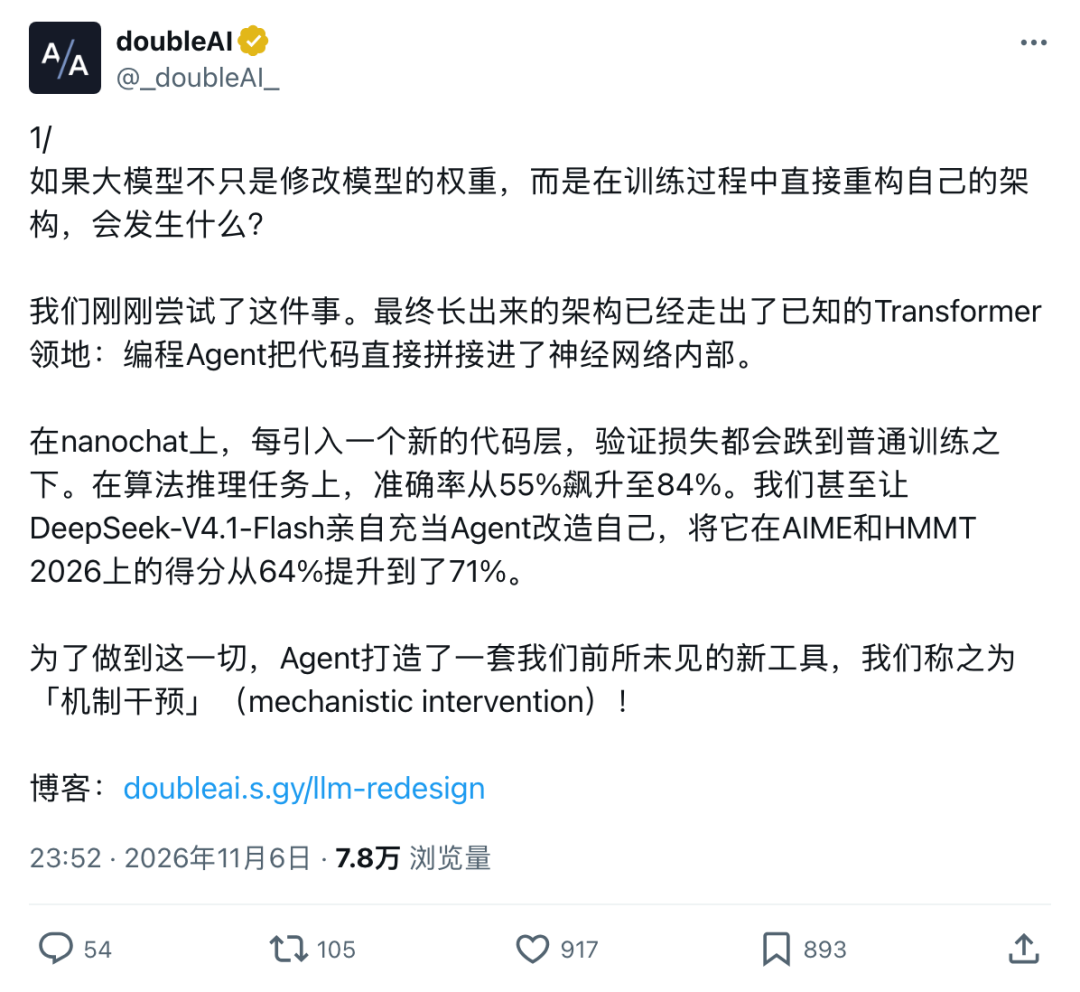
这家由 Mobileye 创始人 Amnon Shashua 创立的 AI 机构,首次提出了一个颠覆传统深度学习的新范式——「机制干预」(mechanistic intervention)。
相比以往模型只能在写死的架构里硬调权重,这套方法把编程 Agent 放进了训练与推理现场。在训练中途,哪一层网络卡壳了,Agent 就当场写几行 Python 代码塞进模型主干,实时接管计算。靠着这手绝活,预训练模型只塞入 20 行代码,就在单次前向推理里跑起了梯度下降。连塞 10 层代码后,30 种经典算法的准确率更是从 55% 狂飙到 84%!
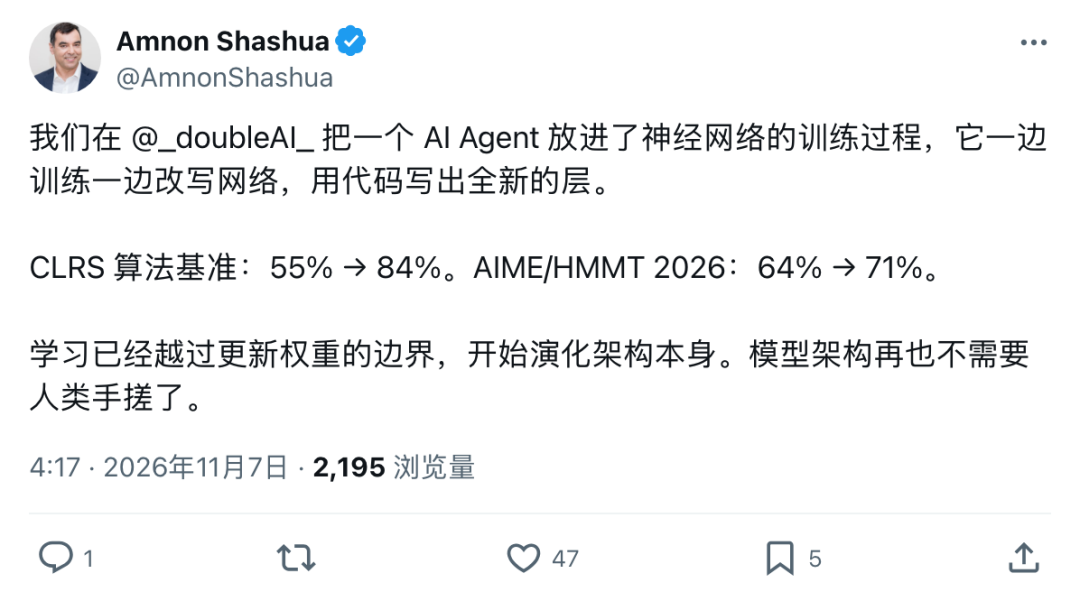
研究一经发布,迅速在 AI 圈引发刷屏热议。创始人 Amnon Shashua 放话,深度学习已经彻底跨过了「只调权重」的旧边界。
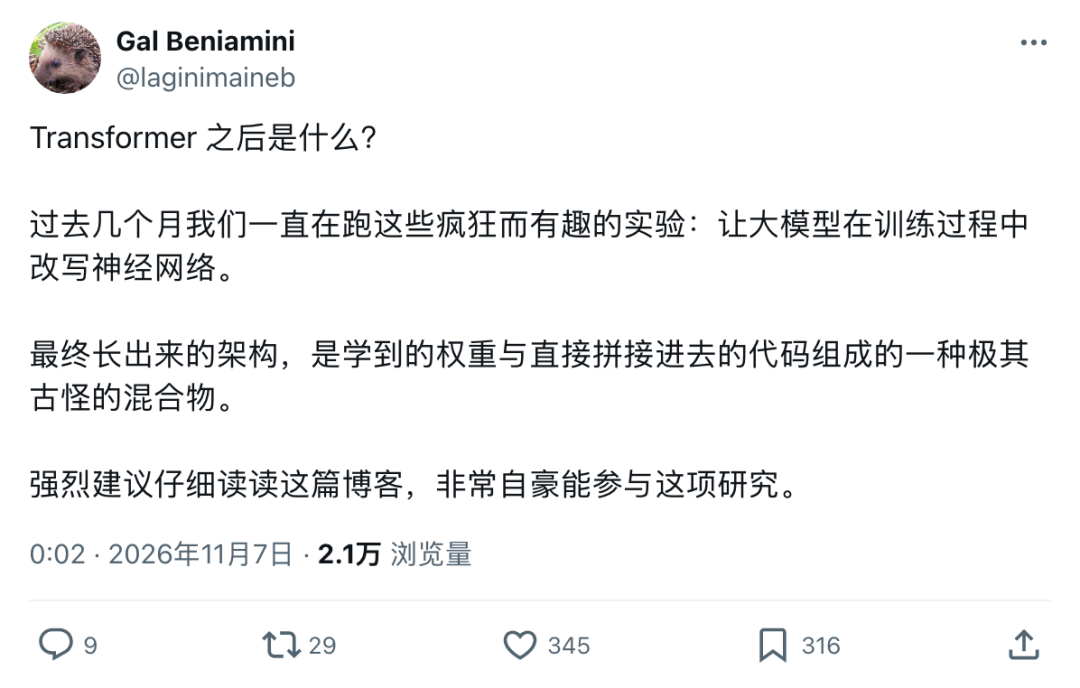
现在,连神经网络架构本身都能在训练中自主进化,人类手搓模型架构的时代翻篇了!联创 Gal Beniamini 更是感叹,当放手让大模型边训练边改写自己,最后长出来的架构连研究员都觉得不可思议。它不再是纯粹的神经网络,而是一半来自训练学出的权重,一半来自半路拼接的 Python 代码!
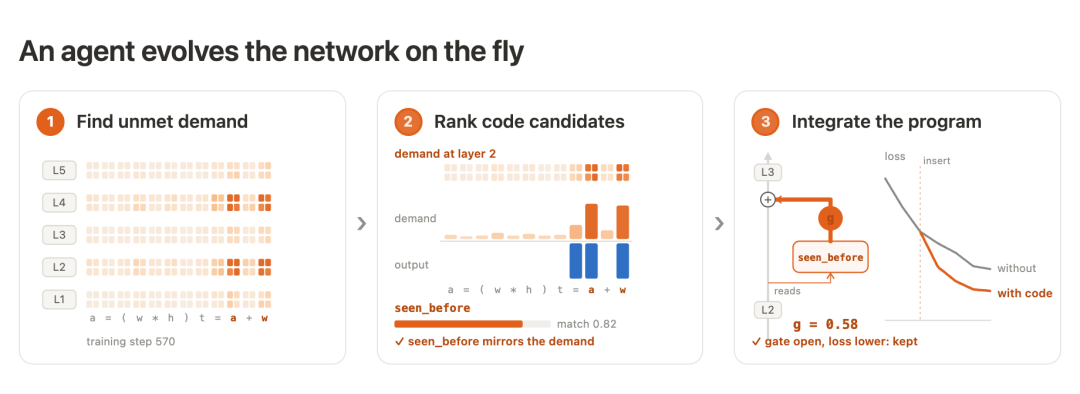
在进入实验细节之前,我们先来看看这套「机制干预」到底是怎么运作的:
- 第一步是找瓶颈——Agent 实时读取每层网络的梯度信号,揪出靠调权重学不会的短板。
- 第二步是写代码——Agent 现场生成几十个候选 Python 函数,实测哪段代码最能帮模型降误差。
- 第三步是热插拔——把胜出代码挂在初始值为 0 的门控后面并入网络,由后续训练自动把门控推开。
塞入20行代码,前向传播跑起梯度下降
第一组实验从语言模型预训练切入,验证训练中途塞入 Python 代码,能否帮模型更快压低预测误差。
在 12 层模型 nanochat 的 1500 步训练中,Agent 先后三次出手塞入 Python 代码层。每次代码一并入,模型预测误差(bpb)就随之连降三次!
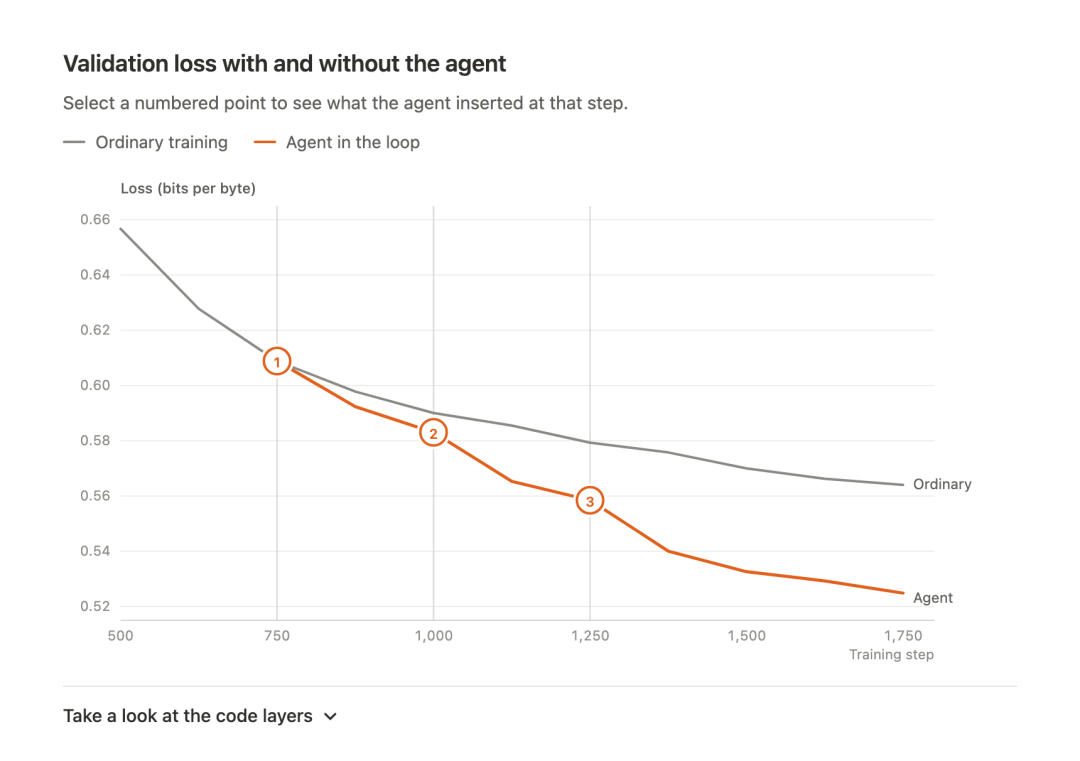
训满 1500 步后,加代码层的模型相当于白赚了 15% 的训练进度。而打乱逻辑的「假代码对照组」与常规训练完全重合,证明提分全靠 AI 写出的代码逻辑。
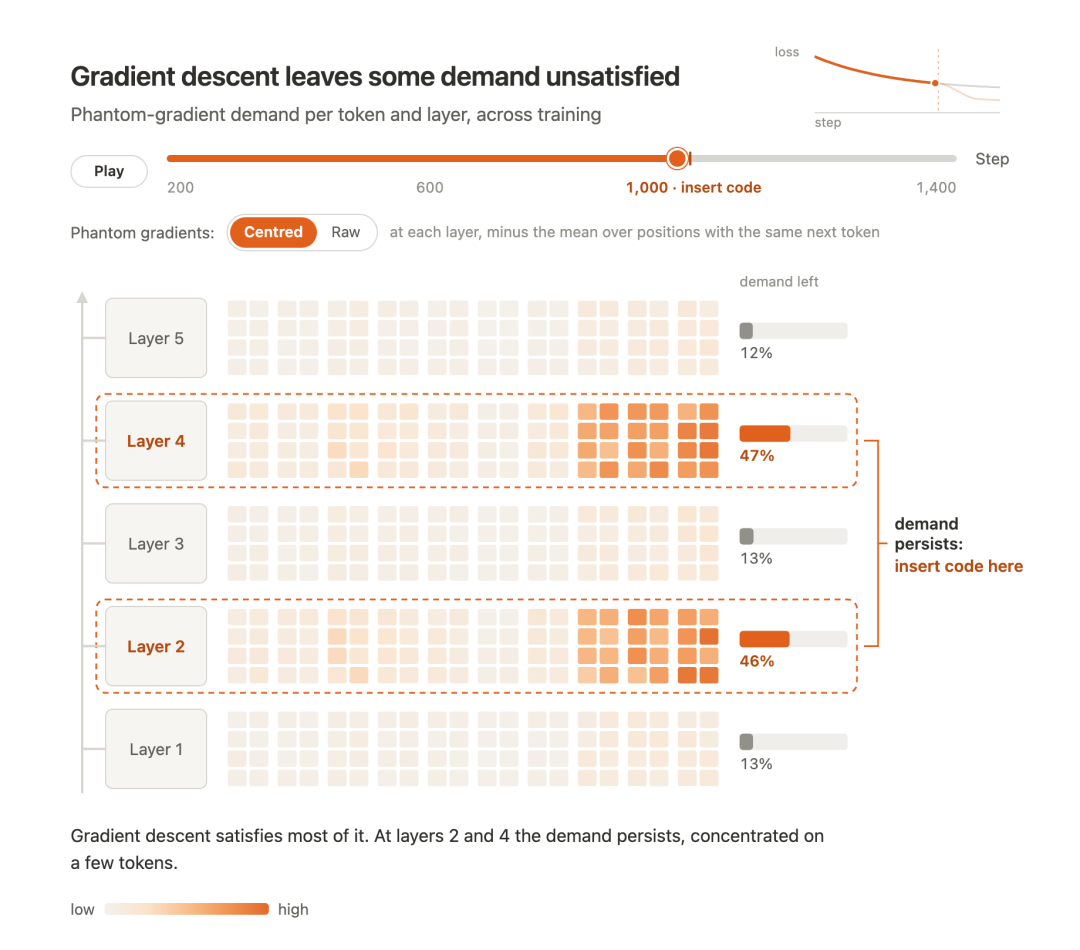
面对 12 层网络,Agent 之所以能找准往哪一层塞代码,靠的是「幽灵梯度」(phantom gradient)。它假想在某层后加个新模块,测算往哪个方向推能让误差下降最快。滤掉常规噪声后,第 2 层和第 4 层的高需求热区便清晰显现出来!
锁定瓶颈层后,Agent 写出几十个候选函数,在单批数据上实测谁最契合第 2 层的梯度方向。
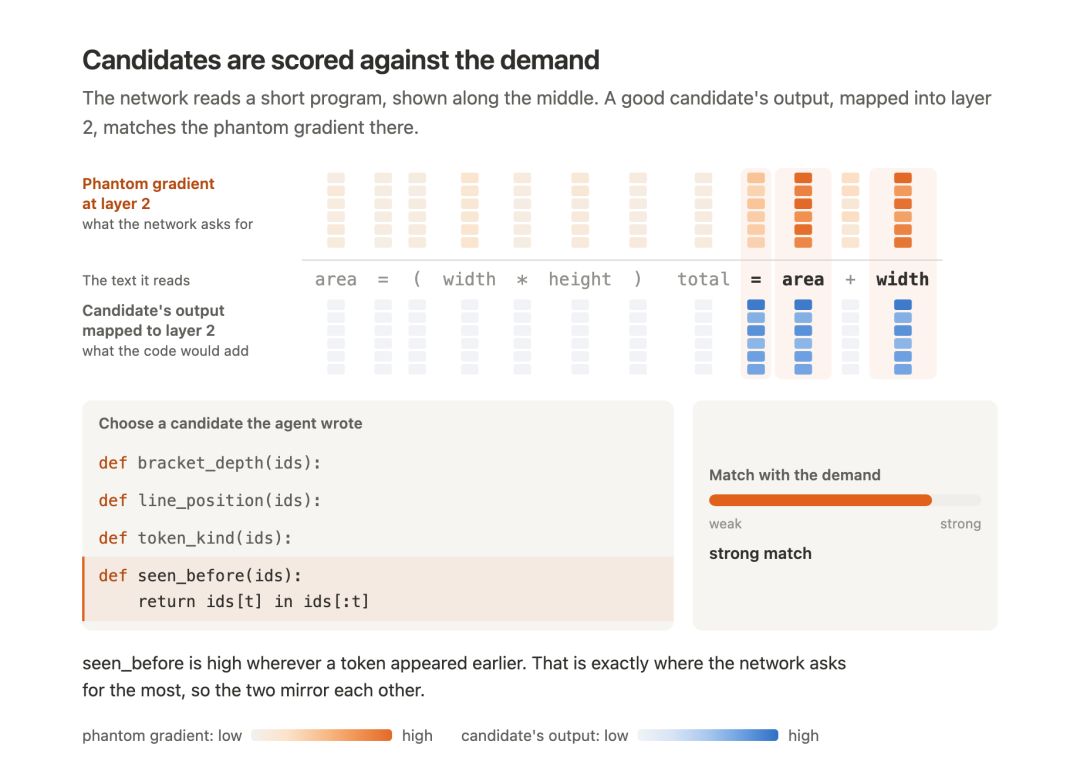
接着,最高分函数挂在初始值为 0 的门控 g 后面并入网络。刚插入时门控输出为 0,原有网络不受影响。但短短 100 步内,梯度下降发现这段代码真能降误差,便自动把门控调整到了 0.58!
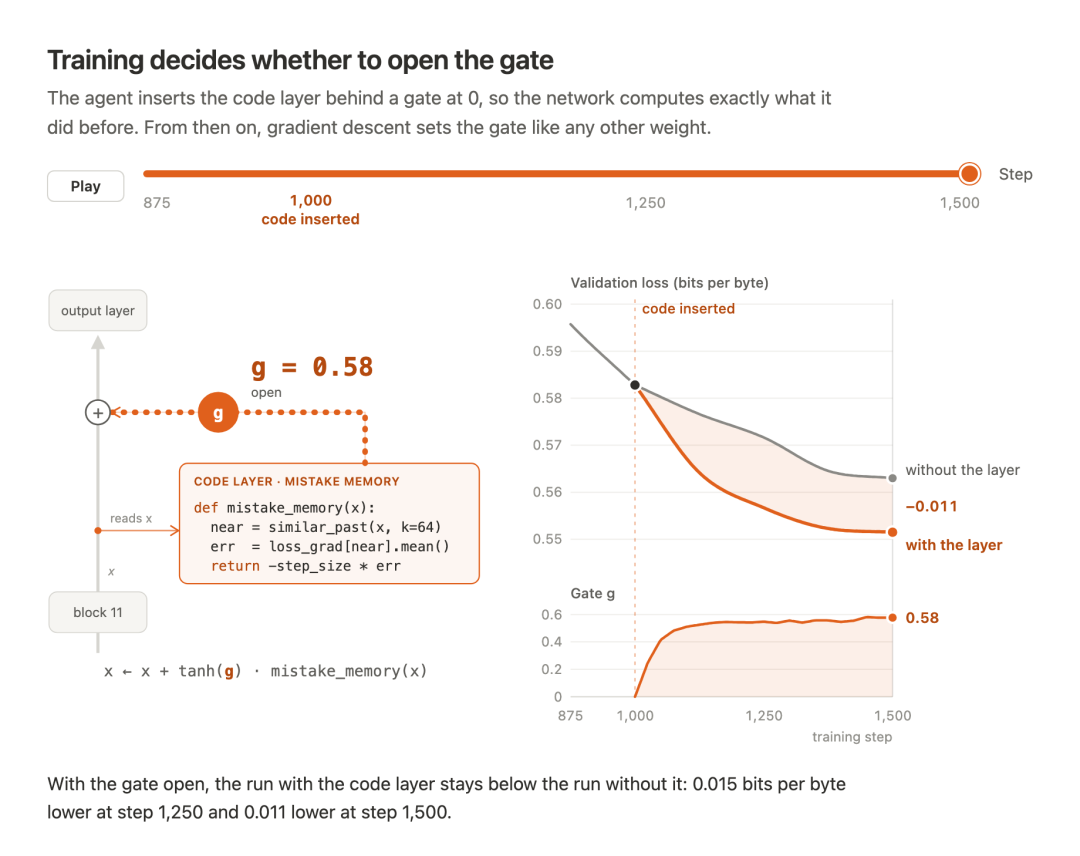
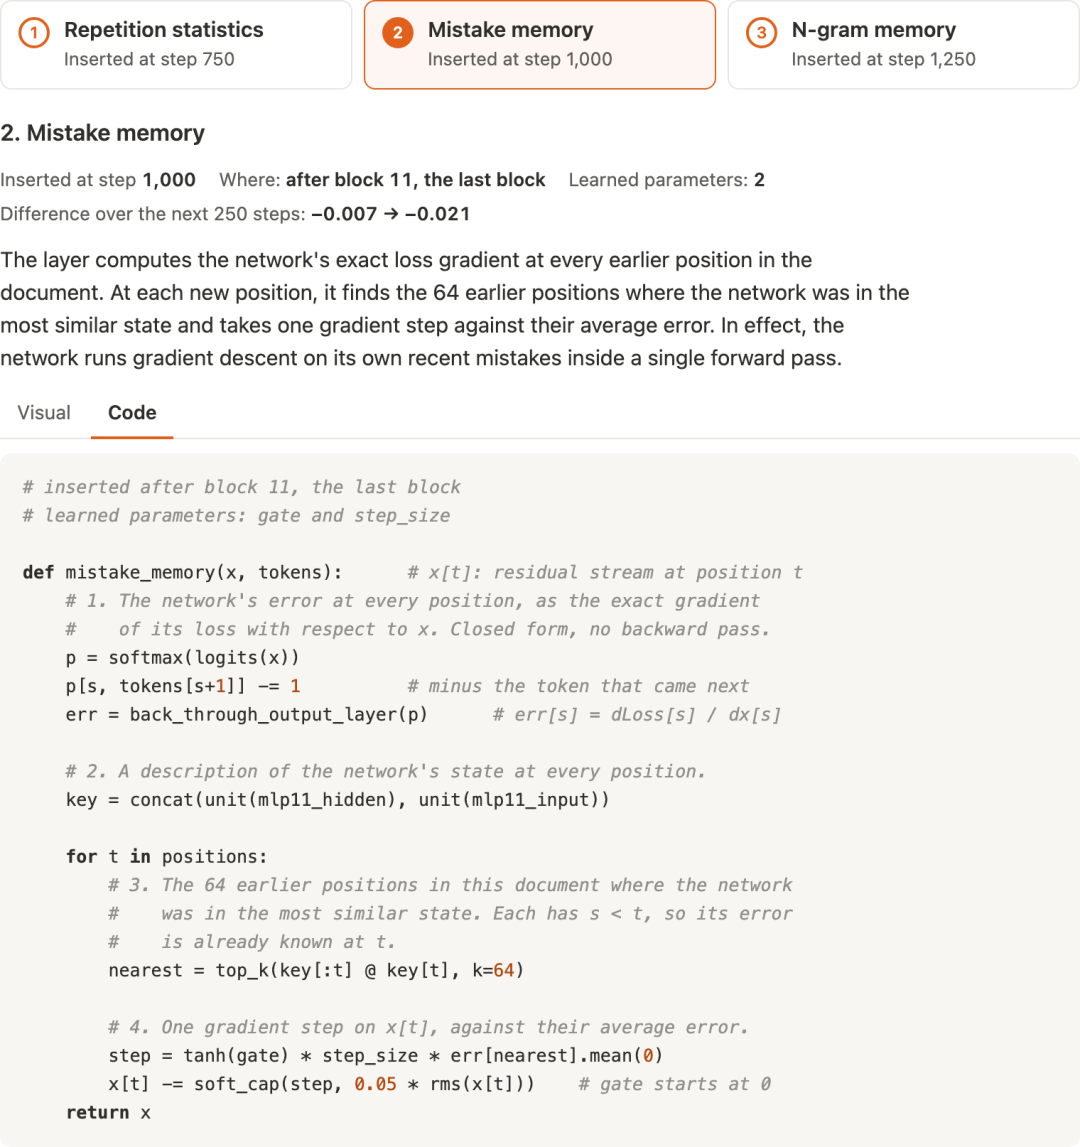
靠着这套流程,Agent 在第 1000 步往末层塞进了一个最惊艳的「错误记忆层」。这短短 20 行代码之所以震撼,是因为它打破了以往「前向只能推理、反向才能改错」的定式!
不用等反向传播,模型边往后读就能边核对前文答案,当场算出预测误差,找出 64 个最相似的犯错位置。紧接着,它直接在脑子里迈出一步梯度下降,在单次前向传播内实现了边读边纠错!
# inserted after block 11, the last block
# learned parameters: gate and step_size
def mistake_memory(x, tokens): # x[t]: residual stream at position t
    # 1. The network's error at every position, as the exact gradient
    # of its loss with respect to x. Closed form, no backward pass.
    p = softmax(logits(x))
    p[s, tokens[s+1]] -= 1 # minus the token that came next
    err = back_through_output_layer(p) # err[s] = dLoss[s] / dx[s]
    # 2. A description of the network's state at every position.
    key = concat(unit(mlp11_hidden), unit(mlp11_input))
    for t in positions:
        # 3. The 64 earlier positions in this document where the network
        # was in the most similar state. Each has s < t, so its error
        # is already known at t.
        nearest = top_k(key[:t] @ key[t], k=64)
        # 4. One gradient step on x[t], against their average error.
        step = tanh(gate) * step_size * err[nearest].mean(0)
        x[t] -= soft_cap(step, 0.05 * rms(x[t])) # gate starts at 0
    return x
训练半路插代码,比天生自带强17分
既然 Python 代码层这么管用,那么从训练第 0 步就把代码层装进模型行不行呢?
然而,第二组实验却测出了一个完全反直觉的惊人反转。
团队把模型的记忆窗口锁死在 500 词以内,考它能不能找回几千词之前的变量赋值。同时,Agent 写了一个能跨窗口查字典的「代码缓存层」,分三种时机装入模型:
- 常规训练基线——超出 500 词窗口的变量全部忘光,召回率考 0%。
- 第 0 步天生自带组——开训前就装好代码缓存层,召回率停在 55%。
- 第 1200 步半路插入组——先练 1200 步再半路塞入同一个缓存层,召回率冲上 72%!
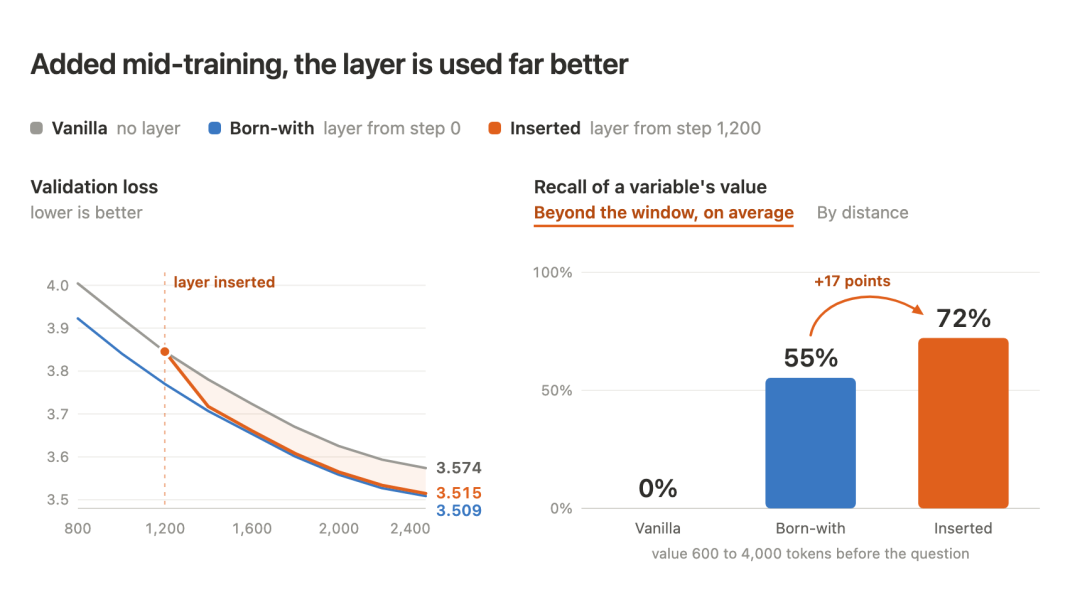
同样的 Python 代码层,训到半路才插进去,竟然比天生自带高出整整 17 个百分点!
这个反转揭开了深层原因:如果开训第一天就给现成的代码捷径,神经网络就会「偷懒」依赖外部字典,不去打磨底层表征。相反,先强迫模型在 500 词限制下把基础表征练扎实,撞上天花板后再接上 Python 代码,神经权重与符号代码才能发挥最大合力!
连塞10层代码,填平算法0分盲区
验证了「半路插入」的优势后,第三组实验挑战 30 种经典计算机算法,检验连塞 10 层代码能带来什么质变。
传统 Transformer 学算法有个致命盲区,测试一旦遇上训练跳过的「中间长度」,准确率就会崩盘。在下图中,常规训练(灰线)碰到未见的中间长度瞬间掉到 0%,接入代码层后(橙线)则稳居高位!
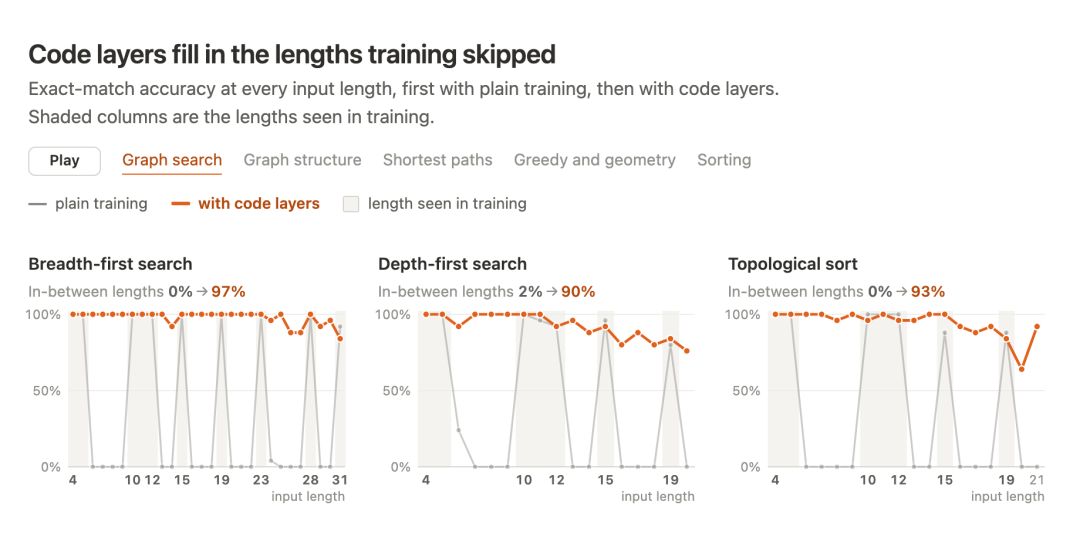
从总分看,常规模型哪怕训满 20000 步,30 种算法总准确率也只能达到 55%。到了第 10000 步,Agent 每隔 500 步出手一次,一口气连塞了 10 个 Python 代码层,帮模型记录「哪些节点访问过」以及「当前最小值」等关键状态。
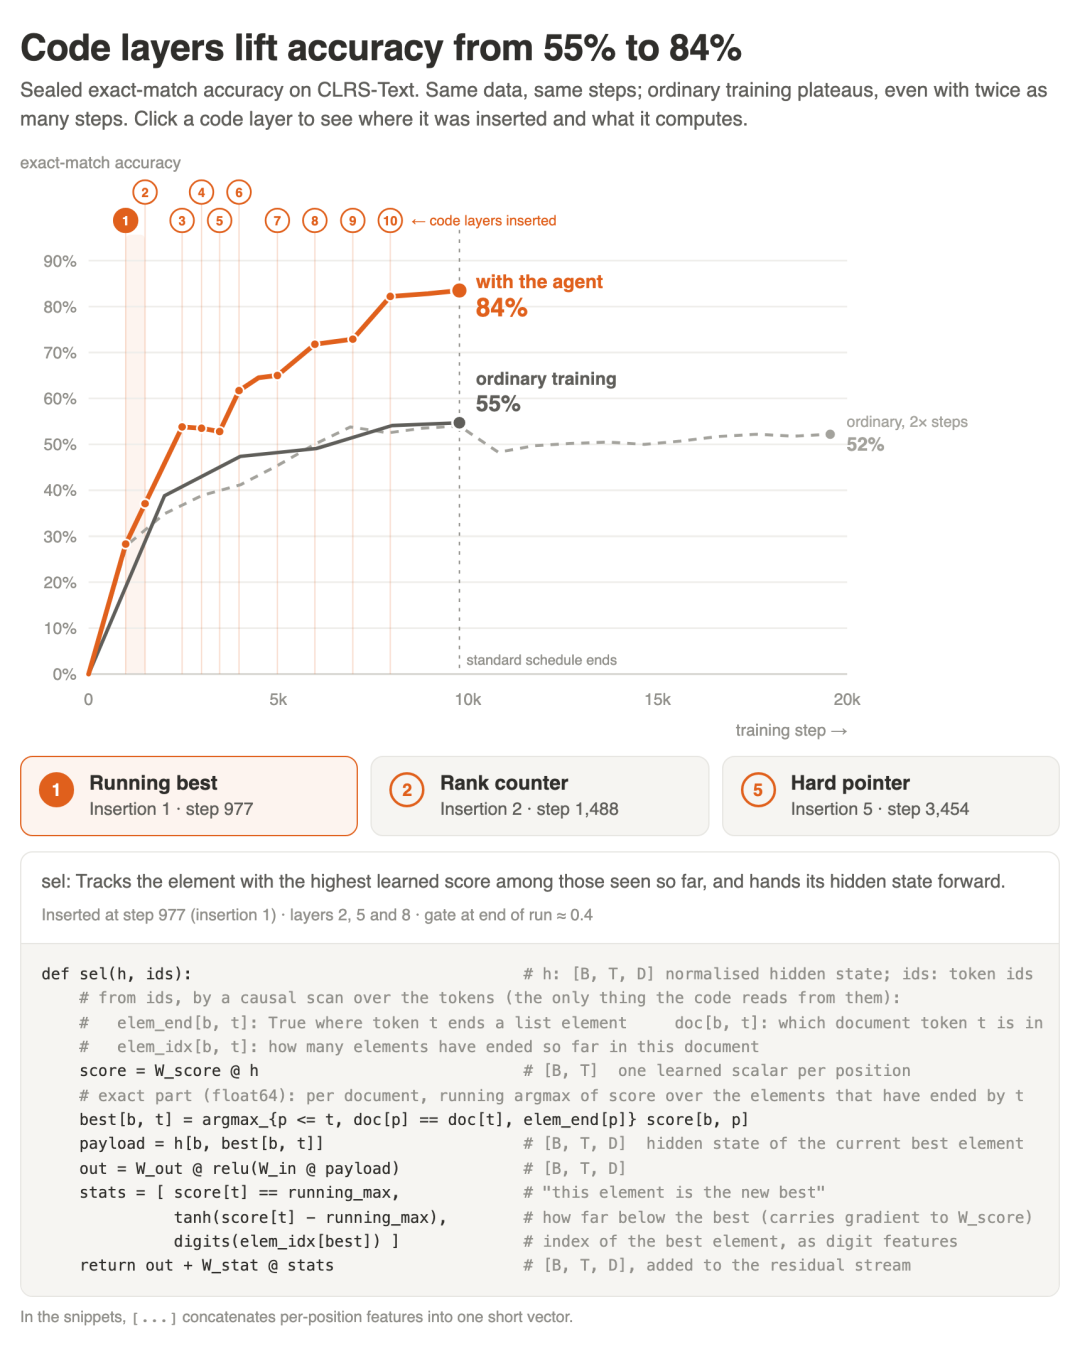
短短 5000 步后,原本考 0 分的广度优先搜索干到 97%,拓扑排序冲上 93%,30 种算法总准确率暴涨 29 个百分点,拿下 84%!
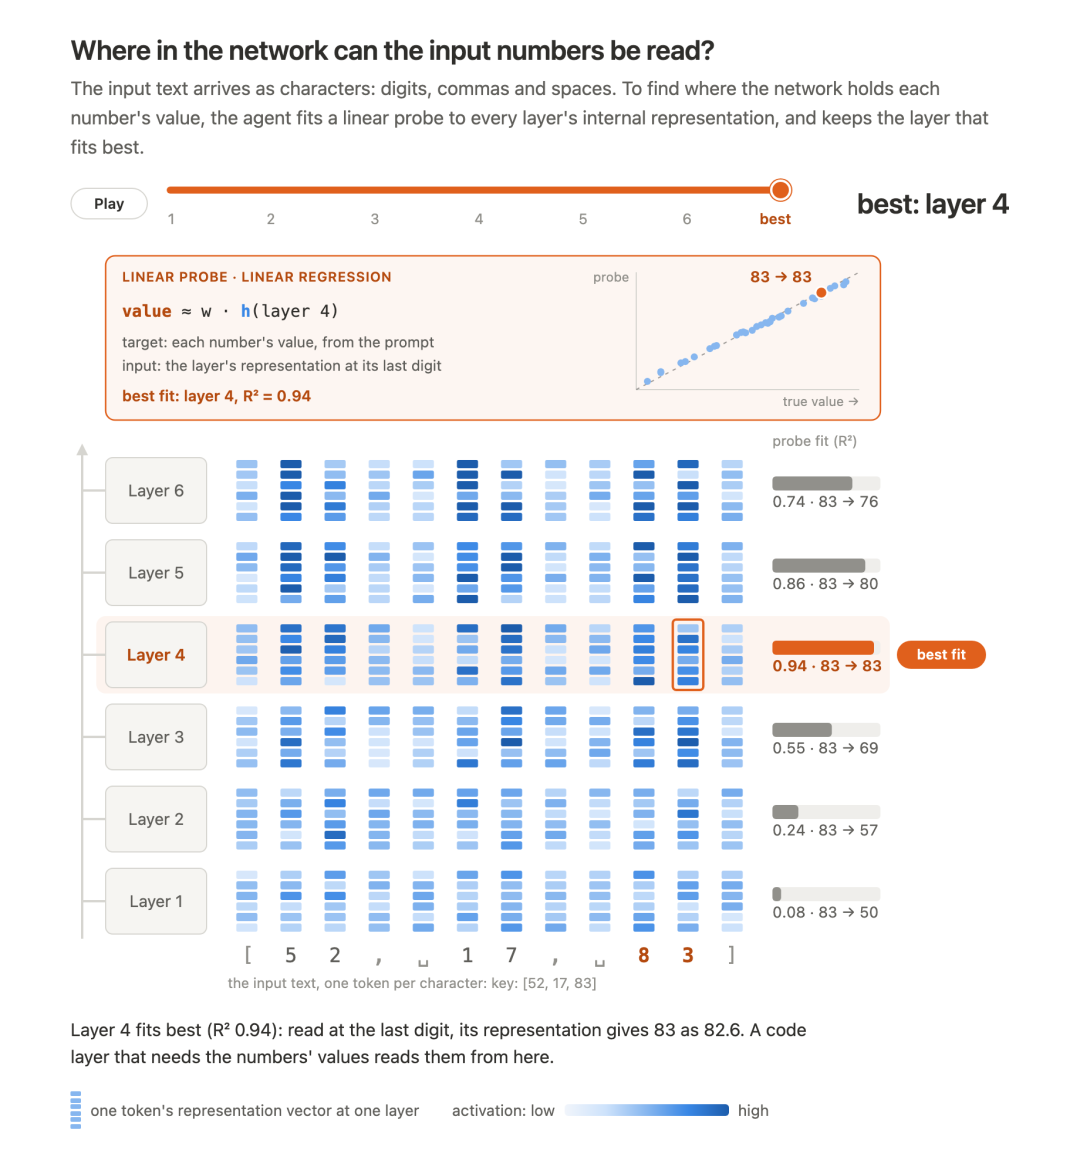
之所以能涨分这么猛,是因为神经网络与 Python 代码在内部打出了精妙配合。比如代码层需要比较数字大小,但原始输入只是拆散的字符「8」和「3」。Agent 用线性探针挨层检测后发现,到了第 4 层,神经网络已经把零散字符拼成了真正的数字!
于是,代码层用探针从第 4 层读出数值 82.6,在 Python 里完成比大小和循环更新后再写回网络,将神经表征与符号计算彻底打通。
DeepSeek读脑自救,数学竞赛暴涨7分
视线再回到开篇那一幕,看看已经训好的 DeepSeek-V4.1-Flash 与 Qwen3-8B 是如何靠写代码原地进化的。
团队将 DeepSeek-V4.1-Flash 在 243 道数学题上的做题轨迹,连同最深 7 层的内部激活状态交给它自己。DeepSeek 分析完犯错规律后,亲手写出探针重采样程序 probe_and_resample,杀进 AIME 与 HMMT 2026 考场!
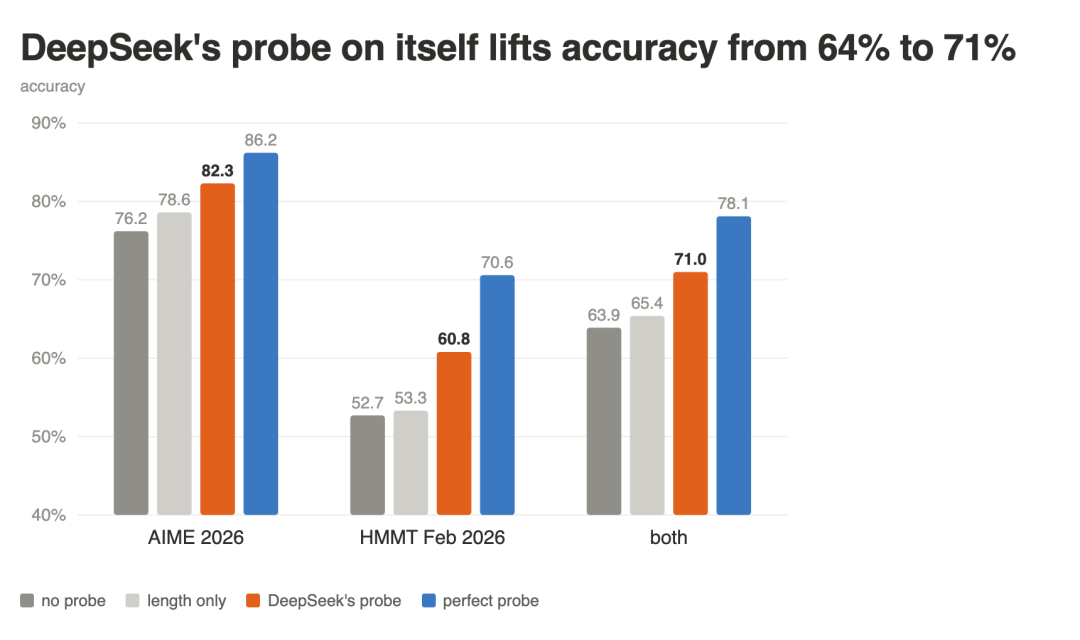
消耗相同的 token 预算,三组对照高下立判:
- 标准单次长思维链推理——一条道走到黑,准确率 63.9%。
- 仅按长度重采样组——只按字数盲目重算,准确率仅 65.4%。
- DeepSeek 自写探针组——实时「读脑」提前止损,准确率冲上 71.0%,暴涨超 7 个百分点!
不改半个权重就能暴涨 7 分,全靠 DeepSeek 给自己写的这段监控代码。
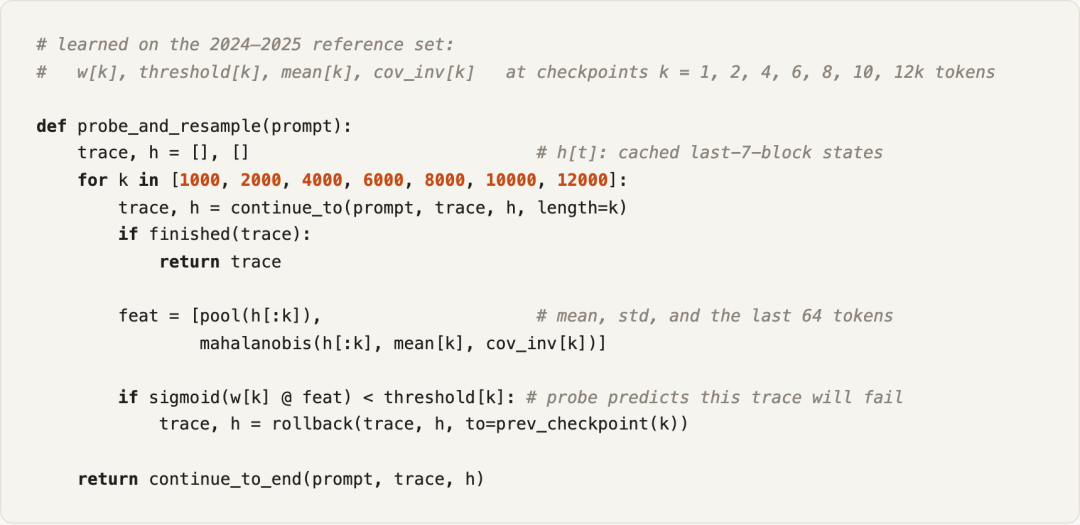
# learned on the 2024-2025 reference set:
#   w[k], threshold[k], mean[k], cov_inv[k]  at checkpoints k = 1, 2, 4, 6, 8, 10, 12k tokens
def probe_and_resample(prompt):
    trace, h = [], []                # h[t]: cached last-7-block states
    for k in [1000, 2000, 4000, 6000, 8000, 10000, 12000]:
        trace, h = continue_to(prompt, trace, h, length=k)
        if finished(trace):
            return trace
        feat = [pool(h[:k]),                # mean, std, and the last 64 tokens
                mahalanobis(h[:k], mean[k], cov_inv[k])]
        if sigmoid(w[k] @ feat) < threshold[k]: # probe predicts this trace will fail
            trace, h = rollback(trace, h, to=prev_checkpoint(k))
    return continue_to_end(prompt, trace, h)
以前大模型一旦走错思路,往往要白白算完几万个 token 才发现全错。现在,思维链每推进到检查点,程序就会自动提取最深 7 层的激活特征打分,一旦测出轨迹偏离正常分布,当场触发回滚重算 rollback!
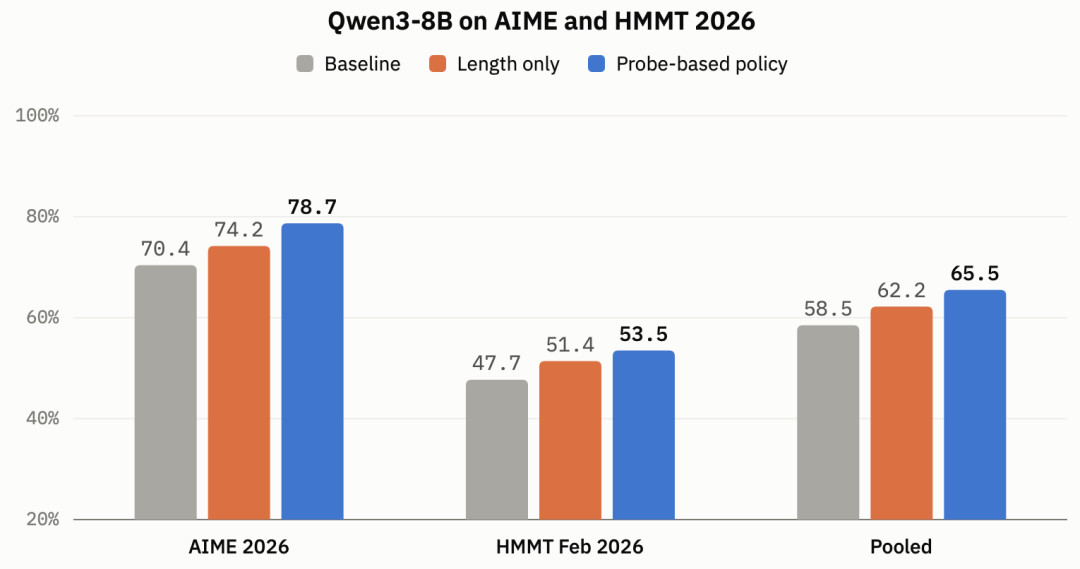
此外,Qwen3-8B 也在零梯度更新下,自主进化测试了 15000 个 Python 调度策略。而且在 AIME 与 HMMT 2026 考场上,还将准确率从 58.5% 拉高到 65.5%,同样狂涨 7 个百分点!
能省下算力实现逆袭,关键在于 Qwen3-8B 定制的这段代码。32 条并发轨迹每跑 2048 个 token 检查一次,满 8 条算出答案且榜首票数达第二名 2 倍以上,就提前终止全员省下算力。而跑满 12288 个 token 未算完、重复率超 0.35 的「死循环复读」轨迹,则会被当场砍掉重启并降权投票!
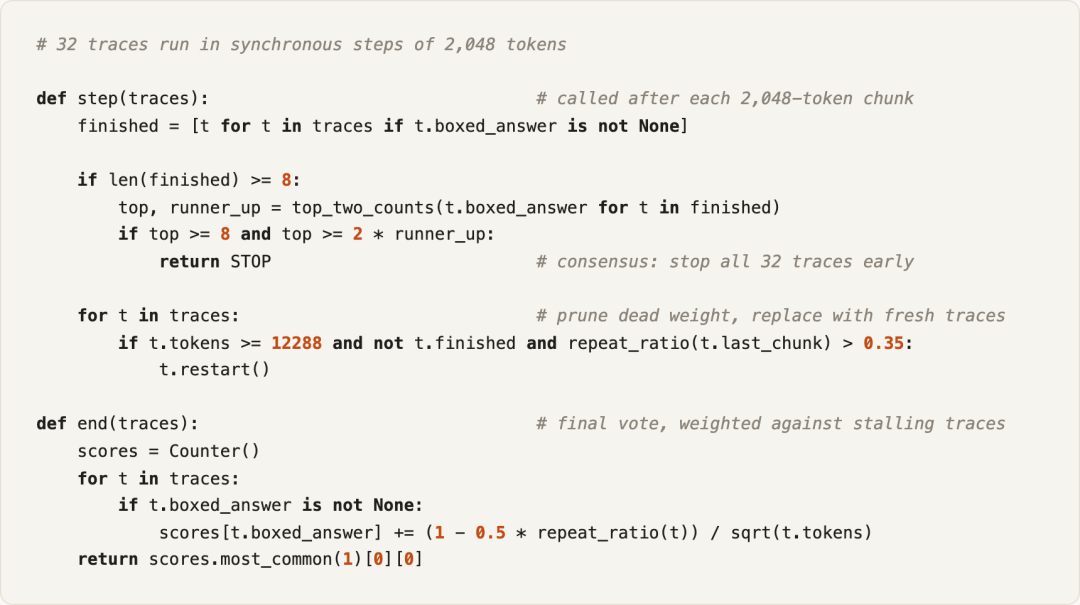
# 32 traces run in synchronous steps of 2,048 tokens
def step(traces):    # called after each 2,048-token chunk
    finished = [t for t in traces if t.boxed_answer is not None]
    if len(finished) >= 8:
        top, runner_up = top_two_counts(t.boxed_answer for t in finished)
        if top >= 8 and top >= 2 * runner_up:
            return STOP    # consensus: stop all 32 traces early
    for t in traces:    # prune dead weight, replace with fresh traces
        if t.tokens >= 12288 and not t.finished and repeat_ratio(t.last_chunk) > 0.35:
            t.restart()

def end(traces):    # final vote, weighted against stalling traces
    scores = Counter()
    for t in traces:
        if t.boxed_answer is not None:
            scores[t.boxed_answer] += (1 - 0.5 * repeat_ratio(t)) / sqrt(t.tokens)
    return scores.most_common(1)[0][0]
以上这四组实验,清晰勾勒出了通往超级人工智能(ASI)最关键的一步——递归自我改进。
模型卡在哪个算子、崩在哪个长度,不再需要人类盯着 Loss 曲线一点点猜。AI 读懂自己的内部状态,当场写几行 Python 代码就能给自己的大脑动手术。从「人类调权重」迈向「AI 写架构」,大模型已经开始亲手接管自己的神经网络,AI 真正自我进化的时代,已经来了!
对这一研究方向感兴趣的开发者,可以到云栈社区和同行深入交流。
参考资料:
 发表于 4 小时前
|
查看: 4|
回复: 0
 /1


