文件能够被读取,并不意味着其中的数据已经适合分析。编号可能丢失前导零,成绩可能包含单位或缺失值,图像的坐标与数组下标也可能被混淆。学习数据整理,有助于理解大模型生成的转换代码,判断处理规则是否符合任务,并确认所需信息得到保留。
数组、表格、文本和图像采用不同的数据组织方式。明确数据含义,选择合适的操作,再核对处理前后的结构与内容,可以为后续统计分析和模型学习准备可靠输入。
一、数组与批量运算
1.1 数据表示与处理目标
结构化数据(Structured Data)通过字段和记录组织信息,例如成绩表中的学号、姓名与各科成绩。文本保存字符序列,数字图像则可以表示为像素及其通道数值。
处理之前,应明确数据的单位、允许范围、标识方式和缺失约定。同样由数字组成的内容,可能分别表示成绩、日期或编号,其处理规则并不相同。
数据整理主要关注结构、类型与质量;数据分析进一步概括分布、比较差异和探索关系;模型学习则利用样本学习规律。这些环节相互衔接,前面的处理决定了后续结果能够如何解释。
1.2 多维数组与数据形状
NumPy 提供多维数组(Multidimensional Array),适合存储和批量处理数值。普通数值数组使用统一的数据类型,因此应选择能够表示所需范围和精度的类型。
轴(Axis)表示数组的一个维度。维数表示轴的数量,形状(Shape)表示各轴的长度。理解数组时,应先说明每个轴对应什么对象。
import numpy as np

# 两行对应两名学生,三列依次对应数学、英语和物理。
scores = np.array([
    [85, 90, 88],
    [92, 85, 79],
], dtype=float)

print(scores.ndim)   # 2:两个轴。
print(scores.shape)  # (2, 3):两行、三列。
print(scores.size)   # 6:共六个元素。

print(scores[0])     # [85. 90. 88.],第一名学生的成绩。
print(scores[:, 1])  # [90. 85.],两名学生的英语成绩。
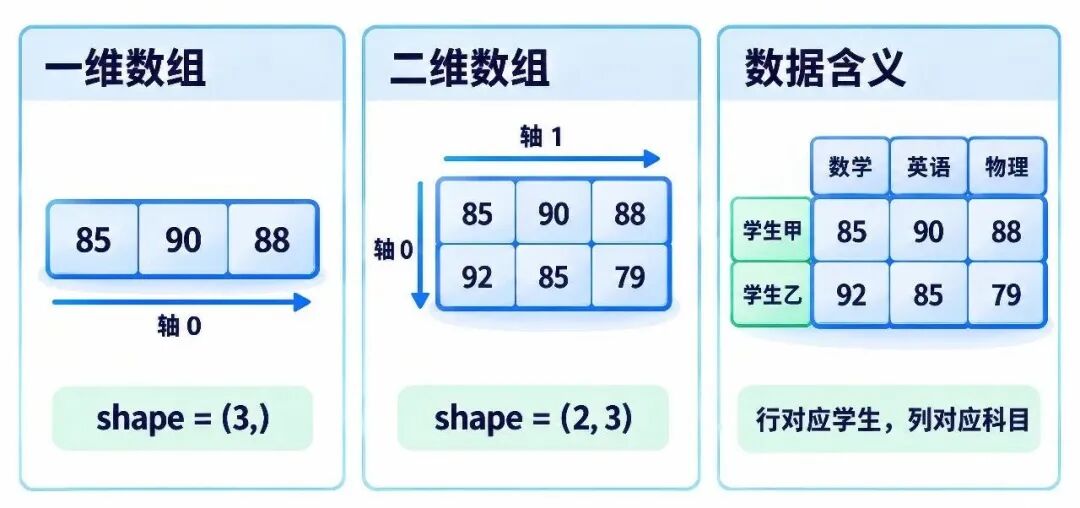
图 1-1:数组形状、行列与数据含义
1.3 批量计算与聚合方向
数组可以对多个元素执行相同操作,也可以沿指定的轴汇总数据。求和、均值等聚合操作会减少需要分别保留的维度,因此应先判断结果应对应学生还是科目。
# 接续 scores。
adjusted = scores + 1
print(adjusted)
# [[86. 91. 89.]
#  [93. 86. 80.]]

print(scores.sum(axis=1))   # [263. 256.],每名学生的总分。
print(scores.mean(axis=0))  # [88.5 87.5 83.5],每门科目的均分。

# scores + 1 产生新结果,没有修改 scores。
print(scores[0, 0])         # 85.0
广播(Broadcasting)使形状兼容的数组能够参与运算。对整个数组增加一个数,是广播的简单应用。按学生或按科目分别调整时,还需要检查数组形状是否表达了正确的对应关系。
1.4 修改范围与原始数据
从数组中提取部分数据,可能得到共享底层存储的视图(View)。修改视图时,原数组中的相应数据也可能变化。需要独立修改时,可以创建复制(Copy)。
import numpy as np

original = np.array([85, 92, 78])

view = original[:2]
independent = original[:2].copy()

view[0] = 90

print(original.tolist())     # [90, 92, 78]
print(independent.tolist())  # [85, 92]

# 本例使用数值数组。
# 基本切片共享数据,copy 创建独立的数据副本。
阅读转换代码时,应同时确认计算结果和修改范围。对结果的检查,也包括原始数据是否按约定保留。
二、带标签的表格处理
2.1 表格对象与字段类型
pandas 提供一维带标签序列(Series)和二维数据表(DataFrame)。行列标签能够表达记录与字段的含义,使程序可以按名称选择数据。
字段类型应符合实际用途。学号需要保留前导零,适合使用文本;成绩用于计算,适合使用数值。
import pandas as pd

# 本章后续片段接续 df。
# 所有记录均为虚构数据,学号按文本保存。
df = pd.DataFrame({
    "学号": ["001", "002", "003", "004", "005", "006"],
    "姓名": ["张三", "李四", "王五", "赵六", "钱七", "孙八"],
    "班级": ["A", "A", "A", "B", "B", "B"],
    "数学": [85, 92, 78, 95, 60, 88],
    "英语": [90, 85, 72, 98, 55, 91],
    "物理": [88, 79, 85, 92, 65, 76],
})

print(df.shape)   # (6, 6):六条记录、六个字段。
print(df.dtypes)  # 查看各列的数据类型。
print(df.head(2)) # 查看前两条记录。
2.2 标签、位置与条件筛选
表格中的标签和位置承担不同作用。标签用于标识,位置用于说明排列次序。排序或筛选以后,记录的位置可能改变,原有标签仍可能保留。
条件筛选根据每条记录是否满足要求,决定保留哪些内容。多个条件组合时,需要明确每个条件及其逻辑关系。
# 接续 df。
print(df.loc[0, "姓名"])  # 张三:按行标签与列标签访问。
print(df.iloc[0, 1])     # 张三:按行位置与列位置访问。

mask = (df["数学"] > 70) & (df["物理"] > 80)
selected = df.loc[mask, ["学号", "姓名"]]

print(selected["姓名"].tolist())  # ['张三', '王五', '赵六']

# &、|、~ 分别用于逐元素的与、或、非运算。
# 每个比较式加括号,不能用 and、or 直接替代。
# 筛选后的行标签可能不连续。
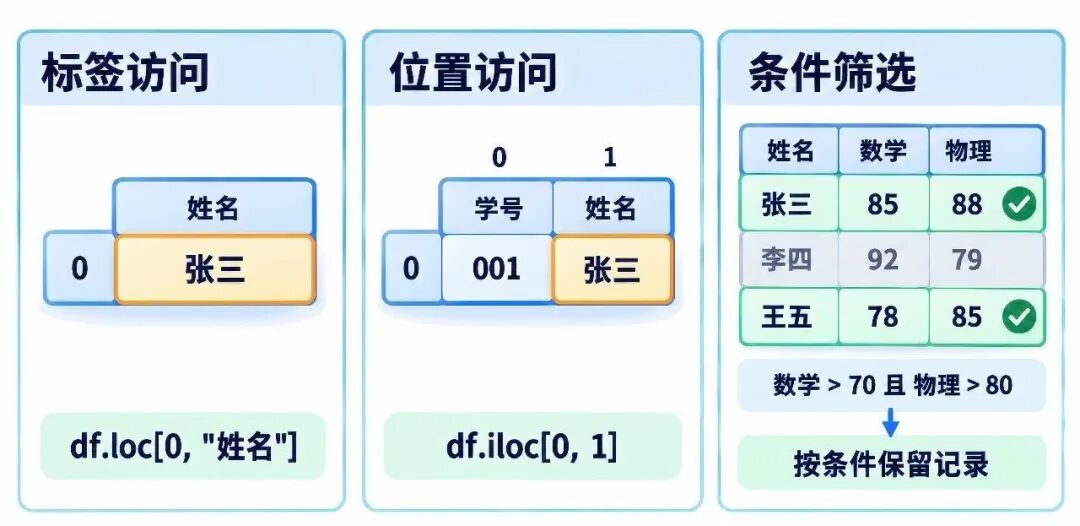
图 2-1:标签访问、位置访问与条件筛选
2.3 标签对齐与明确赋值
标签对齐(Label Alignment)按相同标签对应数据。两个序列的排列顺序不同,仍可以根据标签匹配;标签缺失或重复时,则需要重新检查对应关系。
import pandas as pd

scores = pd.Series([85, 92], index=["001", "002"])
bonus = pd.Series([3, 1], index=["002", "001"])

print((scores + bonus).to_dict())
# {'001': 86, '002': 95}
# 根据学号标签对应,不按显示位置直接相加。
修改表格时,应明确目标对象、目标记录和目标字段,避免通过连续选取形成含糊的赋值路径。
# 接续 df。
working = df.copy()

working.loc[working["学号"] == "001", "数学"] = 86

print(df.loc[0, "数学"])       # 85,原表保留。
print(working.loc[0, "数学"])  # 86,处理副本已修改。
2.4 排序与分组汇总
排序改变记录的排列次序,分组聚合(Group Aggregation)按类别组织记录并计算结果。处理前应明确排序依据、同值顺序,以及每项汇总使用哪些记录。
# 接续 df。
subjects = ["数学", "英语", "物理"]

result = df.copy()
result["总分"] = result[subjects].sum(
    axis=1,
    min_count=len(subjects),
)

# 三科均非缺失时才计算总分。
# 总分降序,同分时按文本学号升序。
ordered = result.sort_values(
    ["总分", "学号"],
    ascending=[False, True],
)

print(ordered["姓名"].tolist())
# ['赵六', '张三', '李四', '孙八', '王五', '钱七']

print(result.groupby("班级").size().to_dict())
# {'A': 3, 'B': 3}

assert result["总分"].sum() == 1474
记录数与有效值数量需要区分。一组有三条记录,并不保证每个字段都有三个有效值。汇总结果应保留相应的数量依据。
三、数据质量与清洗规则
3.1 缺失与有效性检查
缺失值(Missing Value)表示数据未记录或不可用。原始字段为空、文本无法解析、数值超出范围,具有不同原因,应分别记录。
数值转换成功,只说明内容能够按某种数值形式解释。成绩是否有效,还需要检查范围和整数要求。零分可以是有效成绩,不能因为它在条件判断中表现为假,就将其当作缺失。
pandas 提供缺失判断功能,但空字符串、空白字符和特定文本是否代表缺失,仍需按任务约定处理。
import pandas as pd

scores = pd.Series([85, None, 0], dtype="Int64")

print(scores.isna().tolist())  # [False, True, False]
print(scores.count())          # 2:非缺失值数量。
print(len(scores))             # 3:总记录数量。

# Int64 是可保留缺失标记的整数类型。
# 数值 0 得到保留,没有被当作缺失。
3.2 重复记录与异常候选
重复值不一定代表重复记录。同名人员、相同日期或相同金额都可能真实存在。删除重复项之前,应明确记录身份和重复提交的判断依据。
异常值(Outlier)通常指明显偏离其余观测或预期模式、值得进一步核查的数值。它可能来自录入错误,也可能反映真实的特殊情况。
明确的业务约束可以直接用于检查,例如百分制成绩应处于规定范围。统计方法能够提供异常候选,但不能单独证明数据错误。
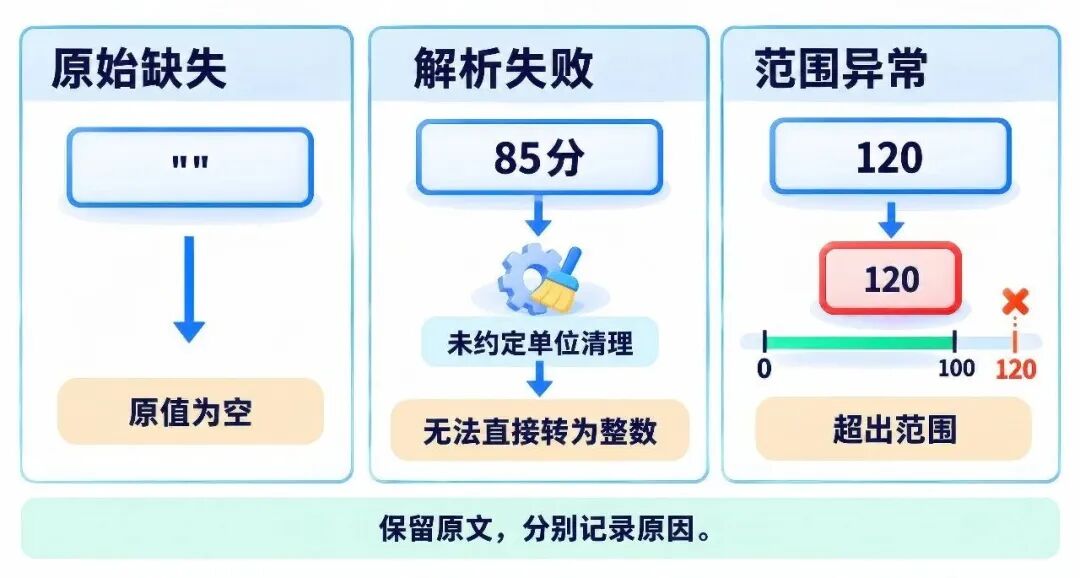
图 3-1:原始缺失、解析失败与范围异常
3.3 清洗顺序与处理记录
数据清洗(Data Cleaning)依据约定识别并处理格式、缺失、重复及有效性问题。删除、填充和替换会改变可用记录或数值分布,因此应先确定规则,再执行操作。
常见处理过程包括:
- 保留原始字段和来源标识。
- 统一允许调整的空白、单位或表示形式。
- 转换类型并检查有效范围。
- 分类记录有效数据、待核查数据和已确认重复项。
- 核对数量与内容,保存处理依据。
例如,四条成绩原文依次为“85 分”、空文本、“120”和“85 分”。如果最后一条已经确认是第一条的重复提交,那么删除该条后,应保留一条有效记录和两条待核查记录。
清理后的文本为空,不一定说明原文为空。原文如果只有单位“分”,清理后也可能成为空文本,应记录为无法解析,而非原始缺失。
填充缺失值时,还应保留填充标记和依据,使估计值与实际观测能够区分。
四、文本与图像的基础变换
4.1 文本结构与清理范围
文本中的空白、换行、标点和大小写可能具有任务含义。清理前应确定需要保留的结构,例如段落边界、字段分隔和单位。
raw_text = "AI   helps\nAI learns"

# 保留原文,在新字符串中统一连续空白。
normalized = " ".join(raw_text.split())

print(normalized)             # AI helps AI learns
print(raw_text.splitlines())   # ['AI   helps', 'AI learns']
print(normalized.count("AI"))  # 2:非重叠子串计数。

# 统一空白会把换行转换为空格。
# 如果需要保留段落,应采用其他清理规则。
子串计数只统计指定字符片段,不等同于自然语言分词。词语边界、上下文含义和语义分析将在后续文本处理内容中展开。
4.2 像素、通道与坐标
Pillow 提供图像对象和常用变换。RGB(Red, Green, Blue,红绿蓝)图像用三个通道表示颜色,可以转换为数值数组。
图像尺寸通常按宽、高表示,图像数组通常按高、宽、通道组织。非正方形图像更便于辨认这两种顺序。
import numpy as np
from PIL import Image

# 创建宽 300、高 200 的 RGB 测试图。
image = Image.new("RGB", (300, 200), "white")
pixels = np.array(image)

# 数组先按行、再按列访问,最后一维对应 RGB 通道。
pixels[50:150, 100:200] = [255, 0, 0]
image = Image.fromarray(pixels)

print(image.size)    # (300, 200):宽、高。
print(pixels.shape)  # (200, 300, 3):高、宽、通道。

print(image.getpixel((150, 100)))  # (255, 0, 0)
print(pixels[100, 150].tolist())   # [255, 0, 0]
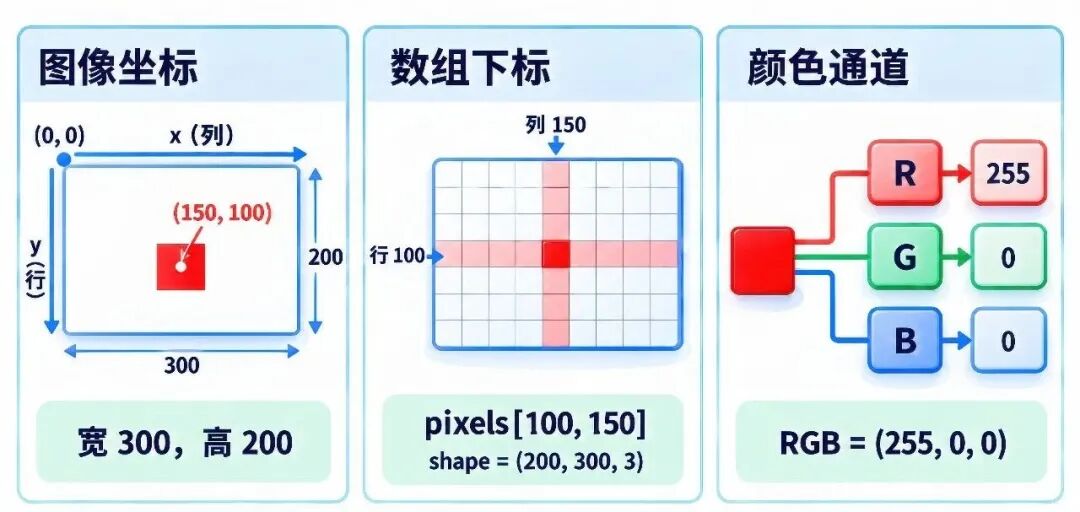
图 4-1:图像坐标、数组下标与颜色通道
4.3 几何变换与通道转换
裁剪选择局部区域,缩放改变尺寸并重新采样,旋转和翻转改变空间排列。灰度转换减少颜色通道信息,适用于只关注明暗的处理任务。
这些操作可能丢失部分内容。应根据后续用途决定是否保留原图,以及允许改变哪些信息。
# 接续 image。
crop = image.crop((100, 50, 200, 150))
small = image.resize((150, 100))
gray = image.convert("L")

print(crop.size)  # (100, 100)
print(small.size) # (150, 100)
print(gray.mode)  # L:本例转换为单通道灰度图。

# crop 的参数依次为左、上、右、下。
# 右边界和下边界不包含在裁剪区域中。
# 这些操作返回新图像,image 保留原图。
4.4 邻域处理与结果观察
邻域处理根据某个像素附近的数据计算新值。模糊可以减弱局部变化,锐化可以增强局部细节,边缘检测则突出明显的变化区域。
滤镜结果与权重、邻域范围和边界处理有关。检查时应同时观察均匀区域和颜色交界处,避免只在变化不明显的位置判断效果。
from PIL import ImageFilter

# 接续 image。
blurred = image.filter(
    ImageFilter.GaussianBlur(radius=3)
)

print(blurred.size == image.size)  # True

# 使用新文件保存,拒绝覆盖已有结果。
with open("pixel_original.png", "xb") as stream:
    image.save(stream, format="PNG")

with open("pixel_blurred.png", "xb") as stream:
    blurred.save(stream, format="PNG")
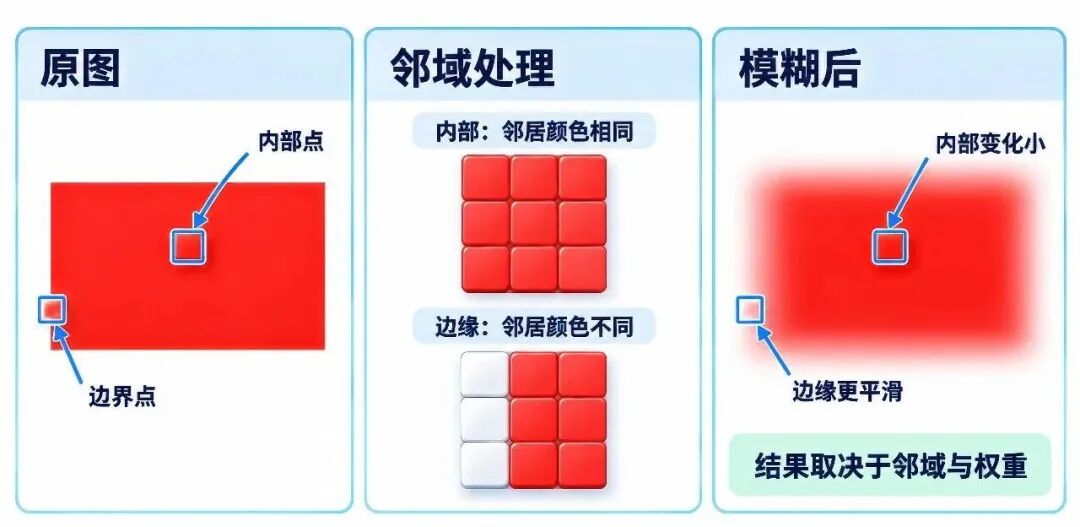
图 4-2:邻域处理与色块边缘变化
五、整理结果与分析衔接
5.1 需求约定与代码阅读
向大模型提出整理需求时,应明确字段含义、允许的转换、问题分类与验收条件。例如:
请整理四条虚构成绩记录。学号依次为“001”“002”“003”“001”,数学原文依次为“85 分”、空文本、“120”“85 分”。已确认第四条是第一条的重复提交,仅据此移出整理结果。允许清除两端空白和末尾单位“分”,有效成绩必须是有限数值、数值为整数且处于 0 至 100。保留原文、原始行号、处理状态和原因,不填充缺失成绩。分别返回整理记录和已确认重复记录,并核对各类数量。
阅读生成代码时,重点确认三个问题:处理依据是否明确,原始信息是否保留,问题记录是否能够回查。
具体实例中的有效数量、问题原因和边界结果,应在运行之前独立确定。
5.2 保存结果与读回核验
整理结果应同时保留规范数据、原始材料和问题记录。保存之后,还需重新读取,检查标识字段、记录数量和计算结果。
import pandas as pd

# 接续第二章的 result、subjects 和 df。
# CSV 输出不额外保存行索引,已有同名文件时拒绝覆盖。
result.to_csv(
    "students_clean.csv",
    index=False,
    encoding="utf-8-sig",
    mode="x",
)

read_back = pd.read_csv(
    "students_clean.csv",
    dtype={"学号": "string"},
    keep_default_na=False,
)

assert len(read_back) == len(result)
assert read_back.columns.tolist() == result.columns.tolist()
assert read_back["学号"].tolist() == df["学号"].tolist()

assert read_back[subjects + ["总分"]].equals(
    result[subjects + ["总分"]]
)
assert read_back["总分"].sum() == 1474

# 本例没有缺失字段,读取时关闭默认缺失文本识别。
# 真实任务需要另外约定空字段和缺失标记。
读回一致说明保存过程保留了所检查的数据。处理规则是否正确,仍需根据原始材料与独立预期核验。
5.3 分析范围与处理口径
删除记录、填充缺失或替换异常值,都可能改变后续统计结果。分析之前,应说明使用原始数据还是处理副本,以及有效记录的范围和数量。
当分析目标发生变化,例如从逐人汇总改为班级比较,还应重新检查分组字段、缺失处理和有效数量是否支持新的目标。
可靠的数据整理应使每一次变化都有依据,每一项结果都能够联系到来源与处理规则。
📘 小结
数组与表格支持批量运算,文本与图像变换落实具体处理规则。明确维度、标签、类型和缺失约定,保留原文与问题记录,并核验保存结果,可以为后续分析提供结构清楚、来源可查的数据。
参考阅读:
 发表于 2 小时前
|
查看: 6|
回复: 0
 /1


