一位开发者利用 Qwenputer 项目实现的 32 位 RISC-V CPU,成功渲染出《DOOM》的一帧 320×240 游戏画面。整个过程生成了超过 634 万个执行 Token,首次运行耗时 50.7 分钟;后来经过融合执行器优化,同一帧缩短到约 24 分钟。
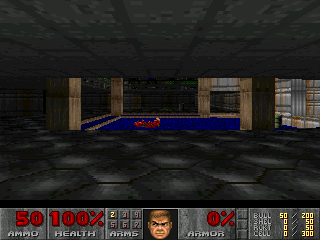
DOOM E1M1 首帧完整渲染结果(320×240),全部像素由编译进权重的 CPU 电路生成。来源:Ad1tyaNarayana/qwenputer-doom。
这件事最特别的地方在于,执行 DOOM 的 CPU 并不存在于一颗独立芯片上。它的指令执行逻辑被编译成 Transformer 权重,由 GPU 运行模型计算来完成。
整套实验分成两部分:Qwenputer 作者 Divyansh Agrawal 先将 RISC-V CPU 嵌入 Qwen3.5-4B;另一位开发者 Aditya Narayana 随后利用其中的 CPU 电路完成了 DOOM 单帧渲染。
Qwenputer 的实现方式很特别。开发者在 Qwen3.5-4B 原有网络前面增加 11 层 Transformer,让这些网络层承担 CPU 的指令执行工作。
这些权重并不是通过大量数据训练出来的,而是由编译器根据 CPU 运算逻辑直接计算生成。
它实现了 RV32IM 指令集,支持 32 位整数运算、乘除法、访存和分支,还包含 Zba 位操作扩展及部分自定义指令。
一条 RISC-V 指令进入后,需要完成取指、译码、寄存器读取、运算和状态更新。Qwenputer 把这些步骤映射到 Transformer 的计算过程中,通过连续的模型执行完成指令。
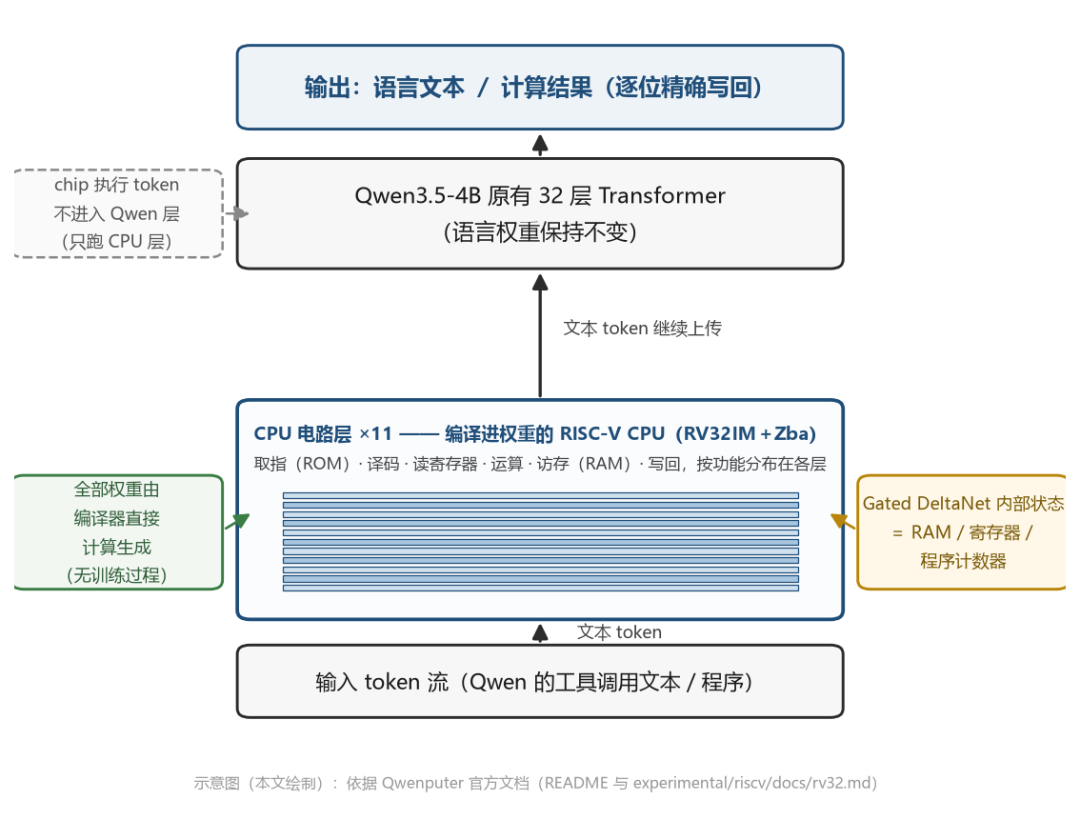
Qwenputer 结构示意:11 层 CPU 电路位于 Qwen3.5-4B 原有 32 层网络之前,寄存器、内存与程序计数器保存在 Gated DeltaNet 内部状态中。本文依据官方文档绘制。
这与让大模型生成一段模拟 CPU 运行的文字不同。计算过程遵循预先编译好的确定性逻辑,可以与传统 RISC-V 参考实现逐步比较。
项目报告称,约 23 万个执行输出位置与参考模型对照,没有发现不一致。
02|大模型的内部状态,直接当 RAM 用
CPU 能执行指令,还需要存储程序、数据、寄存器和程序计数器。
Qwenputer 利用了 Qwen3.5 中的 Gated DeltaNet 机制。DeltaNet 原本通过内部状态矩阵保存和更新序列信息,开发者将这种状态更新机制改造成可寻址存储。
具体来说,项目使用 One-hot 形式的键选择状态矩阵中的某一行,再通过更新操作覆盖这一行的数据。读取时使用对应查询,取回存储的内容。这样,状态矩阵中的每一行就可以充当一个存储单元。
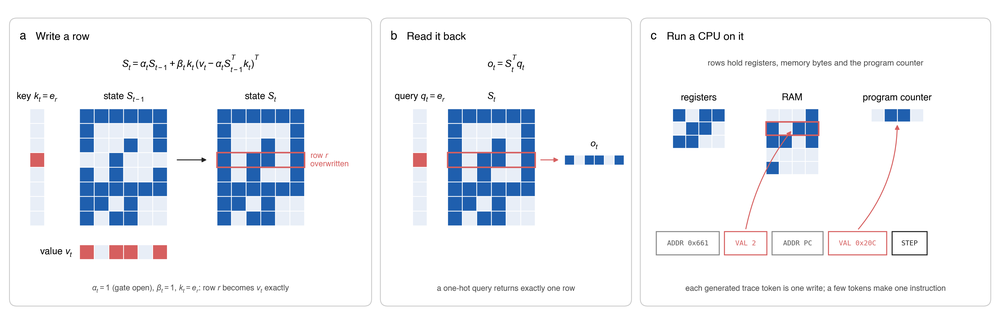
Gated DeltaNet 状态用作 RAM:One-hot 键覆盖一行(a)、One-hot 查询原样读回一行(b),寄存器、内存字节与程序计数器分布在状态矩阵中(c)。来源:Qwenputer 官方 README。
程序、数据和寄存器分布在不同的 DeltaNet 状态区域中,随着执行过程不断更新。
这也意味着,CPU 执行状态不需要交给外部 Python 模拟器维护,而是保存在模型自己的内部状态里。
03|一帧 DOOM,为什么需要 50 分钟
DOOM 实验使用的是 DMC100-Doom,一个面向小型微控制器的移植版本。为了适应有限的内存,程序将 320×240 画面分成 25 个条带分别渲染,使游戏场景能够在 64 KiB RAM 条件下运行。
开发者把程序编译成裸机 RISC-V 固件,再交给 Qwenputer 编译出的 CPU 电路执行。一条 RISC-V 指令进入后,需要完成 取指、译码、寄存器读取、运算和状态更新,这些步骤也是传统 CPU 数据通路的核心环节。
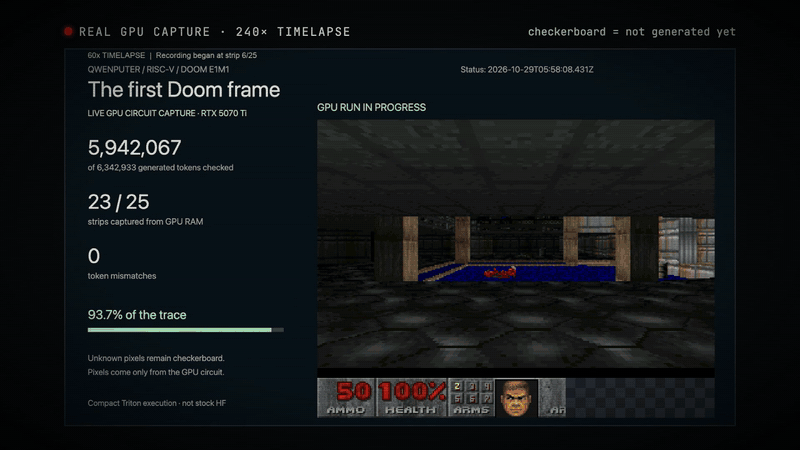
实验的真实 GPU 执行记录,来自官方 240 倍快放录像中的一帧:6,342,933 个执行 Token 已校验 93.7%,25 个画面条带已回读 23 个,0 次失配。来源:Ad1tyaNarayana/qwenputer-doom。
实验使用一张 16 GB 显存的 GeForce RTX 5070 Ti,CPU 电路总共生成 6,342,933 个执行 Token,最终从内部状态中读取出完整的一帧画面。
首次执行耗时 50.7 分钟。后来通过融合执行器优化,时间下降到约 24 分钟。
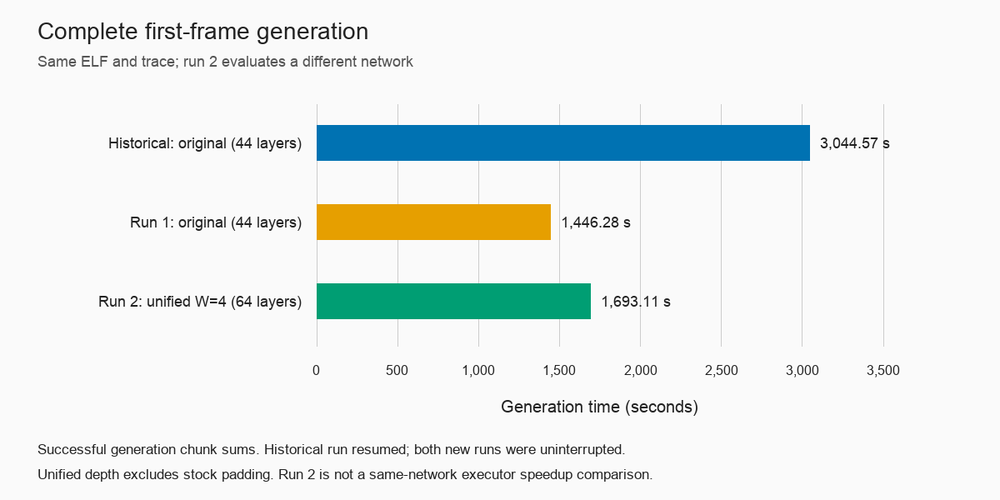
首帧完整生成耗时对比:原始执行器 3,044.57 秒,约 50.7 分钟;融合执行器降至 1,446.28 秒,约 24.1 分钟。来源:Ad1tyaNarayana/qwenputer-doom。
这里有个重要细节:DOOM 实验只运行了 Qwenputer 编译出的 CPU 电路,没有加载 Qwen 原有的语言模型层。它使用专门的 Triton 执行器,也不是通过普通聊天界面玩游戏。
因此,这次成果是成功渲染一帧画面,还远远谈不上流畅运行 DOOM。但实验验证了一个很有意思的结果:一套由 Transformer 权重构成的 CPU 逻辑,确实能够执行足够复杂的程序,完成实际图形渲染。
04|把 CPU 写进权重,究竟有什么价值
从性能来看,这种实现完全无法与真正的 RISC-V 处理器相比。传统 CPU 可以在极短时间内执行大量指令,而 Qwenputer 需要通过模型计算逐步更新执行状态。即使有 GPU 加速,运行 DOOM 一帧仍然需要数十分钟。
但 Qwenputer 展示了另一种计算组织方式:将确定性的指令执行逻辑编译进神经网络权重,再用模型内部状态保存可读写的数据。这让大模型除了生成语言,还可以在自身计算过程中完成精确的程序执行。
例如,在项目的 40 题大整数乘法测试中,原始 Qwen3.5-4B 的正确率为 55%,加入内部 CPU 后提高到 97.5%。模型能够通过内部 CPU 计算结果,而不必调用外部 Python 解释器。
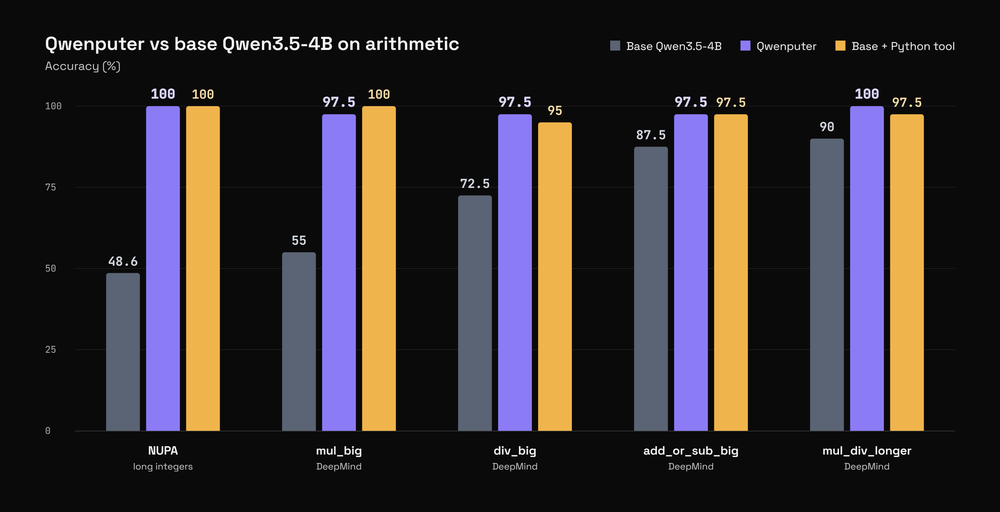
整数运算基准采用 greedy 解码,每题集 40 题:mul_big 一项从 55.0 提高到 97.5,与调用真实 Python 解释器持平。来源:Qwenputer 官方 README。
对于芯片和系统架构工程师,这项实验提供了一个特殊的观察角度:传统 CPU 依赖寄存器、ALU 和存储器组成数据通路,而 Qwenputer 把相同的逻辑功能映射到了 Transformer 层和 DeltaNet 状态中。
它距离实际应用还有很大距离,但已经证明,神经网络的计算结构可以承载确定性的指令执行。
一颗 CPU 被编译成 11 层 Transformer,最后花了 50 分钟画出一帧 DOOM。这个结果看起来很慢,却让大模型与传统计算机之间,多了一种可以实际验证的连接方式。
 发表于 3 天前
|
查看: 9|
回复: 0
 /1


