AMD Versal 这类 FPGA SoC 把硬化 NoC、内存控制器以及处理器集成在同一颗芯片上。多个计算模块需要共享片上互连与外部内存,系统整体表现很大程度上取决于数据如何穿过这些模块,以及不同请求之间如何互相干扰。
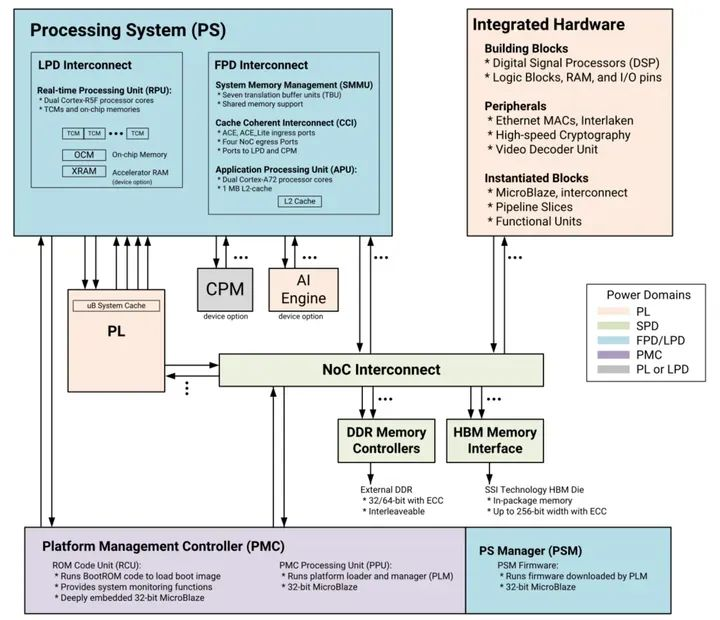
AMD Versal 自适应 SoC 总体框图,NoC Interconnect 连接可编程逻辑(PL)、处理系统(PS)、DDR 与 HBM 内存控制器。来源:AMD 官方文档(经 FPGA开发圈/eetrend 转载)
伊利诺伊大学厄巴纳-香槟分校(UIUC)近期开源了 Naviq,一款面向 Versal 类 FPGA SoC 的周期级仿真器。在与 Vivado RTL NoC 模型的对照测试中,Naviq 的带宽与延迟表现十分接近,同时把仿真速度提升了 81–182 倍。
01|FPGA 性能瓶颈,可能藏在计算模块之外
传统的 FPGA 开发流程通常针对计算模块本身做 RTL 仿真,验证功能、流水线和时序是否正常。对独立模块而言,这种做法已经能提供比较准确的行为信息。
然而,现代 FPGA SoC 的性能问题正越来越依赖系统环境。
举个例子,两个 DMA 引擎同时向 DDR 发起 AXI 读请求时,即便各自相连的计算模块都能持续接收数据,也不意味着内存会按预期速度返回。这些请求还要经过 NoC 的路由、缓冲和仲裁,并可能受到其他 Master 的干扰。
一旦下游缓冲区暂时无法接收数据,背压就会沿着数据路径向上游传播。最终的直观表现可能是计算流水线在等待输入,而不是计算资源不够用。
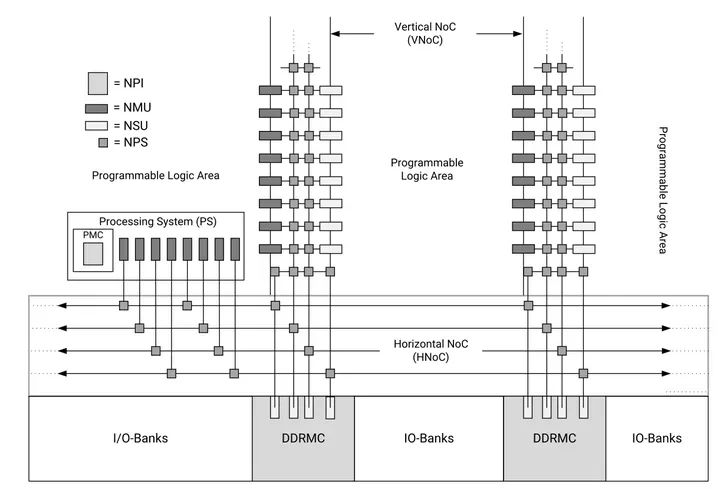
Versal 硬化 NoC 结构:多路 Master 经 NMU 进入,经 NPS 交换与水平/垂直 NoC 路径,访问 NSU 与 DDRMC。来源:AMD 官方文档(经 FPGA开发圈/eetrend 转载)
在 Versal 里,硬化 NoC 承担着处理器、可编程逻辑与内存控制器之间的数据搬运工作。光验证计算模块,很难完整反映共享互连带来的争用和延迟。
麻烦之处在于:完整的 RTL 仿真虽然能观察到这些细节,却很难支撑大量参数组合的反复测试。
02|Naviq 把硬化 NoC 变成周期级模型
Naviq 采用的是一种混合建模思路。
处理器、NoC 和内存等系统基础设施用软件模型来描述关键行为,工程师自行设计的 RTL 加速器则通过 Verilator 接入仿真环境。这样开发者既能继续测试自己的硬件逻辑,又不必让所有固定的 SoC 基础设施都跑在 RTL 层面。
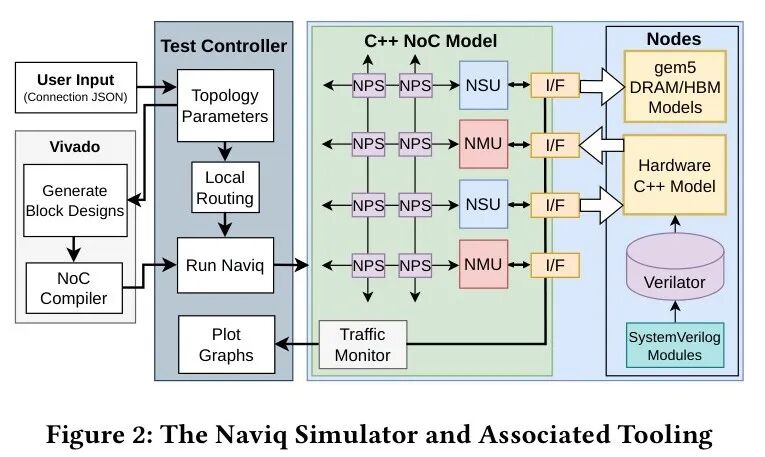
Naviq 仿真器与相关工具的架构,包含 Test Controller、C++ NoC 模型以及 gem5、Verilator、SystemVerilog 等节点。来源:Naviq 论文 Figure 2(arXiv:2611.02023)
整套方案里最关键的是 NoC 模型。
Naviq 没有把 NoC 简化成一条固定延迟的连接通道,而是保留了真正影响性能的几项机制:AXI 事务排序、数据包封装、路由、背压以及内存交互。
以 AXI 读事务为例:请求从 Master 发出后进入 NoC,沿对应传输路径到达目标内存系统,返回数据同样受链路和缓冲资源约束。
当多个 Master 同时访问同一内存资源时,仿真器必须反映请求之间的竞争,而不是给每个请求简单加一段固定延迟。
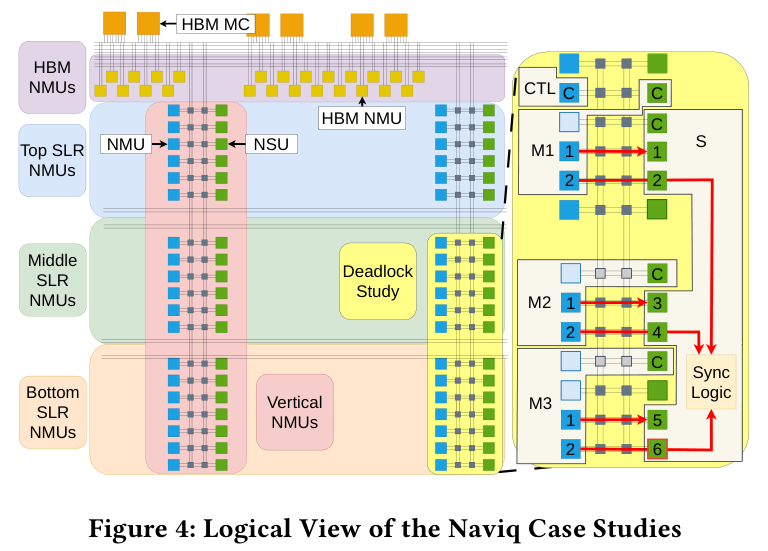
Naviq 案例研究的逻辑视图:HBM NMU、Top/Middle/Bottom SLR NMU、垂直 NMU 列与 NSU 端点在 NoC 中的布局。来源:Naviq 论文 Figure 4
Naviq 的设计重点很明确:保留会改变系统性能的周期级行为,同时把大量不影响当前分析目标的 RTL 执行开销省掉。
03|为什么仿真速度能够提高 81–182 倍
传统 RTL 仿真必须持续更新大量硬件信号和模块状态。对于包含复杂互连与内存控制逻辑的 SoC,哪怕工程师只想研究带宽和延迟,也不得不执行完整的 RTL 模型。
Naviq 把硬化基础设施替换为 C++ 周期模型,只维护与系统行为相关的状态变化。自定义加速器仍可通过 Verilator 参与仿真,与软件模型在同一个环境中交互。
论文将 Naviq 与 Vivado RTL NoC 模型做了对比。在评估场景中,仿真速度提升了 81–182 倍,同时带宽和延迟结果也较好地复现了参考模型。
在预留的随机测试集里,各类别平均延迟准确率最低为 97.6%,带宽准确率最低为 99.9%。需要强调的是,这些数字反映的是 Naviq 与 Vivado RTL 参考模型的一致性,并不代表与真实板卡测量结果的直接对照。
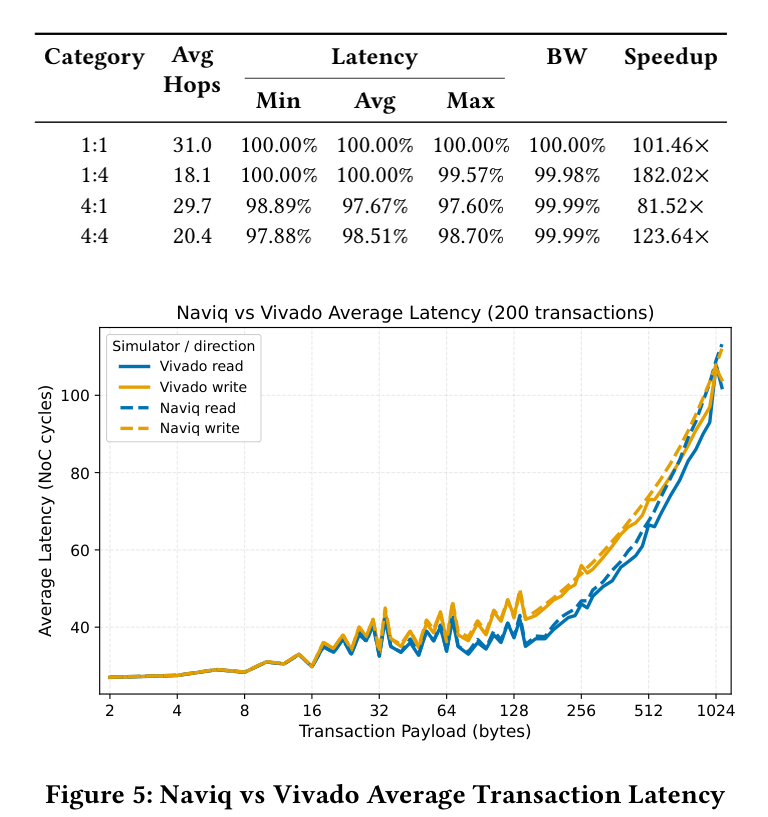
上:Naviq 论文 Table 1,四类流模式下加速比 81.52×–182.02×,延迟准确率 97.60%–100.00%;下:Naviq 与 Vivado 平均事务延迟对比(Figure 5)。来源:Naviq 论文
这里有一个重要边界需要说清楚:182 倍指的是仿真执行速度,并不是 FPGA 芯片的运行速度,更不代表加速器性能提升了 182 倍。
另外,周期级模型也不等同于完整的 RTL 实现。它适合分析事务、流量、资源竞争和系统性能,但不能替代信号级功能验证、时序检查或硬件实现验证。
两类仿真工具解决的是不同阶段的问题。
04|AXI 背压和内存争用,终于能放在一起分析
Naviq 提供了 CPU、内存与自定义加速器的系统级集成能力,并支持协议检查、执行轨迹、检查点和性能分析。借助这些功能,工程师可以研究更接近实际 SoC 运行状态的问题。
论文中有一组实验把 16 路 AES/DMA 接入 HBM。采用分布式、本地化的 NoC 连接布局时,仿真的聚合吞吐量达到 1.338 Tb/s;当流量集中经过同一列 NoC 资源时,吞吐量跌到 191 Gb/s,两者相差近 7 倍。
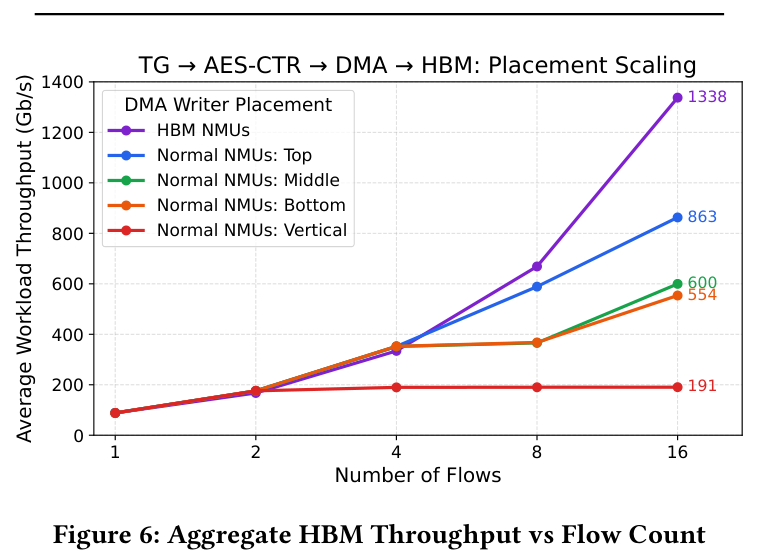
TG→AES-CTR→DMA→HBM 实验中,HBM NMU 布局在 16 流时达 1338 Gb/s,垂直布局饱和于 191 Gb/s。来源:Naviq 论文 Figure 6
计算模块本身没有变化,性能差异完全来自数据流量经过的系统路径。这说明即使 HBM 有足够带宽,上游的互连资源也可能先一步成为瓶颈。
论文还模拟了一种 FIFO 故障:接收端持续撤销 TREADY,背压沿 NoC 一路传播,最终导致系统级停滞。
这类问题很难靠单独验证某个计算模块来发现,因为错误发生在模块与模块之间的数据交互里。Naviq 借助握手失败热力图和链路追踪,帮助工程师定位异常的 FIFO。
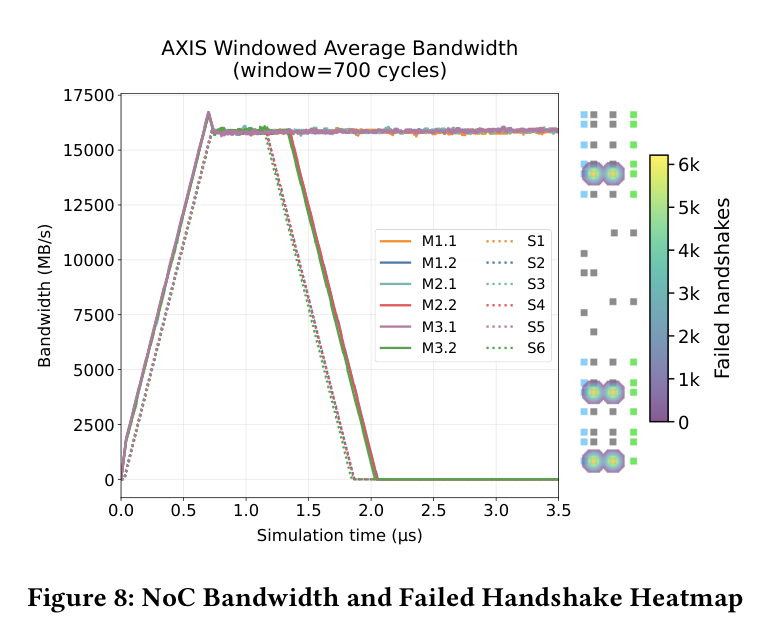
左侧为 NoC 链路窗口平均带宽(约 1.5–2.0 μs 处多条链路带宽骤降),右侧为握手失败热力图,三处持续背压热点指向异常 FIFO 所在路径。来源:Naviq 论文 Figure 8
对于多加速器设计,这种能力尤其有价值。工程师可以在进入耗时的完整 RTL 验证之前,先比较不同数据路径和资源配置的优劣。
Naviq 的优势不只是让单次仿真跑得更快,更在于降低了原本成本高昂的多轮架构实验门槛。
05|硬化 NoC 改变了 FPGA 的验证重点
早期的 FPGA 设计里,大量互连逻辑可以由工程师通过可编程资源自行实现,设计者能直接修改对应的 RTL。
随着 Versal 等器件引入硬化 NoC,互连本身变成了固定的片上基础设施。工程师可以配置连接关系、流量走向和资源使用方式,却没法像改自定义 RTL 那样去改它的内部实现。
这让系统验证有了新的要求:既要吃透自己的计算模块,也要评估它与硬化基础设施之间的交互。
Naviq 展示了一条可行的工程路线:对自定义逻辑继续沿用 RTL 验证,对相对固定的 SoC 模块建立足够准确的周期级模型,再通过统一环境观察完整数据路径。
混合仿真的思想并不是第一次出现,周期级建模和 Verilator 也早已被广泛使用。Naviq 的具体贡献在于:面向 Versal 类 FPGA SoC 建立了一个包含 AXI4 事务、NoC 背压和内存交互的系统模型,并给出了与厂商 RTL 模型的量化对比结果。
对 FPGA 和 SoC 架构工程师来说,这项工作的启发很直接:当性能瓶颈出现在计算模块与互连、内存之间时,验证范围也必须从单个 RTL 模块扩展到整个系统的数据路径。
仿真提速 182 倍的价值,最终体现在工程师能更早发现系统瓶颈,并在设计定型前尝试更多架构方案。对 FPGA SoC 验证、NoC 架构这类话题感兴趣的开发者,也可以到云栈社区与更多同行交流。
 发表于 3 天前
|
查看: 11|
回复: 0
 /1


