AI Coding 已经进入芯片设计领域。不过,让 AI 生成一段 Verilog,和让它完成一个能够运行 Linux 的 CPU,中间还隔着仿真验证、时序收敛、板级调试和性能优化等一整套工程流程。
日本工程师圓山宗智公开的 mmRISC-2 项目提供了一个实际案例:他使用 Claude Code 开发 64 位 RISC-V 处理器,12 天实现 Linux 启动,38 天形成最终版本,累计生成约 2.21 万行 SystemVerilog RTL。
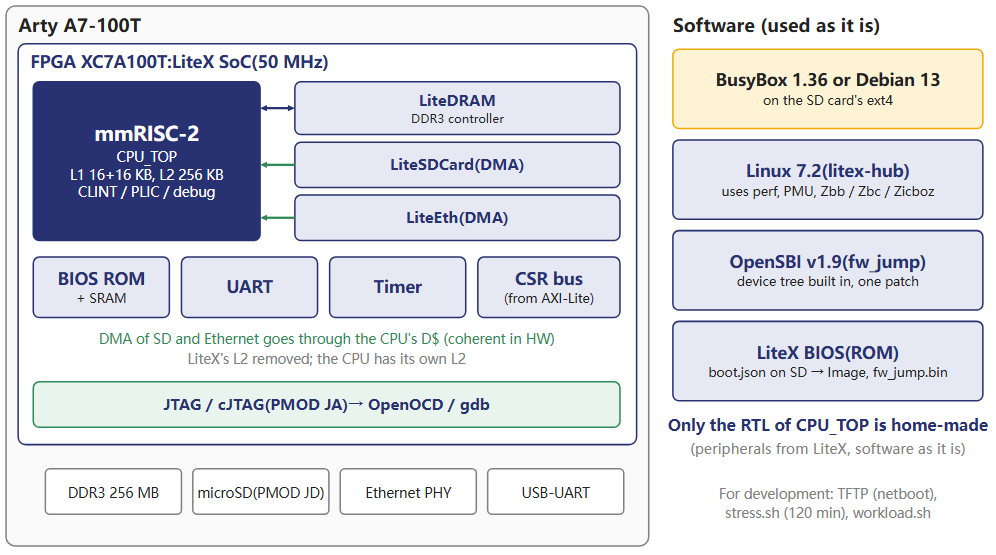
mmRISC-2 是一款借助 AI Coding 开发的 64 位 RISC-V 处理器。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
处理器最终在 Arty A7-100T FPGA开发板 上以 50MHz 运行,达到 3.034 CoreMark/MHz。项目中的规格、RTL、测试平台和脚本主要由 AI 编写,工程师负责目标制定、方案选择、工具运行和实际硬件验证。
01|这个 RISC-V CPU 是怎么用 AI 开发出来的
整个项目并没有让 Claude Code 一次性生成完整 CPU,而是沿着一条逐步推进的工程路径展开。
开发者首先使用 LiteX 搭建 SoC 环境,并通过已有的 Rocket CPU 启动 Linux,确认内存、外设和软件启动链路能够正常工作。有了这个基础,后续替换 CPU 时就不必同时排查整个系统。
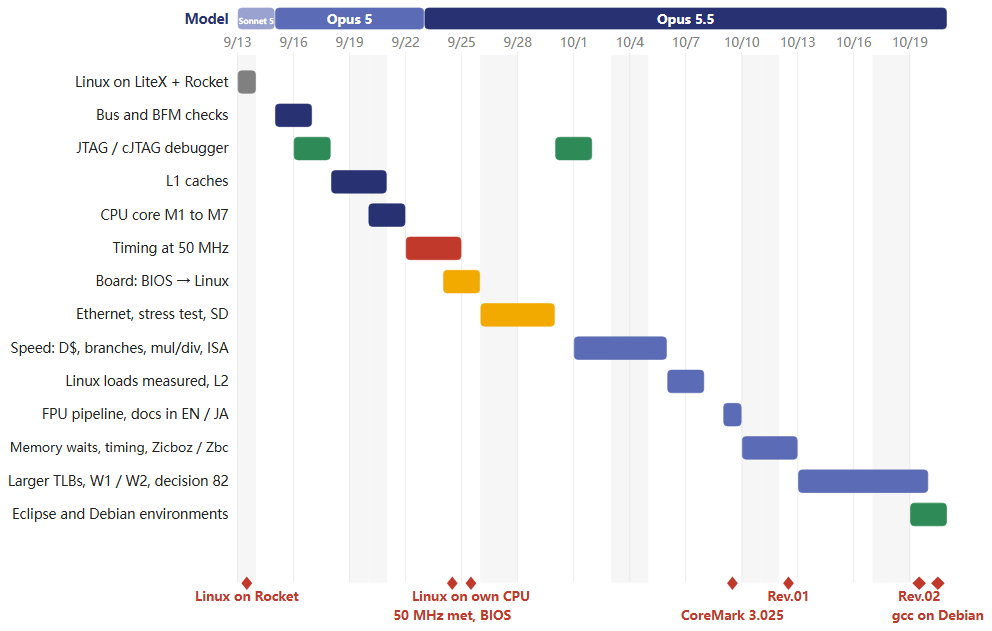
mmRISC-2 从建立系统基线到完成 FPGA 验证的开发路径。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
随后,项目开始开发 JTAG 调试器、Cache 参考模型和 CPU 核心,逐步完成指令执行、流水线、Cache 等模块的实现与验证。
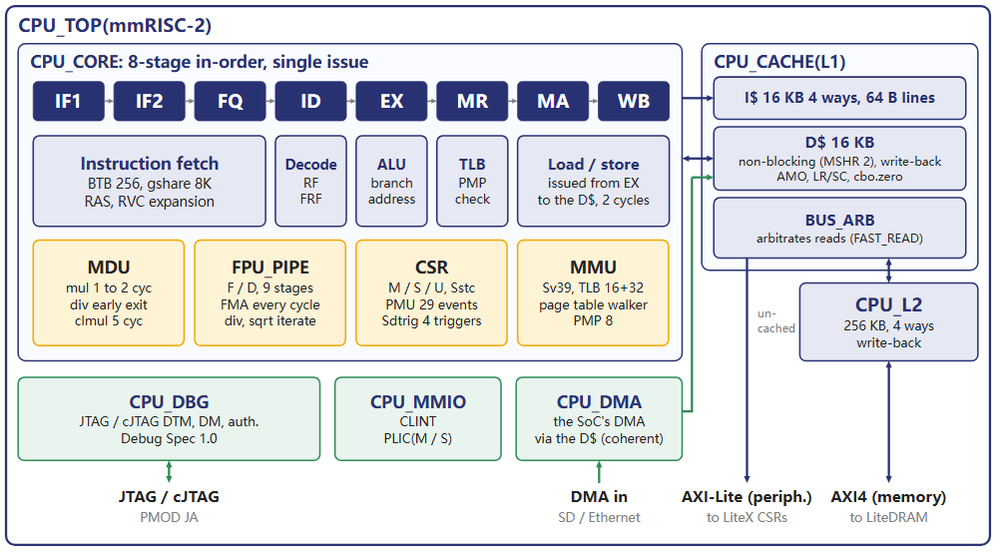
mmRISC-2 处理器的主要微架构模块。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
当 RTL 具备基本功能后,开发进入综合与时序优化阶段。开发者将 Vivado 生成的时序报告交给 Claude Code 分析,根据关键路径调整流水线结构,再通过重新综合和功能回归检查修改效果。
最后,处理器被部署到 FPGA 开发板上,完成 Linux 启动、CoreMark 性能测试,以及内存、以太网和 SD 卡的长时间压力测试。
这条开发路径涵盖了从系统搭建、RTL 实现、仿真验证到时序收敛和板级测试的主要环节。AI 参与了代码生成、问题分析和设计迭代,但每个阶段都需要明确的验收条件和真实工具反馈。
02|先建立可验证的基线,再让 AI 写 RTL
mmRISC-2 先用 Rocket CPU 跑通 Linux,再开发自己的处理器,这个顺序很有工程价值。
如果 CPU、总线、内存控制器和启动软件同时由 AI 生成,一旦 Linux 无法启动,很难快速判断问题究竟出在指令执行、Cache 访问,还是外设通信。
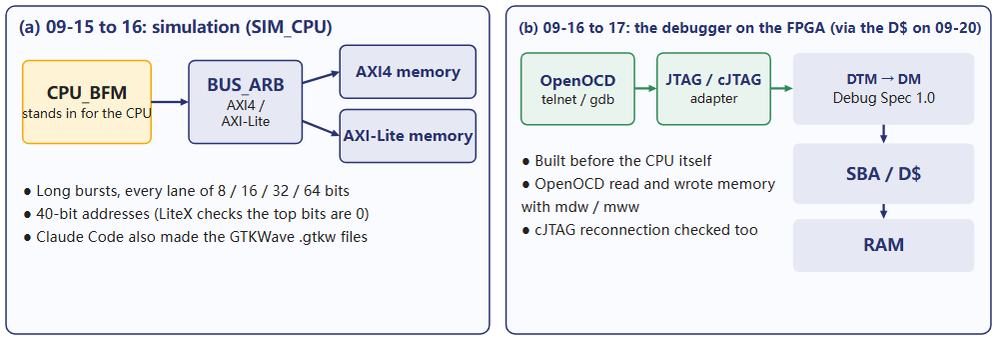
先验证 SoC 基础环境,再替换待开发的 CPU 核心,有助于缩小问题排查范围。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
而有了已经验证的 SoC 环境,就可以把问题范围缩小到新加入的模块。
这一思路同样适用于日常 RTL 开发。例如让 AI 开发 AXI DMA,可以先固定接口协议、时钟复位和测试环境,再分别实现描述符解析、地址生成、数据搬运和异常处理。
每完成一个模块,就执行对应的仿真与回归测试,而不是等所有代码生成完再统一调试。
AI Coding 的起点应该是清晰的模块边界、接口约束和验收标准,而不只是一段描述功能的提示词。
03|把 EDA 报告变成 AI 修改 RTL 的依据
mmRISC-2 最有代表性的工程问题发生在时序收敛阶段。
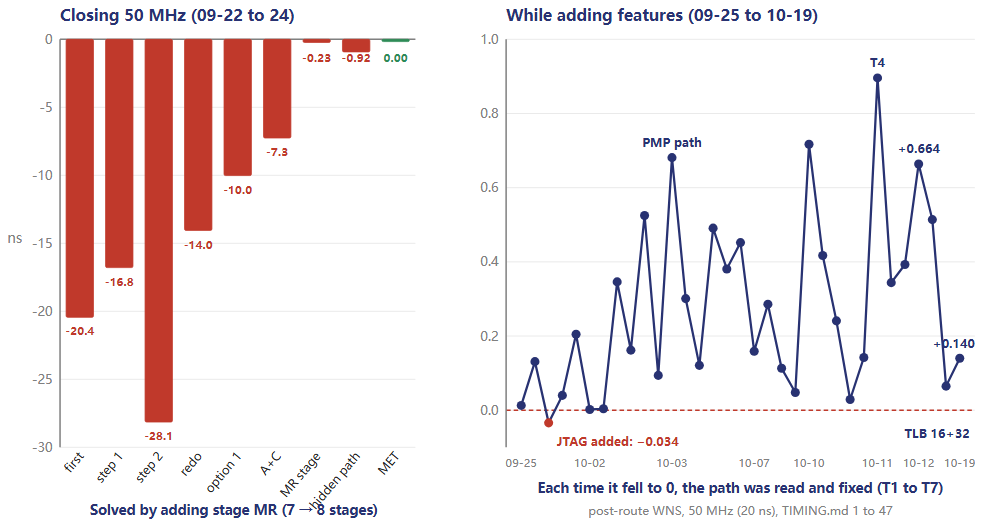
第一次综合后,设计的 WNS(最差负裕量)达到 −20.4ns,距离 50MHz 的时序目标还有明显差距。
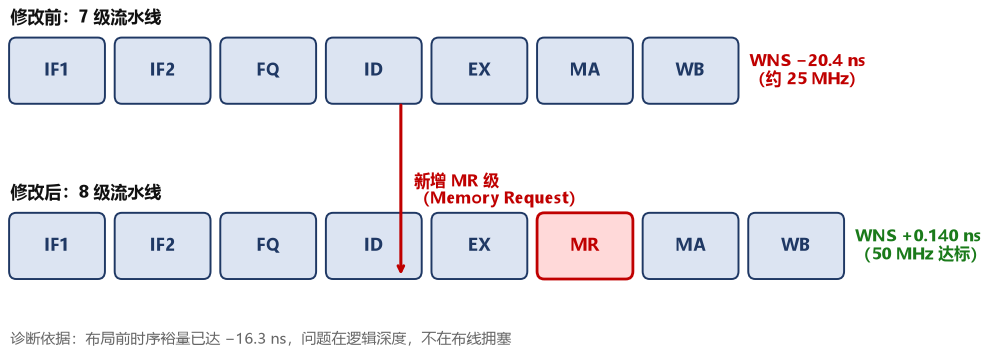
项目初期存在明显的时序违例,WNS 达到 −20.4ns。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
Claude Code 分析 Vivado 报告后发现,在布局之前,时序裕量已经达到 −16.3ns。这意味着问题不能简单归咎于布线拥塞,逻辑路径本身就需要调整。
随后,项目在流水线中增加 MR 阶段,将原来的 7 级流水线调整为 8 级。经过连续修改和验证,最终实现 WNS +0.140ns,满足 50MHz 目标。
增加 MR 流水级后,项目通过多轮修改与验证完成 50MHz 时序收敛。(根据项目公开数据绘制)
这里形成了一套可以直接迁移的工作流程:
运行综合 → 提取关键路径 → 分析路径成因 → 提出 RTL 修改 → 重新综合 → 回归验证。
工程师可以将关键路径的起点、终点、逻辑级数、路径延迟和设计约束交给 AI,让它分析组合逻辑是否过深、寄存器划分是否合理,并提出具体修改方案。
但时序改善并不代表设计一定正确。增加流水级可能改变数据相关处理、旁路逻辑和指令延迟,因此每次修改都需要重新执行功能验证。
AI 可以加快分析和修改,最终仍要由 EDA 报告与回归结果判断方案是否有效。
04|不仅验证 AI 写出的 RTL,还要验证测试本身
AI Coding 有一个容易忽略的问题:如果 RTL 和 Testbench 都由同一个 AI 生成,两者可能共享相同的错误假设。
例如 AI 误解了某个协议的握手条件,它可能在 RTL 和测试平台中采用同样的错误实现,最终仿真依然通过。
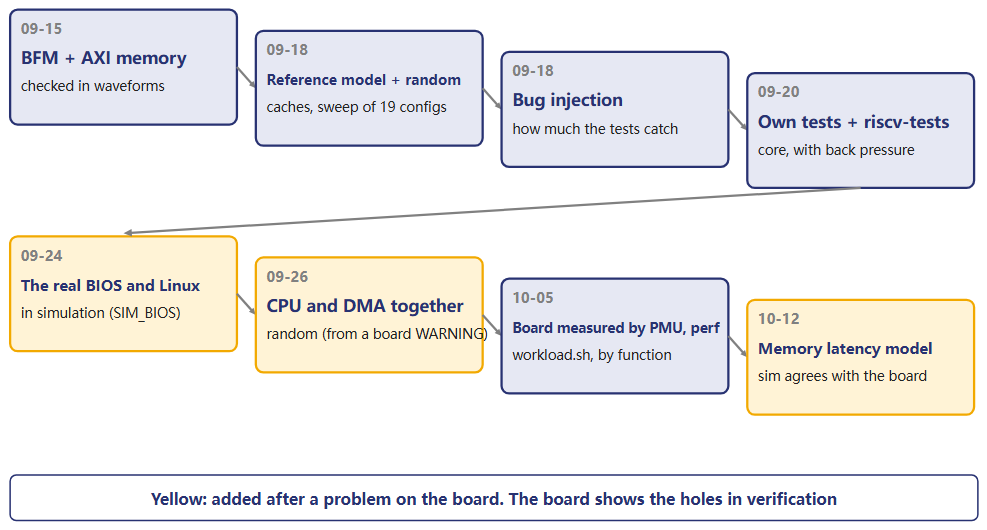
通过参考模型、独立测试和错误注入,检查 AI 生成 RTL 及验证环境的可靠性。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
mmRISC-2 采用了多层验证,包括自定义测试、参考模型、RISC-V 官方测试,以及故意向 RTL 中注入错误。项目累计注入 554 种错误,已有测试全部成功检测出来。
这种方法可以用于日常 SoC 模块开发。例如开发 FIFO 时,可以故意修改满空标志、读写指针更新条件或边界比较逻辑,检查测试平台能否发现问题。
开发 AXI 接口时,也可以构造错误响应、突发传输边界问题或异常握手场景,检验验证环境是否足够敏感。测试通过只能说明当前测试没有发现错误;主动注入错误,可以进一步检查测试有没有发现问题的能力。
05|让 AI 优化性能,也要允许它删除自己的代码
项目后期,开发者开始使用性能计数器分析 Cache、TLB、分支预测和内存等待造成的开销。
其中有两个值得注意的例子。
一个是指令预取器。项目曾实现这一功能,但实际测试发现性能下降 0–4%,最终决定移除。
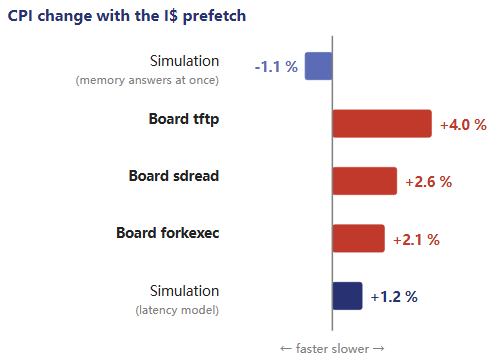
mmRISC-2 根据性能分析决定是否保留优化,而非一味增加硬件功能。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
另一个是增加第二个总线读取端口。分析发现预期收益只有 0.26%,因此没有继续实现。
这说明 AI Coding 的优化流程不能以生成更多代码为目标。
对于工程师来说,更合理的做法是让 AI 先分析性能计数器,找出主要的停顿来源,再评估修改某个模块可能获得的收益。例如 Cache Miss 占比很高,并不意味着增加预取器就一定有效,还需要考虑访问规律、预取准确率、带宽竞争和额外硬件开销。
先定位瓶颈,再估算收益,最后决定是否修改 RTL。AI 提出的优化方案,也需要接受实测结果的检验。
06|工程师负责决策,AI 参与执行与迭代
整个 mmRISC-2 项目中,作者累计向 Claude Code 发出约 400 次日语指令。
AI 承担了规格编写、RTL 实现、测试平台、脚本、文档和代码提交等工作;工程师负责制定目标、选择方案、运行 Vivado、烧录 FPGA,并将真实运行结果反馈给 AI。
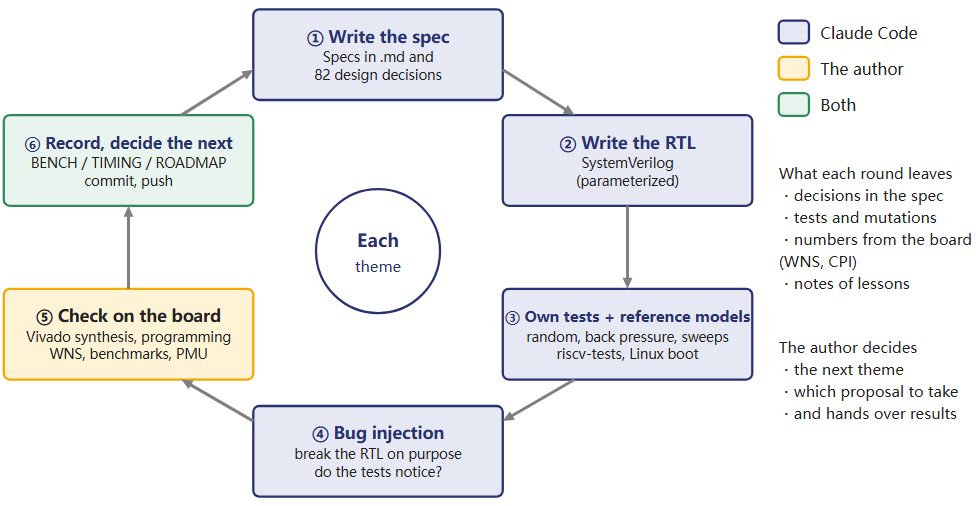
工程师制定目标并判断结果,AI 参与实现与分析,EDA 工具和 FPGA 提供验证反馈。(图源:mmRISC-2 项目 GitHub 仓库,白皮书插图)
最终版本不仅能够启动 Debian 13,还可以在自研 CPU 上运行 gcc 编译 C 程序,并通过 120 分钟的内存、以太网和 SD 卡联合压力测试。
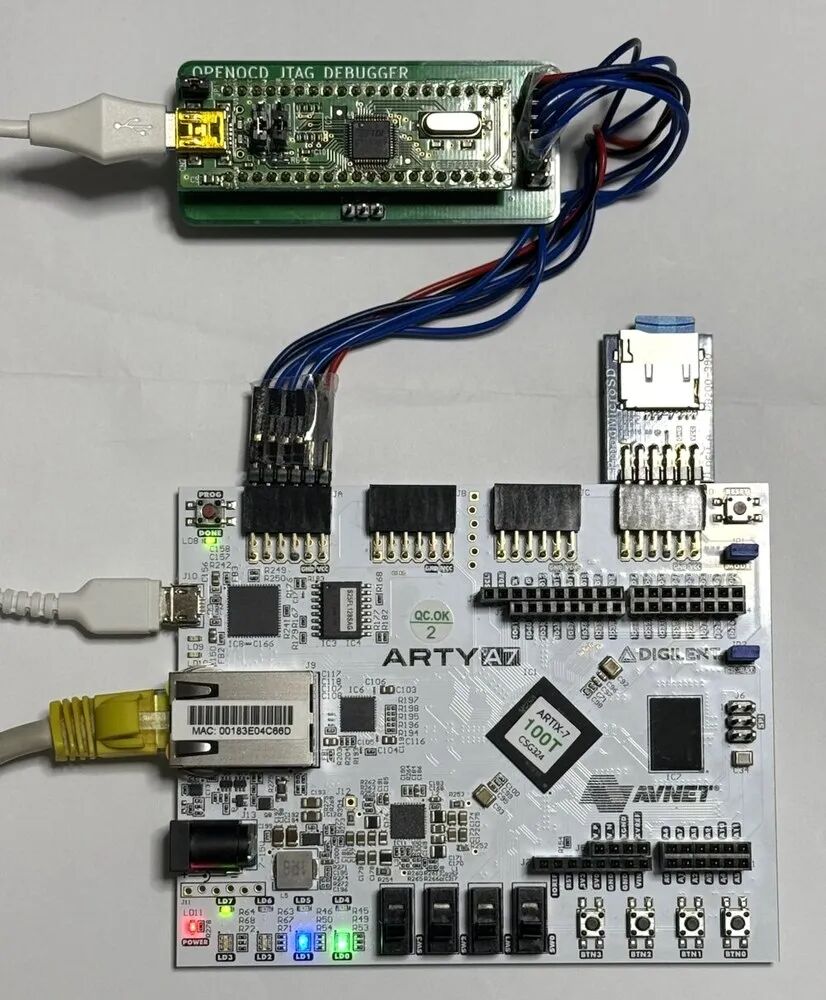
mmRISC-2 在 FPGA 平台上完成 Linux 启动与实际软件运行。(图源:mmRISC-2 项目 GitHub 仓库,Arty A7-100T 开发板与 OpenOCD JTAG 调试器实物照片)
从这个案例可以整理出一套适合 RTL 工程师的 AI Coding 工作方法:
- 明确规格: 定义接口、功能边界、设计约束和验收标准。
- 分模块实现: 每完成一个模块,就执行独立验证。
- 利用工具反馈: 将仿真、Lint、综合和时序报告交给 AI 分析。
- 建立回归闭环: 每次修改都检查功能、时序和资源变化。
- 根据实测取舍: 不以生成代码量衡量成果,保留真正有效的设计修改。
mmRISC-2 仍然是一个运行在 50MHz FPGA 上的开源处理器项目,不能据此推断 AI 已经能够独立完成复杂商用 SoC 的设计与签核。ASIC 实现还涉及物理设计、功耗、DFT、工艺约束及制造验证等更多环节。
不过,这个项目提供了一种可以迁移到日常工程中的开发方式:将规格、RTL、EDA 报告和验证结果组织成连续反馈,让 AI 参与每一次有依据的设计迭代。
对于正在开发 FPGA、AXI 接口、DMA 控制器或 SoC 子模块的工程师,这套方法已经具备实际参考价值。如果你对这类 AI 辅助硬件开发的案例和工具感兴趣,也可以访问 云栈社区 查看更多技术实践与开发者分享。
 发表于 3 小时前
|
查看: 1|
回复: 0
 /1


